ARTICLE · 1183262
Orbia 源码精读:720 个探索回访案例,怎么测出视频世界模型记不记得住自己生成的世界
Orbia 源码精读:720 个探索回访案例,怎么测出视频世界模型记不记得住自己生成的世界让一个视频世界模型当游戏引擎用:玩家操纵相机离开出生点,绕过一排货架,拐进没见过的走廊,两分钟后原路返回——门口那座石狮子还在吗?位置对不对?深度关系乱没乱?新加坡国立大学联合光子工作室(LightSpeed Studios)等八家单位上周放出的 Orbia 基准,专门回答这个问题。它不给模型打"画质分",而是用 720 个带注册 RGB-D 参照和人工标注锚点的探索-回访案例,去量每个模型丢没丢掉自己的 3D 世界。论文以 PDF 形式挂在项目页,代码、数据集、27 个模型的完整榜单全部开源,仓库上线六天攒了十三颗星。 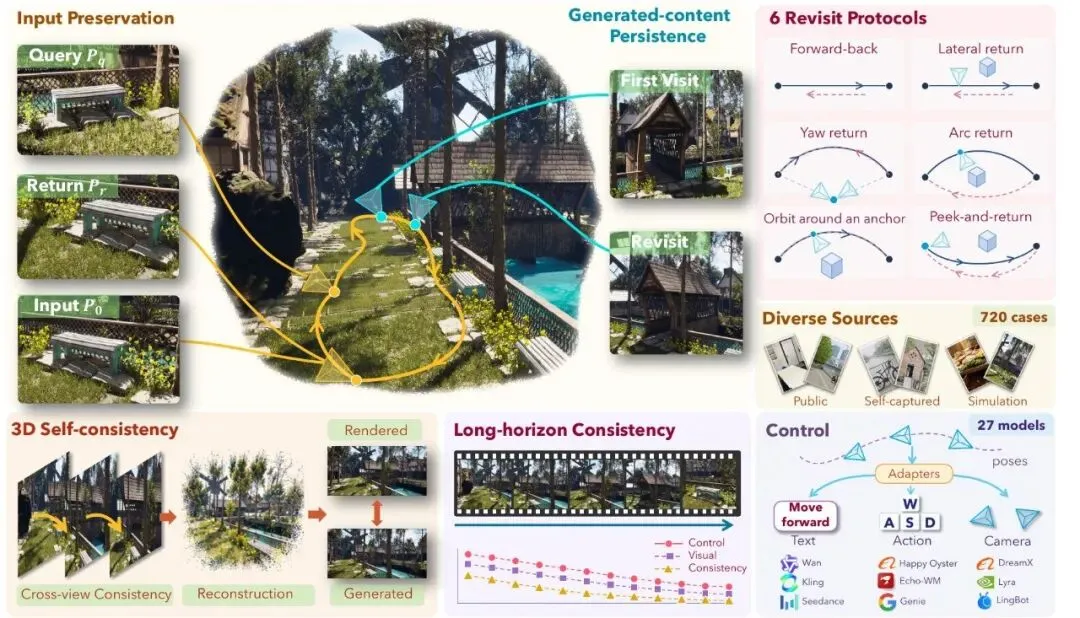
Orbia 测的是交互式视频世界模型的 3D 一致性,拆成三个维度:输入保留(出发时看到的场景,回来时还在不在)、生成内容持久性(模型自己编出来的区域,重访时是不是同一批内容)、3D 自洽(生成的各个视角能不能被同一个 3D 场景解释)。外加控制对齐、视觉质量、时间稳定性,一共六层。 跑完 27 个模型,论文给出的判断相当扎心:视觉质量和三个一致性维度的秩相关只有 0.33(世界模型组)和 0.21(TI2V 组),画面好看基本不保证 3D 世界不散架;世界模型和纯文生视频模型之间最大的差距在相机控制,57.29 对 32.48,差 24.80 分;序列从 22 秒拉到 60 秒,生成内容持久性在六种轨迹上普遍掉 15 到 27 分。27 个模型没有一个六项全优。 代码就绪度:评测代码、数据构建管线、UE 仿真脚本、三个模型适配器示例全部放出,权重下载脚本一键配好环境。没有放出 27 个模型的生成视频,榜单要复现得自己重新生成。 只看一处该看哪个文件:`src/metrics/scoring.py` 的 `aggregate_reports()`。六个维度怎么归一化、怎么加权成 Overall、缺哪层就不出总分,全在这一个函数里。 视频生成正在从"合成画面"往"世界模拟"走:交互式游戏、开放域探索、生成式渲染、具身仿真,都把生成模型当环境用。当环境的硬要求和当播放器完全不同——玩家回到走过的区域,应该看到同样的货架;渲染器换个视角,露出来的表面要互相咬合;具身智能体要能复用先前观察到的空间关系。帧好看说明不了这些。 现有基准各测一角。WorldScore、WorldOlympiad 用位姿条件分别测局部和全局的几何自洽;WBench、WorldMark 测多轮交互状态与长期漂移;MIND、WRBench 测回访一致性;WorldLens 把驾驶世界模型的评测扩到重建和下游任务。论文表 1 拉了一张十几行的对比表,结论是没有一个基准同时覆盖局部 3D 自洽、全局 3D 自洽、输入物体保留、回访一致性、长期漂移这五件事。 更隐蔽的坑在度量粒度。一个场景里最招眼的石狮子可能只占画面 5% 出头,丢了它,场景级 PSNR 平均一下几乎看不出来。Orbia 的统计是:锚点在输入图里占的画面比例中位数只有 5.2%,在查询视角里是 5.4%——不单独给锚点打分,"丢地标"这种最显眼的失败就会被整图平均吞掉。 主线一句话:探索-回访协议。每条轨迹从 P0 出发,经过查询位姿 Pq,走进输入视野之外的区域做首次访问,绕去别处探索,再回到该区域做重访,最后回到 P0。六个模板覆盖前进-后退、横向、纯转角、弧线、绕锚点环绕、窥视-返回,短案例 357 帧 22 秒,长案例 961 帧 60 秒,全部 1280×720、16 FPS。 设计一:注册 RGB-D 参照加锚点。输入保留不靠模型自评,靠两条真实参照:回到 P0 时对输入图,走到 Pq 时对配准过的 RGB-D 参照。配准靠 ViPE 补全缺失位姿,锚点由 VLM 提名、SAM3 在两端独立分割再跨视角核验身份,反投影深度还要过可见性和深度一致性检查。每个锚点单独算 DINO、PSNR、SSIM、LPIPS 和深度 AbsRel,再等权平均——这就是"石狮子单独打分"。 设计二:生成内容持久性拿模型自己的第一次生成为参照。输入视野之外的区域没有真值,模型爱生成什么都行,唯一该成立的是"回来时还是那批内容"。于是首次生成的观测就是重访的参照,外观用投影对齐后的 DINO 特征比,几何用 AbsRel 比,再加一个双向最近点 F-score 检查两次访问是否重建出同一批表面。3D 自洽则完全不看请求轨迹:用 DA3 恢复相机和深度,做跨视角深度/特征一致性、4×4 网格的区域尺度一致性,以及从 64 帧上下文建高斯场景、渲染 16 个 held-out 视角和原帧对比。 一个必要公式(总体分,改写成文字):Overall = 0.25·T1 + 0.25·T2 + 0.1·T3 + 0.1·T4 + 0.1·T5 + 0.2·T6。三个量:T1 是控制对齐(平移旋转误差加 Move/Look 准确率),T2 是视觉质量,T3 到 T5 就是上面三个一致性维度,T6 是时间稳定性。一致性三个维度合计只占 30%,作者的用意是把"当环境用"的两道门槛(跟得上指令、画面不糊)和"世界不散架"分开看,避免一致性单项掩盖可用性问题。 对照一:输入保留的权重与锚点身份采样。论文第 4 节把输入保留拆成 Return、Query、Identity 三块,表 3 按这三列出分。`src/metrics/scoring.py` 的 `tier3()` 是它的直接实现: ```python total = (sum(parts[name]*w for name, w in [('return', .3), ('qe', .4), ('identity', .3)]) if all(v is not None for v in parts.values()) else None) ``` 0.3/0.4/0.3 对上表 3 的三列,任一块缺失整个 T3 置空而不是拿剩下的凑数。锚点身份一致性的"四个时刻",在 `src/metrics/anchor_identity.py` 的 `sample_indices()` 里: ```python return sorted({min(end, max(start+1, int(np.floor( start + fraction*(end-start)+.5)))) for fraction in (.25, .5, .75, 1.)}) ``` 在 Q0 到 QE 区间的 25%、50%、75%、100% 处各取一帧,SAM3.1 从输入掩码出发跟踪,对掩码内 DINO 余弦相似度取平均——论文写"average masked DINO cosine similarity over four times and equally across anchors",代码里就是这四个分数。 对照二:高斯重建的 held-out 渲染。论文 3D 自洽一节写"DA3 从 64 帧上下文预测高斯场景,渲染 16 个 held-out 视角,用 PSNR、SSIM、LPIPS 对比"。`src/backends/run_da3_evaluator.py` 的请求校验把约束钉死了: ```python if (request.get("format") != "orbia.da3.request.v1" or request.get("reconstruction_inputs") != "context_rgb_only" or request.get("infer_gs") is not True or request.get("no_post_optimization") is not True): raise ValueError("invalid DA3 request") ``` `context_rgb_only` 限制重建输入只有上下文 RGB,`no_post_optimization` 禁掉后优化,held-out 视角数在返回时逐一核对。`src/metrics/scoring.json` 里 T5 的 reconstruction 节点就是 `["gs_psnr", "gs_ssim", "gs_lpips"]`,三个叶子各按固定端点归一化后取均值。 默认行为与分支的区分。T1 控制分有个容易看漏的分支:`scoring.py` 里 `selected = ('move','turn') if profile == 'action_only' else tuple(t1_parts)`——动作条件模型只按 Move/Look 准确率计分,默认的 `pose_and_action` 四项全算。归一化端点全部写在 `scoring.json`,注释标明来自 model-balanced 分位数(误差类 0 到 P95,PSNR 用 P5 到 P95),版本号 orbia-1.0,跑多少遍都不重算——这是跨批次可比的前提,不是动态统计。轨迹方面,`src/trajectory/templates.py` 默认走解析模板曲线,但 ScanNet++ 来源的案例走 route-conforming 分支,中间采样沿真实采集路线而不是拟合曲线,模板名只描述路线拓扑。 数据侧的筛选链路:扫了 110,406 段公开视频和场景,机器初筛留 10,944 个候选,进 881 案例多样性池,最终留下 240 个公开数据案例。完整构成是 ScanNet++ 60 个短案例、SpatialVID 134 短 74 长、Sekai 25 加 25、MiraData 21 加 21、自采 60 短 30 长、Unreal Engine 仿真 180 短 90 长,共 480 短加 240 长,859 个锚点评测目标,每个模板贡献 80 短 40 长。标注和审核累计超过 300 小时。 被测模型 27 个:19 个相机或动作条件的世界模型,8 个 TI2V 模型,适配器把同一条请求轨迹翻译成相机条件、离散指令或文本指令。评测工具链是 DA3-GIANT-1.1 恢复深度和相机(长视频换 DA3 Streaming)、SAM 3.1 做锚点跟踪(gated 权重,要 HF 登录接受条款)、DINOv2 ViT-S/14、LPIPS 的 alex 骨干,质量分用 MUSIQ、LAION aesthetic、AMT、HPSv3。`tools/download_weights.py` 一键拉齐并写出 `evaluation.local.yaml`。评估工作流拉的 VLM 是 Qwen2-VL-7B,构建工作流拉的是 Qwen3.5-9B,两条线用途不同。 最影响可比性的三个条件:所有几何指标都建立在 DA3 恢复的相机和深度上;归一化端点固定为 orbia-1.0 那一套;帧按索引对齐请求位姿,视频文件自带帧率不参与对齐。 表 2 总榜分开看。世界模型组 SolarWM-H3 以 76.32 排第一,同时拿下生成内容持久性和时间稳定性两项第一;Lyra2 74.77、EVOKE 72.70 跟进,其中 Lyra2 控制分 81.64 全场最高。TI2V 组 Seedance2.5 以 67.44 领先。没有模型六项全优:Gen3C 输入保留 75.23 全场第一,视觉质量 67.55 在世界模型组只排第 17;HY-WorldPlay 3D 自洽 70.34 第一,控制 45.26 排到第 16。 表 3 的输入保留明细更细:Return 子项冠军是 Gen3C 的 81.24,Query 子项冠军是 SolarWM-H3 的 65.30,Identity 子项冠军是 Cosmos3-Nano 的 92.79——三个子项偏爱三个不同模型,作者的结论"三个检查必须一起做"有数据撑着。 相关性方面(图 5):控制与 3D 自洽的秩相关在世界模型短视频上只有 0.09,长视频上 -0.04——跟得上相机指令和视角之间互相咬合是两回事。控制与输入保留的相关性从短视频的 0.63 掉到长视频的 0.32,跟着轨迹走不等于内容没丢。 长程衰减(图 7、图 8):SolarWM-H3、Lyra2、EVOKE 等八个头部模型的控制分从首个到末个五秒窗口平均掉 26.98 分,SolarWM-H3 从 91.91 掉到 64.50;TI2V 组视觉质量只掉 2.08,局部几何掉 7.13。生成内容持久性在前进-后退这种最简单轨迹上,世界模型从 66.21 掉到 40.96。 人类对齐:90 个案例、20 位评分者对六个维度分别排序,自动分与人工排序的 Spearman 相关在 0.859 到 0.921 之间,时间稳定性一致性最高。 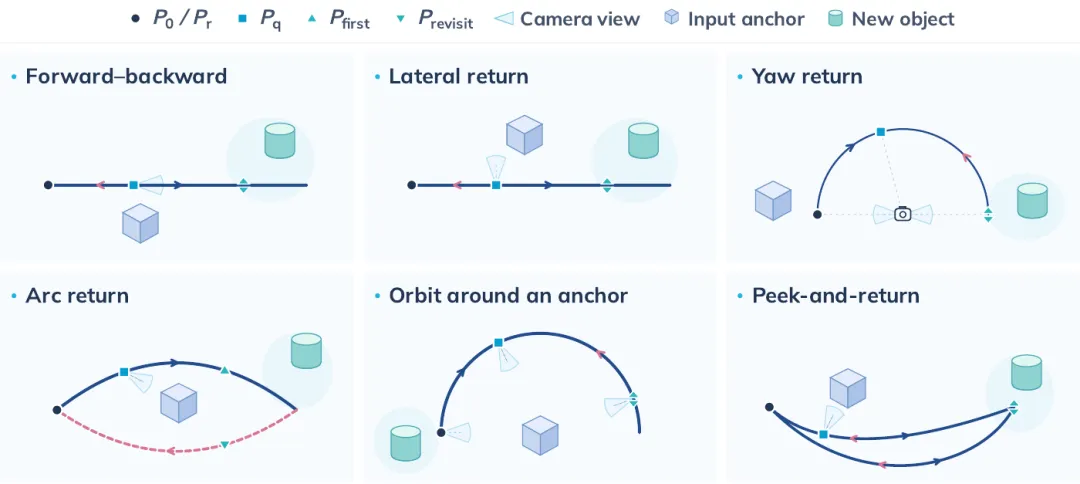
对应得扎实的部分:T3 的 0.3/0.4/0.3 权重、锚点身份四时刻采样、T5 的三叶子重建分、总体 25/25/10/10/10/20 加权、T6 的短长 30/70,论文文字和代码逐条能对上,`docs/evaluation.md` 还把权重用表格重述了一遍。 代码比论文多出来的:`scoring.json` 把每个叶指标的归一化端点固化成配置(误差 0 到 P95、PSNR 用 P5 到 P95),换版本分数才可比;`anchor_identity.py` 用常驻 SAM 子进程加 Linux memfd 传帧,避免每个案例重复加载权重和落盘;`evaluate.py` 支持断点续跑,同输出目录下按指纹跳过已完成任务;ScanNet++ 的 route-conforming 轨迹是独立分支。这些论文都没展开,属于工程实现。 只是配置选择的:评估与构建两条工作流拉的 VLM 不同;DA3 请求强制 `no_post_optimization`。这些不是缺陷,是评测协议的一部分,但读论文时不会知道,得翻代码。 环境用 `tools/install_evaluation.sh`,依赖按 requirements 目录分组安装;权重用 `tools/download_weights.py`,SAM 3.1 需要先在 HuggingFace 接受访问条款并 `hf auth login`。数据集从 HuggingFace 拉 Orbia/Orbia,解到 `data/orbia`。 最小样例不用一上来跑全量:`evaluate.py` 支持 `--stage geometry`(只恢复相机和深度)和 `--tiers T1`(只算控制分),可以先拿一条已有视频把管线跑通。要接自己的模型,`examples/camera_model.py`、`action_model.py`、`text_model.py` 三个适配器示例分别对应三类接口,`generate.py` 会顺手写出 `videos.jsonl`。成功标志是 `results/scores/scores.csv` 里出现 T1 到 T6 和 Overall——六层不齐不出总分,T6 必须长短视频都有;单案例的明细在 `results///report.json`。 容易看错的三处:帧对齐按索引不按帧率,第 i 帧必须对应第 i 个请求位姿,短案例 357 帧、长案例 961 帧,存成 30 FPS 也没关系但帧数必须对;归一化端点是固定配置,别自己重算分位数;动作条件模型记得传 `--control-profile action_only`,否则按四项控制指标算,分数口径就错了。我没有跑过完整评测,以上来自代码和文档。 有证据的价值:把"生成的视频是不是一个一致的 3D 世界"从观感问题变成六个可复现的数字;锚点对象级度量补上了场景平均的盲区(中位数 5.2% 的画面占比,正是最容易被平均吞掉的失败);held-out 渲染把"局部互相一致但整体矛盾"这类失败单独暴露出来;自动排序与人类排序相关 0.86 以上,说明这套指标不是自嗨。 限制也要说清:所有几何指标建立在 DA3 恢复的相机和深度上,恢复误差会传导进 T3 到 T5 的每一项,换深度估计器分数会动——这是我的推测,我没有在论文里找到换估计器的敏感性实验。锚点之外的细粒度变化不进锚点子项,只能靠场景级指标兜底。27 个模型里相当一部分是闭源服务,第三方复现榜单必须重新生成全部视频,成本不低。论文发布形态是项目页 PDF 加 GitHub,暂无 arXiv 条目,长期引用建议固定到仓库 commit 和 PDF 版本。 对做世界模型的人来说,这份基准最实际的用法可能是当"遗忘率仪表盘":训练前后各跑一轮 720 案例,输入保留和生成内容持久性两栏的差值,比肉眼刷 demo 诚实得多。 参考资料 仓库:https://github.com/worldbench/Orbia(commit 10db32fb3c) 论文 PDF:https://orbia-bench.github.io/paper/orbia.pdf(2026 年 10 月版,70 页) 项目页:https://orbia-bench.github.io/ 数据集:https://huggingface.co/datasets/Orbia/Orbia 主要源码(均在上述 commit):src/metrics/scoring.py、src/metrics/scoring.json、src/metrics/anchor_identity.py、src/backends/run_da3_evaluator.py、src/trajectory/templates.py、tools/download_weights.py、docs/evaluation.md
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看