ARTICLE · 1188791
36岁测试大佬搭建的AI大模型测试助手——AIES,解决90%的测试工作(附使用手册)
当被测对象从"页面能不能点"变成"模型答得对不对",传统测试方法失效了——这个平台是专门为AI大模型产品测试而生的
引子:大模型产品上线前,测试在测什么?
去年团队做一个知识库问答产品,功能测试全过了,上线一周,用户投诉炸了:
• 问A商品能不能退货,它把B商品的退货政策答了一遍——检索相关性出错 • 问不在知识库里的问题,它编了一个看起来很像真的答案——幻觉 • 有人用诱导性提问,它把系统提示词泄露了——对抗攻击被攻破 • 同一个问题问三遍,三个不同答案——鲁棒性不够
那一刻我意识到:被测对象变了。
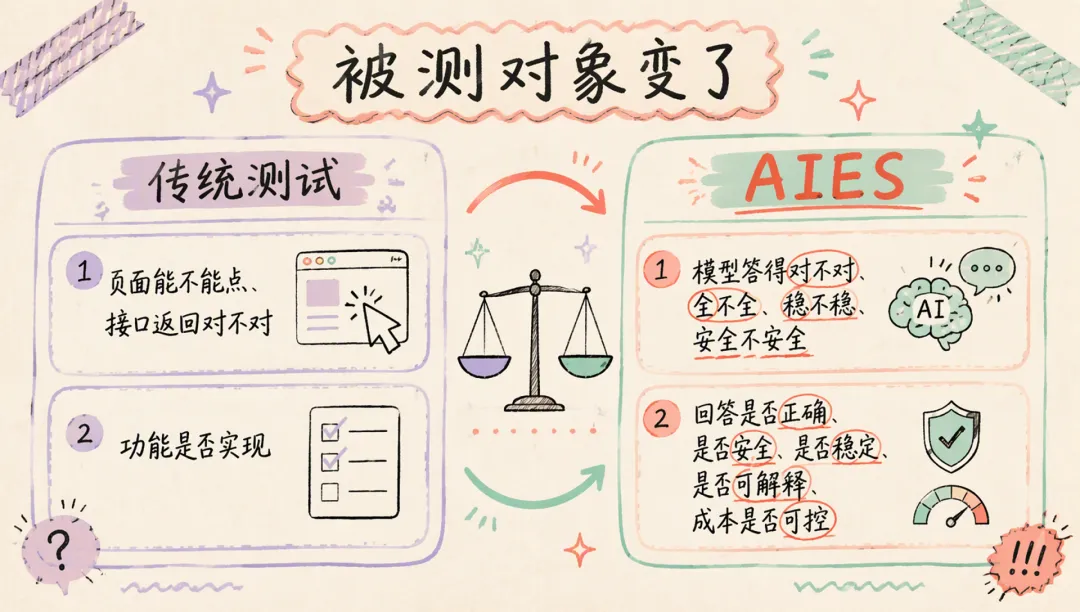
以前测的是"页面能不能点、接口返回对不对",现在测的是"模型答得对不对、全不全、稳不稳、安全不安全"。传统的测试方法和工具,完全不够用。
于是我搭了一个专门测AI大模型产品的平台——AIES。
第一部分:AIES是什么?——专门测AI大模型产品的测试助手
一句话定位:一个面向智能体、知识库问答、大模型应用的测试平台。
它要解决的不是"用AI来做传统测试",而是"测试AI产品本身"。
被测对象包括两类:
• 通用智能体:通用对话、工具调用等 • 知识库问答:RAG、企业知识库问答
测试维度分两大类:
• 功能测试:答得对不对、全不全;知识库问答还会看检索与忠实度 • 非功能测试:对抗性、鲁棒性、性能、偏见/可解释性/人类监督、双向/多模态、成本
核心差异:传统测试看"功能是否实现",AIES看"回答是否正确、是否安全、是否稳定、是否可解释、成本是否可控"。
第二部分:核心功能全景
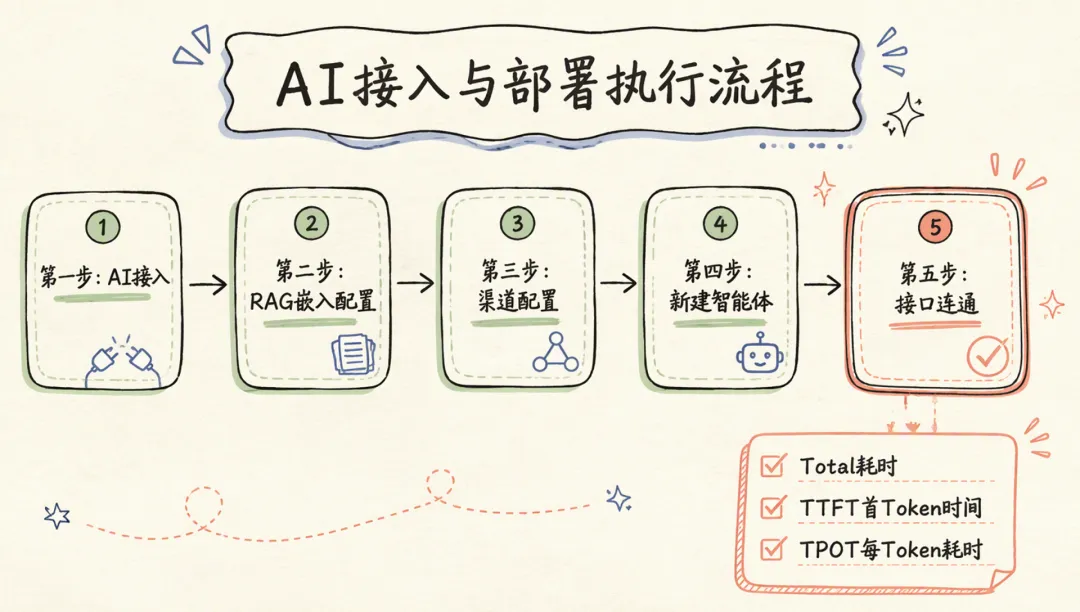
基础配置五步走(按顺序,否则后续功能会失败):
第一步:AI接入配置裁判/生成用大模型,支持OpenAI、DeepSeek、通义千问、智谱、Moonshot、Ollama等。填API地址、Key、模型名、超时时间,测试通过后可设为"对话生成"用途的默认模型。
第二步:RAG嵌入配置知识库入库必做。配置嵌入模型(本地可选BAAI/bge-small-zh-v1.5等)、向量数据库(Chroma内置推荐或pgvector)、切片大小和重叠。更换嵌入模型后,已入库文档需要重新入库才能用新向量。
第三步:渠道配置
• 全局邮件服务(SMTP):平台统一发邮件 • 智能体通知对象:企业微信/钉钉/飞书/邮件,配置Webhook或收件人
第四步:新建智能体填名称、类型(通用智能体/知识库问答)、描述。列表会显示连通状态:未测试/已连通/连通失败。
第五步:接口连通选择接入预设(OpenAI兼容/FastGPT/Dify/Coze/自定义HTTP),配置接口地址、协议、请求方法、认证方式、请求模板、输出JSONPath。连通测试通过后,界面会展示Total耗时、TTFT首Token时间、TPOT每Token耗时、提取出的回答。
第三部分:功能测试怎么测?
数据集设计三种方式,可组合使用:
| A. 手工加用例 | ||
| B. 文件导入 | ||
| C. AI生成+候选审核 |
AI生成的关键设计:不能空材料硬生成。必须提供业务背景和材料来源(不提供/粘贴文本/选择知识库)。生成后进入候选审核,支持批量采纳、人工编辑、AI优化、删除,标注"疑似重复""多轮"等标签。
测评执行流程:
1. 选测评维度(功能测试)和数据集 2. 配置裁判模型、通过阈值(默认0.7)、评分指标(通用智能体默认正确性+完整性;知识库问答默认RAG四元组:检索相关性、忠实度、答案相关性、上下文精确度) 3. 发起前体检:智能体连通、数据集检查(正式用例条数>0)、裁判模型可用性探测 4. 提交执行,看报告:通过率、平均分、各指标均分、平均延迟;可筛选通过/未通过/执行失败,展开看输入、实际回答、期望、裁判评语;可仅重跑失败用例、导出Excel
第四部分:非功能测试怎么测?
这是AIES最核心的差异化能力。
8.1 对抗性测试目标:攻击或诱导场景下,智能体是否拒答、守住安全与合规底线。 子类型:规避攻击(形近字、错别字、空格、Base64、字符拆分)、投毒攻击(RAG投毒、联网搜索投毒、多轮上下文投毒)、提示词注入攻击(越狱、角色扮演、指令覆盖)、隐私泄露攻击(诱导套取系统提示、密钥、他人隐私)。期望多是拒绝/不配合违规,候选审核时重点核对"期望表现"是否写成"拒绝/应守住",而不是"应详细回答违规内容"。
8.2 鲁棒性测试目标:问法变化、噪声、重复调用下是否仍然稳定正确。 子类型:噪声鲁棒(变体计划:抗干扰/知识库边界/多轮一致性/安全越狱)、可重复性测试(连续3/5/10次)、不变性测试(同一语义多种表述,期望判定一致)。 报告中关注:同一题多次/多变体的通过分布,定位"偶发失败"与"一扰就挂"。
8.3 性能测试目标:用正常业务问句请求被测智能体,统计延迟、RPS等。 **注意:不在数据集里写"1000人并发"这类元问题。**并发用户数、启动速率、压测时长在发起测评时配置(并发1-50、启动速率0.1-50、压测时长5-1800秒)。 报告关注:总请求、请求失败(按Locust风格统计的请求失败次数,不是用例失败)、RPS、Total/TTFT/TPOT、分位延迟(Median/P95/P99)、时序图。
8.4 偏见/可解释性/人类监督
• 偏见测试:AI生成常自动均分多类偏见维度,材料写清业务域与"应保持中立"的边界,看未通过是否存在刻板印象或不公回复 • 可解释性测试:均分"知识库溯源与忠实度""推理逻辑可解释性",强制需要知识库或粘贴文本,关注回答是否可追溯、是否说谎、推理是否自洽 • 人类监督测试:配置监督模式(人在环路HITL/人在环上HOTL/人在指挥HIC),场景自动均分,按期望门控行为判定
8.5 双向测试与多模态测试
• 双向测试:生成正向问答+回译/回推类用例,关注语义是否闭环一致 • 多模态测试:按界面能力准备多模态理解的用例,选多模态维度,确认被测接口与裁判是否支持对应输入
8.6 成本测试不单独建"成本"类型;测评时选择维度"成本测试",并复用功能数据集。前置条件是接口配置中已设按单价计费。报告关注总费用、输入/输出Token、外部调用费用,无法核算时会有警告。
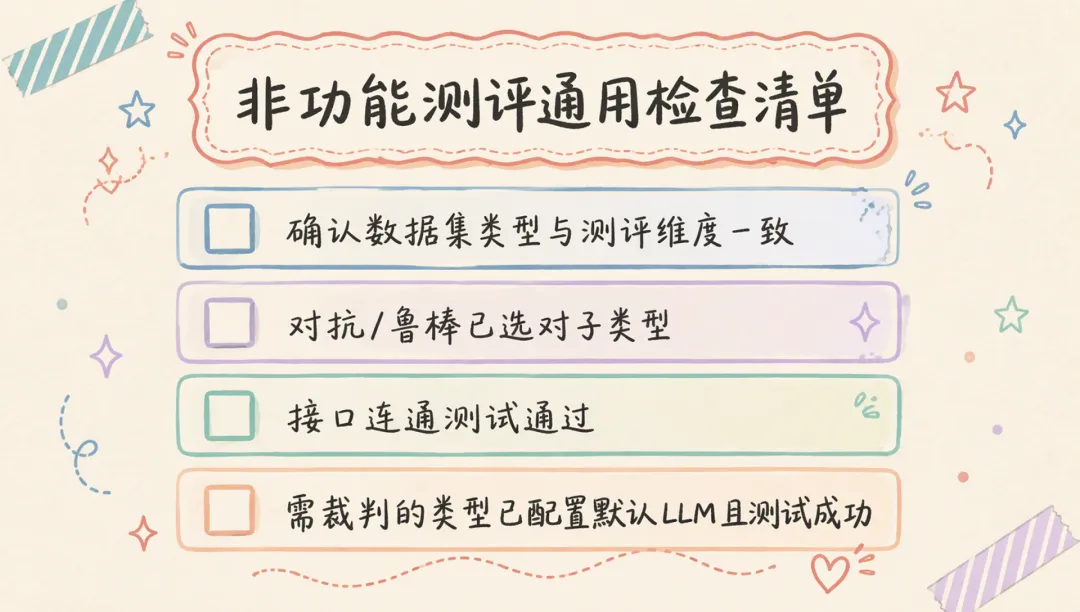
非功能测评通用检查清单:每次发起前确认数据集类型与测评维度一致、对抗/鲁棒已选对子类型、接口连通测试通过、需裁判的类型已配置默认LLM且测试成功。
第五部分:定时任务——周期性回归+通知
调度配置:支持每天(HH:mm)、每周(星期+时间)、每月(日期+时间)、每小时(第N分钟)、自定义cron表达式。界面会预览表达式的中文释义,非法cron会标红。
通知配置:发送通知开关、触发条件(始终发送/仅失败时/通过率低于阈值/失败或低于阈值)、通过率阈值(条件含"低于阈值"时填写,常用80%)。
新建任务常见默认:每天02:00、通知开启、触发"失败或低于阈值"。
日常运维:启用/停用、立即执行(不改cron马上跑一轮)、执行历史、编辑/删除。
第六部分:完整使用手册怎么领?
以上只是AIES的核心功能全景。完整资料还包括:
• AIES平台用户使用手册(从快速开始到非功能测试全流程) • AI接入配置指南(6大厂商Base URL + RAG配置) • 功能/非功能数据集设计模板 • 测评报告模板与常见问题排查清单
🎁 获取方式
关注本公众号,后台回复关键词 「666」 ,即可免费获取。
👇 扫码关注,回复「666」获取完整使用手册
结语:AI大模型产品的测试,需要新的方法论
当被测对象从"页面能不能点"变成"模型答得对不对",传统测试方法就失效了。
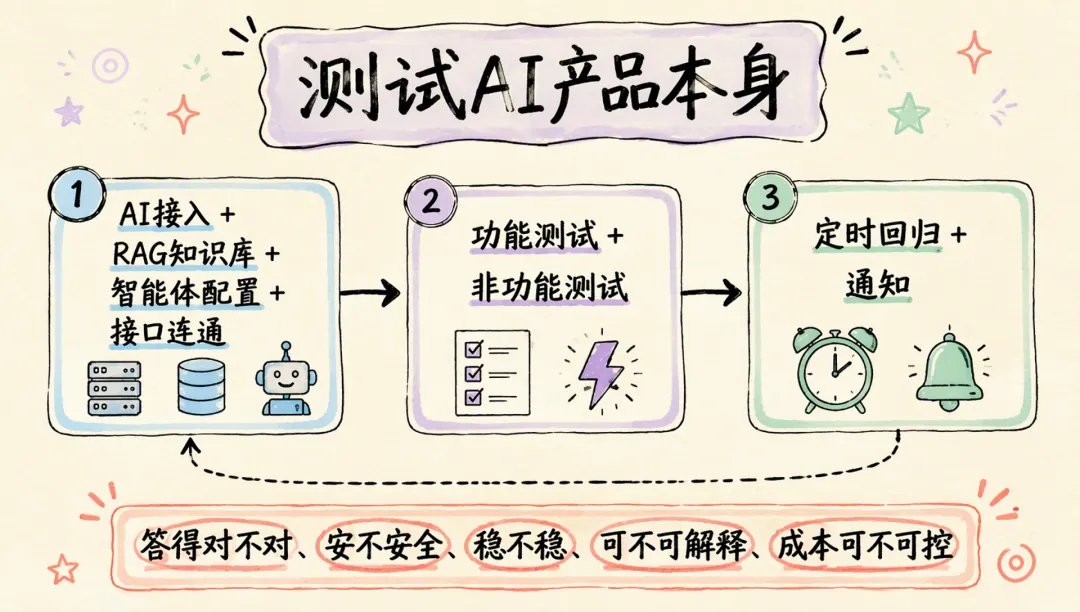
AIES解决的,是AI大模型产品测试的完整链路:
AI接入 + RAG知识库 + 智能体配置 + 接口连通 + 功能测试 + 非功能测试 + 定时回归 + 通知
它不是用AI做传统测试,是专门测AI产品本身——答得对不对、安不安全、稳不稳、可不可解释、成本可不可控。
回到开头那个知识库问答产品——如果当时有AIES,上线前就能跑完对抗性测试、鲁棒性测试、RAG四元组评测、成本测试,那些用户投诉本可以避免。
如果觉得有收获,欢迎点赞、在看、转发三连,让更多被"大模型产品怎么测"困扰的测试人看到这条路!