ARTICLE · 1189694
AI 测试工具买了一堆,为什么团队还是不用?
「AI 测试实战」系列。前面几篇讲的是提示词回归、评测集、四道闸门;这一篇换个位置站——站到花钱的那一头,讲怎么选工具。
先说一个不太体面的事实。
AI 测试工具最常见的死法,不是不好用,是没人用。
这个判断不是我拍脑袋来的。今年有几份报告都指向同一件事。
Testin 云测在 2026 年的 AI 测试规模化报告里提到一个数字:AI 的「非采纳者」比例,从 2024 年的 4% 回升到了 11%。它特意说明,这些人不是觉得 AI 没用,而是算不清 ROI,退回去重新评估。
Gartner 也把「2027 年 80% 的企业会集成 AI 测试工具」这个预测,下修成了「2028 年 70%」,同时预判超过 40% 的 Agent AI 项目会在 2027 年底之前被取消。
世界质量报告里那个数字更直接:真正把 AI 测试做到企业级规模化的,只有 15%。
一边是铺天盖地的「AI 测试元年」,另一边是 15%。
差在哪?我的答案很朴素:大部分团队是在「试用期结束」那一步输的,不是在使用中输的。
这些工具,没有一家公开报价
你去翻 Testim、Applitools、mabl 的官网,会发现一件挺有意思的事:它们几乎都不标价格,所有档位写的都是「Contact Us」。
这不是巧合。不公开报价的东西,价格往往取决于「你有多想买」。
量级大家心里都有数:企业级的 AI 测试平台通常按座席、或者按云端执行额度计费,一年的钱,够你在团队里招一个初级测试。
所以第一个问题就摆在这了:
如果这笔钱换成一个人,你希望那个人干什么活?
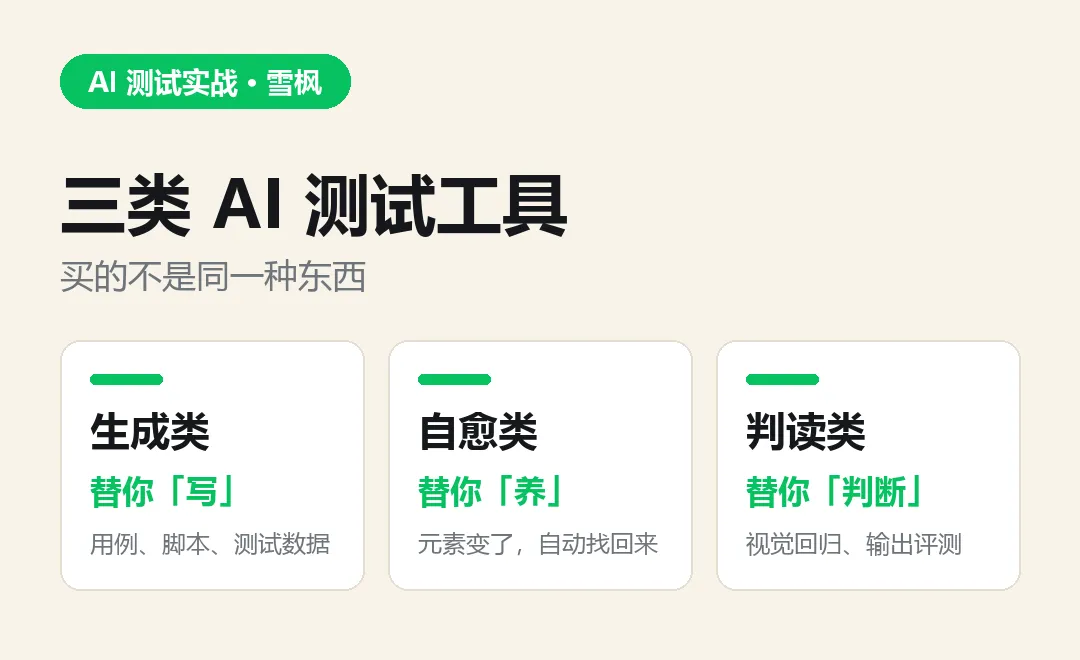
这句话想清楚,选型就完成了一半。因为 AI 测试工具压根不是一类东西,它是三类,各自替你干的活完全不同。
生成类工具最容易在第二个月被闲置
这一类解决的是「写」的问题:用自然语言生成测试用例、生成自动化脚本、生成测试数据。
它是最热闹的一类,也是闲置率最高的一类。
原因在于,它生成的东西质量分布很不均匀。业内的实测口径是:正常路径上的准确率能到 85% 以上,一旦进入边界值和异常场景,会掉到 60% 左右。
这个断崖是有道理的。AI 是从「常见模式」里学写测试的,而每个项目真正的异常处理,往往是为某个具体业务定制的——「余额不足」这个场景,代码里写的是跳转充值页,AI 很可能断言成「弹出错误提示」。
生成类工具替你省的是打字的时间,不是判断的时间。判断那一部分,一点都没少。
所以判断标准非常具体:你团队里有没有人,能一眼看出 AI 生成的那 40 条用例里,哪 12 条是错的?
有,这类工具立刻能用。没有,它只会变成又一项「审查 AI 产出」的负担。
自愈类工具卖的是省心,赌的是静默漂移
这一类解决的是「维护」的问题。
自动化测试最烦的不是写,是养。界面动一个按钮位置,几十条用例一起红,测试同学一下午就过去了。自愈类工具宣称的正是这件事:元素变了,AI 自己重新找到它,用例接着跑。
这确实是真的,也是 AI 在测试领域最扎实的一个价值点。
但它有个副作用,名字挺好听,叫「静默漂移」。
一个测试悄悄修好了自己,你没法知道它这次修的是「按钮换了位置」,还是「绕过了那个按钮」。
测试还是绿的,但它验证的东西可能已经不是原来那个了。这种失败比红色的失败更危险,因为没人会去翻一个绿灯。
所以这类工具的选型判断很具体:它自愈的时候,留下什么记录? 是明确告诉你「我改了哪个定位、改成了什么」,还是只在报告角落里记一笔?
前者能用,后者要谨慎。你买的是省心,不能把可见性一起买掉。
判读类工具最贵的不是钱,是审查工时
这一类解决的是「判断结果对不对」的问题,典型的是视觉回归,以及 AI 输出的评测。
它最容易被忽略,却可能最贴你的日常——因为视觉和体验判断,恰恰是 AI 到现在也没真正拿下的能力。
麻烦在误报。视觉对比工具的误报率,公开口径是 8% 到 12%。单看不高,算一下:项目每天有 50 个组件变更,那就是每天 4 到 6 个假警报,等着人一条条看过去。
误报最贵的代价不是审查时间,是团队习惯了忽略它——报告一旦被无视,工具的价值就归零了。
所以这类工具要问的不是「它准不准」,而是:我们有没有人,会认真看它每周报出来的差异?
试用期该问的六个问题
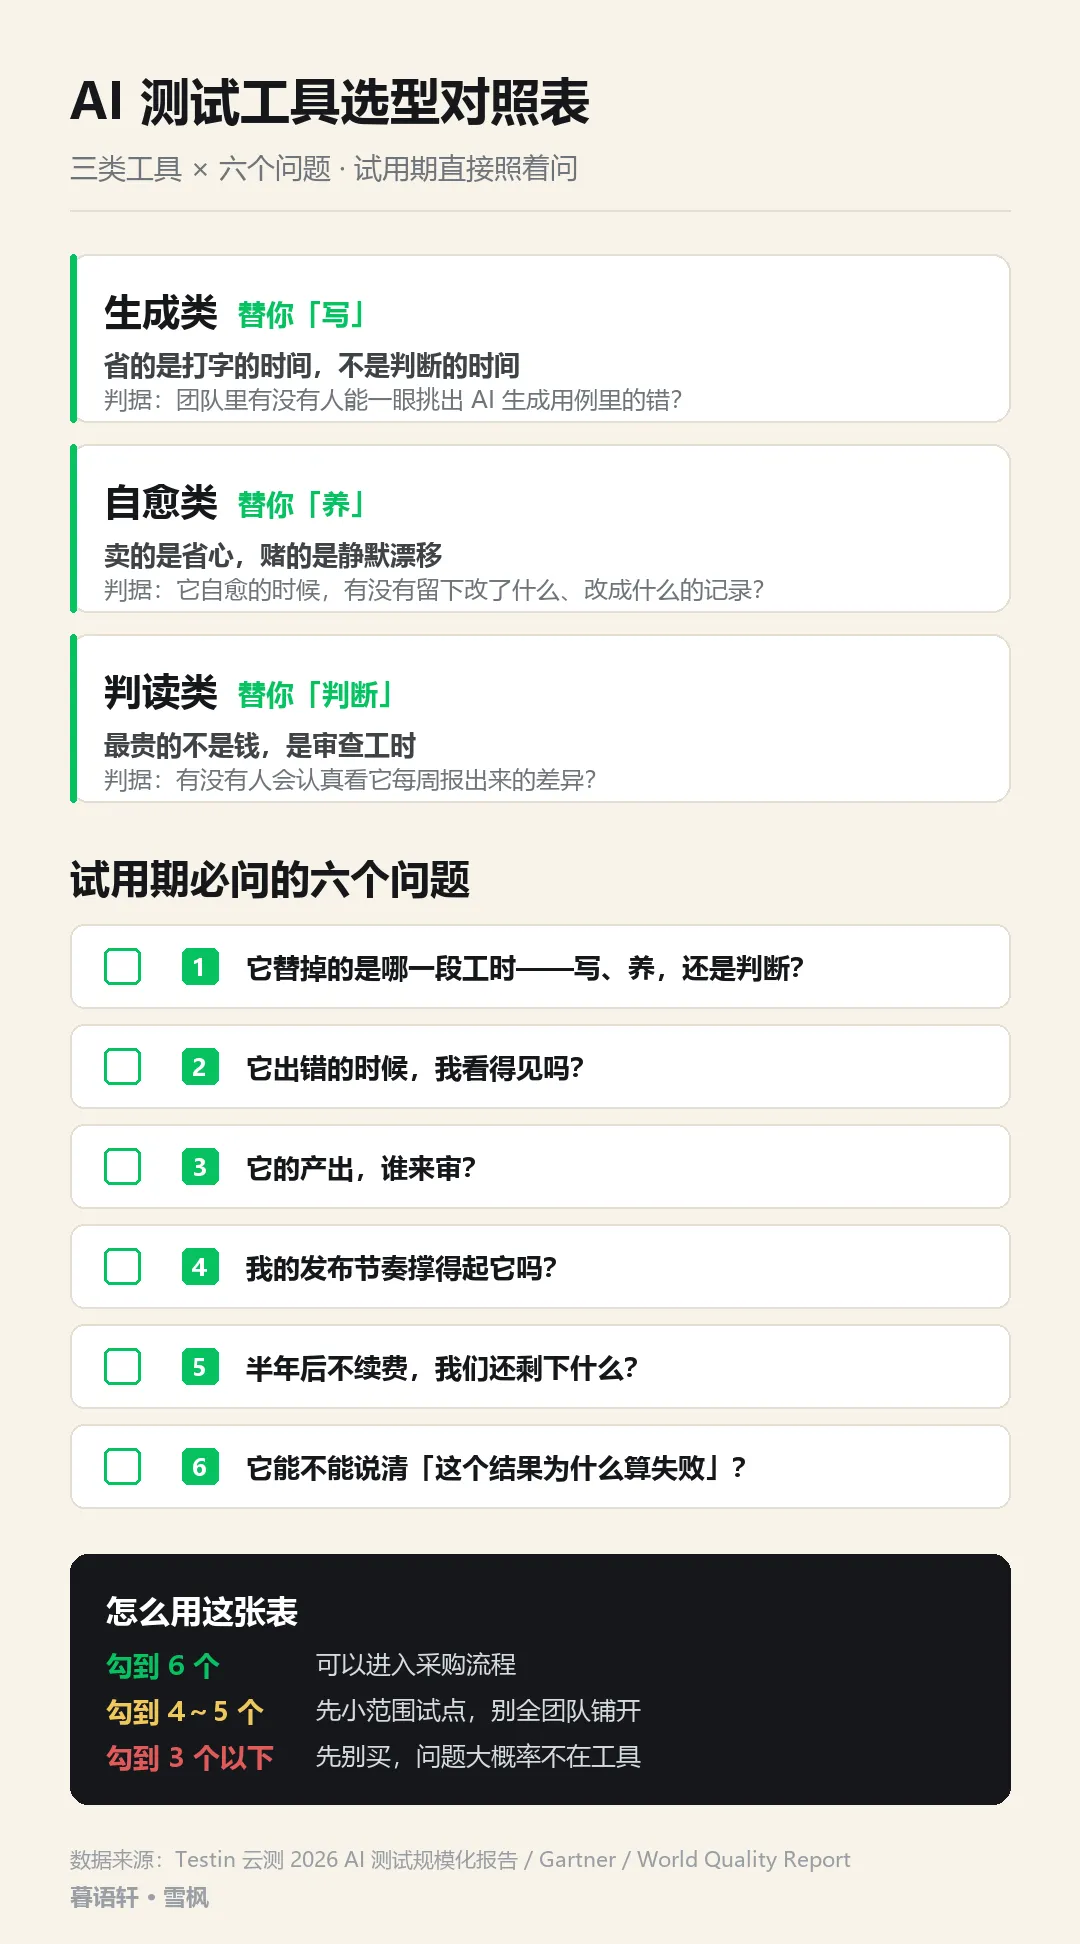
三类讲完,你会发现它们共用一套判断逻辑。我把它整理成六个问题,以后你试用任何一个 AI 测试工具,直接照着问。
1. 它替掉的是哪一段工时——写、养,还是判断? 答不上来,说明你还没定位清楚自己的问题。
2. 它出错的时候,我看得见吗? 自愈有没有留痕、误报有没有分类。
3. 它的产出,谁来审? 没有审查人的工具,最后都会变成新的技术债。
4. 我的发布节奏撑得起它吗? 业内有个判断是:一年发布不到两三次的项目,迁移成本根本收不回来。
5. 半年后不续费,我们还剩下什么? 是留下一堆自己写的用例,还是只剩一个空账号。
6. 它能不能说清「这个结果为什么算失败」? 答不出来的,就是在让你盲信。
第六个问题尤其值得追。51Testing 上有篇分析 AI 测试 Agent 局限的文章讲得挺透:AI 看不到「这段代码为什么这么写」——它看不到去年那次 P0 事故打的那个补丁,也看不到生产环境的脏数据长什么样。所以它给出的「全部通过」,你没办法完全信。
什么情况下,我的建议是先别买
说句公道话。
有三类团队,现在买 AI 测试工具,我建议先停一下。
一种是用例本身还没跑顺的。 自动化测试自己都在飘、都没人维护,再叠一层 AI,只是让混乱跑得更快。
一种是发布节奏慢的。 一年发两三次的项目,靠人工回归就够了。AI 测试工具的收益随「变更频率」放大,变更少,收益就薄。
还有一种是团队里没人能审 AI 产出的。 这条最要命。Testin 的报告里还有一组数字:50% 的组织缺少 AI/ML 专业人才,这个比例和 2024 年持平。工具能买,人的能力买不来。
反过来说,如果你发现自己符合两条——变更频繁,并且有人能审——那 AI 测试工具对你是真有价值的。而且价值不在「省人」,在「把以前不敢测的覆盖面补上」。
最后
回到开头那个 15%。
它不是技术门槛,是组织门槛。Gartner 预判会被砍掉的那 40% 项目,砍它们的理由也很统一:成本失控、价值说不清、风险控不住。
这三条,恰好都是选型阶段就该问出来的问题。
所以在掏钱之前,把那份对照表填一遍,比多看十篇工具测评管用。
我把这套判断逻辑做成了一份《AI 测试工具选型对照表》——三类工具对照六个问题,每一项都能打勾,最后一列写着「勾到几个可以买、勾到几个先别买」,试用期可以直接打印出来照着问。
后台回复「选型」,领这份对照表。
这个选题我会一直跟下去。工具每年都在换代,每次有真实变化,我都会更新进这份表里——关注之后回复同一个关键词,拿到的永远是最新版。
下一篇我还没定。如果你团队正在纠结某个具体的工具,评论区留个名字,我按票数排。
来源与说明:本文引用的行业数据来自 Testin 云测《从试点走向工程化:AI 测试规模化的能力跃迁路径》报告(2026-08,含 AI 非采纳者比例 4%→11%、Gartner 预测修正、超 40% Agent AI 项目将被取消、50% 组织缺乏 AI/ML 人才)与 World Quality Report 的规模化比例;「AI 测试 Agent 的上下文局限」引自 51Testing 公开分析文章;三类工具的划分、六个问题、「先别买」的三条判断,以及 happy path 85%/边界 60%、视觉误报 8%–12%、发布节奏阈值等业内口径,均为作者综合公开资料后的个人整理,不代表任何厂商立场。