ARTICLE · 1215472
ASPIRE 源码精读:机器人给自己写代码修 bug,调试经验怎么攒成可迁移的技能库
ASPIRE 源码精读:机器人给自己写代码修 bug,调试经验怎么攒成可迁移的技能库BEHAVIOR-1K 里有个任务叫「导航过去捡起收音机」:机器人明明看见了收音机,感知调用也成功返回了位姿,却一遍遍卡在同一个地方——导航接口连续返回规划错误,机器人就是凑不过去。NVIDIA GEAR 实验室上个月把它做成了新版 ASPIRE 的招牌案例,10 月 16 日仓库推送 v1.0 后,这两天正挂在 GitHub 的 Python 日榜上。我把论文和代码都读了一遍。 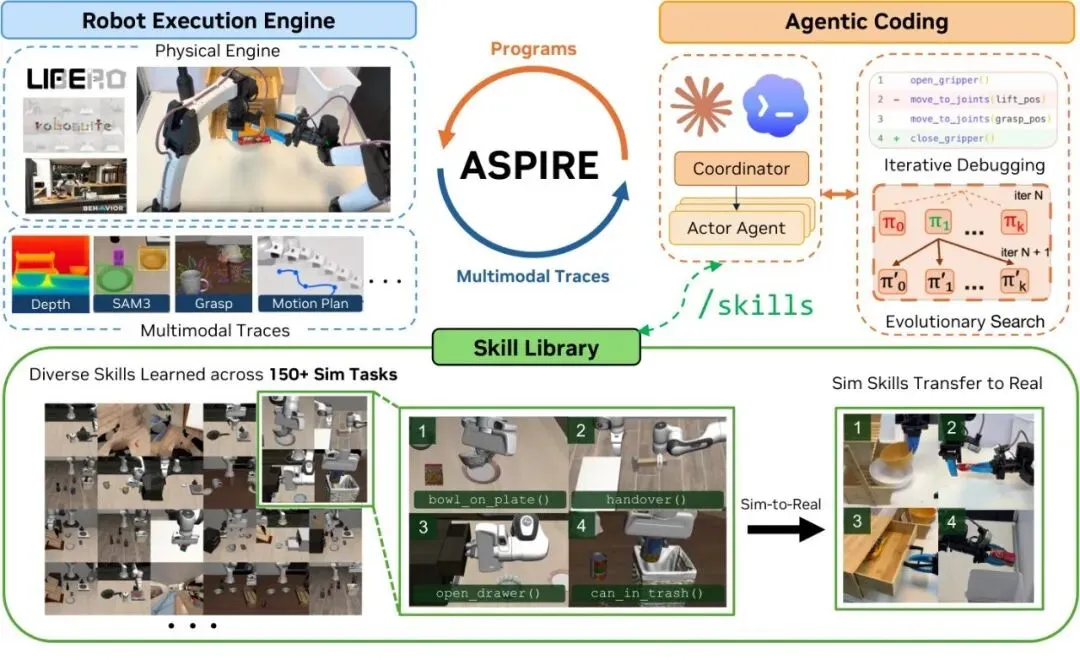
ASPIRE 全称 Agentic Skill Programming through Iterative Robot Exploration,NVIDIA GEAR 实验室牵头,与密歇根大学、加州大学伯克利分校等合作,论文 2026 年 7 月挂上 arXiv,代码开在 NVlabs/ASPIRE,现在六百多个星标。 它解决两件事:编码智能体给机器人写控制程序时,不再只拿到「任务成没成」这种粗反馈;做完一个任务,修 bug 的经验不再被扔掉,而是沉淀成可复用的技能库。 做法上改了三处:执行引擎按原语粒度记录多模态轨迹;验证过的修法蒸馏成技能条目;进化搜索防止智能体在一条错路上反复打补丁。 数字(论文口径):LIBERO-Pro 扰动套件最高领先此前方法77 个百分点,Robosuite 双臂交接任务从 20% 提到 92%,BEHAVIOR-1K 长程家务任务最高领先 32 个点;用 LIBERO-90 攒出的技能库零样本打 LIBERO-Pro Long,成功率 31%,此前方法只有 4%。 停在什么条件:全流程依赖冻结的前沿模型(论文用 Claude Opus 4.6、100 万 token 上下文),作者没验证过更小的模型能不能撑住这个调试循环。想快速上手,只看一个文件:.claude/skills/iterative-debugging/SKILL.md,整套调试战役的编排规则都在里面。 回到开头的收音机。论文第 2 节把这次失败拆开了:感知没问题,物体位姿拿得到;真正的原因是导航目标点落在了桌子的碰撞避让缓冲区里,规划器反复拒绝。失败不在检测、不在抓取,在目标位姿本身不可行。可任务级反馈只会告诉你「没成功」。 这正是机器人程序调试麻烦的地方:感知、运动规划、抓取生成、接触动力学、长程任务协调,一个 rollout 崩了,可能是其中任何一环的锅。固定的人工设计反馈接口两头不讨好——信息太少会藏住出错的原语,原始视频一股脑塞进来又让智能体抓不住因果链。 现有方案还不攒经验。论文选的主要基线 CaP-Agent0,每个种子都重新生成一份程序,靠测试时推理和重试硬顶。论文里有句原话:解第一百个任务的智能体,并不比解第一个的更有经验。 人类工程师不这么干活。程序失败后回放执行、查看感知输出和轨迹、定位出错的子系统、改实现,再把修法记成套路。ASPIRE 做的事,就是把这套流程原样交给智能体自己跑。 主线是协调者-演员架构。一个协调者管理共享技能库、给每个任务派一个 actor 编码智能体;actor 负责写程序、执行、诊断、修复。actor 之间不共享聊天记录和原始轨迹,可迁移的经验全部蒸馏进技能库,各自的上下文窗口留给任务本身。 第一个设计是执行引擎。每次感知、规划、抓取、控制调用都记一条轨迹:调用了哪个接口、输入输出、返回状态,配上 RGB 帧、覆盖层、抓取候选、物体位姿、规划结果。运动类原语前后各保留一帧,智能体看的是出错调用紧邻的证据,不是整段视频。 第二个设计是技能库的条目格式。存的不是完整任务程序,而是失败签名、适用条件、修法策略,外加一段有代表性的代码草图。准入有闸门:验证者智能体拿不到提出者的代码,只凭技能库和提案重解任务,两轮内做出来才算转正。 进化搜索补上探索短板。单轨迹调试容易陷进局部修补循环,于是每轮让模型基于历史表现最好的三个程序和失败轨迹,提出一组 K 个候选程序全部执行,下一代条件于幸存者和剩余失败模式。 论文算法 1 的记号可以当公式看:Execute(P, S) = (r, Z)。P 是候选机器人程序,S 是执行用的种子集合,r 是得分、Z 是这次执行产生的轨迹束。整个搜索就是反复调用它:提候选、执行、按 r 排序、把 Z 喂回下一代,分数过阈值就停。 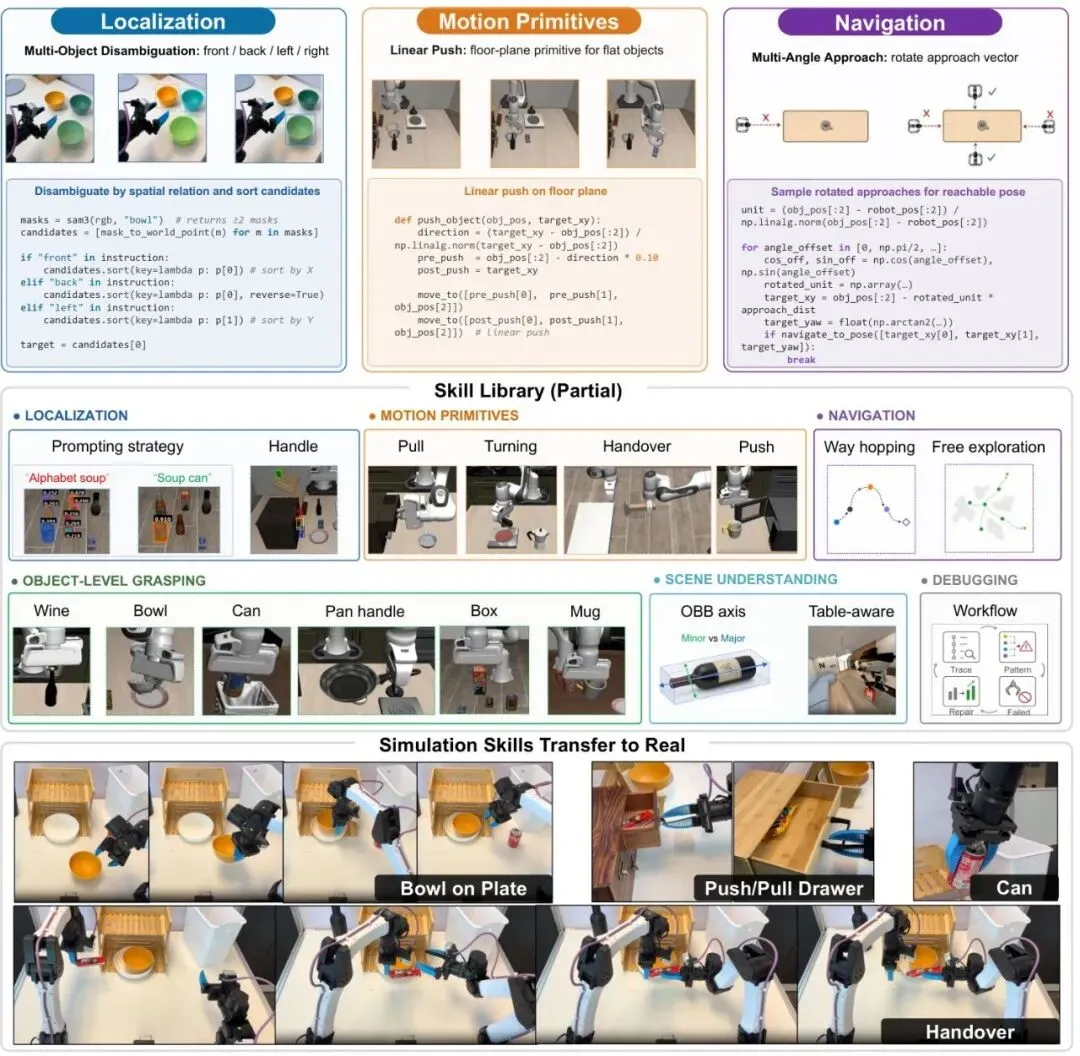
先说清调用链:这个仓库没有传统意义的训练入口,编排本身就做成「技能」。init_run.py 建战役目录 outputs/runs/<时间戳>/,协调者按 main-agent-prompt.md 派 actor(subagent-prompt.md),actor 产出并调试程序,协调者跑 run_validation.py 做 held-out 评测,verifier-prompt.md 验证技能提案,通过的写进 skills/ 目录。examples/ 下能看到 actor 产出的程序长什么样。 第一处对读:论文 2.1 节说引擎「保留每个原语调用前后紧邻的帧与覆盖层」,对应 src/cap_harness/runtime.py 里的 _recorded_tool_call: motion = name in { "step", "execute_trajectory", "set_gripper", "set_grippers", "move_to_joints", "move_to_pose", "move_synchronized", "open_gripper", "close_gripper", "go_home", } if motion: self._recorder.keyframe(f"before-{name}") with self._recorder.span(name, category="program", inputs={"args": args, "kwargs": kwargs}) as span: result = self._invoke_tool(name, function, args, kwargs) 白名单里的都是运动原语,前后各落一帧,跟论文表述逐字对上。每次调用落成一条 CallTrace,字段包括 tool、ok、duration_s、inputs_summary、outputs_summary、failure_code——正是论文列的「接口、输入输出、返回状态、多模态证据」。顺带一个部署细节:生成程序跑在受限命名空间里,import 只放行 math;README 同时警告这不是安全沙箱,生成的 Python 有完整 import 权限,必须在隔离主机上跑。 第二处对读:论文 3.3 节「学习与评测种子分离」加 2.2 节「只有验证过的修法入库」,对应 SKILL.md 的运行顺序和 run_validation.py 的实现: HELDOUT_SEEDS = list(range(1, 51)) a seed passes on
LIBERO 默认三段种子:51–65 调试学习、66–80 未见检查、1–50 是 held-out 评测。run_validation.py 的头注释写明,run identity 把程序、基准、任务、种子、init 模式全部哈希进一个指纹,不同指纹的结果永不混算;计分只认 task_success,program_ok 仅作分诊用。SKILL.md 第 4 步写得更直白:只有验证通过的提案才会晋级进 skills/ 目录。要区分的是,这套种子划分是 LIBERO 的默认行为(seeded 模式),Robosuite 换成 saved 模式、种子段改成 101–125、126–130、1–100——同一套代码的两种配置,不是两个分支。 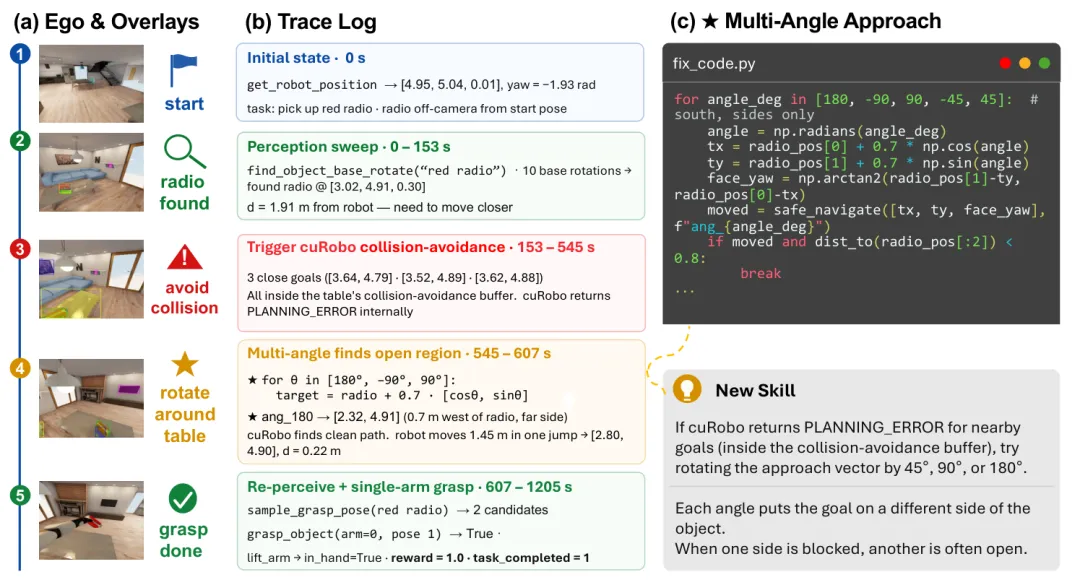
智能体:模拟全流程用 Claude Code 加 Claude Opus 4.6,100 万 token 上下文;程序写在 CaP-X 上,那是基于 MuJoCo Playground 的 code-as-policy 框架,提供感知、几何、运动规划接口。agent、环境、API 集合全程固定。 三个基准与划分:LIBERO-Pro 每套件 10 个任务、50 个 held-out 种子(学习用 51–65);Robosuite 每任务 100 个 held-out trials(学习用 101–125);BEHAVIOR-1K 两个长程家务任务(学习 26–35、评估 1–25),评估用增量块执行——每个代码块都从当前的多模态轨迹生成。 基线:编码智能体一侧是 CaP-Agent0,视觉差分、预定义技能库、逐集重试;端到端 VLA 一侧是 OpenVLA、π0、π0.5;另加人类专家手写的程序。 实机是另一套设置:OpenAI Codex GPT-5.5 推理模式拉满,跑在 YAM 双臂操作站上,本体和 API 都与仿真不同;三个仿真学到的技能(苏打罐、碗、抽屉)作为 in-context 指导注入,对比有技能和没技能两组。 最影响可比性的一条:ASPIRE 每任务只生成一个程序,跑全部 held-out 种子;CaP-Agent0 每个种子重新生成程序、带测试时推理和重试。两边协议的努力量不对称,读数字时得记着。 LIBERO-Pro(论文图 4a):位置、任务两类扰动平均后,对每套件最强基线的增益是 Object 加 77、Goal 加 41.5、Spatial 加 42.5 个百分点。π0.5 在部分位置扰动上强于 OpenVLA 和 π0,但离 ASPIRE 还远,任务改写下基本崩掉。 Robosuite(图 4b):简单接触任务接近饱和,双臂交接从 20% 拉到 92%。BEHAVIOR-1K(图 4c):导航和任务成功两个口径都超过人类程序与 CaP-Agent0,捡收音机任务的任务级成功率从 56% 到 88%。 零样本(图 5):LIBERO-90 攒的库直接打 LIBERO-Pro Long,位置扰动 23%、任务扰动 38%,两个轴都压过基线;库规模从 0、25、50 加到 90,成功率一路走高。 实机(表 1):碗上盘 20/20 对 20/20,token 从 8.65M 降到 5.11M;举苏打罐 13/20 到 19/20,token 从 61.94M 降到 6.58M;推拉抽屉 0/20 到 11/20,token 从 334.9M 降到 81.7M。token 降是一致的,成功提升是任务依赖的——作者自己也这么写。 消融(图 6):去掉两个组件的基座宏平均 14%,加执行引擎到 62%,再加进化搜索到 72%。搜索轮数上前几轮收益最大,之后递减。 仓库 v1.0(10 月更新)的 README 另给了一批数字:80 个 LIBERO-Pro 任务 99% 成功、新增魔方任务、模型规模从 GPT-6 Luna 的 15% 到 Claude Opus 5.5 的 99%。那是 README 口径,基座与论文不同代,我没有跑,不当论文数字来用。 已对应的部分:三个组件在仓库里都找得到实体——runtime.py 的受限执行与轨迹记录、.claude/skills 与 .codex/skills 下的技能库与战役编排、evosearch 技能;种子划分、验证者准入、held-out 协议逐条能对上。 实现补充的部分:协调者、actor、验证者在仓库里直接做成了 Claude Code 和 Codex 的 agent skill,两个目录各一份。训练循环本身就是一个编码智能体工作流,论文没有展开这层工程形态,读代码时值得留意。 只是配置选择的部分:examples/ 里 close_microwave.py 用四个固定横坐标扫把手候选,是 seeded 模式下的程序策略,程序读不到仿真器内部状态,不算作弊;技能文件 grasp.md 写明 close_gripper() 与 set_gripper(0.0) 不等价——接触停顿也算闭合成功,这是 harness 的合约行为。模型从 Opus 4.6 到 5.5 的数字变化是时间演进,不是口径打架。 环境:CUDA 主机、uv、HuggingFace token(SAM3 权重是门控的);照 docs/host-setup.md 走,LIBERO 用 scripts/bootstrap_libero.sh 建 .venv-libero,渲染后端设 MUJOCO_GL=egl。 最小样例:按 README Quick Start 的提示词把仓库交给 Claude Code 或 Codex,让它跑 libero_goal_swap 十任务快速通道;正式开跑前它会先报 GPU、凭证、种子划分、输出路径,等你确认。 成功标志:outputs/runs/<时间戳>/ 下出现 campaign.json、每任务目录、outcome.json 和 held-out 结果表;技能目录新增经过验证的条目。 容易看错的一处:三段种子别混——51–65 学习、66–80 未见检查、1–50 才是评测;计分只认 task_success,程序崩了但任务完成照样算过。再提醒一次,生成的 Python 有完整 import 权限,别在带凭证的机器上跑。 有证据的价值:消融里执行引擎单独贡献 14% 到 62% 的大头,说明按原语粒度暴露证据这件事换到任何智能体调试场景都成立;技能库是纯文本,markdown 加代码草图,可读、可审、可回滚;零样本曲线和实机 token 表一起支撑了「修法可迁移」的主张,而不是记住了仿真器的代码。 限制也摆在明处:依赖单一前沿模型,小模型没验证;程序只能用预定义的感知规划控制接口,任务需要面外能力就得人来扩 API;库的长期管理没解决,条目会过期、冗余甚至误导,零样本曲线有非单调段;每个任务要烧大量模型调用和仿真 rollout,作者在局限一节自己算了这笔账;实机侧还不是自主终身学习,成功检测、安全复位、标定维护仍然要人。 想抄作业的读者抓两件事就够:把反馈按原语粒度拆开,把修法先验证再入库。剩下的进化搜索、双臂硬件,都是在这两块地基上的加法。
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
a seed passes on task_success alone