ARTICLE · 1219720
NAS 文档管理神器!极空间部署 Paperless-ngx 文档自动 OCR 归档
平时电脑和 NAS 里面最容易乱的,除了照片和视频,应该就是各种文档了。
发票、合同、说明书、保修单、账单、证件扫描件、 PDF 资料……刚保存的时候觉得随便建个文件夹就行,时间一长就会发现,同一类文件可能散落在十几个目录里,真要找的时候完全记不起文件名。
那我们的 NAS 基本都是 7×24 小时运行的,能不能干脆在 NAS 上部署一套真正的文档管理系统?
最近就折腾了一下 Paperless-ngx。
Paperless-ngx 是什么?
Paperless-ngx 是一个开源、自托管的文档管理系统。
简单来说,就是把原本散落在电脑、手机和各种文件夹里的文档统一丢进去, Paperless-ngx 帮你完成 OCR 、归档、分类、标签以及全文搜索。
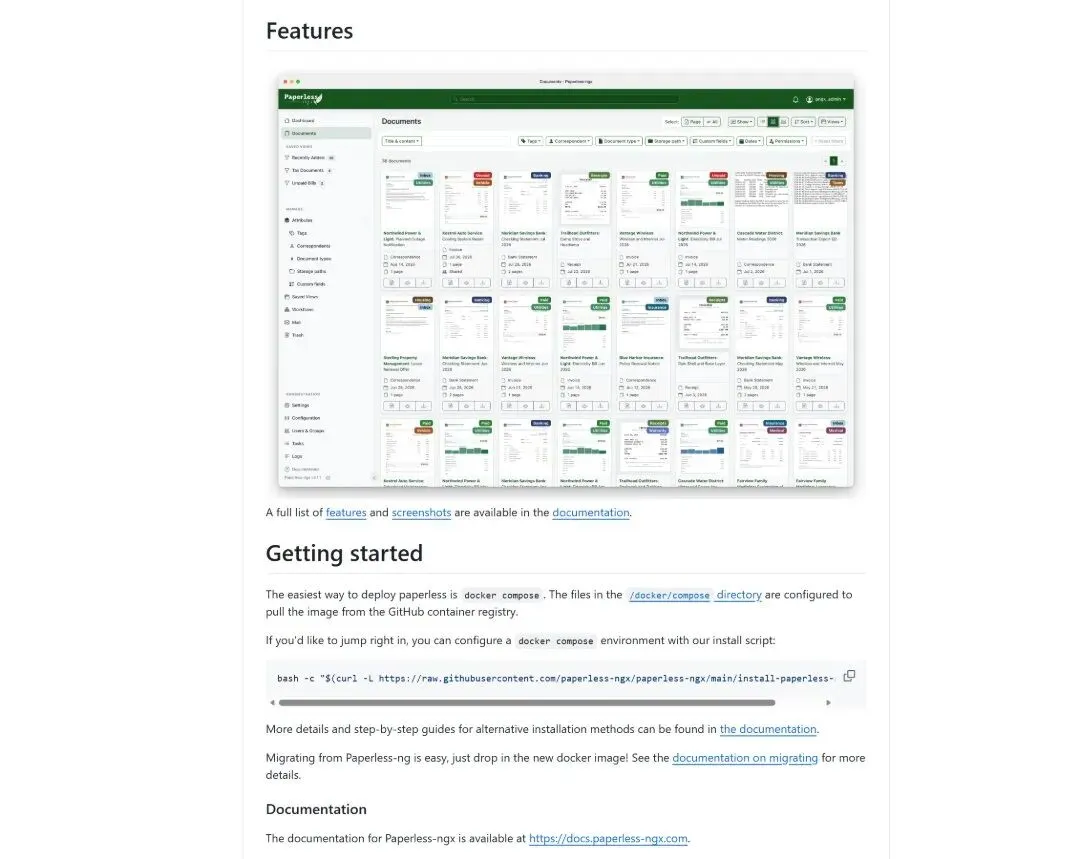
它底层使用 Tesseract OCR ,支持 100 多种语言;处理后的文档可以保存为适合长期归档的 PDF/A ,同时原始文件也会继续保留。
比如一张 PDF 格式的发票,原先只能通过文件名来搜索。
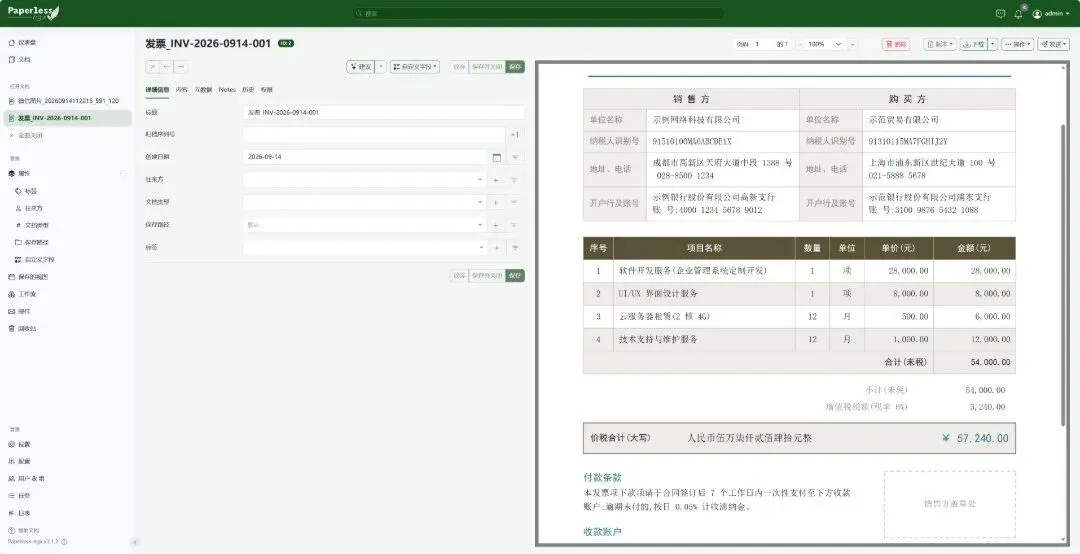
导入 Paperless-ngx 之后, OCR 会把里面的公司名称、金额、日期等文字提取出来,以后直接搜索内容就能找到。
除了 OCR ,它还有联系人、文档类型、标签、自定义字段、工作流等功能,基本已经是一套比较完整的电子文档归档系统。
极空间部署 Paperless-ngx
Paperless-ngx 官方已经提供了 Docker 镜像,而且支持 AMD64 、 ARM 和 ARM64 ,官方也直接提供了 SQLite 版本的 Docker Compose 。对于个人或者家庭 NAS 使用,其实 SQLite 就已经够用了。
这里咱们依旧直接使用 Docker Compose 部署:
services:broker:image: valkey/valkey:9-alpinecontainer_name: paperless-brokerrestart: unless-stoppedvolumes:- ./redisdata:/datawebserver:image: paperlessngx/paperless-ngx:latestcontainer_name: paperless-ngxrestart: unless-stoppeddepends_on:- brokerports:- "50009:8000"volumes:- ./data:/usr/src/paperless/data- ./media:/usr/src/paperless/media- ./export:/usr/src/paperless/export- ./consume:/usr/src/paperless/consumeenvironment:PAPERLESS_REDIS: redis://broker:6379PAPERLESS_DBENGINE: sqlitePAPERLESS_TIME_ZONE: Asia/ShanghaiPAPERLESS_SECRET_KEY: "这里换成自己的随机密钥"PAPERLESS_ADMIN_USER: adminPAPERLESS_ADMIN_PASSWORD: "这里换成自己的登录密码"PAPERLESS_OCR_LANGUAGES: "chi-sim"PAPERLESS_OCR_LANGUAGE: "chi_sim+eng"
这里主要需要改一下管理员密码,以及 PAPERLESS_SECRET_KEY 。
使用体验
容器正常启动之后,在浏览器输入:极空间 IP:50009 ,就可以打开 Paperless-ngx 。
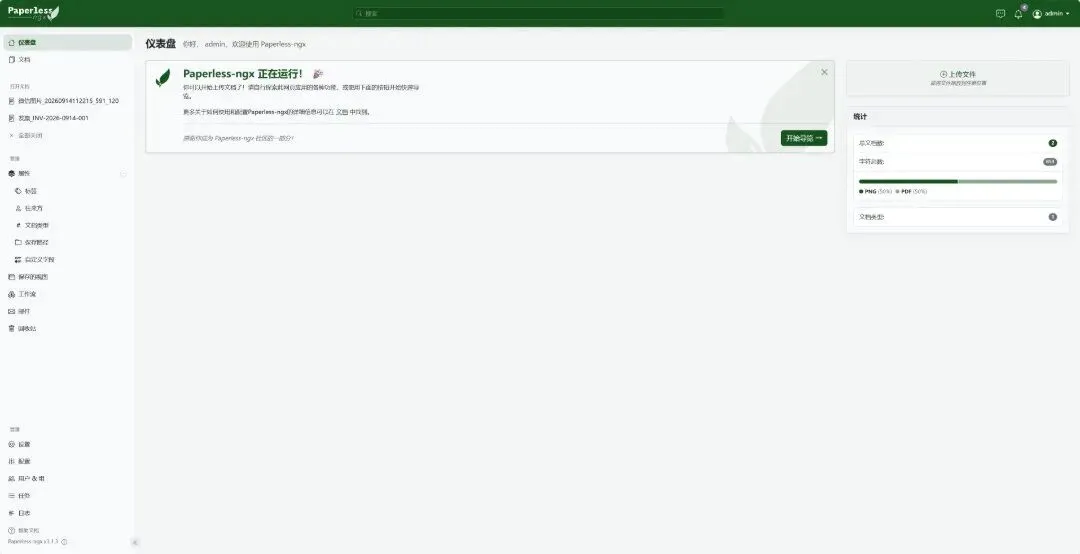
使用我们刚刚在 Compose 中设置的:用户名以及密码直接登录即可。
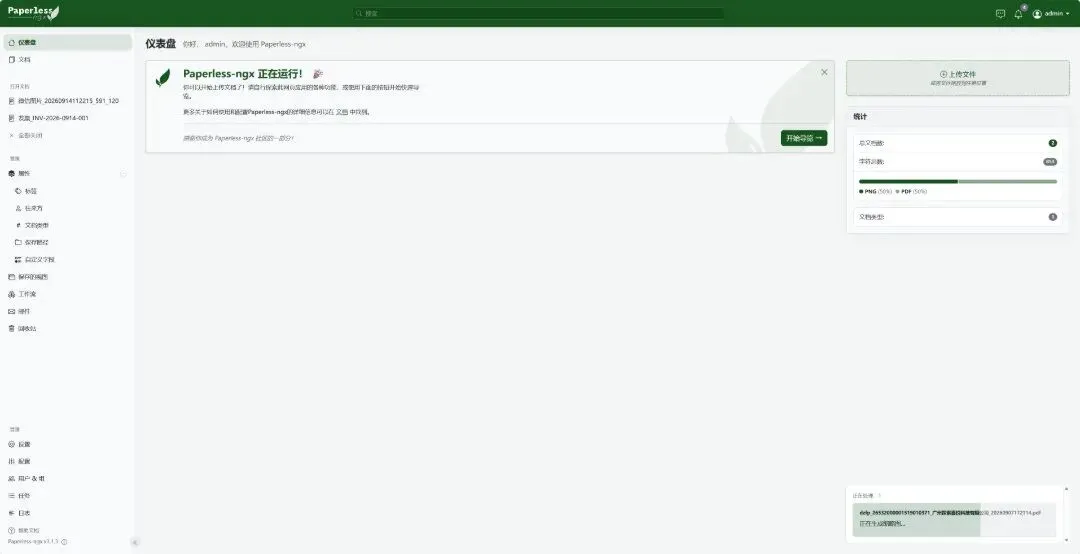
Paperless-ngx 的首页就是比较传统的文档管理逻辑,上传文件也非常简单, PDF 、扫描件或者图片直接拖进去就可以。
上传之后,后台会自动开始处理文档。对于本身就有文字层的 PDF ,可以直接提取文本;如果是扫描件或者图片,则会通过 OCR 识别里面的内容。
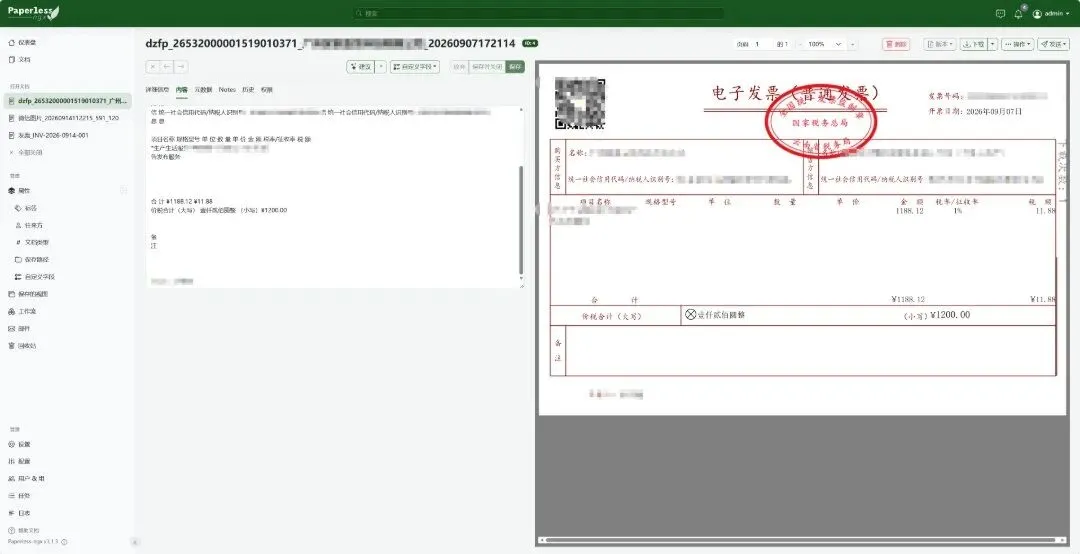
识别完成之后,这些文字就可以直接搜索了。
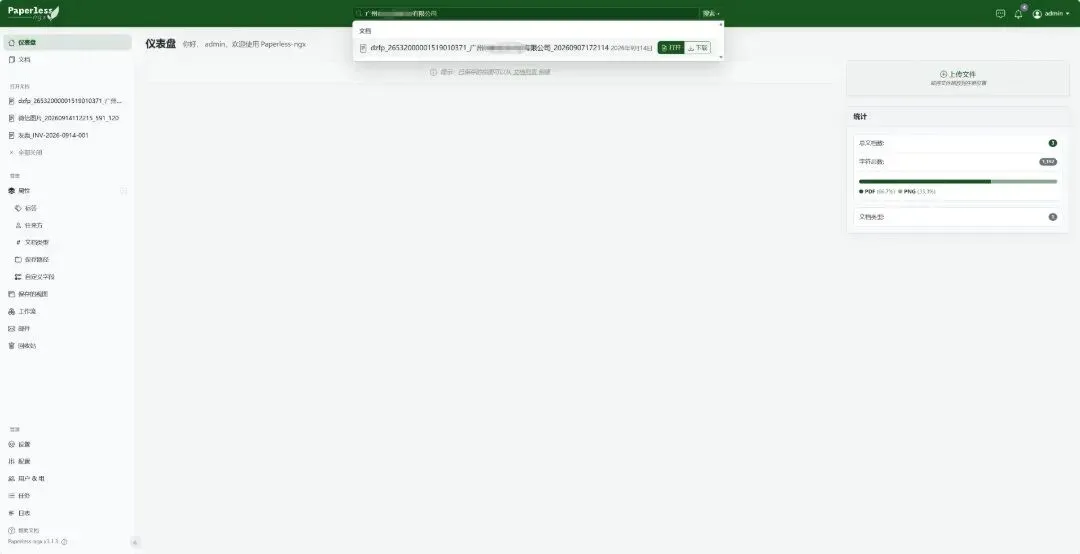
比如我这里上传了一张账单,以后甚至不需要记得文件叫什么名字,直接搜索账单里面出现过的公司名称、产品型号或者金额,就能把对应文件找出来。
分类与标签
当然,如果只是把文档全扔进去,时间久了还是会乱。
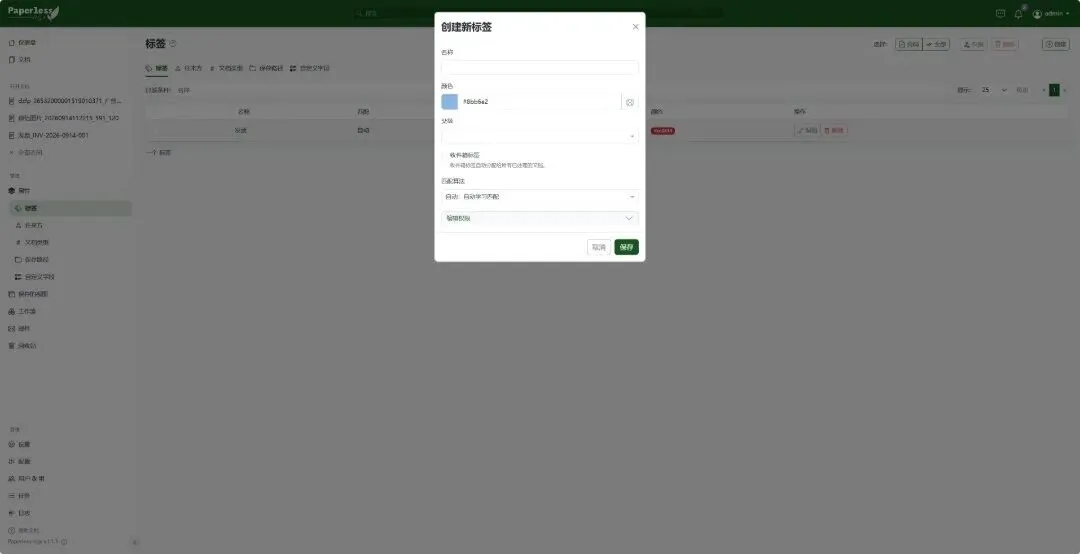
Paperless-ngx 提供了比较完整的分类体系,包括:联系人、文档类型、标签以及自定义字段。
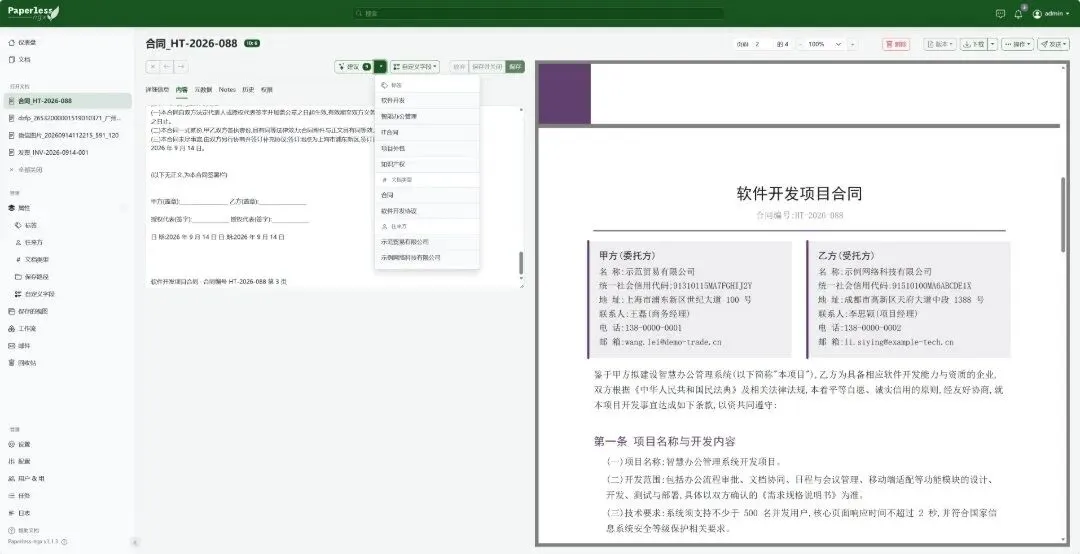
比如合同可以按照甲方公司设置联系人,文档类型设置成“合同”,然后再添加“已签署”“2026”“项目 A”这一类标签。
标签本身还支持父子层级,最多可以建立 5 层的树形结构,所以文档比较多的时候也能整理得比较细。这样后面找资料的时候,就不只是靠文件夹一级一级翻了。
自动导入
paperless 还有个很好用的自动导入功能,前面在部署时咱们已经把./consume 这个文件夹挂载到了 paperless-ngx 的自动导入目录。
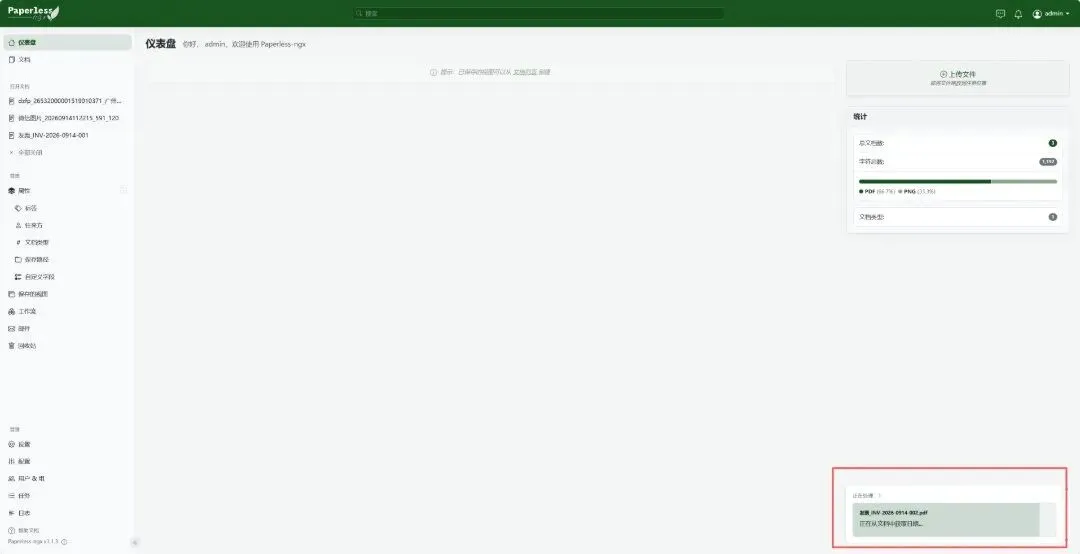
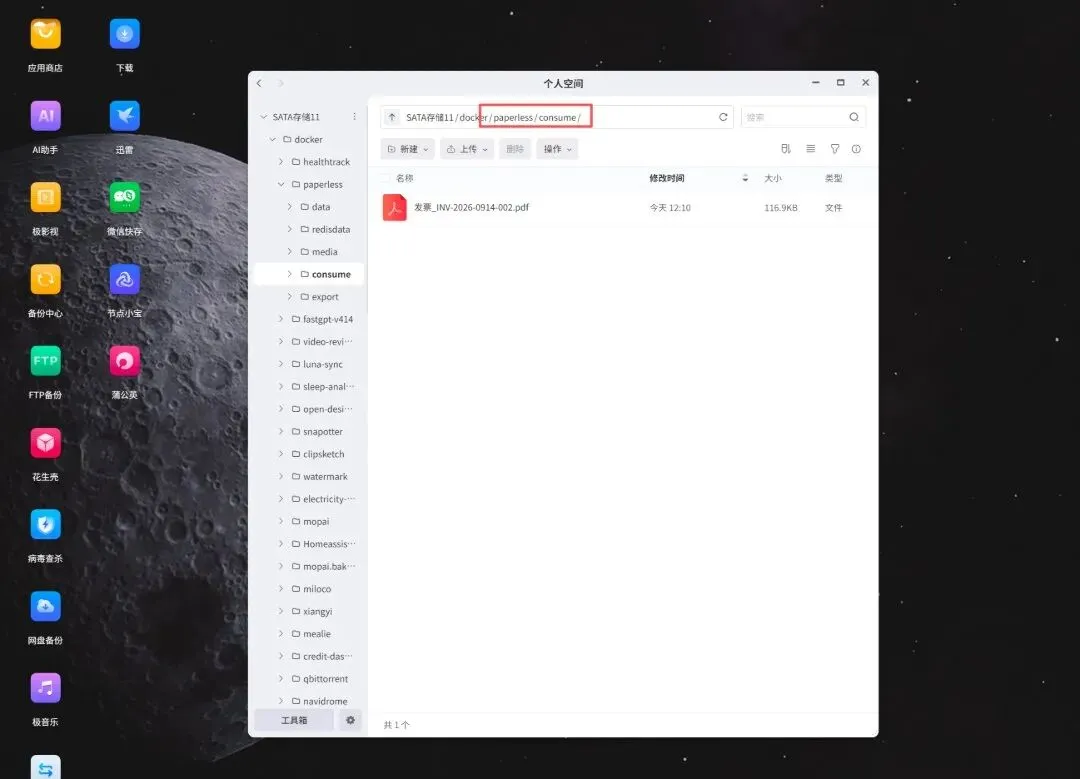
以后有新的 PDF 或者扫描文件,直接扔进这个文件夹,就会自动读取并导入,对于经常需要扫描合同、发票或者纸质资料的人来说,这个流程还是挺方便的。
工作流
Paperless-ngx 还有一个比较有意思的功能就是 Workflow 工作流。
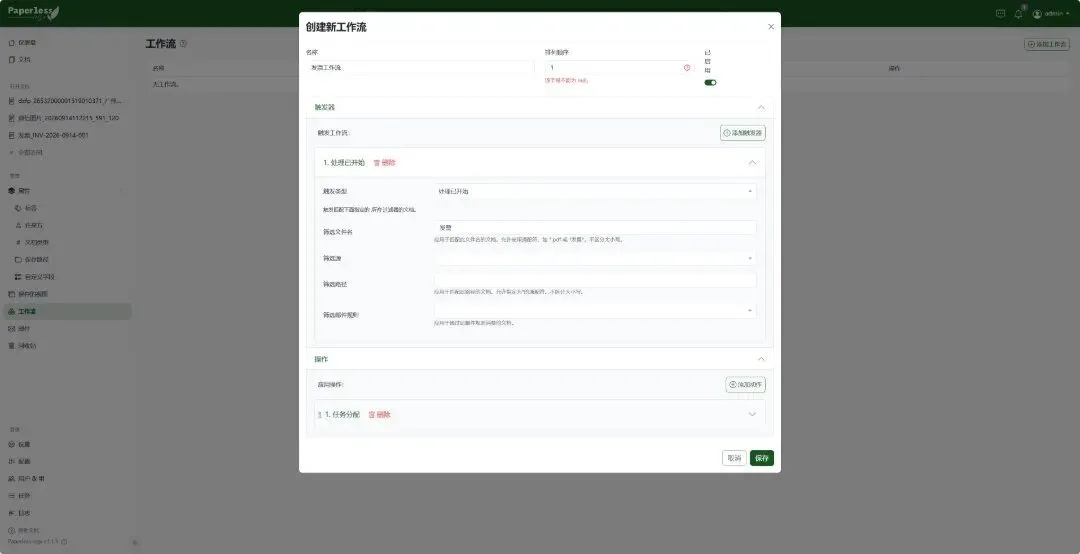
可以根据新文档的内容、类型等条件,自动给文件分配标签、自定义字段或者其它属性。比如:检测到“发票”——自动设置文档类型:发票——自动添加标签:财务。
这项功能呢属于是文档比较少的时候感知不强,但是到了后面积累了几千份资料,就会发现自动化整理还是很省事的。
写在最后
Paperless-ngx 这东西,刚开始用可能感觉不到它有什么用。等你资料越攒越多,再找文件的时候,就知道它省了多少事。
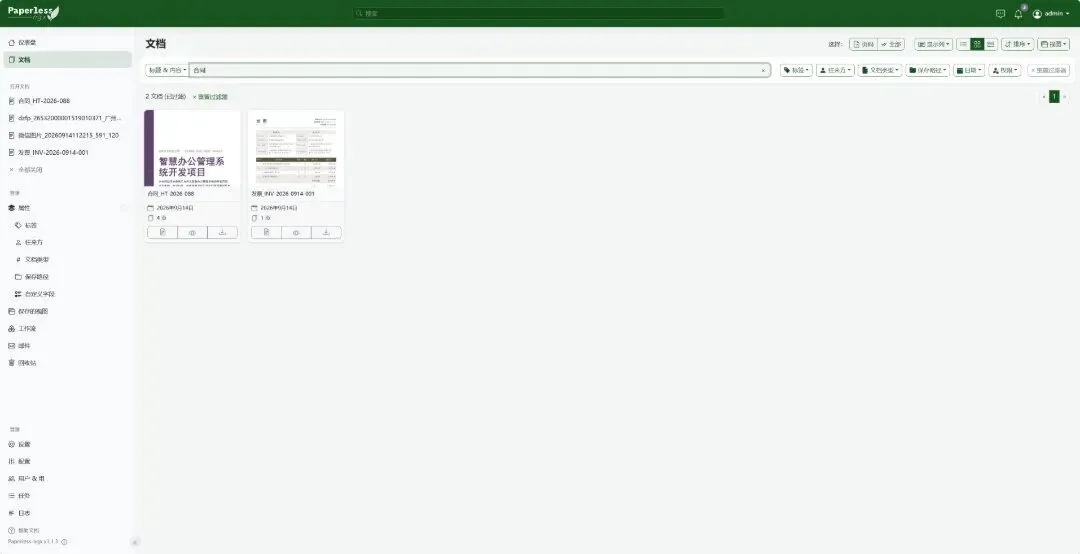
像合同、发票、说明书、扫描件、各种 PDF ,直接丢进去就行。后面的 OCR 、分类、搜索都会顺手很多。尤其是扫描件,以前想找一句话只能挨个文件打开看,现在直接搜关键词,差别还是挺明显的。
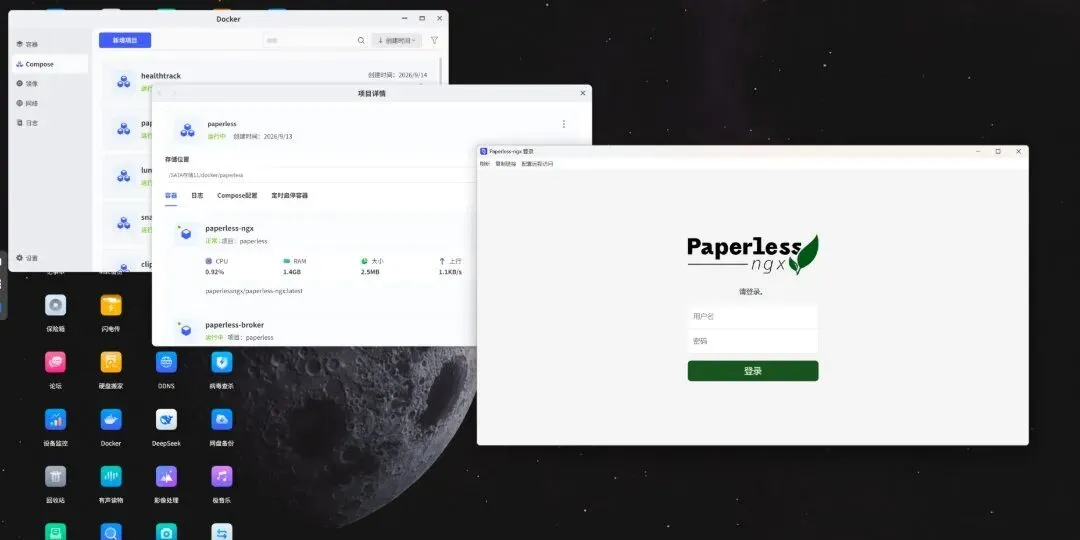
再加上文件本身还是放在 NAS 里,电脑和手机随时都能访问,在外网下,也能使用极空间自带的 docker 外网访问功能,哪天突然要找几年前的资料,也不用再一层一层翻文件夹。
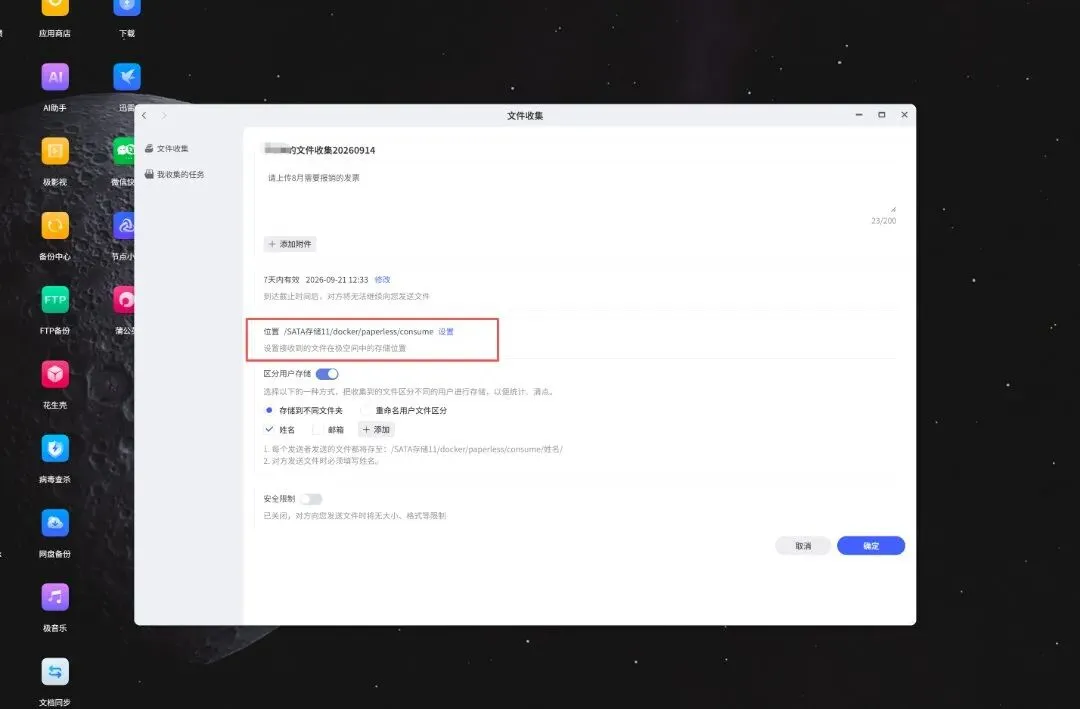
而且,如果是像公司里面要收集员工的报销发票信息,也能直接使用极空间的文件收集功能,将文件收集文件夹设置为 Paperless-ngx 自动同步的文件夹,这样员工上传的发票信息就能直接识别入库。
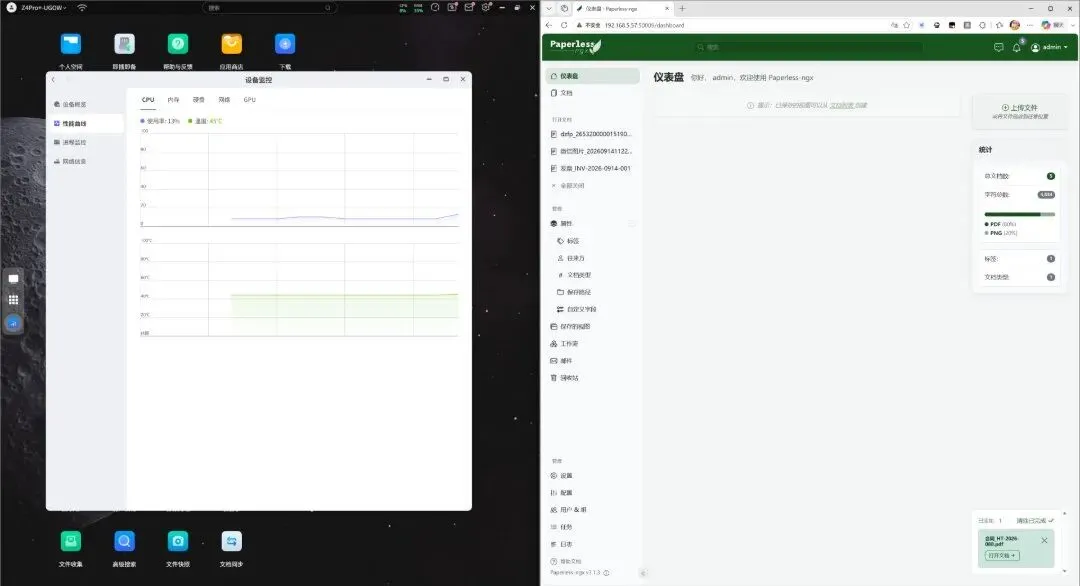
性能占用方面, Paperless-ngx 的 OCR 是完全本地的,咱们这边部署在极空间 Z4 Pro+性能版上,做到入库即识别是完全没问题,并且性能占用也非常低,在 NAS 上部署完全没问题。
好了,这篇就写到这。
希望对你有帮助,我们下篇见。