ARTICLE · 1219712
一文看懂 RAG 完整流程:从文档分块到有依据的回答
资料已经放进知识库,AI 为什么还可能答错?
假设公司售后政策里写着:“设备 A 的保修期限为一年。”
现在,你问 AI:“这台设备可以保修多久?”
它很快给出了一段回答,语句通顺,解释也很完整。但要确认答案靠不靠谱,你还得往回查:它读到的是保修期限,还是保修范围?它说的“一年”,对应的是不是这台设备?
从一份文档到一个答案,中间还有一整条信息处理流程。
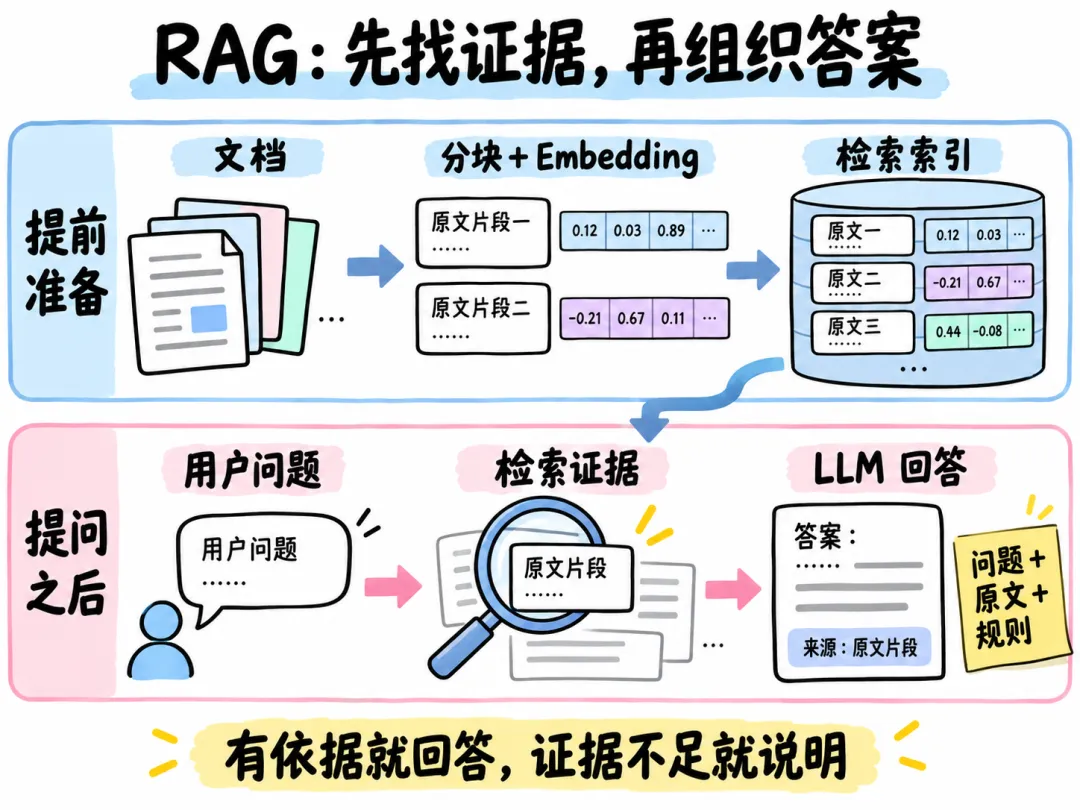
RAG 的作用,就是先找到相关资料,再让模型依据这些资料组织回答。
下面沿着“设备保修多久”这个问题,一步步看清它是怎样工作的,以及每一步可能在哪里出错。文中的期限、设备名称与补贴金额,都只是教学示例。
先用大白话讲清楚 RAG
RAG 的英文全称是 Retrieval-Augmented Generation,中文叫检索增强生成。
大语言模型,也就是 LLM,擅长理解和组织语言。但它不天然知道你公司的内部文件,也可能没见过刚刚更新的规定。
可以把 RAG 想成一次开卷考试:收到问题后,先翻到有关的资料,找到能支撑回答的段落,再根据那段内容作答。
完整过程分成两部分:提前把资料准备好;收到问题后,查找证据并生成回答。
为什么不每次都把所有资料交给模型?因为模型有上下文窗口(Context Window),一次请求能容纳的 Token 数量有上限。Token 是文本的基本处理单位。
资料越多,有效段落越可能被无关内容淹没;重复处理不相关的内容,也会增加成本和等待时间。因此,我们需要先把有关的片段找出来。
1. 文档解析与分块:让资料能够被找到
一份 PDF 对人来说可以直接翻阅,但系统要先从中提取文字和结构。
如果是扫描件或图片,通常还需要 OCR(光学字符识别)。表格、多栏排版和关键数字,都值得在这一步核对。
如果“保修一年”在解析时已经丢失,后面的检索就无从找到它。
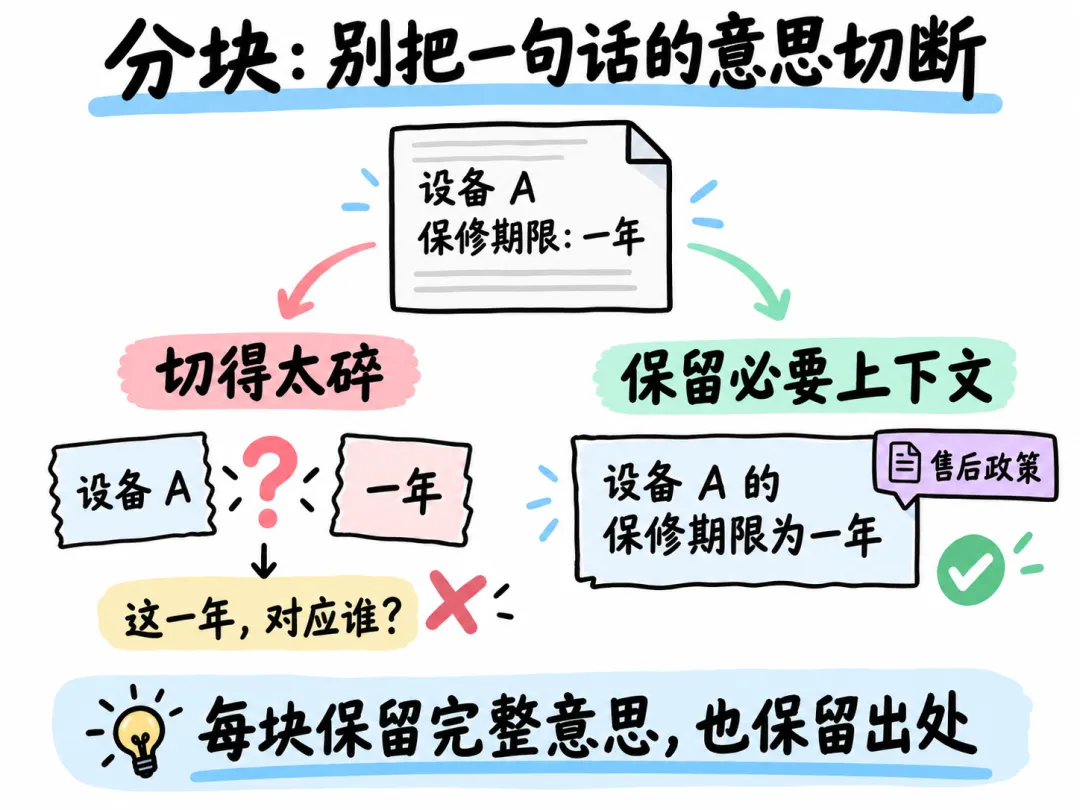
读出内容之后,还要把长文档拆成适合查找的片段。这一步叫 Chunking(分块),每个片段叫 Chunk。
想象把一份手册拆成一叠资料卡。每张卡都应让人知道它在说什么,也能查到它来自哪里。
切得太碎:“设备 A” | “保修一年”保留必要上下文:“设备 A 的保修期限为一年”来源:售后政策它解决什么问题:
把查找范围从整份长文档,缩小到更具体的内容片段。 让片段保留必要的语义关系和来源信息。
容易出错的地方:
块太大,可能混进多个主题;块太小,又可能把设备名称与保修期限切开。块大小、重叠范围和切分边界,需要用自己的资料和真实问题来测试。
2. Embedding 与索引:让系统比较语义
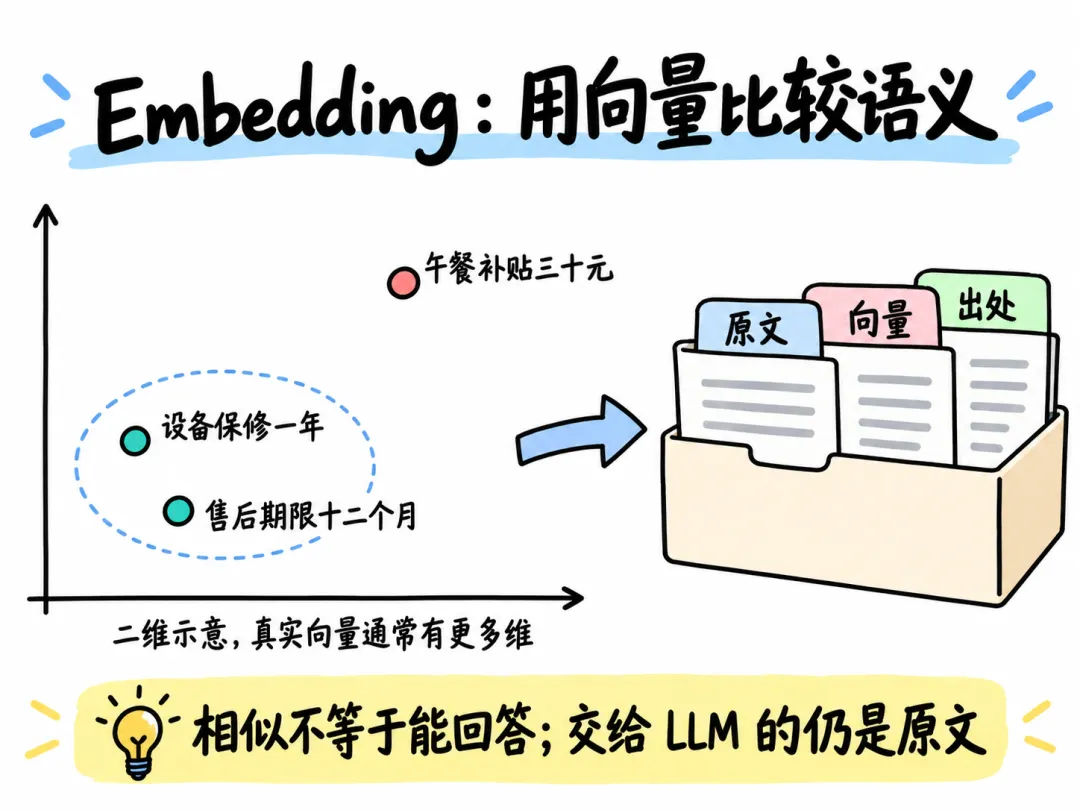
资料切好之后,系统会用 Embedding(文本嵌入)把每个片段表示成一串数字,这串数字叫向量。
这样做,是为了帮助系统比较内容在语义上是否接近。
比如,“设备保修一年”和“售后期限十二个月”,用词不同,却都在描述保修时长。合适的嵌入模型通常会让它们的向量比较接近。
“午餐补贴三十元”谈的是另一件事,位置就可能更远。
上图用二维位置帮助理解。真实向量通常有更多维度,这些位置也不是固定的。
接下来,系统把原文、向量与出处关联起来,建立检索索引。常见实现包括向量数据库,也可以使用其他检索系统。
需要记住的边界:
语义相似,只表示值得进一步查看,不保证片段能够回答当前问题。 向量用于帮助查找;真正交给 LLM 阅读的,仍然是检索到的原文。
3. 检索与重排:从相关内容里挑出有用证据
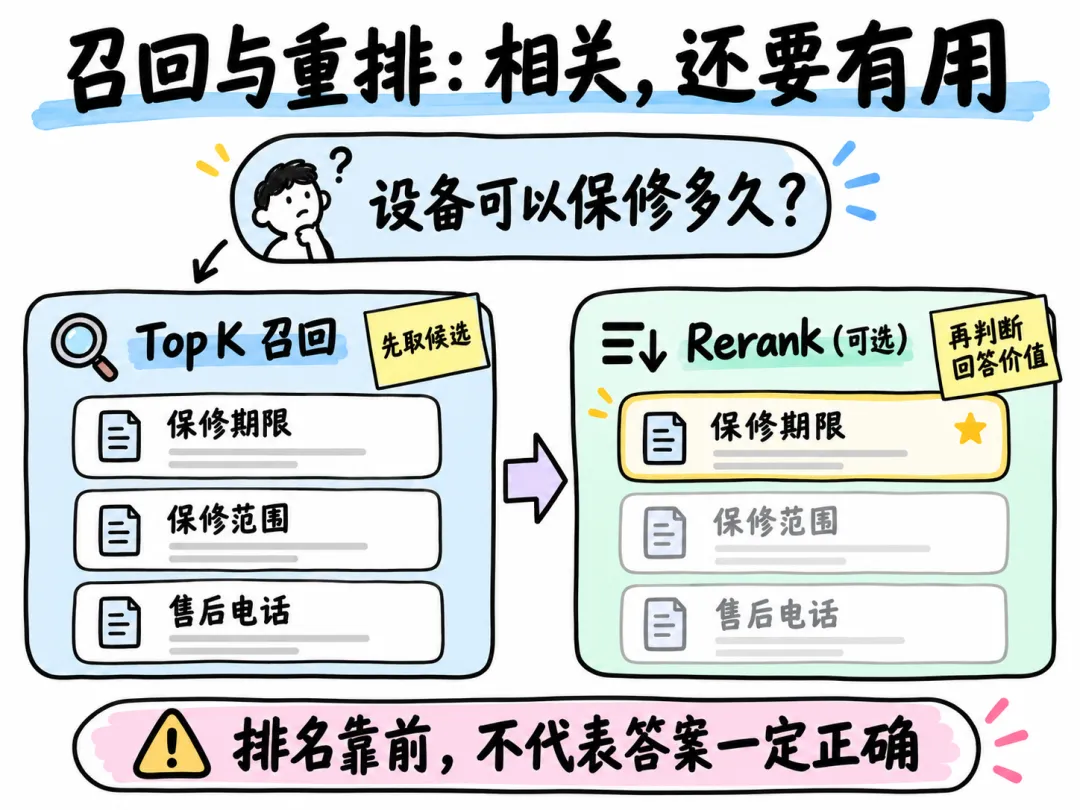
现在,资料准备好了。用户问:“设备可以保修多久?”
在这里介绍的向量检索流程中,系统使用同一个 Embedding 模型,把问题也转成向量。问题和文档进入可比较的空间,系统就能寻找相近片段。
比较方式有多种。余弦相似度主要比较方向,欧氏距离比较向量之间的距离。具体指标需要结合模型和索引来选。
排序之后,先取出前 K 个候选,这一步叫 Top K 召回。K 是数量参数,可以根据测试结果调整。
候选里可能有“保修期限”,也可能有“保修范围”和“售后电话”。它们都与保修有关,能够回答“多久”的却未必是同一段。
这时,可以加入 Rerank(重排):把问题和候选片段一起交给重排模型,进一步判断谁更适合回答。
第一轮:找出与保修有关的候选保修期限 / 保修范围 / 售后电话进一步判断:哪段能回答“多久”?明确写出保修期限的片段更有价值它的作用:在第一轮结果比较杂时,进一步筛选证据。
它的代价:增加计算开销。因此重排是可选步骤,要结合效果和成本来决定是否加入。
排名靠前,也仍然需要检查:这一段是否真的回答了当前问题。
4. 带证据生成:让 LLM 根据资料回答
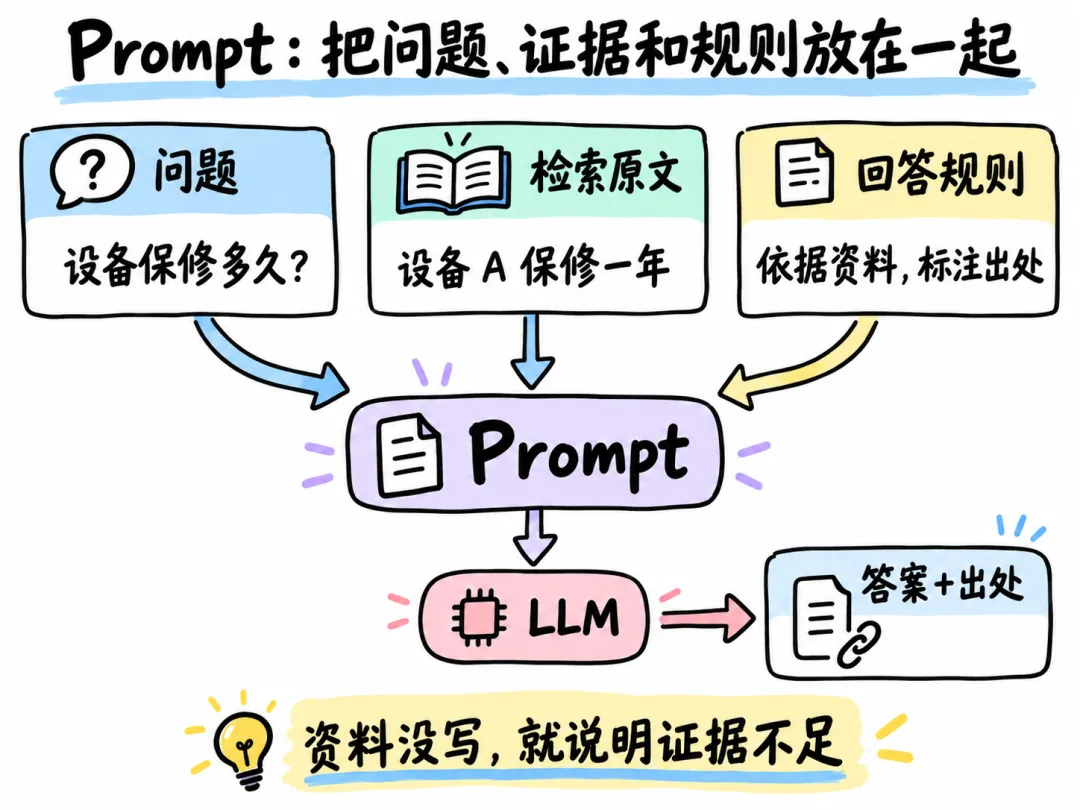
找到证据后,就到了模型组织回答的阶段。
系统会把三部分放进 Prompt(提示词):用户的问题、检索到的原文,以及回答时要遵守的规则。
用这个教学例子表示,大致是:
问题:设备 A 可以保修多久?资料:设备 A 的保修期限为一年。来源:售后政策规则:依据资料回答,并标明出处。资料不足时,明确说明无法确定。有了对应条款,模型就有依据回答保修期限。
如果找到的内容只有售后电话,资料里没有写期限,那么合理的回答应当说明:现有资料不足以确定保修时长。
这里仍然需要核对:模型有没有忠实理解原文,答案引用的出处能不能支撑它的说法。
即使检索正确,模型把“一年”读成“一个月”,最终答案依然是错的。
5. 调整检索:把问题问清楚,再结合两种搜索
现实中,用户不一定会把问题写得很完整。
如果前文已经明确谈的是设备 A,下一句只问“它能保修多久”,系统可以把已知设备名称补进检索问题。
这叫 Query Rewrite(查询重写)。它利用已知上下文帮助查找,必须保留用户原意;不确定的条件,需要澄清或保留不确定性。
此外,资料里的信息也不都适合同一种检索方式。
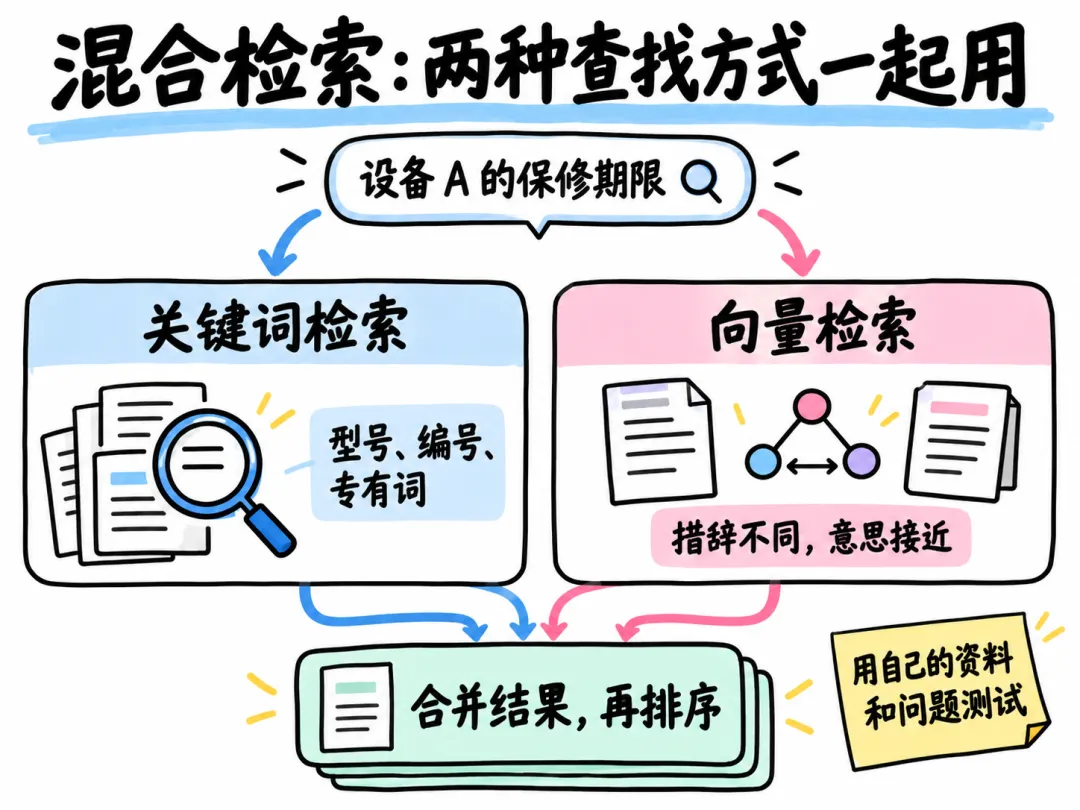
- 关键词检索:
适合型号、合同编号、人名等需要精确匹配的内容。 - 向量检索:
适合措辞不同,但语义接近的内容。
同时使用两种方式,把结果合并后再排序,就是 Hybrid Search(混合检索)。
可以把它理解为两种查资料的方法:一路盯住精确词汇,另一路寻找意思相近的表达。
需要验证的地方:两路都有盲区,组合后的效果也要用自己的资料与问题检查。
6. 答案不对时,沿着流程往回查
RAG 是一条连续的处理流程。最终答案出错时,可以先找出信息从哪一步开始偏离。
选择 LLM 时,还需要结合延迟、隐私和运维要求。本地部署是一种选择,安全性仍然取决于权限、日志和更新等具体设计。
先做一次小范围验证
准备一份你熟悉的小文档,列几道资料中有明确答案的问题,再加几道资料没有涉及的问题。
然后逐一检查:
检索有没有找到正确片段? 回答有没有忠实于原文? 引用能不能回到对应出处? 没有证据时,系统有没有明确说明?
从这些具体问题入手,你会更容易判断自己的 RAG 需要调整哪一个环节。
思易 · AI 学习笔记
根据《画懂 RAG:先找资料,再生成答案》视频讲稿整理。