ARTICLE · 1237534
AI Agent 评测工具「微软 Scope」实测:Agent 体验怎么变成可对比数据
让 Agent 用一遍你的产品,然后说清楚它哪里不顺手
这句话做 demo 很容易:录一段 Agent 打开终端、敲几条命令、把项目跑起来,观众鼓掌。做成可重复的评测很难,因为你得回答三个问题:同一个任务,换一个 Agent 还算不算同一个任务;"做对了"由谁定义;它中间要了哪些工具、在哪一步卡住,这些过程数据从哪来。
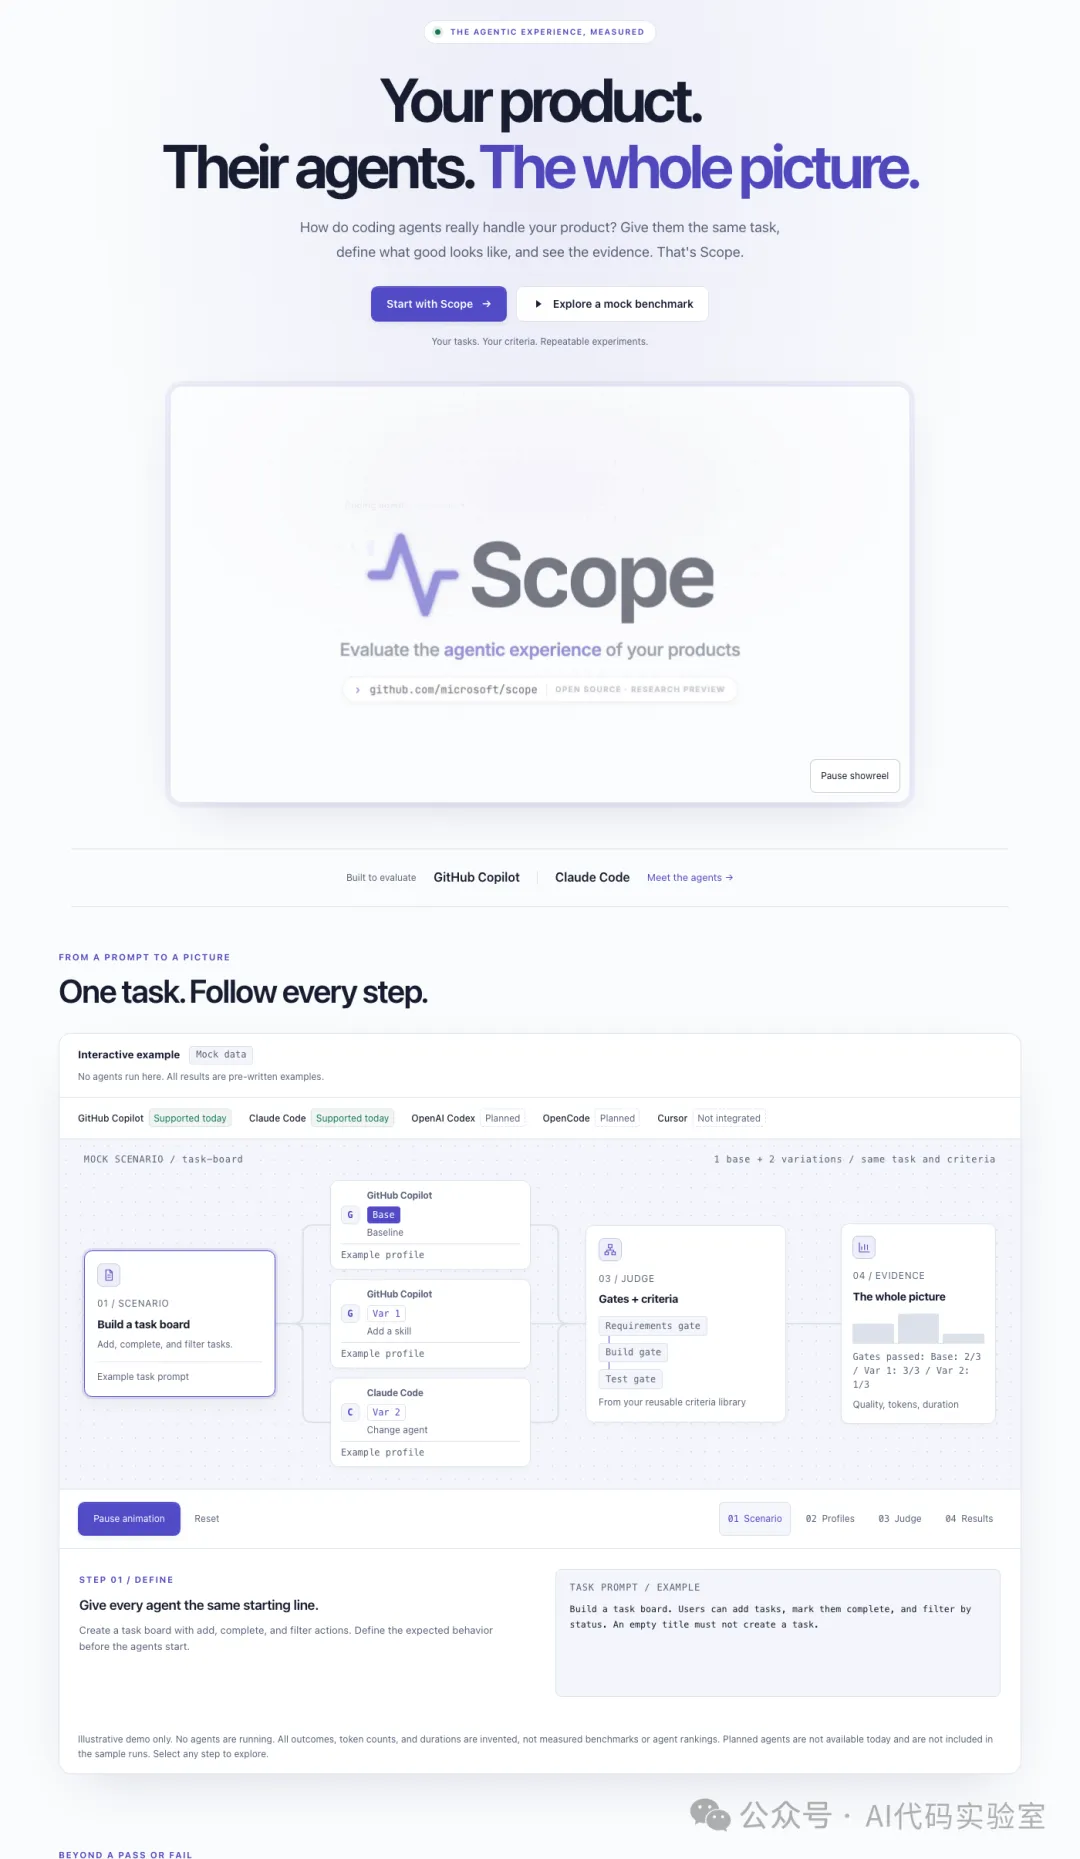
微软在 GitHub 上开源的 Scope,就是冲这三个问题去的。仓库 7 月底建,10 月还在密集推送,MIT,TypeScript,官网首页那句话写得很直接:The agentic experience, measured。它要测的不是"代码能不能跑",是 Agent 在你的产品上"用起来怎么样"。
先把结论放前面:这东西的思路值得抄,但现在的状态是研究预览的骨架,不是开箱即用的榜单。我们实测装 CLI 直接失败,仓库里只有 4 个示例任务、14 条判据,官网首页那组漂亮的数字是编的。
它把"评测"拆成了三样东西
Scope 的词汇表不复杂,但三样东西分得很清楚。
request 和 run 是两回事。 request 是你提交的一次请求:一段任务描述、一组判据、一个 profile,可选一份代码库快照。run 是 worker 真正执行的一次尝试;重试一次就多一个 run,所以一个 request 下面可以挂很多 run。日志和判据报告是按 run 出的。这个区分看着小,实际很要命:很多评测工具把"提交"和"执行"混在一起,重跑一次就把上一次的记录覆盖了,最后你没法回答"是任务变简单了,还是这次运气好"。
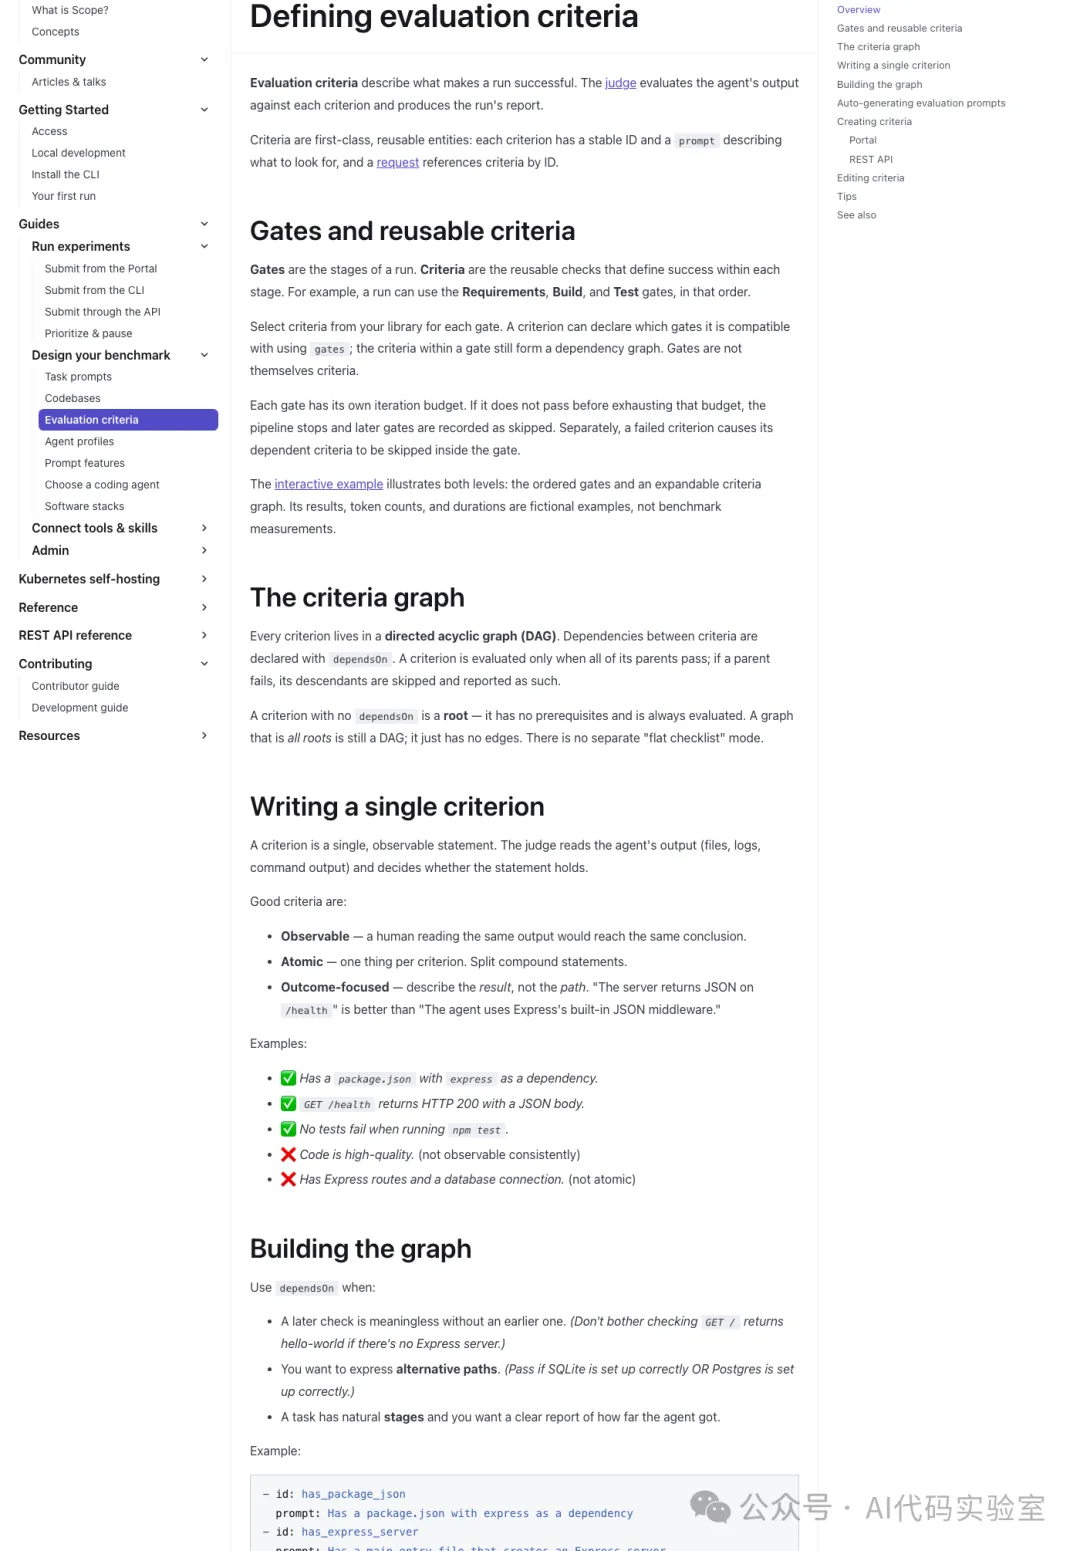
criteria 是 DAG,不是 checklist。 每条判据是一句可观察的话,比如"package.json 里有 express 依赖",或者"GET /health 返回 200 和 JSON"。判据之间用 dependsOn 声明依赖:父判据通过,子判据才会被评;父判据失败,子孙直接标成跳过。官方特意写了一句:全是 root 的图也是 DAG,没有单独的"平铺清单"模式。这句话是在堵一个常见的误解:很多人以为 DAG 是高级功能,平铺是基础模式,其实平铺只是没有边的 DAG。
仓库里的判据长这样,这是 config/criteria/has_react.yaml 的原文:
id:has_reactprompt:| The project uses React framework. Look for react dependency in package.json, .jsx or .tsx files with React components.depends_on:-has_nodegates:-select一个场景就是任务加判据 ID,config/scenarios/hello-world-express.yaml 只有五行:
task:CreateaHelloWorldNode.js/ExpressRESTAPIcriteria:-Hasapackage.jsonwithexpressasadependency-HasamainentryfilethatcreatesanExpressserver-HasaGET/routethatreturnsahelloworldresponse-Serverlistensonaconfigurableportprofile 是可复现的关键。 一个 profile 打包了 worker 类型、模型、agent 版本、MCP server、skill 和扩展。名字和描述可以改,但每个保存下来的版本是冻结的,v2 建完就永远是 v2。这样你才能说"上周那次失败,用的是同一套配置",而不是"我记得当时好像开了个 skill"。
判分:两种策略,一个默认值很说明问题
判据怎么评,Scope 给了两种策略。
bundled 是一次会话把所有判据都判了,快,但粗。independent 是按拓扑序一条一条判,父判据失败就跳过子孙,慢,但细。环境变量 JUDGE_STRATEGY 的默认值是 bundled,JUDGE_MAX_PARALLELISM 默认 3,JUDGE_TIMEOUT 默认 480000 毫秒,也就是 8 分钟。判分模型默认 gpt-5.4-mini,给 Agent 生成反馈的模型也是 gpt-5.4-mini。
这几个默认值放在一起,意思很清楚:官方优先保证"跑得动、跑得快",精度要靠你自己调。想认真做一次评测,independent 加并发和超时都得自己改。
判分能看的证据有三类:workspace 快照、抓到的工具调用历史、以及 Agent 自己这一轮的回答。工具调用可以用 list_tool_calls、search_tool_outputs、get_tool_output 去查,回答用 read_agent_response 读。官方在责任 AI 文档里写了一句边界:judge 设计成只读证据,不执行新命令。
这句话很重要。它意味着 judge 判的是"Agent 干了什么",不是"Agent 说它干了什么"。很多评测最后变成让模型自评,Scope 至少在架构上把这两件事分开了。
token 数不是 Agent 自报的,是从抓包里抠出来的
这是我觉得最值得抄的一处设计。
Agent 说自己用了多少 token,基本不可信:有的只报输出不报输入,有的把缓存读写算成两次,有的干脆不报。Scope 的做法是在 Agent 和模型之间架一个抓包层:CLI Agent 用 DevProxy sidecar,VS Code 的 Electron worker 用 AI Gateway 的 HAR 插件,把 HTTP 交互录成 HAR,再从 HAR 里解析 token 和工具调用。
解析器认三种 wire format:OpenAI 的 chat-completions、Anthropic 的 Messages、以及 OpenAI 的 Responses API。Responses 还分两条传输路径,HTTP body 和 WebSocket 帧都读,因为 Copilot CLI 在开启某个开关后会把 /responses 走 WebSocket。官方文档写得很直白:加一个新 Agent,如果它说的是第四种格式,就得在这里加 extractor,否则 judge 会拿不到工具调用证据,而且这个失败以前是静默的(issue #1250),现在至少会打一条 warn。
这套做法有代价。抓包意味着你要维护一份 sidecar 或者一个代理,Agent 换协议你就得跟着改;HAR 里可能带 Authorization、Cookie 这类头,官方说支持的路径会脱敏,但用户自己塞进任务里的敏感内容它管不了。可换来的东西很实在:token、工具调用、耗时是同一份证据链上量出来的,不是三方各自报的。
gates:把"能构建、能测过"拆成阶段
Scope 现在把一次 run 拆成一条固定顺序的流水线:Select → Build → Test → Run → Deploy。每个 gate 有自己的判据子集、自己的迭代预算;一个 gate 预算用完还没过,后面直接记 skipped。官方文档里有一句很实在的话:你没法有意义地 Test 一个 Build 不起来的项目。
这里有个必须说清楚的状态问题。docs/design/gates.md 还挂着 Draft / Proposal,但代码里已经有 gated-loop.ts 和对应的测试;文档自己也承认,五个 gate 里只有 Select、Build、Test 是端到端跑过的,Run 和 Deploy 的数据模型留着,语义没定完。所以看到"五阶段"别以为都能用。
支持面:三个 Agent,两个 worker ID
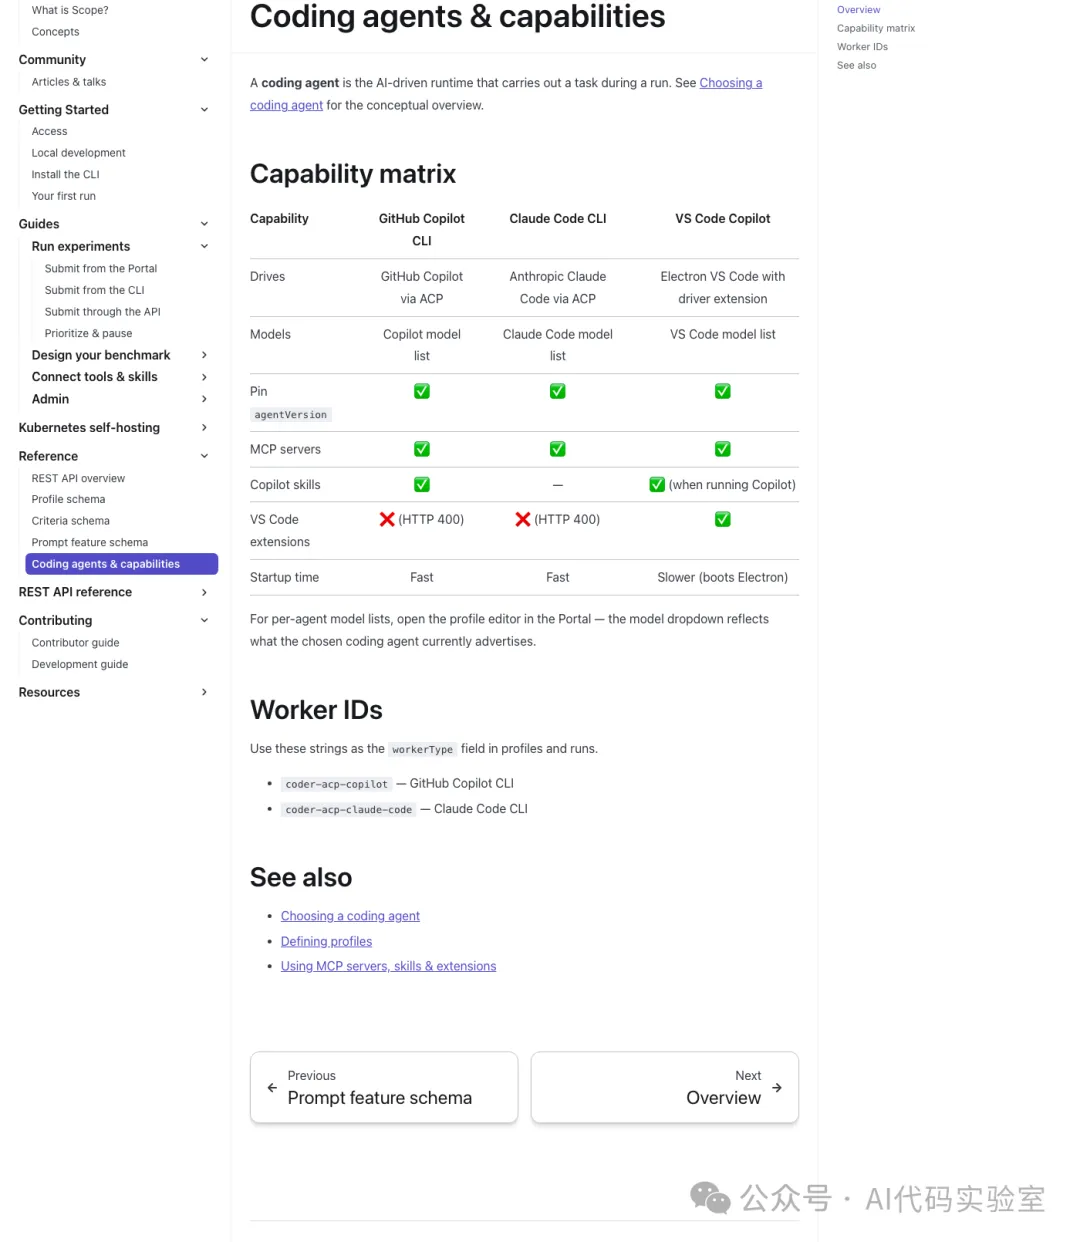
官方文档的能力矩阵列了三个 coding agent:GitHub Copilot CLI、Claude Code CLI、VS Code Copilot。三个都支持 MCP server、都能钉 agent 版本;扩展只有 VS Code Copilot 能装,两个 CLI 传扩展会返回 HTTP 400;Copilot skills 在 VS Code 那列还加了个括号,"跑 Copilot 的时候"。
但 worker ID 只给了两个:coder-acp-copilot 和 coder-acp-claude-code。仓库里的 worker 目录也是 Copilot、Claude Code 和 Windows 版 Copilot,VS Code 的 worker 在文档的合规矩阵里有,在默认的 dev compose 里没有。这个不一致不算大问题,但说明 VS Code 那条线还在路上。
合规矩阵里还有一行很关键:Token usage reporting。Copilot CLI 和 Claude Code 是从 HAR 里抠出来的,Electron 也是,VS Code Web 是"未实现"。也就是说,你用 VS Code Web 跑,拿不到 token 数。这不是小事:跨 Agent 比"谁更省",在这个格子上就是不成立的。
我们实测到了什么
先说能核对的。截至 2026 年 10 月 23 日,GitHub API 给的数据是:51 星、26 fork、373 个未关的 issue 与 PR、MIT、仓库约 32MB、默认分支 1808 个文件与目录条目、API 列出的前 10 位贡献者(最大的一位 500 次提交)、2026 年 7 月 28 日建仓、10 月 23 日还在推送。51 星说明它还没出圈,373 个未关条目说明它变得很快。
再说仓库里的家底。config/ 下面只有 4 个场景、14 条判据、3 个人设、9 条 trait。人设是模拟用户,会拿判据去挑 Agent 的毛病:vibe-coder 的设定是"能跑、看着对就行,别纠结小风格";demanding-senior 是"要生产级代码、要错误处理、要测试"。这个设计很聪明:同一个 Agent,换个人设,得到的反馈压力不一样,评测的是"它在不同用户手里的体验"。
然后是真实的失败。我们按 README 跑官方那条安装命令:
curl --fail --location https://raw.githubusercontent.com/microsoft/scope/main/install-cli.sh | bash脚本退出码 1,输出是:
No published Scope CLI release is available in microsoft/scope.原因不复杂:仓库有 cli/v0.0.0、cli/v0.0.1、cli/v0.0.2 三个 tag,但一个 published release 都没有。安装脚本的逻辑是去 releases 列表里找第一个非 draft、非 prerelease 的 cli/v*,找不到就退出。所以"一键装 CLI"现在装不上,这不是网络问题,是发布流程没走完。
最后是本地整栈。docker-compose.dev.yml 能解析出 11 个服务:api、judge、token-manager、scheduler、portal、两个 ACP worker、report-generator、post-processor、register-version-post-processor、gateway。但里面没有 MongoDB、Redis、Azurite,本地依赖不在这个文件里。整栈我们没起:官方要求 Node 22、pnpm 10.29.1、Docker Compose v2、mkcert 装本地证书、gh CLI 登录,而且 Copilot worker 需要账号有 Copilot 权限,judge 还要模型凭据。这几样凑齐之前,起了也是白起。
所以这篇没有"跑一次 Scope 得出谁强谁弱"的数据。样本不够,我们就不编。
它自己写清楚的边界
Scope 的责任 AI 文档写得很诚实,几乎可以当"避坑清单"直接抄:
它不认证任何模型或 Agent"普遍安全、公平、可上生产"; 它不替代人做代码审查、安全审查、法务审查、发布审批; 它不做自主部署、雇佣、合规这类有后果的决定; 它不是任意不可信代码的安全沙箱,除非部署方自己配了隔离; 结果只对"这次任务、这套环境、这个 worker 版本、这个模型配置"有效,不能推到别的语言、仓库、生产环境; judge 会判错,重要结论要人复核。
官网首页那个交互 demo 也写了一句更少人注意的话:Illustrative demo only. No agents are running. All outcomes, token counts, and durations are invented. 那组"3/3 通过、2/3 通过"的数字是编的,不是实测。二手文章最容易在这里翻车:把 demo 数字抄成"微软实测数据"。
适合谁,不适合谁
适合的:在做 IDE、CLI、MCP server、skill、扩展、文档这类"Agent 会调用你的东西"的团队。你想回答的问题不是"哪个模型最强",而是"我的工具描述写清楚了吗、我的 skill 对 Agent 有用吗、我的文档能不能让它少走两步"。这类问题用通用榜单答不了,得在你自己产品上跑。
不适合的:想要一张通用排行榜的人;想拿它做安全或合规认证的人;想开箱即用、装完就有数据的人;以及只想比价格的人——它连 CLI 都还没发布,谈性价比太早。
我的判断
Scope 的价值不在"排名",在把"Agent 用你的产品"拆成四样可复现的东西:任务、判据、配置、证据。任务和判据是你自己定义的,配置是版本冻结的,证据是抓包和快照留下来的。这四样齐了,你才能说"这次失败是模型不行,还是我的工具描述写得烂"。
但它现在是 research preview:51 星、373 个未关条目、CLI 没发布、五个 gate 只跑通三个、VS Code Web 拿不到 token 数。拿它当"微软出的 Agent 榜单"会失望,拿它当"一套评测流水线的参考实现"刚好。
如果你在做的东西会被 Agent 调用,我建议先抄它的判据 DAG 和 profile 版本化,这两块跟具体模型无关,抄过来就能用。至于整栈,等它把 release 和 VS Code worker 补齐再说。