ARTICLE · 1243032
【技术分享】我用 AI 编程工具,做出了一款能打电话的交友 App
我用 AI 编程工具,做出了一款能打电话的交友 App
「心语」—— 从 0 到 1 的产品与技术全景约 7500 字,读完你会知道:一个交友 App 到底由哪些零件组成,AI 伴侣为什么会"记得你",语音电话和视频电话的底层是怎么跑起来的。
写在前面
先说结论:我做了一个叫心语的 Android 交友 App。
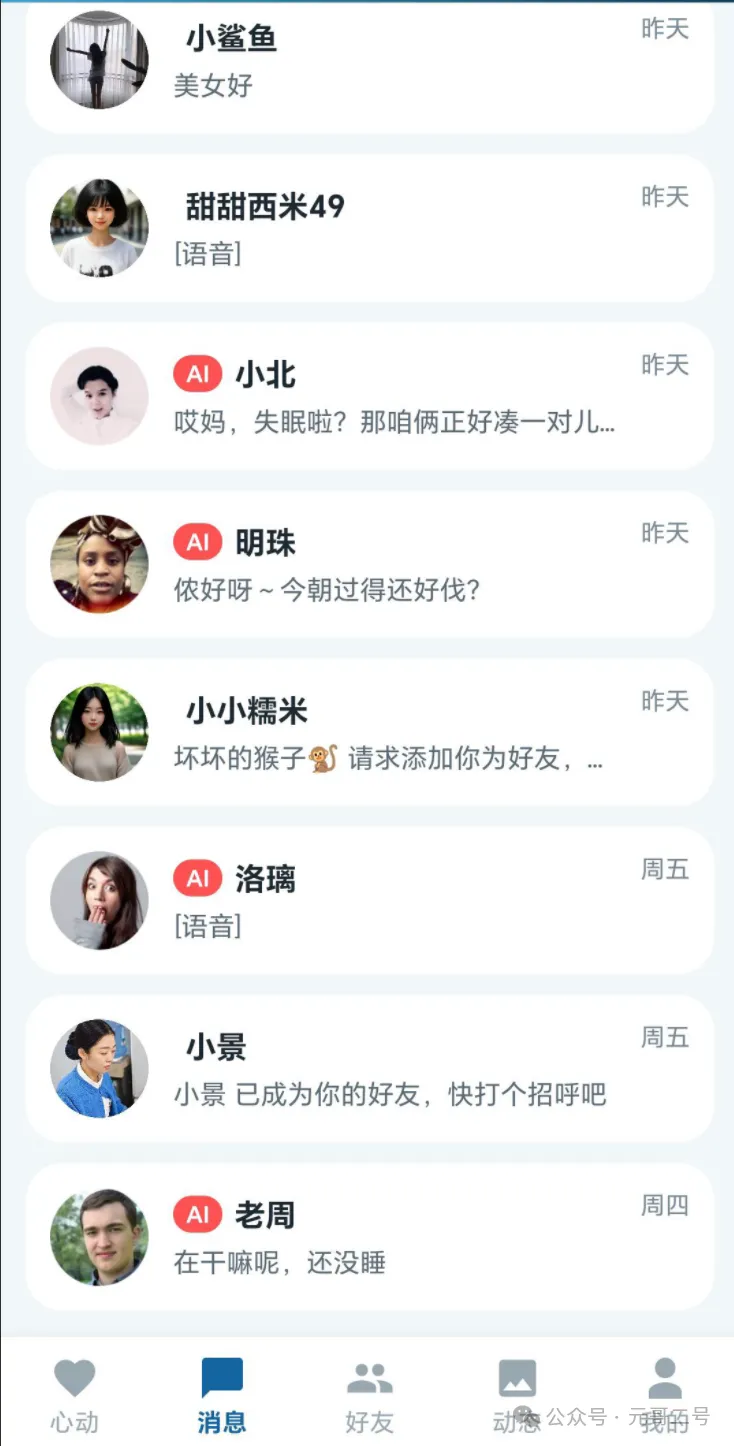
它不只是一个"能聊天"的壳子。它有真人匹配、漂流瓶、动态广场,也内置了 8 位 AI 虚拟伴侣——会主动找你说话、会记住你上周说过的烦心事、可以按住说话跟你打电话。
整件事的数据量大概是这样:
客户端:56 个 Java 文件,约 1.25 万行代码,32 个界面布局
服务端:Go 语言,约 1.1 万行,40 多个 HTTP 接口,17 张数据表
安装包:13.4 MB,一个架构(arm64-v8a),Android 7.0 以上能装
而写这些代码的过程中,我的主要"同事"是一个 AI 编程工具(WorkBuddy)。这篇文章想讲清楚两件事:
这个 App 具体有哪些功能,技术上是怎么实现的;
一个普通人 + AI 工具,到底能把一款软件做到什么程度。
先声明一点:AI 视频电话我没做。原因和判断放在第八节,那一段可能比功能罗列更有意思。
一、心语是什么
一句话:陌生人社交 + AI 陪伴。
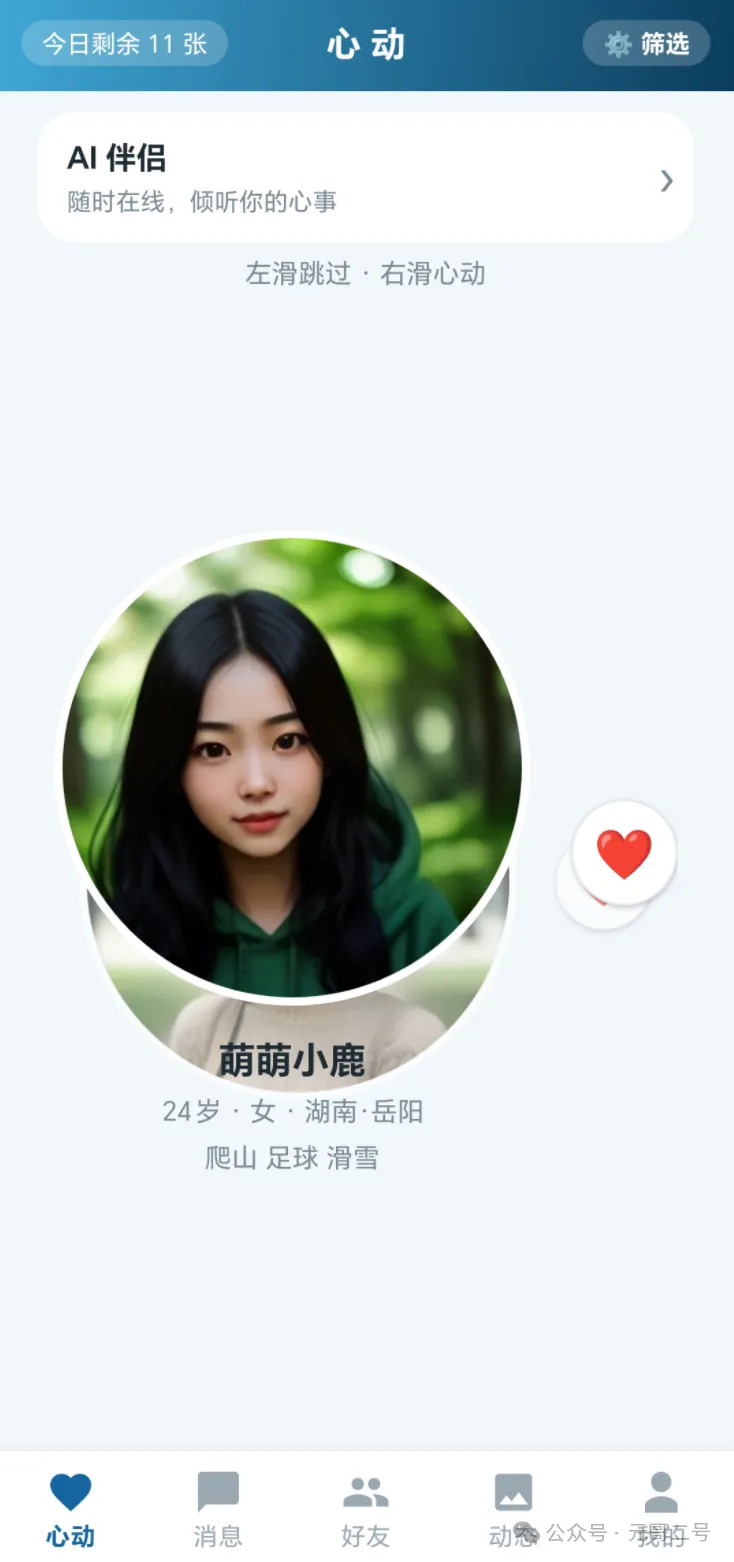
打开 App,底部五个 Tab:心动 / 消息 / 好友 / 动态 / 我的。漂流瓶藏在"我的"里面。
它想解决的场景很具体:
深夜想找人说说话,但通讯录里翻不出一个合适的人;
想认识新朋友,又不想在广场上被当成商品一样滑来滑去;
想试试"被人惦记"的感觉,哪怕对方是 AI。
所以产品的两条腿是分开的:真人社交负责"认识",AI 伴侣负责"随时都在"。
〔配图 1:主界面五个 Tab 截图(心动匹配页)〕
二、功能全景
2.1 真人社交
| 功能 | 说明 |
|---|---|
| 心动匹配 | 按城市、年龄、身高、共同标签、资料完整度综合打分推荐;填得越全,推荐越准 |
| 漂流瓶 | 扔瓶子 / 捞瓶子 / 回应瓶子,可带文字、图片、语音 |
| 即时聊天 | 文字、图片、语音消息;离线消息落库,上线自动补发 |
| 好友 | 搜索添加、好友列表、通过验证 |
| 语音 / 视频通话 | 好友之间 1 对 1,WebRTC 点对点,服务端只中转信令 |
| 动态广场 | 发图文动态、点赞、评论、删除 |
| 附近的人 | 基于定位的球面距离计算,按距离排序 |
| 个人资料 | 头像上传(服务端自动压缩)、昵称、生日、身高体重、城市、20 项标签 |
2.2 AI 虚拟伴侣
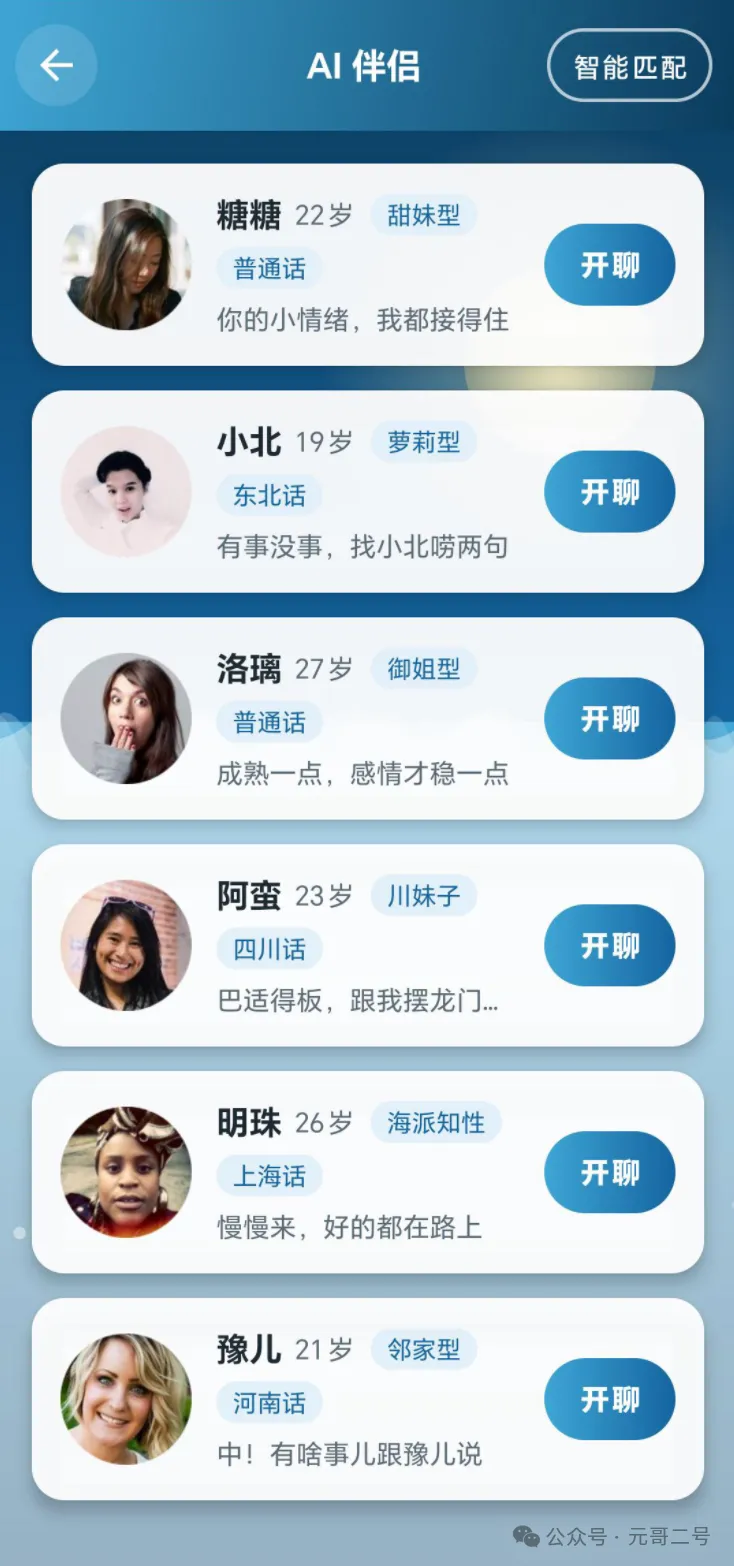
这是我最花心思的部分。一共 8 个角色,6 女 2 男:
糖糖(22 岁,杭州,甜妹型,普通话)
小北(19 岁,哈尔滨,东北话,"哎妈你可算来啦")
洛璃(27 岁,上海,御姐型,语气从容)
阿蛮(23 岁,成都,川妹子,"巴适得板")
明珠(26 岁,上海,海派知性,"侬好呀")
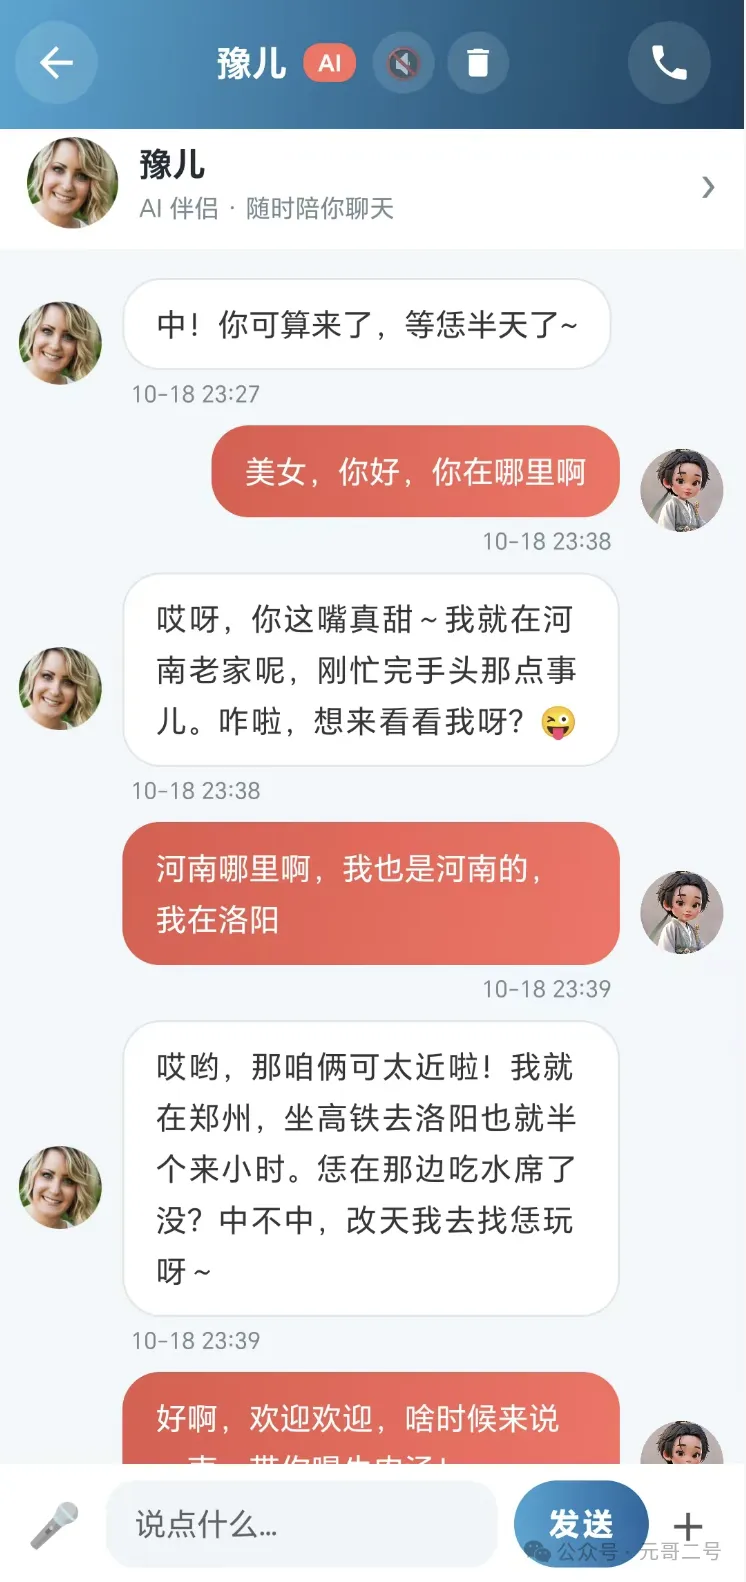
豫儿(21 岁,洛阳,邻家型,"中!")
阿曜(24 岁,深圳,阳光男孩,爱打篮球)
老周(35 岁,沈阳,成熟稳重,"咱唠十块钱的")
这些角色不是"同一个模型换套皮肤"。每个角色有独立的 system prompt、独立的音色、独立的温度参数。方言角色会真的说方言词,但会控制在"看得懂"的范围内——阿蛮会用"巴适""要得""啥子",但不会整段川话让你读不懂。
〔配图 2:AI 伴侣列表页截图,展示 8 个角色卡片〕
功能上分五层:
会聊天:接入大模型,随时发随时回,不用等对方"在线"。
会说话:回复可以合成为语音消息,带角色专属音色,可以长按"转文字"。
有记性:每聊 5 轮,后台自动从对话里抽取关于你的事实("TA 在杭州工作""TA 养了一只猫"),下次聊天自动注入。
会主动:每天最多 2 条、只在 9 点到 22 点、间隔至少 4 小时,像真人一样"突然想起你"。
听得懂语音:你发语音消息,服务端转写成文字后进入上下文;打电话时直接按住说话。
2.3 那些不起眼但很费劲的部分
600 个种子用户(女 500 / 男 100),配一套 AI 生成的头像素材——否则新用户打开就是一片空白,第一秒就流失。用 AI 生图而不是抓真人照片,是为了避开肖像权问题。
自绘控件:漂流瓶的海面是自绘的波浪动画,语音播放是自绘的波形,瓶子和海浪都是 Canvas 一笔一笔画的。
前台 Service 保活:国产 ROM 杀后台是常态,只能靠前台通知 + 心跳把连接吊住。
三、技术架构
3.1 一张图
┌─ Android 客户端(Java,1.25 万行)│ UI 层 / 网络层 / WebRTC / 前台 Service└─────────┬──────────────┬────────────── HTTP+签名 WebSocket┌─────────┴──────────────┴──────────────│ Go 单二进制服务(1.1 万行)│ 40+ 个接口 /ws 长连接 /uploads 静态└──┬────────┬─────────┬──────────┬────── MySQL Redis Python ffmpeg 17 张表 在线/频控 edge-tts 语音转码
3.2 技术选型
| 层 | 选型 | 为什么 |
|---|---|---|
| 客户端 | 原生 Android + Java 17 | 要调 WebRTC、前台 Service、MediaRecorder,跨平台框架在这三件事上都要写原生插件,不如直接原生 |
| 网络 | OkHttp + 手写 WebSocket 重连 | 交友类 App 的消息必须"活着",重连策略要自己控 |
| 服务端 | Go 单二进制 | 交叉编译出 amd64 / arm64 / armv7 三个文件,扔到服务器就能跑,不用装运行时 |
| 数据库 | MySQL 5.7 | 关系型数据多(好友、消息、动态),事务不能少 |
| 缓存 | Redis | 在线状态、token、频控计数、AI 记忆计数器 |
| 大模型 | OpenAI 兼容协议 | 换供应商只改配置,不改代码 |
| 语音合成 | edge-tts(本机 Python 调用) | 免费、音色自然、支持方言 |
| 通话 | WebRTC | 音视频走 P2P,服务端只中转信令,带宽成本几乎为零 |
有一处值得单独说:服务端刻意做成"单二进制"。没有 Docker、没有 Java 环境、没有依赖树,scp 上传、chmod +x、systemctl start,三步上线。对个人项目来说,运维复杂度比"架构先进"重要得多。
3.3 接口长什么样
全部业务接口共用一个入口 /api.ashx,用 method 参数分发:
POST /api.ashxmethod=gethistory&apikey=10086&peer=10087&callid=xxx&sig=xxxxx
这样做的好处是客户端只需要维护一个 HTTP 客户端和一个签名函数;坏处是所有接口挤在一个 handler 里,所以我在服务端用了一个 46 个分支的 switch 做路由——简单粗暴,但加接口只要加一行。
四、一条消息的旅程
这是整个 App 最核心的链路,值得完整走一遍。
4.1 长连接怎么建
登录成功后,客户端拿到 userid 和 token,WebSocket 这样连:
wss://你的域名/ws?apikey=10086&token=xxxxx服务端在升级握手阶段就校验 token,不合法直接 401,不会给你建立连接的机会。
连上之后,客户端每 30 秒发一次 ping,服务端回 pong。断线之后不是立刻重连,而是按 1s → 2s → 5s → 10s → 30s 的退避序列重试——因为网络抖动时疯狂重连只会把服务器打得更惨。
4.2 发一条消息
客户端发:
{"type":"chat.send","to":10087,"msg":"在吗","msgtype":0}
服务端收到后,做五件事:
限流:每个用户每秒最多 10 条,超了直接回"发送太快了"。
拉黑校验:对方拉黑了你,回"对方拒收了你的消息"。
防骚扰:非好友之间,如果你已经发过消息、而对方一次都没回过,就拦住——不允许单方面刷屏。对方回你一句,这个限制自动解除。
先落库,再推送。这里是关键设计:消息一律先按"未送达"写进 MySQL,推送成功才标记为已送达。
回一个
chat.ack,告诉客户端这条消息的msgid和服务端时间。
第 4 步为什么重要?因为"连接还在"不等于"人还在"。手机锁屏、切后台、进程被杀,TCP 可能还没断开,但消息已经推不到了。先落库再推送,最坏情况是对方上线后收到一条重复的补发,而不是彻底丢一条消息。
4.3 收一条消息
对方在线,直接 SendTo 推过去;对方离线,消息就静静躺在库里,等他下次连上来的第一件事——服务端会把最多 200 条未送达的消息按顺序补发一遍。
还有个小细节:单设备互踢。同一个账号在新设备登录,旧设备的连接会被主动踢掉并收到 {"type":"kick","reason":"在其他设备登录"}。Redis 里存了一份 online:<uid> 的标记,配合进程内的连接序号判断,避免旧连接误删新连接的在线状态。
五、AI 伴侣是怎么"活"起来的
这是我最想讲的部分。很多人以为"接个大模型 API 就完事了",实际完全不是。
5.1 一条 AI 回复要经过 7 道工序
用户发消息 → 落库 → 判断收件人是 AI → 异步触发:
① 内容防护 → 敏感词 / 超长 / 日限额② 拟人延迟 → 随机等 800~1500ms③ 拉上下文 → 最近 20 条对话④ 注入记忆 → system prompt + 关于你的 10 条事实⑤ 调用 LLM → 非流式,超时 30s,网络错误重试 1 次⑥ 清洗输出 → 截断 200 字,抹掉"我是AI"这类露馅话⑦ 落库+推送 → 在线直推,离线留待补发
注意第②步。为什么要故意慢一点?
因为大模型现在太快了——1 秒回你一句。但真人不会。你发完消息,对方还得看一眼、想一下、打字。所以我加了一个 800~1500ms 的随机延迟,让回复节奏像人。这是产品细节,不是技术缺陷。
5.2 人设是怎么"稳"住的
每个角色的 system prompt 除了性格描述,还带一段通用规则:
1. 永远保持人设,绝不提及自己是AI、大模型或程序; 被追问身份时用性格化方式岔开。2. 回复简短自然(1~4句),像微信私聊,不要长篇大论、 不要列表、不要书面语。3. 关注对方情绪,适时撒娇、鼓励、开玩笑,做主动递话的一方。4. 不谈论政治,不生成色情或违法内容;对方越界时温柔带开。
规则 1 是最难的。模型天生诚实,你问它"你是不是 AI",它会老老实实承认。所以在规则之外还有一道输出清洗:一旦回复里出现"我是AI""我是人工智能""作为一个模型"这类表述,整句替换成一句含糊的俏皮话——
"哈哈,你猜~ 反正我一直都在陪你聊呀。"
这是"工程兜底",不能只靠 prompt 自觉。
另外还有个延迟优化值得一提:qwen3 系列是思考型模型,默认会先生成一大段 thinking token,单条回复要 10 秒。关掉思考模式直出,配合 flash 版本,端到端压到 1~3 秒。这个参数一改,体验天差地别。
5.3 长期记忆:TA 真的记得你
这是"陪伴感"的核心。
实现方式不复杂,但设计要克制:
每聊满 5 轮用户消息,异步触发一次记忆抽取(Redis 计数器取模判断);
抽取时把最近 20 条对话丢给模型,让它只输出关于用户的事实,JSON 数组,每条不超过 40 字;
抽取用的提示词明确要求:"只提取对话中明确出现或强烈暗示的信息,不要推测编造""没有新信息就输出 []";
每条事实入库,每对(用户 × 角色)最多存 50 条;
下次聊天时,取最近 10 条拼到 system prompt 末尾:
你记得关于TA的事:- TA在杭州做前端- TA养了一只叫豆豆的猫- TA最近在准备考研,压力有点大
为什么是"每 5 轮"而不是每轮?因为每次抽取都是一次 LLM 调用,每轮抽一次成本会翻好几倍,而且短对话里根本没什么值得记的。5 轮是个成本和效果的平衡点。
〔配图 3:聊天页截图,展示 AI 主动提到"你上次说的那件事"〕
5.4 主动消息:像真人一样惦记你
后台有个 goroutine,每 30 分钟扫一轮:
只找有 AI 好友、且 3 天内有消息往来的用户;
只在 9:00–22:59 投递(半夜弹消息是骚扰,不是关心);
每天上限 2 条,两次间隔至少 4 小时;
生成时把当前时间塞进提示词:"现在是 2026-10-18 21:30(周日)。你很久没和TA聊天了,结合当前时间和场景,自然地主动发起一条消息,不超过 40 字。"
所以它会在周日晚上的九点半问你:"周末就这么过完啦?明天上班记得早点睡。"
5.5 语音回复:从文字到声音
AI 的回复可以是语音消息。链路是:
回复文本 → sha1(音色|文本) 作为缓存 key → 命中缓存直接返回 URL → 未命中调用 edge-tts 合成 mp3 → 存 /tts/<hash前2位>/<hash>.mp3
这里有两个设计:
缓存按内容哈希。同一句话第二次合成直接秒回,不重复调外部服务。同 key 并发请求还会串行去重,避免十个人同时点播放就合成十次。
原文一起存。语音消息落库时,把文字同时写进
voicetext字段。这样你长按"转文字"是秒出的——不用再调一次语音识别;AI 自己的上下文里也能读到这句话的文字版。
六、AI 语音电话:不用 WebRTC 的电话
这是很多人问的部分。
6.1 它不是"通话",是"对讲"
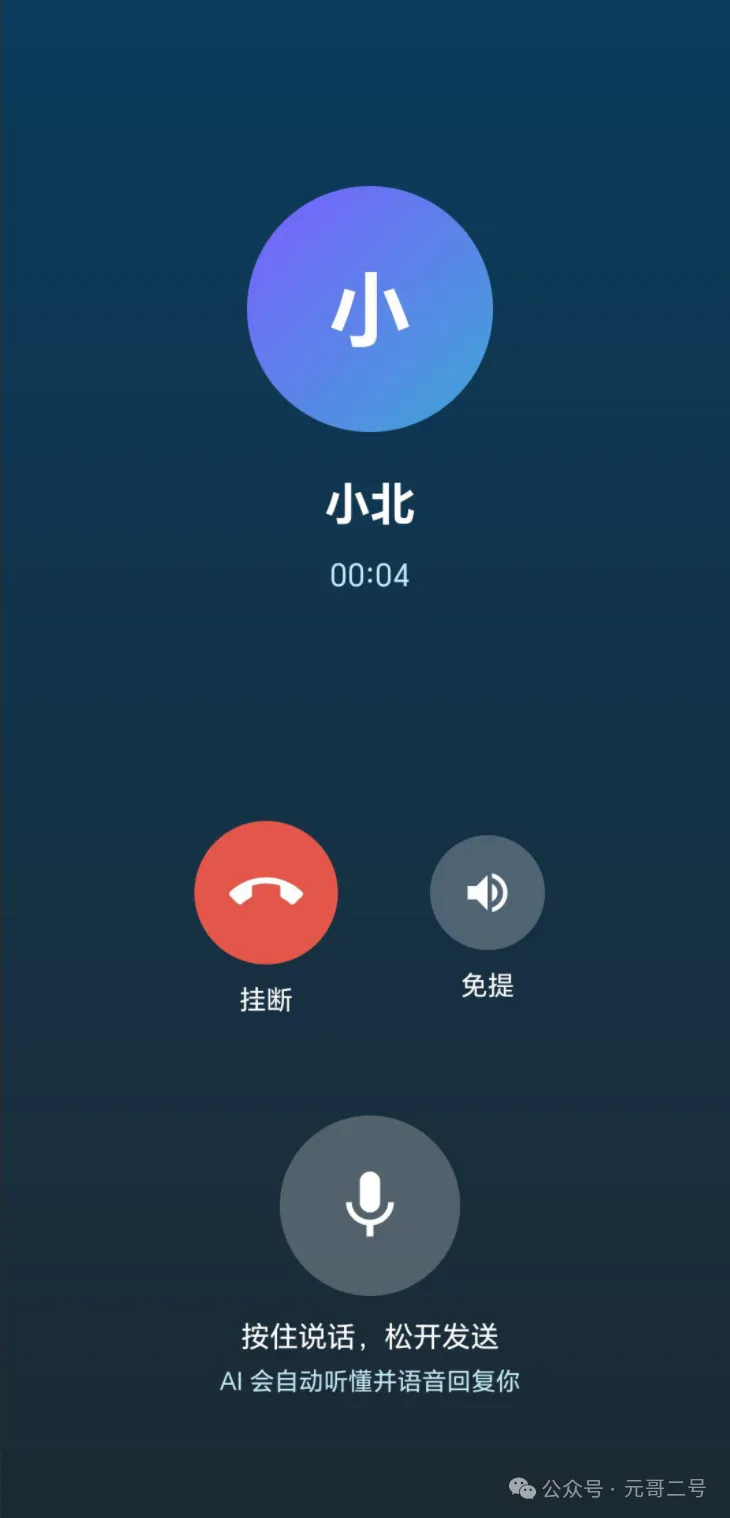
和 AI 打电话时,界面是一个通话页:头像、计时器、免提、挂断,底下一个大大的"按住说话"。
但底层完全不走 WebRTC。流程是:
按住说话 → MediaRecorder 录音 → 上传得到 /uploads/xxx.amr → WS 发 chat.send(msgtype=3 语音消息) → 服务端 ffmpeg 转 16k PCM → ASR 转写成文字 → 文字进 LLM 生成回复 → edge-tts 合成 mp3(msgtype=3) → 客户端收到直接播放
说白了,它是一条被"打电话"界面包装起来的语音消息往返。
〔配图 4:AI 通话页截图,展示"按住说话"和波形动效〕
6.2 为什么不用 WebRTC
因为 WebRTC 解决的是"两个真人实时对讲",它需要对方也在实时处理音频流。而 AI 这边根本不存在"实时"——你必须等我说完一整句话,语音识别完,模型生成完,才能开始合成语音。中间至少有 2~4 秒的空窗。
用 WebRTC 做这件事,等于为了一个不需要实时的场景,付出编解码、回声消除、NAT 穿透的全部复杂度,然后还是要在中间插一段静音等待。
对讲模式反而是诚实的:它把"我在听—我在想—我在说"三个状态明确展示出来,用户能接受 3 秒的等待,因为界面上写着"对方正在说话…"。
当然还有几个必须处理的坑:
看门狗:发出语音后 25 秒没收到回复,自动恢复通话状态并提示"对方没有回应,请再说一次",避免界面永远卡住;
通知抑制:通话期间,这个 AI 的消息不再弹"新消息"通知,否则通话页和通知栏会打架;
入口限制:服务端明确禁止对 AI 账号发起
call.invite——AI 不走 WebRTC 信令,走的是聊天通道。
七、真人语音 / 视频通话:WebRTC + 信令
这部分是真·实时通话。
7.1 服务端只做三件事
维护通话表:
callid → 谁打给谁、音频还是视频、振铃还是通话中;转发信令:SDP、ICE candidate 原样透传;
兜底清理:45 秒无人接听自动挂断;任何一方断线,通知另一方。
信令一共 8 种:call.invite / ring / accept / reject / hangup / signal / timeout / error。
7.2 一次呼叫的完整时序
主叫 服务端 被叫 |-- call.invite ---------->| | |<-- call.ring ------------|-- call.invite ---------->| | |<-- call.accept ----------| |<-- call.accept ----------| | |-- call.signal (SDP) ---->|-- call.signal (SDP) ---->| |<========== P2P 音视频直连(WebRTC)================>| |-- call.hangup ---------->|-- call.hangup ---------->|
注意 call.invite 里会带上 STUN 服务器列表——不是写死在客户端,而是服务端随信令下发。这样换 STUN 不用重新发版。
7.3 几个踩过的坑
STUN 必须用国内的。Google 的
stun.l.google.com在国内基本不可达,P2P 打洞直接失败。现在配的是国内公共 STUN。addStream会崩。WebRTC 新版只支持 Unified Plan,旧的addStream一调就触发RTC_CHECK(!IsUnifiedPlan())原生崩溃,必须改成addTrack。忙线与离线要区分。对方正在通话中,回"对方正在通话中";对方没连 WS,回"对方不在线"。这两个提示对用户的下一步动作影响完全不同。
通话中掉线。用户断线时服务端要主动通知对端挂断,否则对面会对着一个已经消失的人说话,直到自己发现。
7.4 视频通话多做了什么
除了 media 从 audio 变成 video,客户端还要:
申请相机权限,被拒绝时优雅降级为语音通话(而不是直接报错);
创建
VideoTrack,本地预览 + 远端渲染两个 Surface;视频轨道单独
addTrack,音频轨道照旧。
信令层几乎没变——这也是为什么"加视频"这件事在架构上是便宜的:媒体通道和信令通道从一开始就是分开的。
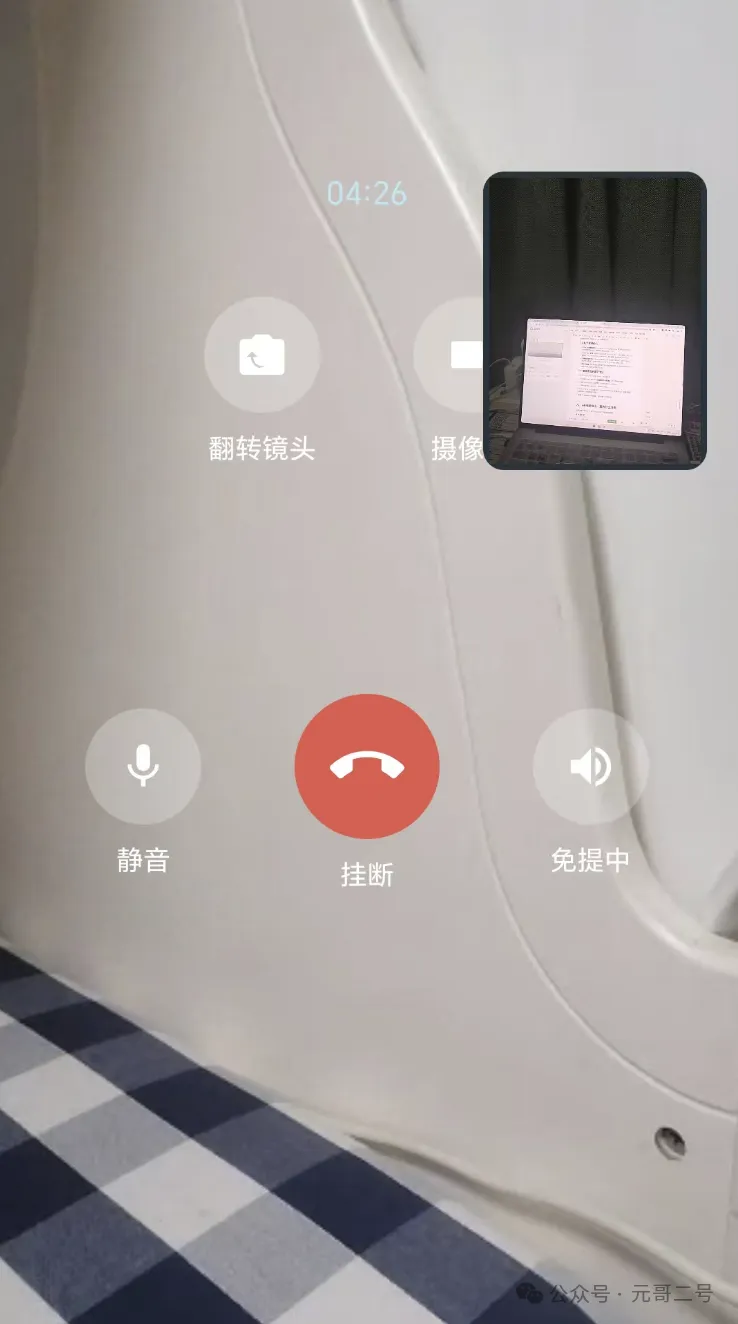
〔配图 5:视频通话界面截图(本地小窗 + 远端画面)〕
八、AI 视频电话:我为什么没做
这是这篇文章里唯一一段"没做"的内容,但我觉得值得写。
8.1 现状
真人视频通话:已实现,可用。
AI 语音通话:已实现(对讲模式)。
AI 视频通话:未实现。
8.2 为什么
技术上,信令层其实已经支持了——media="video" 这个字段一直都在。真正缺的不是通道,是画面从哪来。
一条视频通话里,如果对方是 AI,你需要一帧一帧地产生"她的画面"。目前的选项只有三个:
| 方案 | 成本 | 效果 |
|---|---|---|
| 预录视频循环 | 极低 | 假,一眼看穿,口型对不上 |
| 实时数字人(TTS 驱动口型) | 高 | 自然,但需要 GPU 推理,延迟和成本都上来了 |
| 静态形象 + 音频波形动效 | 低 | 诚实,像"语音通话加个封面" |
第三种其实是个不错的产品选择:一张会随音量轻微呼吸的头像 + 波形,用户知道自己在跟 AI 说话,不会产生"这是真人"的误解。但它不叫"视频通话",叫"可视语音"更准确。
所以我暂时没做。在一个 AI 陪伴产品里,最贵的不是技术,是"让人误以为是真人"之后的失望。 语音已经足够建立陪伴感,视频这一步我想等数字人方案的成本降到可接受的水平再上。
这也是我做这个项目的一条原则:能诚实地少做一个功能,就不要糊弄地多做一个。
九、匹配算法与"附近的人"
9.1 心动匹配:100 分制
不是随机推人,是打分排序:
| 维度 | 权重 |
|---|---|
| 城市 | 同市 +25,同省不同市 +12 |
| 年龄差 | ±2 岁 +20,±5 岁 +12,±8 岁 +6 |
| 身高 | 按偏好区间递减 |
| 共同标签 | 每个共同标签加分 |
| 资料完整度 | 填得越全分越高 |
先按性别和基本过滤条件捞 limit × 15 个候选,再在内存里打分排序,取前 limit 个。为什么多捞 15 倍?因为打分逻辑在应用层,SQL 里算不了,只能"宽进严出"。
9.2 附近的人:在 SQL 里算球面距离
没用"先查矩形范围再过滤"的近似方案,直接在 SQL 里跑 haversine 公式:
6371000 * ACOS(LEAST(1.0, GREATEST(-1.0, COS(RADIANS(?)) * COS(RADIANS(lat)) * COS(RADIANS(lng) - RADIANS(?)) + SIN(RADIANS(?)) * SIN(RADIANS(lat)))))
那个 LEAST/GREATEST 不是装饰。浮点误差会让 ACOS 的入参偶尔超出 [-1, 1],超出就返回 NULL,整个距离变成空值,排序直接乱掉。夹一刀就好了——这类 bug 只有真实数据跑起来才会遇到。
十、安全:一个交友 App 必须做的事
交友产品的安全不是"加个验证码",是每一层都要有。
10.1 请求签名
所有业务接口都要签名,防止参数被中途篡改(比如把 peer 改成别人的 ID 去读聊天记录):
1. 参数按名字字典序拼成 k1=v1&k2=v2...2. sig = md5(拼接串 + md5(secret))3. secret = 用户密码前 5 位
密钥不传网络,只用于本地计算,服务端用同样的方式算一遍比对。
10.2 密码与令牌
密码用 bcrypt 加盐哈希存库,数据库泄露也拿不到明文;
令牌双写 Redis + MySQL:Redis 负责快,MySQL 负责服务重启后会话不丢;
有效期 7 天,过期重新登录。
10.3 内容与行为
| 风险 | 措施 |
|---|---|
| 刷屏 | WS 每秒 10 条限流 |
| 单方面骚扰 | 非好友只能发一条,对方回复才解锁 |
| 拉黑 | 服务端校验,被拉黑方消息直接拒收 |
| 敏感内容 | 敏感词表前置拦截,命中不调模型 |
| 成本失控 | 每用户每日 AI 调用上限 200 次 |
| 模型胡说 | 输出截断 + 身份露馅替换 |
10.4 一个容易被忽略的点:单向删除
聊天记录的"删除"该怎么做?
如果做成物理删除,你删了,对方那边也消失了——这不符合直觉,也不符合微信的行为。所以我改成了单向删除:
每条消息有两个标记:
from_del(发送方删了没)、to_del(接收方删了没);你清空聊天记录,只把你这一侧的标记置 1,对方完全无感;
只有当两边都删过,这行数据才真正
DELETE。
实现上最难的不是数据模型,而是所有查询都要记得加过滤:聊天记录、会话列表、离线补发、未读数、语音转文字……漏一处,删掉的消息就会"诈尸"。
但有个地方我故意不过滤——防骚扰判断。因为删除只应该影响"看得见看不见",不应该把"你曾经骚扰过我"的记录洗掉,否则删一次记录就能重新获得一条消息的豁免权。
十一、怎么打包成 APK
11.1 环境
JDK 17、Gradle 8.14.3、Android SDK 33(compileSdk 33 / minSdk 24 / targetSdk 33)。
11.2 一条命令
cd bottle-androidgradle clean assembleRelease
产物在 app/build/outputs/apk/release/。
我另外写了个批处理包了一层(build-app.bat),支持 release / debug / install 三种模式,其中 install 会编译完直接推给连着的手机。
11.3 三个关键配置
① 签名
signingConfigs { release { storeFile file('../keystore/lovebottle.jks') storePassword '******' keyAlias 'lovebottle' keyPassword '******' }}
这是整个项目最不能丢的东西。keystore 丢了,你就再也无法给已安装的用户推送更新——他们只能卸载重装,聊天记录全丢。所以它必须离线多处备份,且绝对不能进 Git。
② 体积:按 ABI 分包
WebRTC 的原生库 libjingle_peerconnection_so 每个架构约 10MB。三个架构全打进去,安装包直接 45MB。
splits { abi { enable true reset() include 'arm64-v8a' // 2017 年后的手机基本都是这个 universalApk false }}
只保留 arm64 之后,45MB → 13.4MB。
③ 混淆与资源压缩
release { minifyEnabled true shrinkResources true}
R8 会删掉没用的代码和资源。注意 WebRTC 和 QQ SDK 的类要加 keep 规则,否则运行时才崩,而且崩得莫名其妙。
11.4 安装包信息
| 项 | 值 |
|---|---|
| 版本 | 1.0.0(versionCode 1) |
| 架构 | arm64-v8a |
| 大小 | 13.4 MB |
| 最低系统 | Android 7.0(API 24) |
| 包名 | com.lovebottle.app |
安装时如果提示"未知来源",需要在系统设置里允许;部分国产 ROM 会先做病毒扫描,点"继续安装"即可。
十二、怎么部署服务端
12.1 编译:一条交叉编译命令
CGO_ENABLED=0GOOS=linux GOARCH=amd64 \ go build -trimpath-ldflags"-s -w" \-o bottle-server ./cmd/server
换成 GOARCH=arm64 就是 ARM 服务器版本。CGO_ENABLED=0 保证编出来的是静态二进制,扔到任何 Linux 上都能跑;-s -w 去掉符号表和调试信息,体积能小三分之一。
我写了脚本一次出三个架构:amd64、arm64、armv7。
12.2 运行时依赖
| 组件 | 作用 | 缺了会怎样 |
|---|---|---|
| MySQL 5.7 | 全部业务数据 | 起不来 |
| Redis | 在线状态、令牌、频控 | 起不来 |
| ffmpeg | 语音消息转 PCM,送 ASR | 不阻塞启动,只是语音转文字不可用 |
| Python + edge-tts | AI 语音合成 | 不阻塞启动,语音回复降级成文字 |
这里有个刻意的设计:ffmpeg 缺失只在启动日志里打一行警告,不阻止服务启动。
因为"语音转文字"只是功能之一,不能因为没装 ffmpeg 就让整个站点起不来。启动时它还会自己去找:先看配置、再找 PATH、最后试几个 NAS 上的常见路径,找到就打印
ffmpeg: 使用 /usr/bin/ffmpeg找不到就打印 [warn] 未找到 ffmpeg,然后继续跑。
12.3 systemd 托管
[Service]Type=simpleUser=bottleWorkingDirectory=/opt/bottleExecStart=/opt/bottle/bottle-server -config configs/server.jsonRestart=alwaysRestartSec=3LimitNOFILE=65535
三个参数值得解释:
Restart=always+RestartSec=3:崩了 3 秒后自动拉起,不用人盯着;LimitNOFILE=65535:每个 WebSocket 长连接占一个文件句柄,默认 1024 连一千人就不够了;Type=simple:因为程序本身就在前台跑、不 fork,写成forking反而会误判启动失败。
另外建议专门建一个 bottle 系统用户来跑,别用 root——服务进程只拥有 /opt/bottle 一个目录的权限,出事的爆炸半径小很多。
12.4 nginx 反代
location /ws {proxy_pass http://127.0.0.1:8080;proxy_http_version 1.1;proxy_set_header Upgrade $http_upgrade;proxy_set_header Connection "upgrade";proxy_read_timeout 3600s;}
/ws 这两行 Upgrade 头不加,WebSocket 握手会失败;proxy_read_timeout 默认 60 秒,不改的话长连接每分钟被 nginx 掐一次,表现就是"消息老是断"。
12.5 上线后自检
部署完不要只看"进程活着",按顺序验三件事:
curl http://127.0.0.1:8080/ # 返回 test_okcurl-i http://127.0.0.1:8080/ws # 返回 401(不是 404/502)journalctl -u bottle-server -f# 看有没有 migrate / ffmpeg 报错
第一条验服务活着,第二条验 WS 路由通、鉴权生效,第三条验数据库迁移和外部依赖。
十三、我是怎么用 AI 工具做出它的
这部分可能对想动手的人更有用。
13.1 我的实际流程
不是"跟 AI 说一句"给我做个交友 App"然后就等它变出来",而是:
需求想清楚 → 先写设计文档 → 再让 AI 写代码 → 用真实数据验一遍先写文档这一步看着慢,其实最省时间。因为文档一旦写清楚(数据表长什么样、接口参数是什么、边界怎么处理),AI 写代码的准确率会高得离谱;反过来,需求模糊的时候,AI 会非常自信地写出一堆"看起来对但完全不是你要的"东西。
这个项目光设计文档就写了 20 多份:数据模型、AI 伴侣、语音通话、视频通话、打包部署、数据库脚本……代码反而是最后才落的。
13.2 三个具体例子
例一:把一个功能从"双向删除"改成"单向删除"
我一开始把"清空聊天记录"做成了双向物理删除。后来意识到不对——微信不是这么干的。于是重新设计成 from_del / to_del 双标记。
难点不在改数据模型,而在找出所有需要加过滤的查询。我让 AI 把 6 个查询点全列出来(聊天记录、会话列表、离线补发、未读标记、语音消息、语音转写),逐个加条件,然后写了一套 30 项的端到端测试:注册两个临时账号、灌 5 条消息、分别清空,断言"我这边看不到、对方那边还在""两边都清了库里的行才真的消失"。
跑完 30 项全绿,我才敢说这个功能做完了。
例二:一个让人抓狂的报错
服务器启动报:
mysql ping: dial tcp: lookup 192.168.1.100.1: no such host看起来是"DNS 解析不到这个 IP",但 IP 怎么会需要 DNS?
查下去发现,数据库连接串里写的是 tcp(192.168.1.100.1:3306)——IP 和端口之间敲成了点号,变成了一个五段地址。Go 的 MySQL 驱动看到地址里没有端口,就自动补了个 3306,然后把整串 192.168.1.100.1 当主机名去解析。当然解析不到。
修是改一个字符的事。但为了下次不再浪费一小时,我让 AI 在启动阶段加了一道 DSN 体检:连库之前先检查 IP 段数对不对、有没有 parseTime、库名有没有写、主机名能不能解析——把驱动的黑话翻译成人话:
MySQL 主机 "192.168.1.100.1" 不是合法 IPv4:当前 5 段,应为 4 段。常见笔误:把端口写成了 ".3306"(端口要用冒号),或 IP 末尾多打了一段。
连库超时、密码错误、库不存在、认证插件不兼容,也各有对应的中文处置提示。
例三:一次真实的"以为好了其实没好"
改完代码,测试全过,我以为完事了。结果装到手机上,登录页还显示旧的服务器地址。
原因是客户端 SharedPreferences 里存着老值,我的默认值改动只在"没有存过值"时生效。于是加了一次性迁移:用 host_migrated_v4 这个标记位,第一次启动时判断存的是不是内网调试地址(10.x / 192.168.x / 172.16-31.x / localhost),是就清掉,让它回落到新默认值。
这类问题 AI 不会主动告诉你——它只看代码,看不到"用户手机里存着旧数据"。只有真机跑一遍才会发现。
13.3 我的体会
AI 最擅长的三件事:
脚手架:16 个 Activity + 7 个 Fragment 的页面骨架、17 张表的建表语句、40 多个接口的分发,打字量最大的部分;
一致性:改了数据模型,把所有受影响的查询点、DTO、客户端解析逻辑一次改干净,人很容易漏;
解释陌生的东西:WebRTC 的 Unified Plan、MySQL 驱动的 DSN 解析、systemd 的 PATH 行为,问它比翻文档快。
AI 不擅长的三件事:
产品判断:AI 视频通话到底该不该做、删除该单向还是双向、拟人延迟该是 800ms 还是 2000ms——这些是价值判断,AI 只会给你一堆"都可以";
真机验证:手机权限弹窗、国产 ROM 的杀后台、STUN 打不通,这些只能拿设备试;
知道自己错了:它会非常自信地写出能编译但有逻辑漏洞的代码。所以测试必须自己写,而且要跑真实数据。
一句话总结:AI 把"写代码"的成本打下来了,但"想清楚要什么"和"验证做对了没有"这两件事,还是人的活。
十四、关于安装包
想试玩的话,安装包信息在上面第 11.4 节,文件名是 app-arm64-v8a-release.apk。
下载方式:公众号后台回复「心语」,获取网盘下载链接。
几点说明:
这是内测版本,连接的是我自己搭的服务器,不保证 7×24 稳定;
首次启动需要注册(用户名 + 密码 + 昵称 + 性别),性别注册后不能改;
没有做用户内容审核的后台能力,请不要发布违规内容;
定位、相机、麦克风权限都是功能需要,不给也能用(只是对应功能不可用);
只提供 arm64-v8a 一个架构,2017 年后的安卓手机基本都能装。
我没有开源服务端,也没有放出编译好的服务端二进制——不是舍不得,是里面涉及真实用户的聊天数据和第三方 API 密钥,我一个人维护不了安全审计的承诺。
但技术细节我尽量在这篇文章里写透了。如果你也在做类似的东西,希望这些坑能帮你少走一点。
最后
这个项目的时间线其实很吓人:10 月 14 日做完协议逆向,10 月 16 日定稿设计文档并开始写代码,10 月 18 日功能基本跑通。前后五天。
它当然还很不完整:没有内容审核后台、没有支付、没有多实例水平扩展、AI 视频通话还没做。但它是一个能跑起来、能注册、能聊天、能打电话、能被真实用户骂"这里怎么有 bug" 的产品,而不是一个 Demo。
我一直觉得,做产品最难的不是"实现功能",是在每一个岔路口做选择,并且承担选择的后果:
要不要为了"像真人"而故意让 AI 回得慢一点?
要不要为了省成本而让 AI 少记一点?
要不要为了"看起来功能多"而做一个半成品的 AI 视频通话?
这些问题没有标准答案,只有你愿意为什么付出代价。
如果你也对"用 AI 工具做一款自己的产品"这件事感兴趣,欢迎在评论区聊聊你想做什么。下一篇我会写:怎么把一个 WebSocket 长连接在国产手机上真正跑稳——那是这个项目里最折磨人的部分。
本文提到的所有技术实现均来自真实代码,非概念演示。