ARTICLE · 1250686
别把公司文档直接喂给AI!我建了十几个库才看清这个真相
资料全部塞进去,AI秒变专家?
垃圾进,垃圾出,喂再多也白喂
数据清洗 · 混合检索 · Score阈值 · Agentic RAG
行思拾光手记 · 建库避坑指南
📦 7 Parts + Conclusion
👉 滑动
PART 01
垃圾进垃圾出
先做断舍离
PART 02
两种检索
全文×向量
PART 03
及格线名额
Score·TopK
PART 04
切片策略
按语义切
PART 05
多模态
看见图片
PART 06
权限隔离
机密别乱飞
PART 07
Agentic RAG
主动调查
PART ///
写在最后
先打好地基
(阅读预计需要 8-10 分钟,建议先收藏再慢慢看)
做AI落地久了,经常遇到一种让人哭笑不得的客户。老板甩来一个几个G的压缩包,豪气干云地说:“公司十年的资料全在这了,赶紧喂给AI,以后员工有啥不懂直接问它。”
在他们眼里,大模型像个无底洞的胃,吃进去的是草,挤出来的该是高纯度的奶。但作为一个建了十几个知识库的“过来人”,我只能苦笑:直接把这一堆乱七八糟的文档塞进去,AI不仅不会变专家,还会变成满嘴跑火车的“疯子”。
“喂数据”远没有想象中那么简单。让AI变聪明的关键,藏在那些看不见的底层逻辑里。
01
PART
垃圾进,垃圾出
GARBAGE IN · GARBAGE OUT
很多客户的知识库,其实是“历史垃圾场”:三年前作废的规章、上个月的临时通知、离职员工的草稿混在一起。把这些互相矛盾的内容喂给AI,它会精神分裂。你问报销标准,它可能把旧规和新规揉在一起,编出一个不存在的数字。
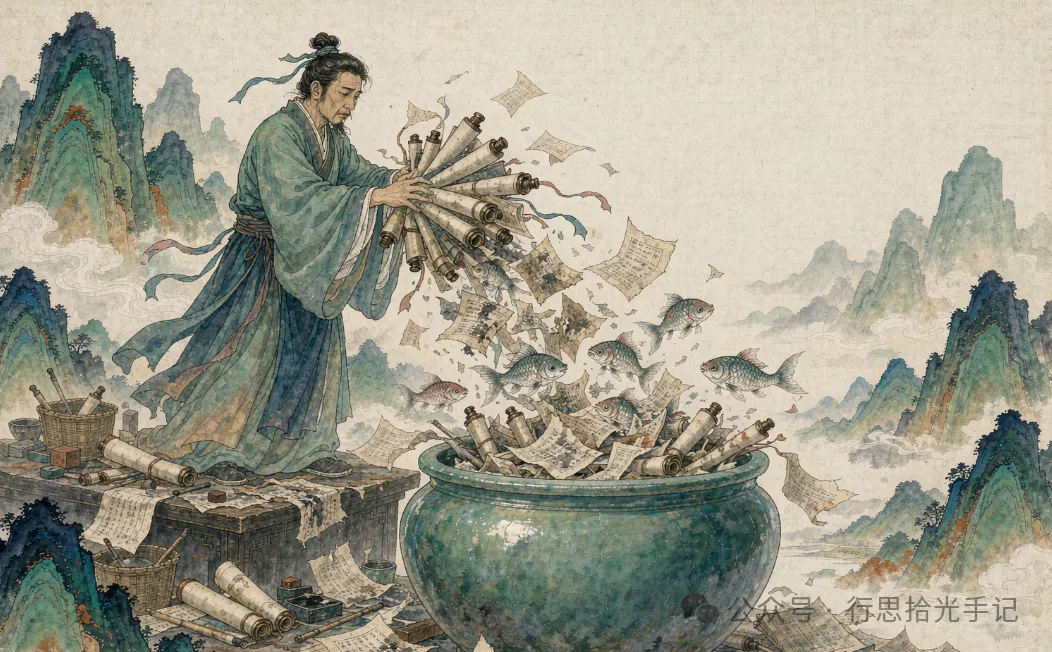
— 十年的文档一股脑入缸,AI分不清新规和废纸
解法:建库第一步不是解析文档,是断舍离。过期的删掉,冲突的标明时间线。AI只负责提取,不负责做真伪鉴定。
02
PART
全文检索像“查字典”,向量检索像“聊感觉”
FULLTEXT × VECTOR
清洗完数据,AI怎么找答案?这里要区分两种基础检索方式。
全文检索像拿书名去图书馆查目录。你说“报销”,它就找带这两个字的段落。精准但死板。如果客户问“差旅费怎么走流程”,文档里只写了“报销制度”,它就傻了。
向量检索像跟管理员说“我想找本讲出差花钱的书”。管理员没看到“报销”俩字,也能根据意思找来相关制度。它把文字转换成数字(向量)计算距离。聪明但偶尔会飘。
所以,好用的知识库从来不做单选题。主流平台都会用混合检索,把“死磕字眼”和“理解意思”结合起来。
03
PART
分数不够,宁可闭嘴
SCORE & TOPK
混合检索会捞出大量段落,但全塞给大模型会把它撑爆。这里有两个关键参数:
Score阈值(及格线):系统给检索到的段落打分,只有匹配度超过及格线的,才有资格送到大模型面前。设低了,AI看垃圾开始胡编;设高了,什么都找不到,直接哑火。
TopK(名额限制):就算一百个段落及格,也只取分数最高的前 K 个(如Top 3)给模型看。太大噪音多,太小信息不全。
调这两个数,是产品经理最枯燥也最见功力的日常。
04
PART
切片,决定AI会不会“断章取义”
CHUNKING
文档太长得切碎。切太碎,上下文断了,AI可能只看到“禁止操作”,没看到“除某某情况外”;切太大,无关信息干扰抓重点。
解法:按语义切,而不是按字数无脑切。一段完整的问答、一个表格切在一起,保留完整业务逻辑。
05
PART
多模态检索,AI正在“看见”图片
MULTIMODAL
企业知识不只文字,还有产品照片、架构图、报错截图。
现在前沿的多模态检索,能把图片和文本放进同一个语义空间。用户问“这个报错界面对应哪个流程”,系统能把截图和文字一起找出来。未来的知识库,不再区分“文本库”和“图片库”。
06
PART
权限混乱,机密到处飞
PERMISSION
最致命的业务坑。直接把高管薪酬的文档喂给AI,员工问一句“老板赚多少钱”它老实答出来,就是重大安全事故。
解法:严格隔离。销售查销售库,人事查人事库。当多个 Agent 共享知识底座时,权限设计不仅是“谁能问”,更是“哪个Agent能读、读到什么程度”。
07
PART
从“一锤子买卖”到“主动调查”
AGENTIC RAG
刚才讲的,都属于传统RAG。它像个只会按固定路线走的快递员:提问→搜一次→生成答案→结束。
但真实业务问题很复杂。比如:“对比一下华东和华南区上季度Top3产品的库存。”传统RAG直接拿整句去搜,大概率答非所问,因为它不会“拆解问题”。这就是行业正在向Agentic RAG(代理式RAG)进化的原因。
它给知识库配了一个“经验丰富的调查员”。
— 调查员带着工具箱查案:拆解、纠错、多轮检索
思考与行动循环(ReAct):调查员接到案子先想:“得先查华东销量”。查完一看:“华南数据没查到”。它不会瞎编,而是换个词再查。这就是大模型的“推理-行动”循环。
带着工具箱查案(Function Calling):它不仅有文档库,还能调外部API、查SQL数据库。知道什么问题用什么工具。
专家会诊(多智能体协同):大案子由“路由Agent”分发,找线索的(检索Agent)和核对线索的(验证Agent)分工合作。
查户口本(知识图谱):遇到深度关系推理,它会翻开“族谱”(知识图谱),顺着实体连线一步步找答案。
它从“被动查阅”变成了“主动调查”,会自己拆解、纠错、多轮检索。
///
LAST
别追新概念,先把地基打好
SUMMARY
技术演进极快,工具越来越聪明。但我反而觉得,最核心的难点依然没变。
数据清洗、切片策略、Score阈值、权限隔离,这些不会因为架构升级而消失。Agentic RAG 是在这层地基上盖楼,地基没打好,楼越高塌得越快。
建知识库,拼的不是模型多牛,而是产品经理对业务的梳理能力。知识库不是垃圾桶,是图书馆,你得分类上架、做好索引。
记住这句话
花80%的时间去清洗数据、调优参数,只花20%的时间去追新工具。
数据喂对了,AI自然就聪明了。
阿雪,AI产品经理
公众号:行思拾光手记
行思拾光,边走边记。“行思”是边走边想,“拾光”是拾取时光。
这里写AI、写产品、写复盘与成长。也写一个AI产品经理的真实思考。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING