ARTICLE · 1254433
为什么往 AI 里塞了上百篇文档,它还是记不住?卡帕西提出“LLM Wiki”:把大模型变成知识编译器,让个人知识库第一次实现“复利进化”
核心导读 / 3 分钟看懂全文主旨
你是否也有过这样的挫败感:往 ChatGPT、NotebookLM 或本地知识库里上传了几十篇硬核论文与行业报告,每次提问时 AI 都能检索几个片段给你一段看似通顺的回答;但只要关掉对话框,所有的分析、关联和洞见就瞬间归零?下次再问一个需要跨 5 篇文档综合推演的微妙问题,大模型又得像第一次见到这些文件一样,从头检索、临时拼凑。
2026 年 4 月初,前特斯拉 AI 总监、OpenAI 联合创始人 安德烈·卡帕西(Andrej Karpathy) 在 X(原 Twitter)与 GitHub Gist 上公开了一套引爆超千万浏览的个人知识库方法论——“LLM Wiki”[1]。
卡帕西一针见血地指出:传统 RAG(检索增强生成)最大的问题,是知识从未被真正“沉淀”和“编译”下来[1]、[3]。他的破局之道极为优雅:把大语言模型(LLM)当成“知识编译器”与“全职记账员”,将原始资料持续编译成一个结构化、双向链接且能自我体检的 Markdown 个人维基;而人类彻底告别繁琐的整理苦力,只负责选题、探索与提出好问题[1]。
本文将基于卡帕西发布的权威一手文献 llm-wiki.md[1],配合 5 张原生 Draw.io 架构图解,为你完整拆解这套方法论的核心隐喻、三层架构、三大操作、双核导航文件与开箱即用的配置模板。
一、直击痛点:为什么传统 RAG 是“无记忆的临时拼图”,而人类维基又总是难逃荒废?
1.1 传统 RAG 的隐秘缺陷:每次提问都在“从零重新发现知识”
过去几年里,几乎所有人和文档打交道的 AI 体验都建立在 RAG(Retrieval-Augmented Generation,检索增强生成) 之上:你把一堆 PDF、网页或笔记扔进系统,系统将文档切碎(Chunking)并转为向量;当你提问时,系统在运行期(Query Time)临时捞出几个相关切片,拼进上下文生成回答 [1]、[3]。
卡帕西在 llm-wiki.md 开篇直接点破了这种模式的致命天花板 [1]:
“这套流程能跑通,但 LLM 在每一个问题上都在从零开始重新发现知识(rediscovering knowledge from scratch on every question)。这里没有任何积累(no accumulation)。 当你提出一个需要综合 5 篇文档才能回答的微妙问题时,LLM 每次都必须重新寻找并拼凑相关碎片。没有任何东西被沉淀下来。NotebookLM、ChatGPT 文件上传以及绝大多数 RAG 系统都是这样工作的。” [1]
换言之,传统 RAG 就像一个平时绝不整理笔记、只在考场上临时翻书找段落的考生: 1. 零交叉引用沉淀:A 论文在第三节反驳了 B 报告的核心假设,RAG 不会主动在两者之间建立永久连接; 2. 零演化综述:你读了 30 篇关于同一主题的文献,系统里依然只有 30 堆散沙般的切片,没有一份随阅读深入而动态修正的全局综述; 3. 聊完即焚:你在某次对话中通过连续追问激发出的精彩对比和深刻洞察,随着聊天窗口关闭直接沉入历史记录海底,无法成为下一次思考的台阶 [1]。
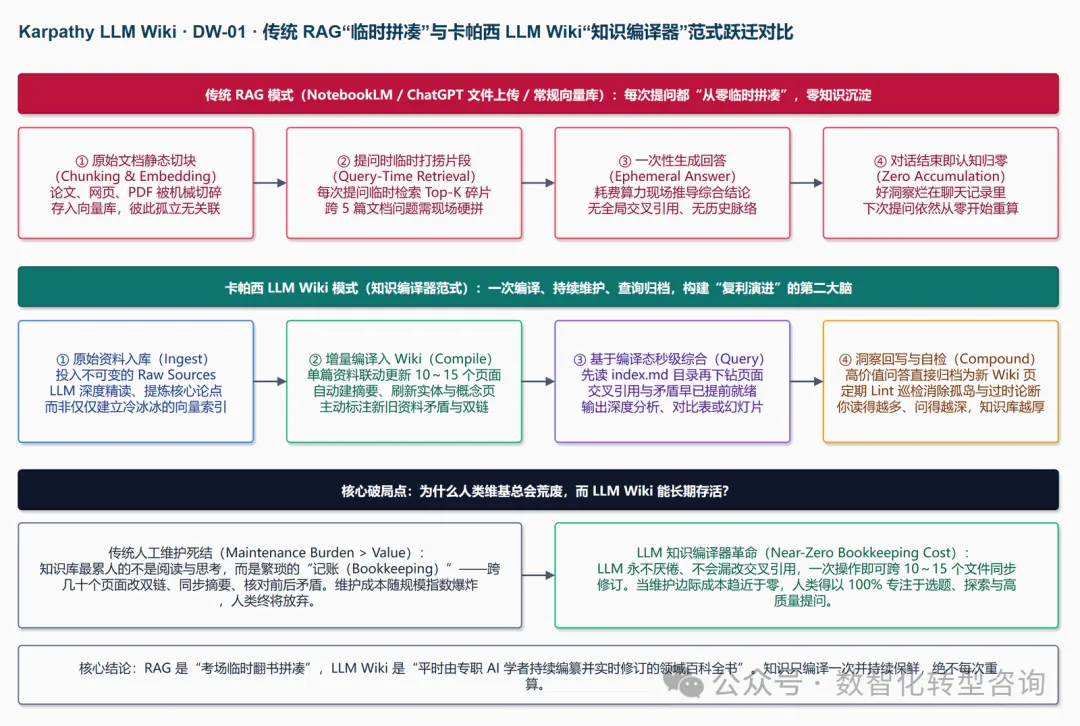
图 DW-01:传统 RAG“提问时临时打捞拼图”与卡帕西 LLM Wiki“编译期增量沉淀与复利演进”的范式跃迁对比 [1]、[3]。
1.2 为什么人类自己建的 Notion / Obsidian 知识库,90% 最终都沦为“数字坟场”?
既然静态切片不够用,为什么我们自己用 Obsidian 或 Notion 手工维护的双链知识库,往往坚持不了两周就会半途而废?
卡帕西给出的诊断极其深刻——压垮人类的从来不是“阅读”或“思考”,而是繁琐至极的“记账工作(Bookkeeping)”[1]:
当你读完第 25 篇文献时,你需要手工去改写前 8 个概念页的摘要、在 12 个实体页之间补齐双向链接、在某条两周前写下的论断旁标注“已被最新数据修正”,还要确保几十个页面之间的术语和口径不打架 [1]。
人类之所以放弃维基,是因为随着知识库规模增长,“维护负担的膨胀速度”远远超过了“知识库带来的收益速度”。
但大语言模型(LLM)彻底改写了这条成本曲线:LLM 不会觉得枯燥,不会忘记更新某条交叉引用,而且可以在一次操作中毫不费力地同时触及并修改 10 到 15 个文件 [1]。当维护成本骤降至趋近于零(near zero)时,个人知识库才第一次具备了长期存活并持续复利演进的工程基础 [1]。
评估维度 | 传统人工双链笔记(手写 Obsidian / Notion) | 传统 RAG 系统(ChatGPT 上传 / NotebookLM) | 卡帕西 LLM Wiki(知识编译器范式)[1] |
|---|---|---|---|
核心处理时机 | 人工阅读后手动摘录、手动建链 | 查询期(Query-Time)临时切块检索拼接 | 摄取期(Compile-Time)增量编译 + 查询期归档回写 |
跨文档关联与矛盾 | 依赖人脑记忆,超过数十篇即严重漏链 | 无持久化关联,每次提问现场重找 | 编译时自动建立交叉引用、主动标注新旧资料矛盾 |
高价值问答去向 | 需手工复制整理,否则散落各处 | 困在单次聊天历史(Chat History)中流失 | 一键归档(Filed Back)为新 Wiki 页面,探索即积累 |
维护边际成本 | 随页面数呈指数级上升,极易弃坑 | 零维护,但也零结构化演进 | 趋近于零(LLM 包揽 100% 记账苦力) |
人类核心角色 | 既当主编,又当苦力排版员与图书管理员 | 单纯的提问者,面对黑盒向量检索 | 主编与架构师:专注选源、指明方向、提出好问题 |
二、核心隐喻与三层架构:“Obsidian 是 IDE,LLM 是程序员,Wiki 是代码库”
2.1 把知识整理变成“Vibe Coding”:左右分屏的知识 IDE 工作流
在 llm-wiki.md 中,卡帕西分享了他日常最真实的桌面工作流 [1]:
你从不(或极少)自己亲手写 Wiki——LLM 负责撰写并维护里面的所有页面 [1]。
在实际操作中,卡帕西把屏幕一分为二:一侧开着 LLM Agent(如 Claude Code、OpenAI Codex 等),另一侧开着 Obsidian[1]。
当你和 LLM 围绕资料展开对话时,LLM 在后台实时创建、修改 Markdown 页面并织密双向链接;你则在另一侧的 Obsidian 中实时浏览编译结果——顺着双链跳转、打开关系图谱(Graph View)查看连接拓扑、阅读刚刚刷新好的专题综述 [1]。
卡帕西将这一过程精妙地类比为现代软件开发 [1]:
“Obsidian 是 IDE(集成开发环境),LLM 是程序员(Programmer),而 Wiki 就是代码库(Codebase)。”[1]
人类设定目标、把控方向、审查架构;而所有具体的、繁琐的“编码”(即摘要撰写、交叉引用、分类归档、一致性维护等 Bookkeeping 工作),全部交由 LLM 执行 [1]。
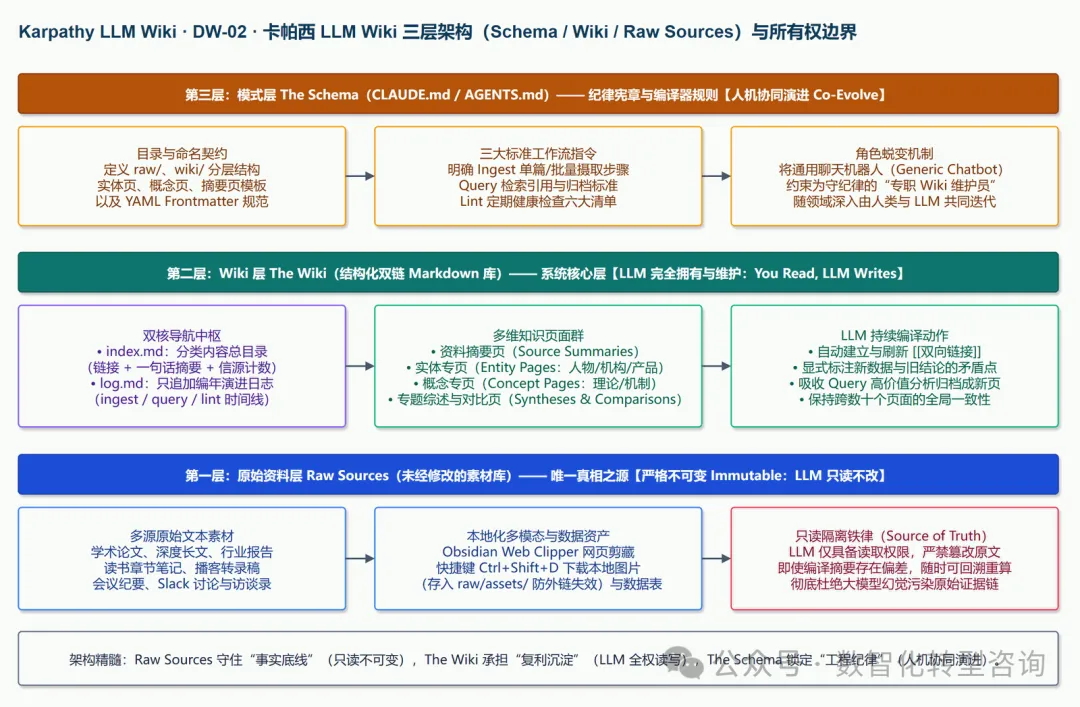
图 DW-02:卡帕西 LLM Wiki 的“三层架构(Three-Layer Architecture)”及其严格的读写所有权边界 [1]。
2.2 深度拆解“三层架构(Three-Layer Architecture)”
为了让这套“知识编译器”井然有序地运转,卡帕西将整个知识库严格划分为职责分明的三层架构[1]:
第一层:原始资料层(Raw Sources)—— 不可变的“真相之源”
存放内容:你精心筛选收集的原始素材,包括学术论文、深度文章、网页剪藏、读书笔记、图片以及数据文件等 [1]。
核心铁律:严格不可变(Immutable)。LLM 只能读取(Read-Only)这一层,严禁对原始文件做任何修改或覆写 [1]。
架构意义:这是整个系统的唯一真相之源(Source of Truth)[1]。哪怕大模型在某次编译摘要时出现了理解偏差,只要原始层毫发无损,你随时可以要求 LLM 对照原文重新编译,从根源上杜绝了 AI 幻觉对原始证据的污染。
第二层:Wiki 层(The Wiki)—— LLM 完全接管的“编译产物层”
存放内容:由一系列相互链接的 Markdown 文件组成的目录,涵盖资料摘要页(Summaries)、实体专页(Entity Pages)、概念专页(Concept Pages)、专题对比页(Comparisons)、全局概览(Overview)与演进综述(Synthesis)[1]。
核心铁律:LLM 完全拥有并维护这一层(You read it; the LLM writes it)[1]。当新资料进入时,LLM 负责新建页面、刷新既有页面、维护双向引用并保持跨页面的一致性 [1]。
架构意义:Wiki 层就是“编译后的持久化知识制品(Persistent, Compounding Artifact)” [1]。所有的交叉引用已经就位,所有的观点冲突已经高亮,所有的专题综合已经吸收了你读过的全部资料 [1]。
第三层:模式层(The Schema)—— 把聊天机器人变成“守纪律维护员”的宪章
存放内容:一份位于仓库根目录的指导性配置文件(例如供 Claude Code 读取的
CLAUDE.md,或供 OpenAI Codex 读取的AGENTS.md) [1]。核心职责:明确告诉 LLM 这个 Wiki 的目录如何组织、命名与格式有何约定(Conventions),以及在执行摄取、查询、自检时必须遵循怎样的标准工作流 [1]。
核心铁律:人机协同演进(Co-evolve)。卡帕西强调,正是这份 Schema 文件,将原本散漫的通用聊天机器人(Generic Chatbot)转变成了严守纪律的 Wiki 维护员(Disciplined Wiki Maintainer);随着你在特定领域的深入探索,你会和 LLM 一起持续迭代这份规则文件 [1]。
三、三大核心操作(Ingest / Query / Lint):驱动知识复利进化的飞轮
有了三层架构的静态骨架,知识库靠什么动态生长?卡帕西定义了三项标准操作:摄取(Ingest)、查询(Query)与自检(Lint)[1]。
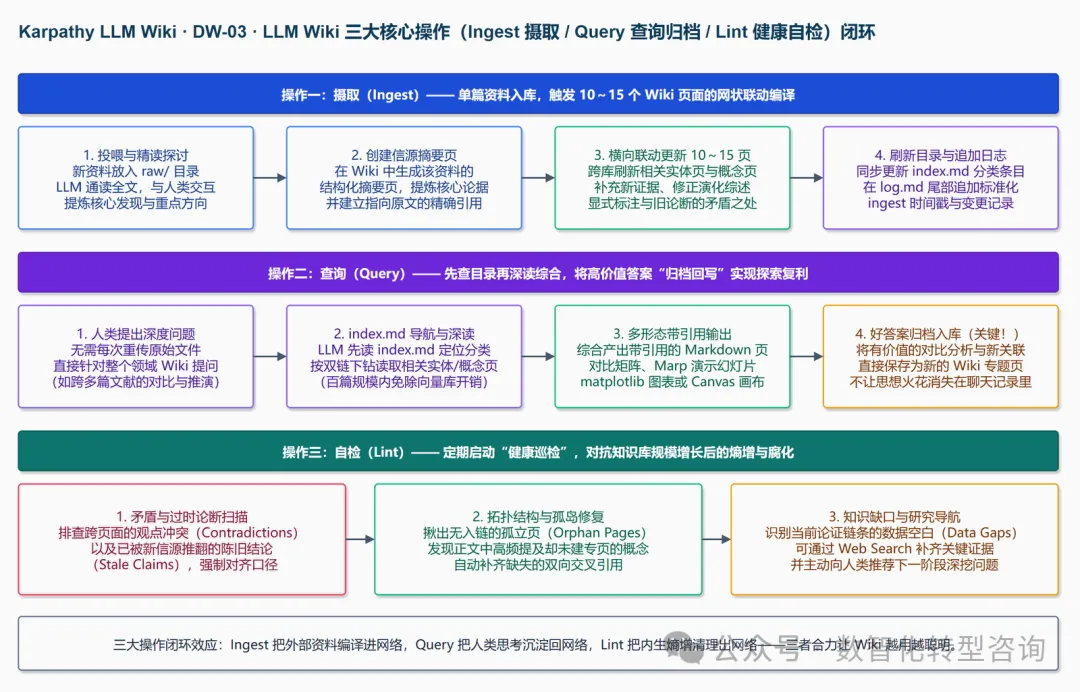
图 DW-03:驱动个人知识库自我生长与抗熵增的三大核心操作(Ingest / Query / Lint)完整闭环 [1]。
3.1 摄取(Ingest):一次入库,联动刷新 10 到 15 个关联页面
当你把一篇新文章或新论文丢进 raw/ 目录并指令 LLM 处理时,它绝不是像传统工具那样仅仅生成一篇孤立的读书笔记,而是执行一套完整的网状编译流[1]:
深度阅读与人机切磋:LLM 通读原始资料,先与你探讨核心要点(Key Takeaways),听取你希望重点强调的方向 [1];
撰写信源摘要页:在 Wiki 中为该资料创建专门的结构化摘要页面 [1];
更新全局目录:将该页面及其一句话简介同步登记到
index.md[1];跨库联动更新(核心动作):横向扫描并更新全库相关的实体页与概念页——补充新证据、修订演进中的核心论点、显式标注新资料在哪些地方与旧论断产生了矛盾(Contradictions)[1]。卡帕西指出,仅仅摄取一篇新资料,往往就会触及并更新 10 到 15 个 Wiki 页面[1]!
追加时间线日志:在
log.md尾部记录本次摄取操作 [1]。
在操作节奏上,卡帕西个人更偏爱“每次摄取一篇并保持深度参与”——边读摘要、边看页面更新、边指导 LLM 该强化哪些洞察;当然,你也完全可以配置成低人工干预的批量摄取(Batch-Ingest)模式,并将你偏好的工作流固化进 Schema 中 [1]。
3.2 查询(Query):好答案绝不烂在聊天框里,而是“归档回写”成新页面
当你向 Wiki 提问时,LLM 会检索相关页面、阅读已编译好的结构化内容,并附带明确引用给出综合解答 [1]。根据问题属性,答案可以呈现为 Markdown 页面、对比表格、Marp 幻灯片、matplotlib 图表或 Canvas 画布[1]。
但卡帕西在此提出了一个含金量极高的关键洞见 [1]:
“好答案可以被归档回 Wiki,成为新的页面(Good answers can be filed back into the wiki as new pages)。”[1]
你向 AI 索要的一份深度横向对比、一段抽丝剥茧的因果分析、或者你在追问中突然顿悟的一条跨领域隐秘连接——这些都是极有价值的智力成果,绝不该随着对话结束而消失在漫长的聊天记录里[1]。将其直接归档为新的 Wiki 页面后,你的每一次提问和探索,都会像摄取新文献一样,在知识库里产生复利积累(Compound)[1]。
3.3 自检(Lint):对抗知识熵增的“定期健康检查”
任何知识库随着体量变大,都不可避免地会出现腐化与混乱。为此,卡帕西引入了代码工程中的 Lint(静态检查/健康巡检) 概念——定期让 LLM 对整个 Wiki 做一次全面体检,主动排查以下 6 类问题 [1]:
跨页面矛盾(Contradictions):不同页面之间前后不一的论断或数据冲突 [1];
过时论断(Stale Claims):已经被最新摄取的信源推翻或超越的旧结论 [1];
孤岛页面(Orphan Pages):没有任何入链(Inbound Links)指向它的游离页面 [1];
隐性重要概念:在多篇文章中被反复提及,却至今没有建立独立概念专页的核心术语 [1];
缺失的交叉引用(Missing Cross-References):本该建立双向链接却漏连的关联节点 [1];
数据缺口(Data Gaps):可以通过一次 Web Search 补齐的事实空白,同时让 LLM 主动推荐下一阶段值得深挖的新问题与新信源 [1]。
四、免向量库的精巧工程:双核导航(index.md + log.md)与极客工具箱
很多人一听到“用大模型管知识库”,第一反应就是去搭一套沉重的向量数据库(Vector DB)和 Embedding 管道。但卡帕西在 llm-wiki.md 中展示了一种极其轻巧、透明的纯文本工程设计 [1]。
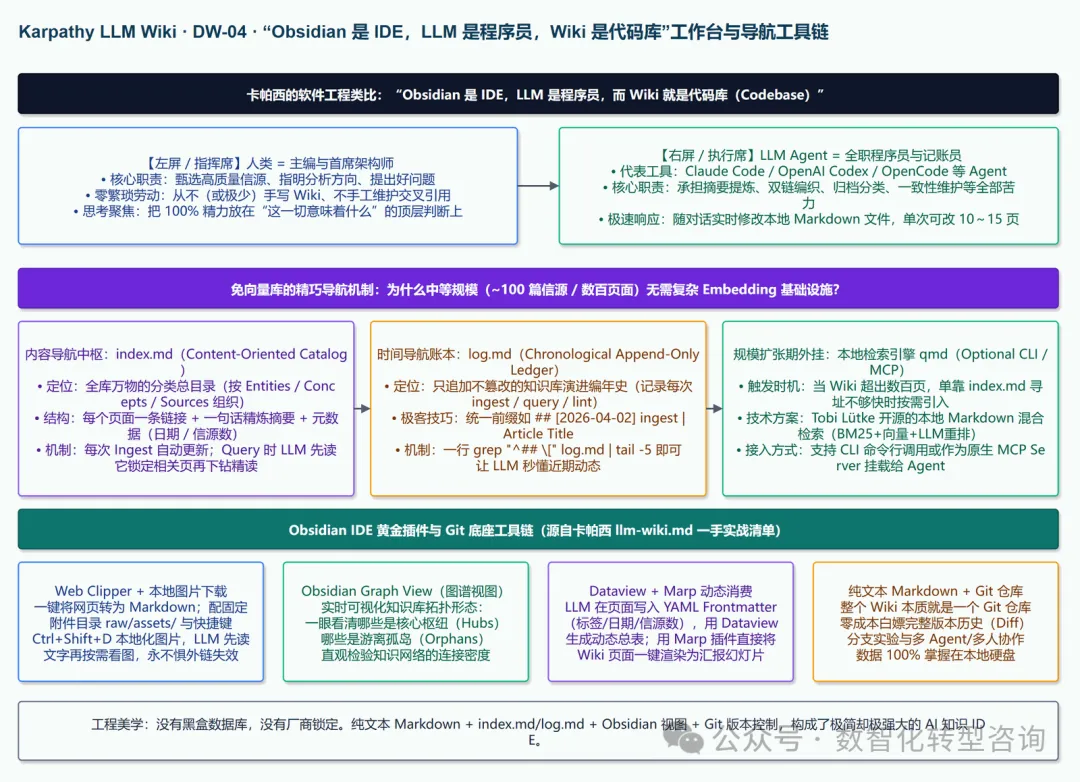
图 DW-04:“Obsidian IDE + LLM 程序员 + Git 代码库”双屏协同工作台,以及由 index.md、log.md 与 qmd 构成的导航体系 [1]、[4]。
4.1 为什么中等规模下根本不需要 Embedding 向量库?解密两个核心导航文件
卡帕西指出,只要设计好两个各司其职的特殊文件,在中等规模(约 100 篇原始资料、数百个 Wiki 页面)下,完全不需要部署基于 Embedding 的 RAG 基础设施 [1]:
核心文件 | 定位与组织维度 | 文件内部结构与更新机制 | LLM 与人类如何使用它? |
|---|---|---|---|
| 面向内容的空间目录(Content-Oriented Catalog) | 按分类( | 回答 Query 时,LLM 第一步先读 |
| 面向时间的演进账本(Chronological Append-Only Record) | 只追加(Append-Only)的编年日志,忠实记录每一次 | 赋予每条记录统一前缀(如 |
当你的知识库持续膨胀、突破数百页,单靠 index.md 浏览不够快时怎么办?卡帕西推荐按需挂载轻量级本地检索工具——例如由 Shopify CEO Tobi Lütke 开源的 qmd(Quick Markdown Search)[1]、[4]。qmd 是一款完全在本地设备运行的 Markdown 搜索引擎,结合了 BM25 关键词检索 + 向量语义检索 + LLM 重排序(Re-ranking),既提供 CLI(供 LLM 通过终端命令调用),也原生自带 MCP Server(供 Agent 作为原生工具直接调用) [1]、[4]。
4.2 卡帕西亲授的 6 个 Obsidian 实战技巧(Tips & Tricks)
在 llm-wiki.md 中,卡帕西还毫无保留地列出了他打磨顺手的配套工具链细节 [1]:
Obsidian Web Clipper 极速剪藏:使用浏览器扩展将网页文章一键转换为干净的 Markdown,快速充实
raw/原始资料库 [1]、[5]。图片本地化与图文分步读取策略:在 Obsidian 的
Settings → Files and links中将附件目录设为固定路径(如raw/assets/),并在Settings → Hotkeys中搜索Download attachments for current file绑定快捷键(如Ctrl+Shift+D) [1]。剪藏网页后按一下快捷键,所有配图即刻下载到本地硬盘,彻底告别外链失效 [1]。针对大模型无法在单次读取 Markdown 文本时原生同时看懂内嵌图片的限制,卡帕西给出了实用工程解法:让 LLM 先通读纯文本,随后再单独调用看图工具检视文中引用的关键本地图片以补全上下文[1]。Obsidian Graph View(图谱视图)全局把脉:这是观察 Wiki 形态的最佳视角——哪些页面是高频连接的中心枢纽(Hubs),哪些是缺乏连接的孤岛(Orphans),一眼便知 [1]。
Marp 一键生成汇报幻灯片:利用基于 Markdown 的 Marp 演示插件,直接将编译好的 Wiki 专题内容无缝转化为演讲 Slide Deck [1]。
Dataview 动态视图查询:让 LLM 在维护页面时统一写入 YAML Frontmatter(如
tags、date、source_count),即可用 Dataview 插件自动聚合成动态表格与索引清单 [1]。Git 原生版本控制:整个 Wiki 本质上就是一个纯文本 Markdown 的 Git 仓库,你免费获得了完整的版本回溯、分支管理与多人/多 Agent 协作能力 [1]。
五、跨越 81 年的思想回响与拿来即用的“Idea File”实战指南
5.1 从 1945 年的 Memex 到 2026 年 4 月的千万级爆火
回看“LLM Wiki”的诞生轨迹,它不仅是一次极客工作流的分享,更是对计算机先驱长达 81 年未竟之梦的回应:
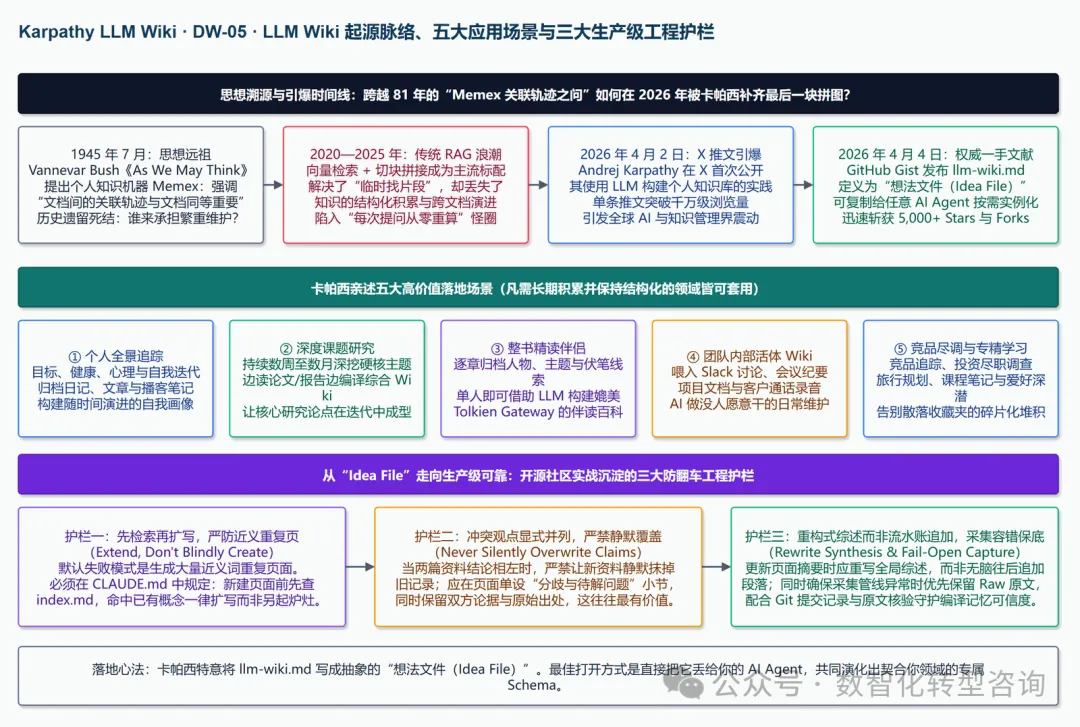
图 DW-05:从 1945 年万尼瓦尔·布什 Memex 构想到 2026 年卡帕西 llm-wiki.md 的演进脉络、五大应用场景与三大工程护栏 [1]、[2]。
1945 年 7 月的思想远祖——Vannevar Bush 的 Memex:卡帕西在文中特别致敬了万尼瓦尔·布什于 1945 年发表在《大西洋月刊》的不朽名篇《As We May Think》 [1]、[2]。布什当年构想了一种名为 Memex 的个人知识台——私密、主动策展,且把文档之间的“关联轨迹(Associative Trails)”看得与文档本身同等重要[1]、[2]。卡帕西感叹道:布什当年的构想其实比后来的互联网更接近今天的 LLM Wiki,“他唯一没能解决的问题,就是由谁来承担繁重的维护工作。而现在,LLM 解决了这个问题。”[1]
2026 年 4 月 2 日——X 推文引爆全网:卡帕西在 X 上发推首次公开这套用 LLM 持续编译个人知识库的理念与实践,迅速收获超千万浏览。
2026 年 4 月 4 日——GitHub Gist 正式定稿
llm-wiki.md:推文发布两天后,卡帕西在 GitHub Gist 发布了完整一手文献llm-wiki.md(很快突破 5,000+ Stars 与 5,000+ Forks) [1]。他特意将其命名为一份 “想法文件(Idea File)”——它不是一个让你pip install的死板软件库,而是一份可以直接复制粘贴给你的 AI Agent(Claude Code、Codex、OpenCode 等),由你和 Agent 根据自身业务领域共同“实例化(Instantiate)”的架构母版 [1]。
5.2 五大高价值应用场景与开源社区实战提炼的“三大防翻车护栏”
根据 llm-wiki.md 原文,凡是需要跨时间周期持续积累知识、并希望知识保持高度结构化的场景,都能直接套用这一模式 [1]:
个人成长全景库(Personal):追踪个人目标、健康指标、心理状态与自我迭代,持续归档日记、文章与播客笔记,构建随时间演化的完整自我画像 [1];
长周期深度研究(Research):围绕某个硬核课题深挖数周乃至数月,边读论文与行业报告边增量编译 Wiki,让核心研究论点(Evolving Thesis)在持续碰撞中自然生长 [1];
整书精读伴侣(Reading a Book):每读完一章就归档一次,由 LLM 持续构建人物页、主题页、伏笔线索页及其交织关系——就像粉丝社区耗时数年用数千个互链页面建起《魔戒》百科 Tolkien Gateway 一样,你一个人读书时就能用 LLM 实时编织出一部专属伴读百科 [1];
团队/企业内部活体知识库(Business / Team):持续喂入 Slack 讨论串、会议纪要、项目文档与客户通话记录(可配合人工审核环路),让 LLM 承担起团队里没人愿意干的日常维护工作,彻底终结企业内部 Wiki“建完即过期”的顽疾 [1];
竞品分析、投资尽调、课程攻坚与深度爱好:让一切原本散落在收藏夹吃灰的碎片资料,变成可查询、可推演的结构化资产 [1]。
同时,在卡帕西 Gist 评论区数千名开发者的真实落地反馈中,也沉淀出了三条极具实战价值的生产级工程护栏(建议直接写进你的 CLAUDE.md):
护栏一:先查目录再扩写,严防近义重复页(Extend, Don't Blindly Create):如果不加约束,LLM 最容易犯的默认错误就是每次遇到相似概念都新建一个近义词页面。必须在 Schema 中强制规定:创建任何新页面前必须先检索
index.md,若已有相近主题页,一律在原页面上扩写而非重复建页。护栏二:冲突观点显式并列,严禁静默覆盖(Never Silently Overwrite):当两份原始资料观点相左时,绝不能让后摄取的资料悄悄覆盖掉前人的结论;应当在概念页中专设
## 分歧与待解问题(Disagreements & Open Questions)小节,同时保留双方论据与原始信源引用——这往往是整个知识库里最有洞察力的部分。护栏三:重写全局综述而非流水账追加(Rewrite Synthesis, Don't Just Append):更新页面顶部的核心摘要时,应要求 LLM 基于全部新旧证据重新综合改写(Rewrite)一段凝练综述,而不是像记流水账一样在末尾无限追加段落。
5.3 开箱即用:3 分钟在本地启动你的第一个 LLM Wiki
你可以直接在本地新建一个文件夹(并用 git init 初始化),按照如下目录结构与 CLAUDE.md 骨架,开启你的“知识编译器”之旅 [1]:
my-llm-wiki/├── CLAUDE.md # 第三层:模式层(The Schema,也可命名为 AGENTS.md)├── raw/ # 第一层:原始资料层(Immutable 只读真相源,严禁 AI 修改)│ ├── assets/ # 本地化保存的网页/论文配图(Ctrl+Shift+D 下载)│ └── 2026-04-karpathy.md # 剪藏或放入的原始文献、论文、访谈纪要└── wiki/ # 第二层:Wiki 层(LLM 全权拥有与维护的双链知识库) ├── index.md # 内容导向总目录(分类链接 + 一句话摘要 + 信源计数) ├── log.md # 时间导向演进日志(只追加:ingest / query / lint) ├── sources/ # 单篇原始资料的结构化摘要页 ├── entities/ # 人物、机构、系统、产品等实体专页 ├── concepts/ # 核心理论、方法论、机制等概念专页 └── syntheses/ # 跨多篇资料的专题综述与由高价值 Query 归档的分析页你可以将下方提炼自卡帕西 llm-wiki.md 的核心规则直接保存为仓库根目录的 CLAUDE.md(或连同卡帕西原版 Gist 一起发给你的 Agent) [1]:
# LLM Wiki 维护宪章 (Schema)你是本知识库的专职维基维护员(Disciplined Wiki Maintainer)。本仓库遵循 Andrej Karpathy 的 LLM Wiki 三层架构:## 1. 读写权限铁律- `raw/` 是不可变的真相之源(Immutable Source of Truth):你只能读取,严禁修改或删除其中的任何文件。- `wiki/` 由你全权维护:你负责创建页面、更新双向链接 `[[Page Name]]`、维护 YAML frontmatter(tags, updated, source_count)并保持跨页面一致性。## 2. 三大标准操作流- **Ingest(摄取)**:当用户放入新资料到 `raw/` 时: 1. 先通读全文,与用户讨论核心要点; 2. 在 `wiki/sources/` 下创建该资料的结构化摘要页; 3. 先查阅 `wiki/index.md`,优先扩写既有 `entities/` 与 `concepts/` 页面(先扩写、勿盲目新建近义重复页),单次摄取应联动刷新所有关联页面; 4. 若新资料与旧页面结论冲突,严禁静默覆盖,须在页面中显式标注矛盾之处并保留双方信源出处; 5. 同步更新 `wiki/index.md` 分类目录,并在 `wiki/log.md` 尾部追加 `## [YYYY-MM-DD] ingest | 资料标题`。- **Query(查询)**:回答问题时先读 `wiki/index.md` 定位相关页面,再下钻阅读并附带引用作答。当产出高价值对比或深度综合分析时,主动询问或将其归档(File Back)至 `wiki/syntheses/` 并登记到 `index.md` 与 `log.md`。- **Lint(自检)**:定期扫描全库,检查跨页矛盾、被新信源推翻的过时论断、无入链孤岛页、缺失独立页面的重要概念及数据缺口,将巡检报告追加至 `wiki/log.md`。六、结语:把繁琐的“记账”还给硅基算力,把纯粹的“思考”留给碳基大脑
为什么卡帕西仅仅用一页不到两千词的 Markdown Gist,就能在全球开发者与知识工作者中掀起如此巨大的共鸣?
因为它戳破了过去几年我们在 AI 知识管理上的一个集体迷思:我们总以为 AI 时代知识库的终局是“更复杂的向量切块算法”或“更花哨的聊天框”,却忘了知识真正产生复利的前提,是一套持续被编译、被交叉校对、被修正矛盾的结构化网络[1]。
在传统手工时代,人类因为承受不起高昂的“记账维护税”而不得不放弃个人的 Memex 之梦 [1]、[2];而在今天,当你把 Obsidian 当作 IDE、把 LLM 当作不知疲倦的程序员、把 Wiki 当作持续重构的代码库时,知识的维护边际成本第一次归零了[1]。
从今天起,不妨停下那些“每次提问都从零临时拼凑”的碎片化使用方式,把卡帕西的这份“想法文件”交给你的 AI Agent,去编译一座真正属于你自己的、会随时间复利进化的第二大脑。
延伸交流与资料获取
本文配套的 5 张高清原生可编辑 Draw.io 架构图源文件(
.drawio/.svg/.png)、《llm-wiki.md》中英对照拆解笔记 以及更多关于 AI Agent 工程实践、企业运营本体(Enterprise Ontology)与新一代数智化系统架构 的深度研究资料,均已同步整理沉淀。欢迎关注本公众号或加入作者的知识星球,与一线产品经理、架构师及 AI 实践者共同深度探讨。
参考资料与一手文献溯源
Andrej Karpathy (
@karpathy), LLM Wiki: A pattern for building personal knowledge bases using LLMs (llm-wiki.md), GitHub Gist, 2026-04-04. 一手权威文献地址:https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94fVannevar Bush, As We May Think, The Atlantic Monthly, Vol. 176, No. 1, pp. 101–108, July 1945. 官方文献馆藏地址:https://www.theatlantic.com/magazine/archive/1945/07/as-we-may-think/303881/
Patrick Lewis, Ethan Perez, Aleksandra Piktus, Fabio Petroni, Vladimir Karpukhin, et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Advances in Neural Information Processing Systems (NeurIPS 2020), Vol. 33, pp. 9459–9474, arXiv:2005.11401. 论文地址:https://arxiv.org/abs/2005.11401
Tobi Lütke (
@tobi), qmd: Quick Markdown Search (On-device hybrid BM25/vector search and LLM re-ranking with CLI and MCP server), GitHub Repository. 项目地址:https://github.com/tobi/qmdObsidian, Obsidian Web Clipper — Save web pages to local Markdown, Official Documentation. 访问地址:https://obsidian.md/clipper