ARTICLE · 1256437
AgiBot World 源码精读:100 万条机器人轨迹,怎么喂出具身智能的 ImageNet 时刻?
AgiBot World 源码精读:100 万条机器人轨迹,怎么喂出具身智能的 ImageNet 时刻?10 月 26 日,智元开源 AGIBOT WORLD 2026 第四期「具身推理」数据集,官方称首个真实场景 Physical Agent 数据集——任务重点从「操作难度」转向「决策难度」,覆盖九类逻辑推理场景。这是这个数据集家族的又一次扩容,也把一个问题重新推到台前:具身智能的 ImageNet 时刻,到底缺什么? 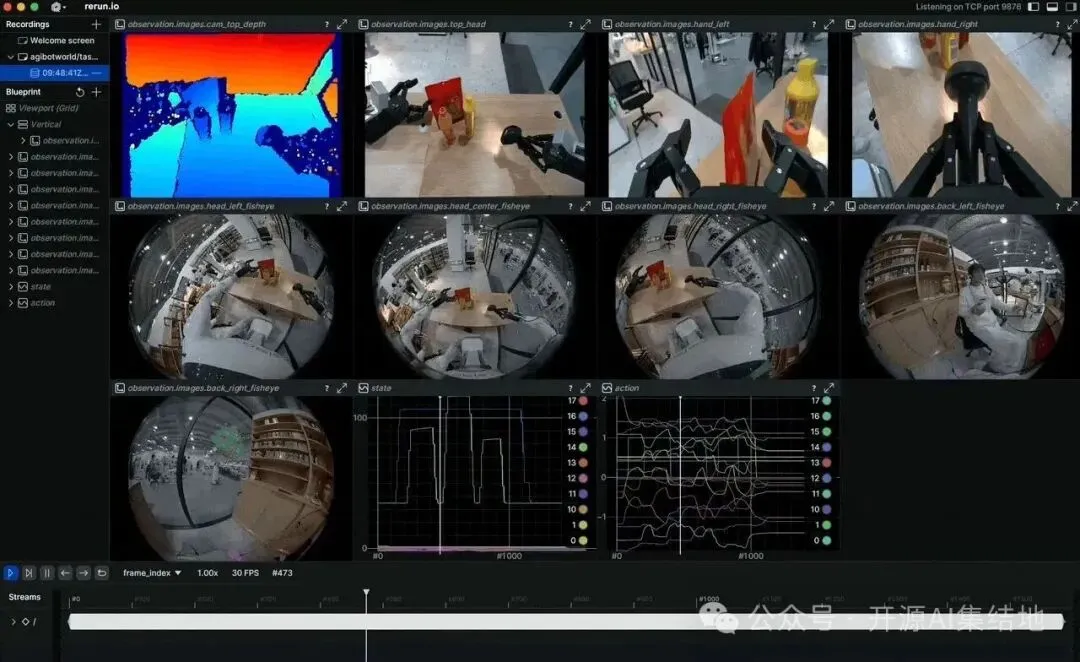
把仓库里的账本摊开。AgiBot World Beta 是完整版:1,003,672 条轨迹、约 43.8TB;Alpha 是精选子集:92,214 条、约 8.5TB。数据来自 100 台机器人,覆盖 100 多个 1:1 复刻的真实场景,横跨五个目标域。硬件配置写得很具体:视觉触觉传感器、6 自由度灵巧手、移动双臂机器人——不是仿真合成的数据,是真机跑出来的。 配套的基座模型 GO-1 已经开源,包括带 Latent Planner 的完整版和去掉规划器的轻量版 GO-1 Air。这套组合的定位很明确:数据集加基座模型加评测(LIBERO、RoboTwin、AgileX 三个平台),给社区一个可以直接上手训练的完整栈。论文发表在 IROS 2025 并入围最佳论文提名,同期工作还被 IEEE TRO 2026 接收。 读仓库源码,比数字更有信息量的是数据组织方式。 第一,格式押注 LeRobot。数据集发布为 LeRobot v2.1 格式(commit 锁 2b71789),这是 HuggingFace 牵头的机器人数据标准。转换脚本 any4lerobot 支持把 LIBERO 的 RLDS 格式转过来——格式统一这件事,正是当年 ImageNet 走过的路:数据格式不统一,跨实验室复用就是空谈。而且 LeRobot 格式自带可视化支持,相机流、状态、动作对齐在同一时间轴上回放,排查数据质量问题(比如标定漂移、动作跳变)效率完全不同于对着裸文件猜。 第二,可视化工具链完整。仓库适配了 LeRobot 的可视化脚本,一条命令(visualize_dataset.py --task-id 390)打开 rerun.io,相机流、机器人状态、动作序列全部可视化。README 里那张可视化截图值得细看:多路相机画面、关节状态曲线、末端执行器动作在同一个界面滚动——这是大规模数据生产的工程基础,标数据、查数据、debug 策略都用同一套工具。 第三,微调显存门槛被打下来了。README 的表格写得很实在:推理约 7GB(RTX 4090 可跑);全量微调约 70GB(A100 80GB/H100);只微调 Action Expert 约 24GB(RTX 4090 可跑)。还配了单卡 4090 的调试脚本(train_dev.sh,DEBUG_MODE 加速初始化)。把微调门槛压到消费级显卡,明显是想让学术界真正用起来,而不是只供起来——这个定价策略和 Meta 当年开源 LLaMA 的逻辑一脉相承:生态价值大于单点商业价值。 这次第四期的转向值得单独说。前几期的任务围绕「操作」——抓取、折叠、搬运,考验的是手眼协调;第四期把重点移到「决策」——九类逻辑推理场景,同时提供高层问答和低层动作轨迹两层标注。 这个转向和整个领域的进展对得上:基础操作能力被 VLA 模型快速拉平后,瓶颈移到了「知道该做什么」——机器人面对没见过的场景,怎么判断先拿哪个、后放哪个、什么顺序才对。数据集把问答和动作轨迹放在同一条数据里,等于给「会想」和「会做」建立了配对监督。 GO-1 的 Latent Planner 设计也是这个思路的模型侧体现:完整版带规划器(负责想),Air 版去掉(只负责做),两版对比可以直接度量规划那部分的价值。 环境:Python 3.10、CUDA 12.4,pip install -e . 一把装完;Flash Attention 走 kernels 库的预编译二进制,不用本地编译,装不上会自动回退源码编译(flash-attn 2.4.2,内存不够时用 MAX_JOBS=4 限并行)。数据两个入口:OpenDataLab(国内快)或 HuggingFace(huggingface-cli download --resume-download)。数据格式转换有现成脚本 any4lerobot 支持。 想快速验证,跑 LIBERO 微调示例是最短路径:转换脚本(LIBERO 的 RLDS 转 LeRobot,建议独立 conda 环境避包冲突)、配置文件(go1_sft_libero.py,四个配置段:数据路径、模型设置、训练超参、状态动作空间)、训练 shell 全给了,4090 就能跑 Action Expert 微调。一个容易看错的细节:action chunk size 和控制频率要跟着数据集走——GO-1 预训练用 30Hz(AgiBot World 采集频率),LIBERO 微调要改成 10Hz,配置里不动这个数字,动作序列的时间对齐就错了。 推理部署同样分两路:本地 GO1Infer 类加载 checkpoint 直接出动作;远端模式起一个策略服务器(真机端不需要 GPU,把观测发过来收动作即可),这个设计对真实机器人部署很友好——算力留在机房,机器人端只跑轻客户端。官方还给了 Genie Studio 一站式平台和 Agilex、RoboTwin 三个评测入口。 我没有实际下载数据集和跑微调,以上流程均来自仓库 README 的书面核对。两个边界要说明:一是许可为 CC BY-NC-SA 4.0,商用受限,企业用要单独谈授权;二是 43.8TB 的 Beta 全量对多数实验室不现实,从 Alpha 的 8.5TB 起步更实际。 这个仓库的价值不只是一份数据,是「数据+模型+工具链+评测」四件套的整体开放。具身智能要复现 CV 那波 ImageNet 时刻,缺的从来不是单点突破,是能让一百个实验室站在同一起跑线上的公共资产——AgiBot World 是目前往这个方向走得最远的尝试之一。 保留意见:真机数据的采集成本决定了它的扩充速度远跟不上互联网图文,43.8TB 听起来大,对比 LLM 训练语料的 PB 级仍是零头;九类推理场景的多样性也有待第四期放出后的社区检验。但方向是对的——机器人学习正从「每人自采一小撮数据」转向「共享大池子」,这一步迈出去,后面的复利才开始。