ARTICLE · 1260641
1.3B,三榜第一——国产开源模型把 PDF 拆成了 Agent 能直接吃的格式
1.3B 参数,三个世界级榜单,全部第一。(文末附相关链接)
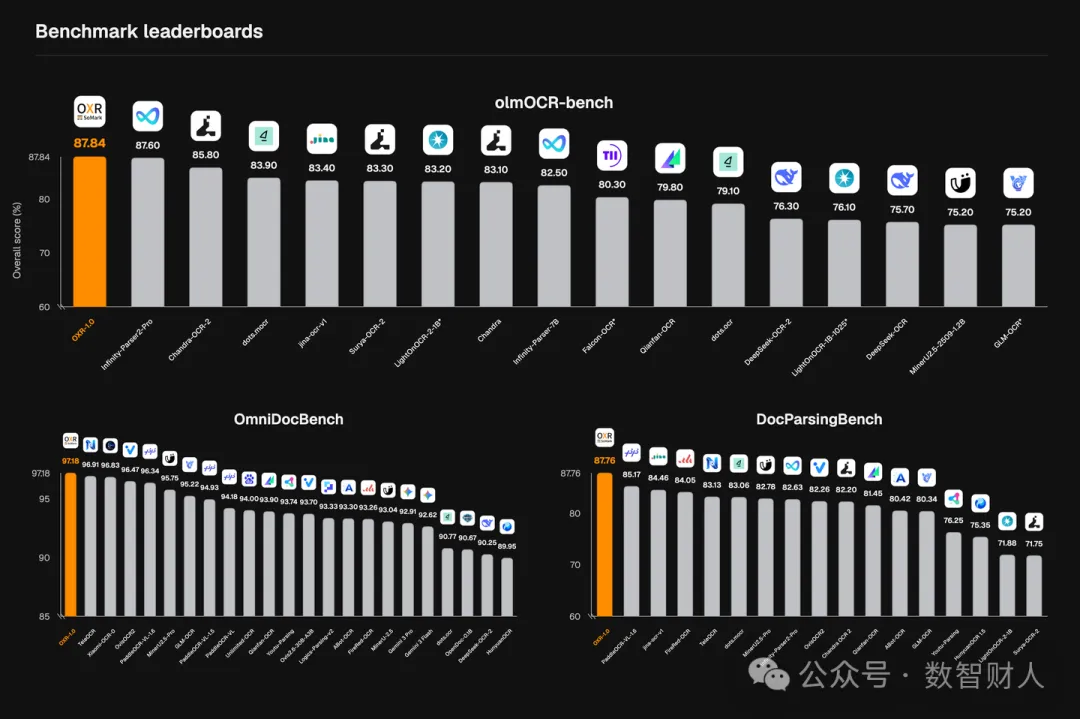
OmniDocBench 97.18,olmOCR-Bench 87.84,DocParsingBench 87.76。
单张 RTX PRO 6000,100 页文档端到端解析,101.0 秒,开源里最快。
模型叫 OXR,Optical Everything Recognition,出自 SoMark 团队。代码、权重、整套评测复现流程全量开源,GitHub 上 1.1K+ star,先在海外开发者社区热起来的。
先看它能干什么。
以前的工具基本只指望把图变成字,剩下的靠模型自己猜。猜错的表格塞进 RAG,下游怎么调都救不回来。
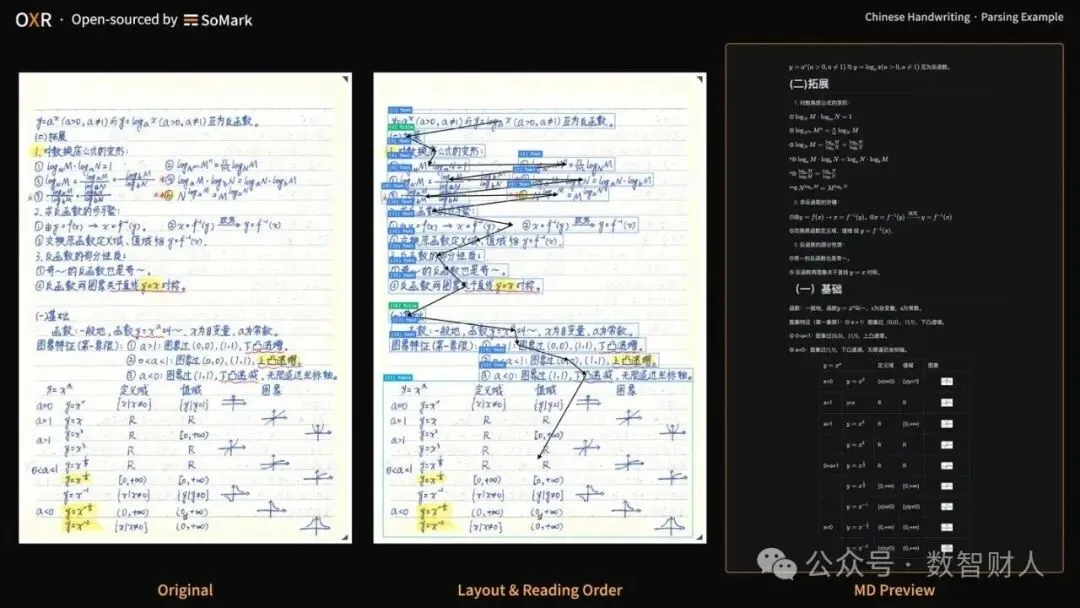
一、它到底在干什么
13 类文档元素,全检测,全识别。表格、公式、代码块、图片、化学方程式、化学结构、脚注、页眉、页脚、印章。
输出不是一堆散字,是带坐标的结构化 Markdown 或 JSON,直接能被 Agent 调用。
这件事为什么难。
传统 OCR 面对一份平平无奇的 PDF,经常是灾难现场。双栏论文串行,手写公式识别成乱码,跨页大表格结构崩解,化学结构式被当成杂乱线条丢掉。这种输入喂进大模型,再聪明也只能吐幻觉。
文档解析一直是个听着没技术含量、实际至今没被完全攻克的活。
二、1.3B 凭什么打过百亿模型
答案在后训练,方法是 RSI,递归自我改进。
先看数据这件事有多贵。文档解析的标注是个无底洞,排版千奇百怪,公式、代码、图表错综复杂,人工标注成本高,错误率本身也高,真实世界的长尾坏样本根本穷尽不了。工程师挑出坏样本、人工修正、重新训练、发个新版本,遇到新的奇葩排版又挂了。
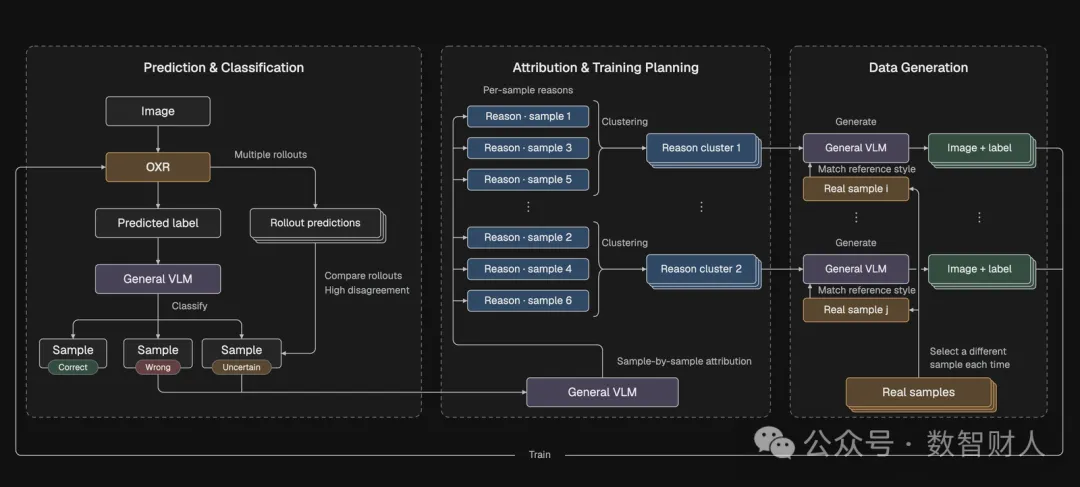
图3 · RSI 三阶段示意
数据准备的速度,卡死了模型进化的脖子。
OXR 团队抓住了一个被忽视的特性,每一份文档输入,都有客观确定的标准答案。文字对不对、表格跨行跨列有没有错、公式符号漏没漏,都能被精确测量。
既然对错可以客观判断,就不必等人类来补标注。
于是后训练阶段引入了一个三步循环。
第一步,预测与分类。OXR 先解析海量无标签真实文档,再让通用多模态模型结合原始图像、解析结果和评判标准,把样本切成三类。Correct 直接通过,Wrong 明确判错送去深度剖析,Uncertain 预测不稳或处在分布边缘,同样送去分析。
保留 Uncertain 这一档,是整个方法里最反直觉的设计。只给正确和错误两个非黑即白的选项,评判模型的犹豫就会被强行包装成一个确定标签,噪声就这么喂进下一轮训练。
OXR 还会对自己做多次 rollout 采样。同一份文档跑几次结果大相径庭,说明模型自己没底,哪怕碰巧蒙对一次,也扔进 Uncertain。
接着在语义完全不变的前提下做轻微图像扰动,小幅缩放、压缩、模糊、平移。扰动之后分歧进一步扩大,说明模型对无害的视觉变化过度敏感,这个动作被记成一条病因,直接指导下一轮补强。
第二步,归因与训练规划。错样本筛出来不能乱喂,得先搞清楚它死在哪儿。通用多模态模型像老医生一样逐个诊断,是跨列单元格对齐失败,还是手写连笔识别错误。
诊断出的自然语言原因,经 SigLIP2 提特征,再由聚类模型形成原因簇。
跨域聚类是这里最有意思的部分。一张财务报表和一张化学实验记录表,外观和文字八竿子打不着,如果归因都指向某种罕见的跨行跨列结构,它们会被提炼成同一个数据构造方向。
第三步,数据生成。原因簇提供结构难点,真实样本池提供版式与视觉风格的参照。每生成一批新数据,从真实样本里抓排版风格当锚点,把要攻克的结构难点自然嵌进去;扰动测试暴露的视觉脆弱点,也被系统性编进合成管线,逼模型反复脱敏。
校验合格的数据回流,训练下一代 OXR。
一轮跑完,短板补上;新一轮真实文档再跑,又暴露新的短板。数据分布一轮轮变扎实,模型的智能密度就上来了。数据质量足够高的时候,模型不需要靠臃肿的参数量去死记硬背。
三、速度第一,是另一回事
准确率第一能理解,速度也是第一就有点意外。
100 页 101 秒,单卡。参数小只是表象,文档解析的速度瓶颈根本不在模型大小。
回顾这条技术线走过的路。
最早是 Pipeline,检测、识别、排序各挂一个独立专有模型,拼起来极其臃肿,维护成本高。后来 VLM 火了,所有任务本质都是图像到序列的映射,端到端大模型一锅端,方案优雅,但自回归生成长序列太吃算力,慢。再后来 PaddleOCR-VL 走了一步好棋,把版面分析和阅读顺序合并成一个小模型,后面接识别模型,两个模型两个阶段,把版面检测拉回毫秒级,成了这两年的行业标准解法。
标准解法也有隐性成本。每增加一条版面标注,就必须强行绑一条阅读顺序标注,数据处理难度直接翻倍。
OXR 换了个任务级拆法。独立的轻量模型只管版面分析,主模型同时负责内容识别和阅读顺序判断。
两个变化。
阅读顺序的损耗被抹平了。判断顺序的耗时本来就远小于文本识别,并进主模型之后没多花时间,反而因为主模型本身有语义理解能力,顺序判断的准确率大幅提升;前面的版面模型卸下排序包袱,任务变纯粹,可以直接换成更轻的高效检测模型,整体吞吐量起飞。
图4 · 架构对比
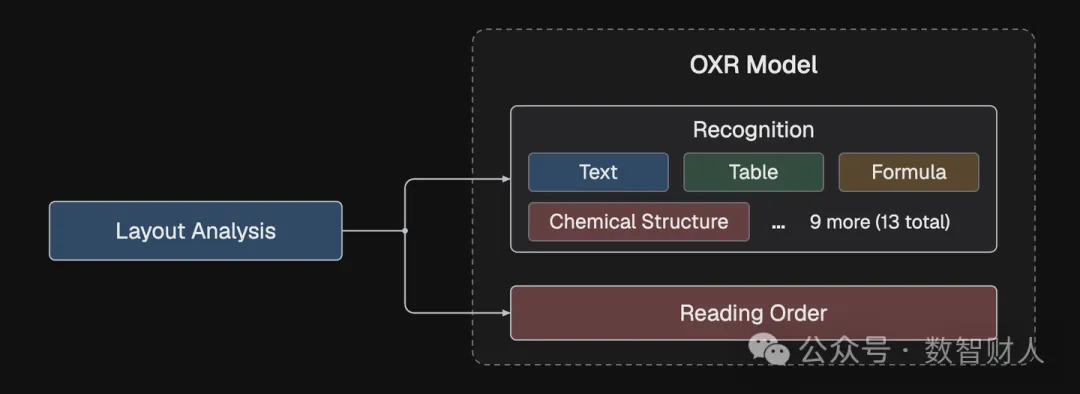
版面分析彻底独立,可插拔。版面需求是个长尾问题,同一个图文混排区域,内容团队想整张提,知识库团队想把文字抠出来当正文;四格漫画,业务 A 要整体裁切,业务 B 要切成四张小图。这种需求没法统一定义。
现在这个模块可以整个换掉。处理古籍、医疗单据这类特殊版面,用自己训的私有版面模型替换,后端继续用 OXR 的识别能力。
四、白嫖通道
免费 API,免注册,免申请 Key,国内镜像 free-oxr.somark.cn/api/v1。
官方说法是,在服务器负载还能承受的区间内会一直维护开源免费服务,但不建议拿去跑生产环境,请求会排队。
本地部署也顺。主流推理框架全面适配,不用自己吭哧吭哧编译 vLLM,官方 Docker 或 CLI 挂载插件一键拉起服务。官网给的部署门槛是 1 张 RTX 3090,1.3B 的模型,消费级卡就能跑。
代码、权重、评测复现流程都在 GitHub,权重在 Hugging Face 和 ModelScope 同步发布。
这里要做个区分。开源的是 OXR,13 类元素。团队还有一套商业级引擎叫 SoMark,21 类元素,支持 Word、PPT、Excel 等更多格式,官网口径是 100 页最快 5 秒,走 API、CLI、MCP 插件和私有化部署几条路。
开源模型和商业引擎不是一回事,别混淆。
One More Thing
为什么今天还要花这么大力气去死磕文档解析?
Agent 正在接管各行各业的工作流,但人类过去几十年沉淀下来的专业私域知识,绝大多数还躺在格式混乱、排版复杂的 PDF、扫描件和报表里。大模型再聪明,喂进去的是一堆顺序错乱、表格破碎的字符垃圾,吐出来的只能是幻觉。
过去很多人把 OCR 当成技术含量不高的搬砖活。
从 OCR 到 OXR,它承担的使命已经变了。它是人机交互的桥,把人类世界的多模态文档完整无损地重构成 Agent 直接可用的结构化资产。
说得再直白一点。模型智能的天花板已经抬得很高了,真正卡住落地的,是输入侧那些没人愿意脏手的活。
过去三十年,OCR 的活是把纸变成字。
从今天起,它的活是把人类的知识底座,翻译成机器能读的语言。
底座铺好,上面的东西才立得住。
相关链接附上
GitHub:https://github.com/SoMarkAI/OXR
ModelScope:https://modelscope.cn/models/SoMark/OXR-1.0
在线 Demo:https://free-oxr.somark.cn/
免费 API(免 Key):https://free-oxr.somark.cn/api/v1
官网:https://somark.cn/ (主站 https://somark.ai)
以上,既然看到这里了,如果觉得不错,随手点个赞、在看、转发三连吧,如果想第一时间收到推送,也可以给我个星标⭐~
谢谢你看我的文章,我们,下次再见。