ARTICLE · 1261065
跨越屋顶线:2026 AI 芯片微架构的演进逻辑
【内容目录】
1.第一道屋顶线:为什么峰值算力翻倍,推理利用率却不到 30%?
2.算法向硬件对齐:从 DeepSeek 到智谱 GLM-5,大模型如何匹配中国芯片?
3.第二道屋顶线:当矩阵核快过向量核,海内外芯片架构如何破局?
全文摘要
2026 年 10 月,一组针对八款主流 AI 加速卡的实测显示:华为昇腾 950PR 的中位数算力利用率达到 86.0%,排名第一。它的绝对算力并不领先,但对自身硬件用得最充分。
这背后是 AI 芯片竞争逻辑的变化:除了比峰值算力,更要比谁能把算力真正用上。本文从“屋顶线”这一概念出发,解释大模型推理为什么会让算力闲置,中国大模型如何反过来按中国芯片的特性设计架构,以及当芯片内部出现新的瓶颈时,英伟达和国内厂商分别选择了怎样的路线。
一、 第一道屋顶线:为什么峰值算力翻倍,推理利用率却不到 30%?
芯片发布会通常强调峰值算力,但算力能不能用上,还取决于显存带宽,也就是数据从显存送到计算单元的速度。
把峰值算力除以显存带宽,得到的数值叫屋顶线拐点。它的含义是:每从显存读取 1 字节数据,计算单元需要完成多少次运算才不会闲置。比如一颗算力 500 TFLOPS、带宽 4 TB/s 的芯片,拐点就是 125。
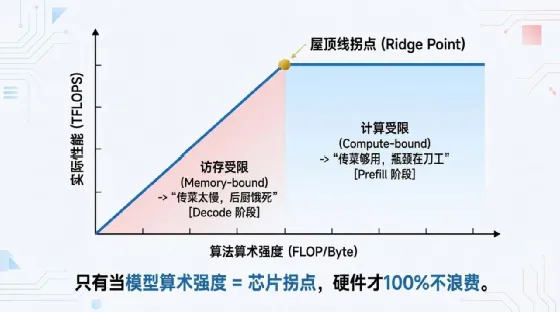
图 1 屋顶线模型:访存受限与计算受限区域
大模型推理分为两个阶段,恰好落在拐点两侧。
预填充阶段,模型一次性读入整段提示词,同一份权重可以反复参与计算,每字节数据对应的运算次数远超拐点。这时瓶颈在算力,芯片越强越快。
解码阶段,模型每次只生成一个词,却要把全部权重和历史缓存重新读一遍,每字节数据只能完成几次到十几次运算。这时瓶颈在带宽,大部分计算单元都在等数据。我们使用大模型时看到文字一个个往外输出,主要耗时就在这个阶段。
所以,峰值算力翻倍并不等于推理速度翻倍。只有当模型的计算密度与芯片的拐点对齐,算力和带宽才能同时用满。
实测:谁把硬件用得最充分
过去普遍认为,中国芯片不仅算力落后,软件栈也拖后腿,实际利用率偏低。SemiAnalysis 今年 10 月的实测给出了不同的结果。
测试覆盖八款加速卡、1,055 种开源大模型中常见的矩阵运算。按利用率排序,昇腾 950PR 中位数为 86.0%,排名第一;英伟达 H100 为 75.5%,B200 为 65.4%,AMD MI355X 为 51.9%。
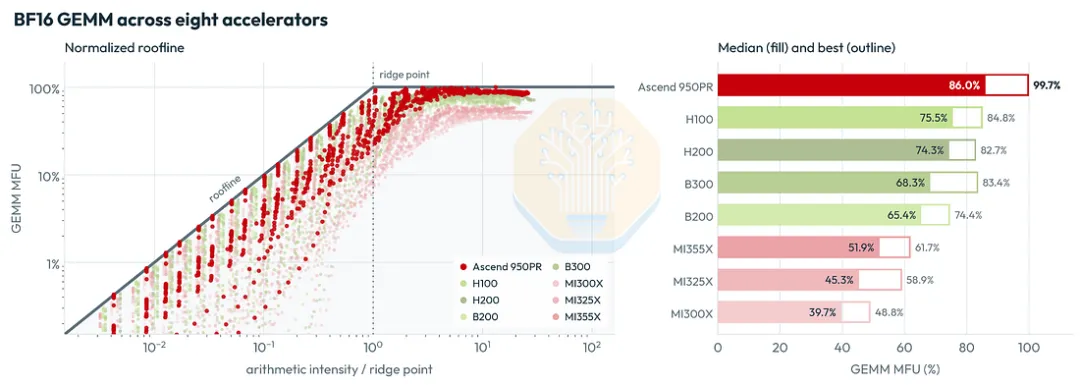
图 2 八款主流 AI 加速卡在 1,055 种矩阵形状下的归一化屋顶线实测(图源:SemiAnalysis)
需要说明的是,这是利用率排名,不是性能排名。按绝对算力,昇腾 950PR 位于英伟达 A100 与 AMD MI300X 之间,与 H100、B300 仍有差距。它的利用率高,一方面是因为英伟达和 AMD 的旗舰卡满载时容易触及功耗上限而降频,另一方面得益于昇腾矩阵核的多级片上缓冲设计,让读数据、计算和写结果可以同时进行。
制程决定了屋顶有多高,架构和软件决定了能不能够到屋顶。
二、 算法向硬件对齐:从 DeepSeek 到智谱 GLM-5,大模型如何匹配中国芯片?
解码阶段计算密度过低,是所有大模型的共同问题。DeepSeek 提出的 MLA(多头潜在注意力)架构通过压缩历史缓存,把解码时的计算密度提高了十倍以上。
经过推导,MLA 的计算密度主要由一个参数决定:注意力查询头的数量。头数越多,计算密度越高。这意味着,从一个模型的头数,可以大致看出它是为什么样的芯片设计的。
DeepSeek 的 128 头
DeepSeek-V3 和 R1 每层使用 128 个查询头,解码计算密度为 241.8。它当时主要使用的英伟达 H800,拐点为 258.2,两者几乎对齐。
中国芯片的拐点在另一个区间
受先进制程限制,新一代中国芯片普遍选择“算力适度、显存做大”的路线。计算 2026 年国内主力芯片的拐点:天数智芯天垓 122.5、华为昇腾 950DT 125.0、摩尔线程 S4000 130.2、沐曦曦云 C600 138.9、海光深算三号 140.0、百度昆仑芯 P800 143.8、壁仞 BR20X 150.0。
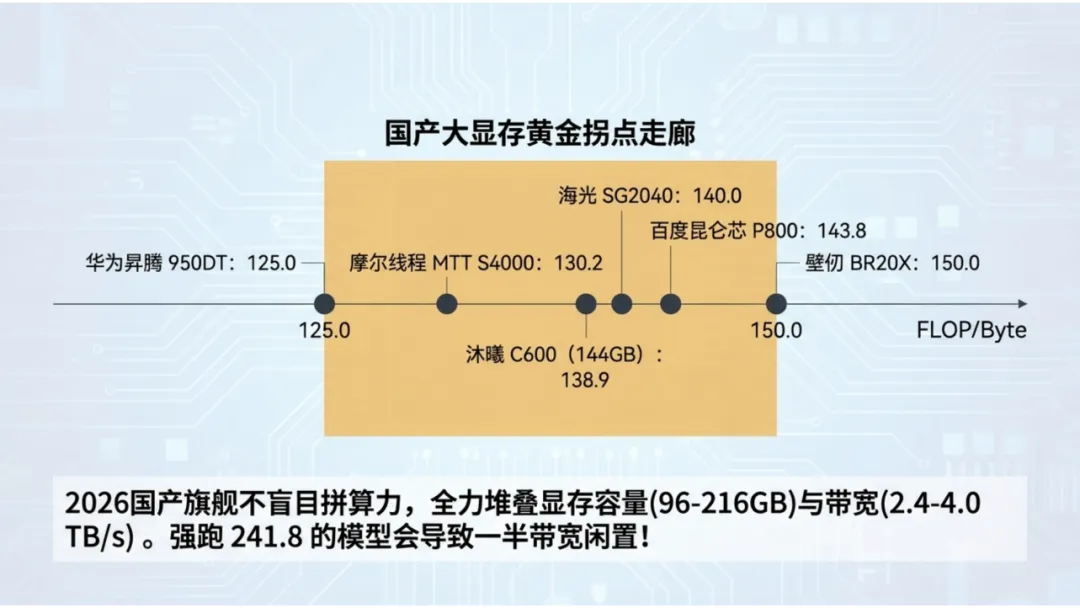
图 3 2026 年中国主力 AI 芯片的屋顶线拐点分布
这些数值集中在 122–150 之间,比 H800 低了将近一半。如果把计算密度 241.8 的模型直接放上去,算力会先到顶,近一半带宽处于闲置状态。
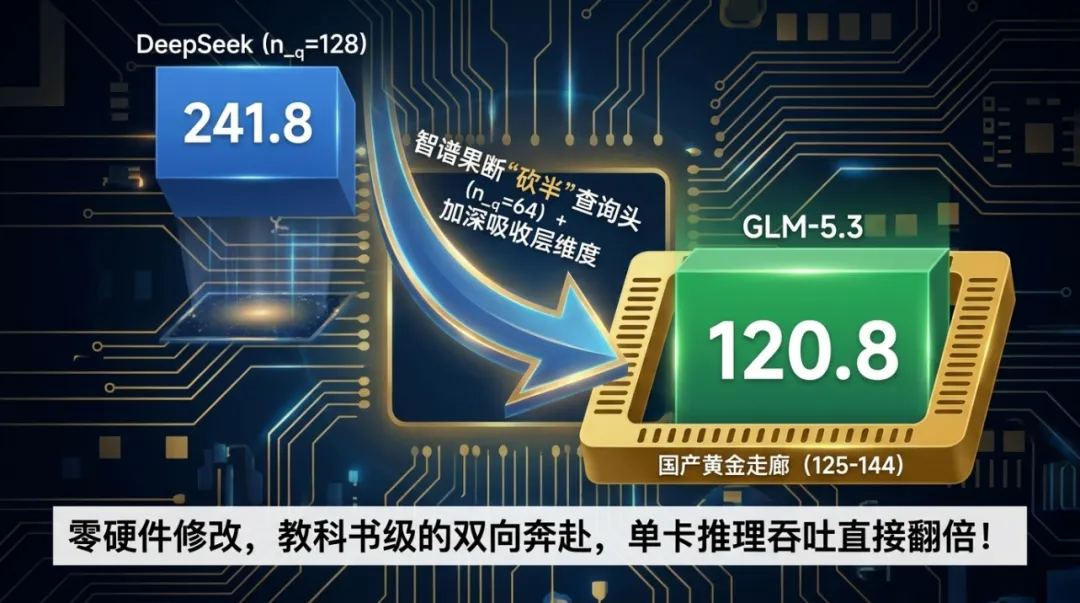
图 4 智谱 GLM-5.3 查询头数降至 64,计算密度降至 120.8
智谱 GLM-5 的 64 头
智谱在 GLM-5 和 GLM-5.3 中把查询头数从 128 减到 64,同时加深其他维度以保证精度。计算密度随之降到 120.8,正好落入中国芯片的拐点区间。硬件不变,单卡推理吞吐提升约一倍。
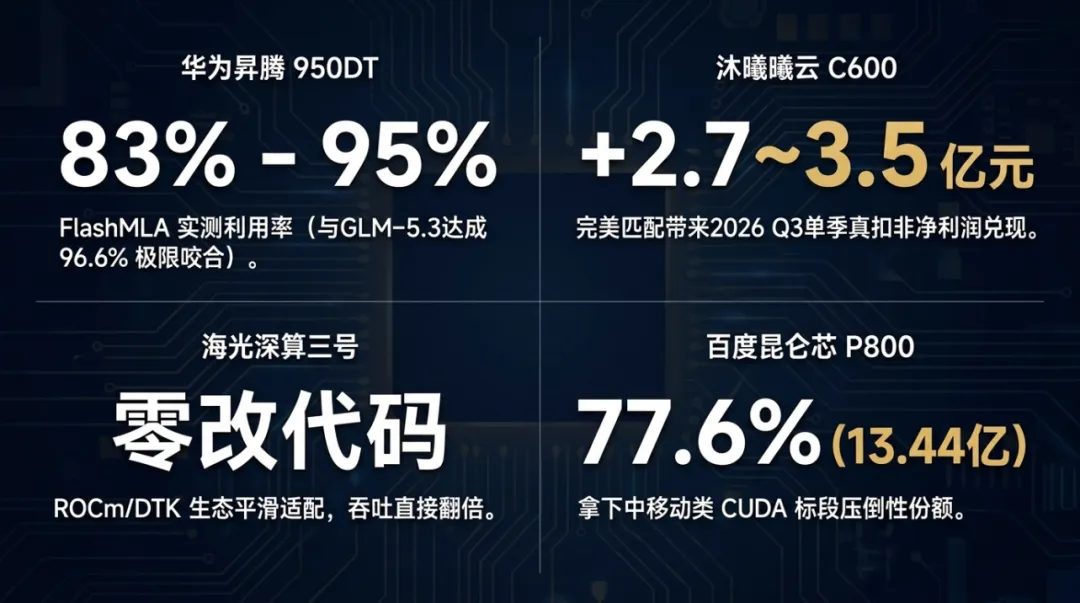
图 5 中国 AI 芯片的模型适配与商业落地成效
过去是芯片厂商去适配模型,现在中国大模型开始按中国芯片的特性来设计架构。
这种双向适配正在带动市场变化。2026 年国内本土 AI 芯片供应量预计翻倍至约 350 万颗,上半年非 GPU 加速器出货量首次超过 GPU。华为在国内加速卡市场的份额接近三成,华为、阿里平头哥与寒武纪三家合计占据非 GPU 市场 95% 的份额;海光、沐曦、燧原、昆仑芯、壁仞、摩尔线程、天数智芯等厂商也已在运营商和互联网集群中批量交付。
三、 第二道屋顶线:当矩阵核快过向量核,海内外芯片架构如何破局?
显存带宽之外,芯片内部又出现了第二道瓶颈。
随着 FP8、FP4 等低精度格式普及,芯片中负责矩阵乘法的单元速度翻了几倍;但负责指数运算、数据格式转换的向量单元,以及片上缓存,并没有同步变快。结果是矩阵单元算完后,要等向量单元处理完才能继续。
英伟达:芯片内扩容,芯片外加设备
在 Blackwell 上,矩阵单元与指数运算单元的吞吐差距拉大到 1024 倍,运行 DeepSeek-V3 时,FP8 实际利用率只有 20%–37%。
英伟达的应对分为两步。芯片内,下一代 Rubin 将指数运算单元的吞吐提升至 4 倍;芯片外,斥资 200 亿美元收购 Groq,用纯片上 SRAM 芯片组成的机柜专门负责解码,Rubin 负责预填充。
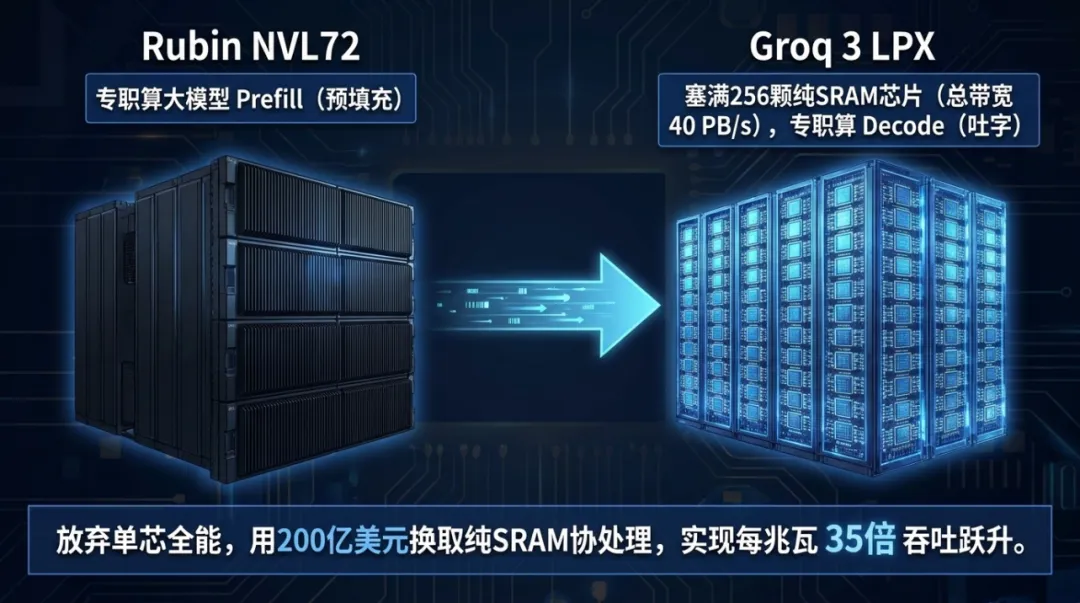
图 6 英伟达的系统级方案:Rubin 扩充指数运算单元 + 收购 Groq 构建异构机柜
昇腾 950 × DeepSeek:在芯片内部解决
华为和 DeepSeek 选择了另一条路:硬件和代码一起改,在单颗芯片内部消化瓶颈。SemiAnalysis 的拆解中有三个具体例子。
一是打通片上通路。 注意力计算需要对中间结果反复缩放,昇腾的矩阵单元无法完成这一步,上一代芯片只能把数据送回显存处理。昇腾 950 将相关片上缓存扩至 256KB,并打通了矩阵单元到向量单元的直连通道;DeepSeek 相应修改 FlashMLA,把这部分计算放在向量单元内完成,数据不再离开芯片。
二是为硬件改数据结构。 早期 FlashMLA 把缓存数值和缩放系数分开存放,昇腾每读取一个词的缓存要搬运两次。DeepSeek 把两者合并为一条连续记录,搬运次数减半。这是软件反过来迁就硬件的直接证据。
三是编译器自动排流水线。 DeepSeek 把昇腾后端合并进自家编译器 TileLang 的主干,让下一块数据的读取与当前块的计算自动重叠。实测单个算子耗时从 17.42 微秒降至 10.52 微秒,提速 40%。
在 32 颗昇腾 950DT 上运行 DeepSeek-V4.1-Flash 时,结合投机解码,每生成一个词的平均延迟为 4.33 毫秒。
其他中国厂商也在做类似尝试:昆仑芯 P800 用硬件无损压缩等效放大带宽,沐曦 C600 内置硬件转置引擎以减少数据搬运,天数智芯天垓 300 通过多核共享缓存,把长文本注意力效率提升到 90% 以上。
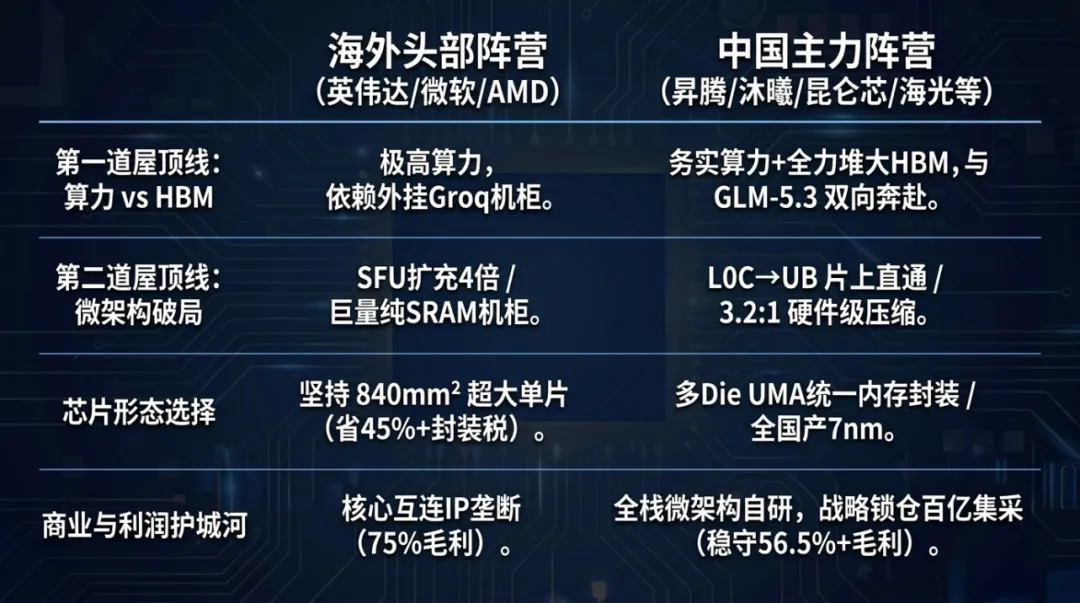
图 7 2026 海内外跨越屋顶线路线对比
结语
2026 年 AI 芯片竞争的重点,正在从峰值算力转向有效算力。
面对同一个问题——解码阶段数据供应不上——英伟达的办法是增加计算单元、增加设备;国内在制程受限的条件下,选择让模型和芯片相互适配:智谱调整头数以贴合中国芯片的拐点,DeepSeek 为昇腾改写底层代码。
中国芯片的绝对算力仍有差距,这一点没有改变。但软硬协同正在让有限的算力得到更充分的使用,这是今年最值得关注的变化。