ARTICLE · 1274171
AI为什么会一本正经地说错话?
AI 的错误,有时很难一眼看出来。
它可能把人名写错,把研究结论说反,甚至给出一篇并不存在的论文。回答却依然段落整齐、解释完整,还能自然地接上一句“因此可见”。
为什么内容错了,语气却没有跟着犹豫?
关键在于:生成一段像样的回答,并不自动意味着其中的事实已经逐项核实。
这类把无依据的内容当成事实说出,或生成与资料相矛盾内容的现象,常被称为“AI 幻觉”。这里主要讨论聊天型大语言模型,并不是把所有 AI 错误都归为同一种问题。
01|答案是怎样生成的?
大语言模型在训练中,从大量数据里学习语言、知识和它们之间的关联。回答问题时,它会结合当前的问题、前文和可用资料,计算接下来可能出现的文字片段,再逐步组成回答。
这让它能够解释概念、整理材料,也能在许多任务中进行推理。如果系统接入搜索或计算工具,它还可以借助这些工具补充信息。
不过,这个过程并没有天然附带一项保证:每生成一个人名、一个年份、一条结论,都已经找到了对应证据。
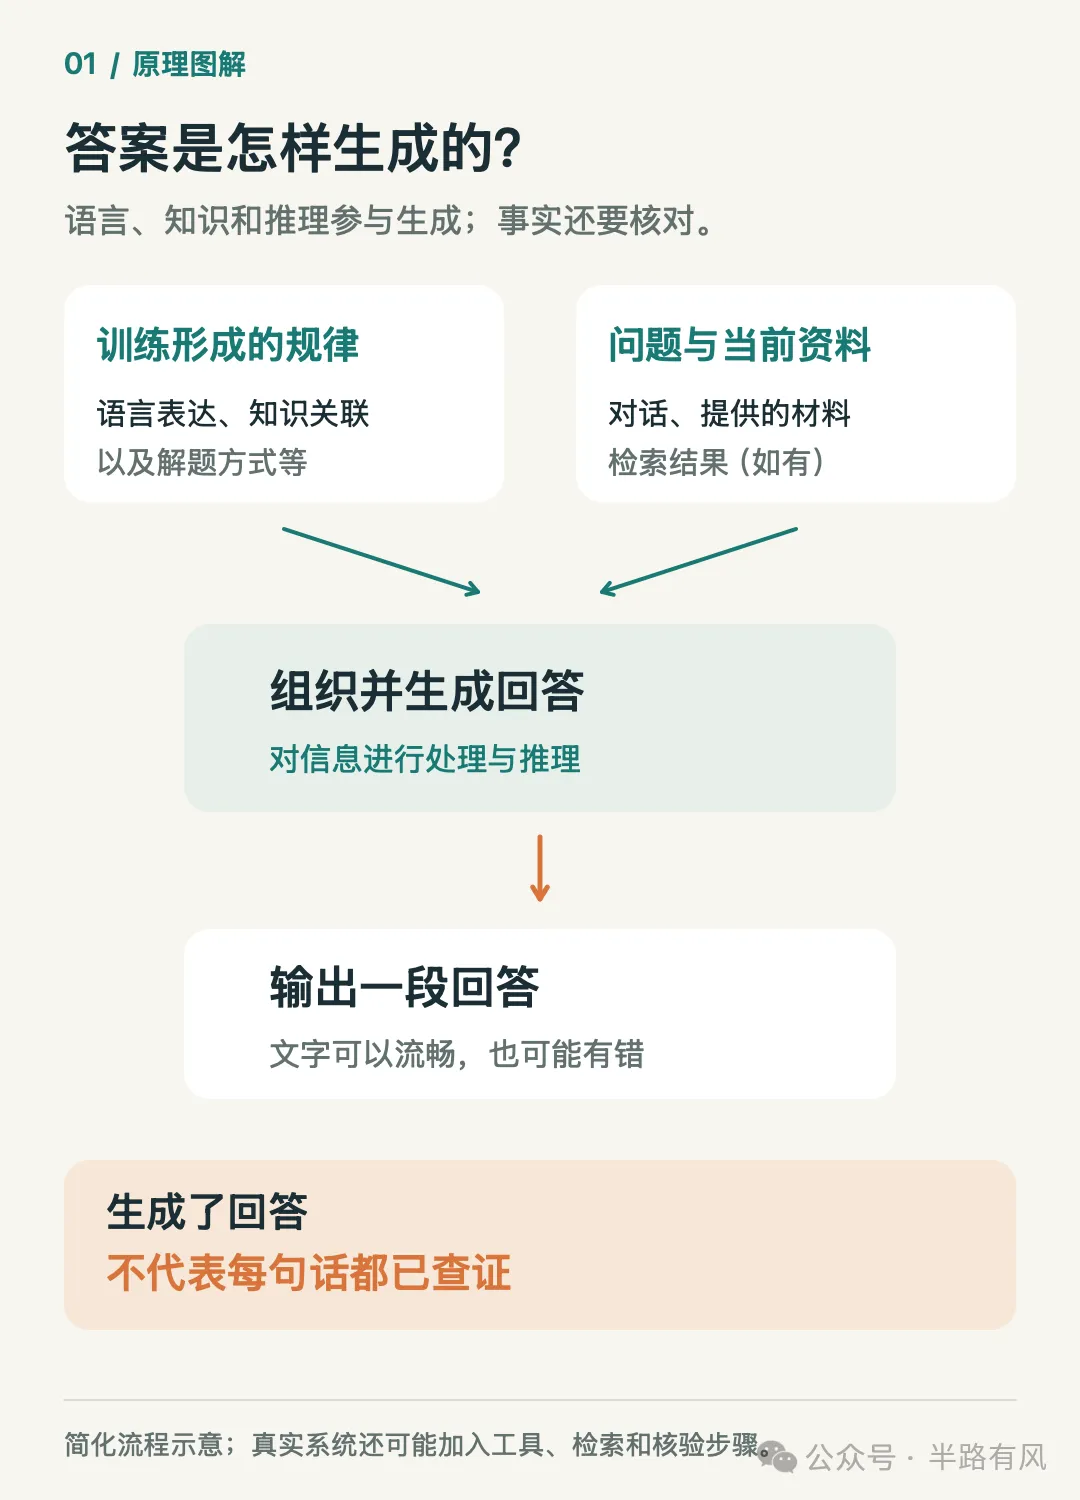
图 1|回答生成的简化示意。不同系统使用资料和工具的方式不同,图中没有展开模型内部计算。
例如,模型可能熟悉论文标题的写法,知道作者、年份、期刊通常怎样组合。信息不足时,这些表达规律仍可能组成一条很像真的、实际却查不到的文献信息。
“这句话很像合理答案”,和“这句话有事实依据”,是两回事。
02|证据不足时,为什么还可能继续回答?
错误不一定来自同一个地方。
有时是可用信息不足:训练中没有可靠学到某个细节,当前资料里也没有答案。模型可能把相近的人名、事件或常见说法混在一起,补出缺失的部分。
有时,问题本身带着未经证实的前提。比如直接问“这项研究为什么证明了某种说法”,已经先假定研究存在,而且结论支持这句话。模型如果没有先核对,就可能顺着这个前提继续解释。
训练和评价方式也可能影响这种表现。研究者指出,如果答对得分,答错和回答“我不确定”都不得分,猜测就可能比不回答更容易得分。这类评价方式可能鼓励模型在不确定时继续作答。
模型当然也可能拒答、承认不知道,或者主动纠正问题。但这些能力并不能保证每次都恰好在证据不足时发挥作用。
而一旦回答继续生成,表达仍然可以很流畅。“首先、其次、因此”这样的结构,既能组织可靠资料,也能组织建立在错误前提上的解释。
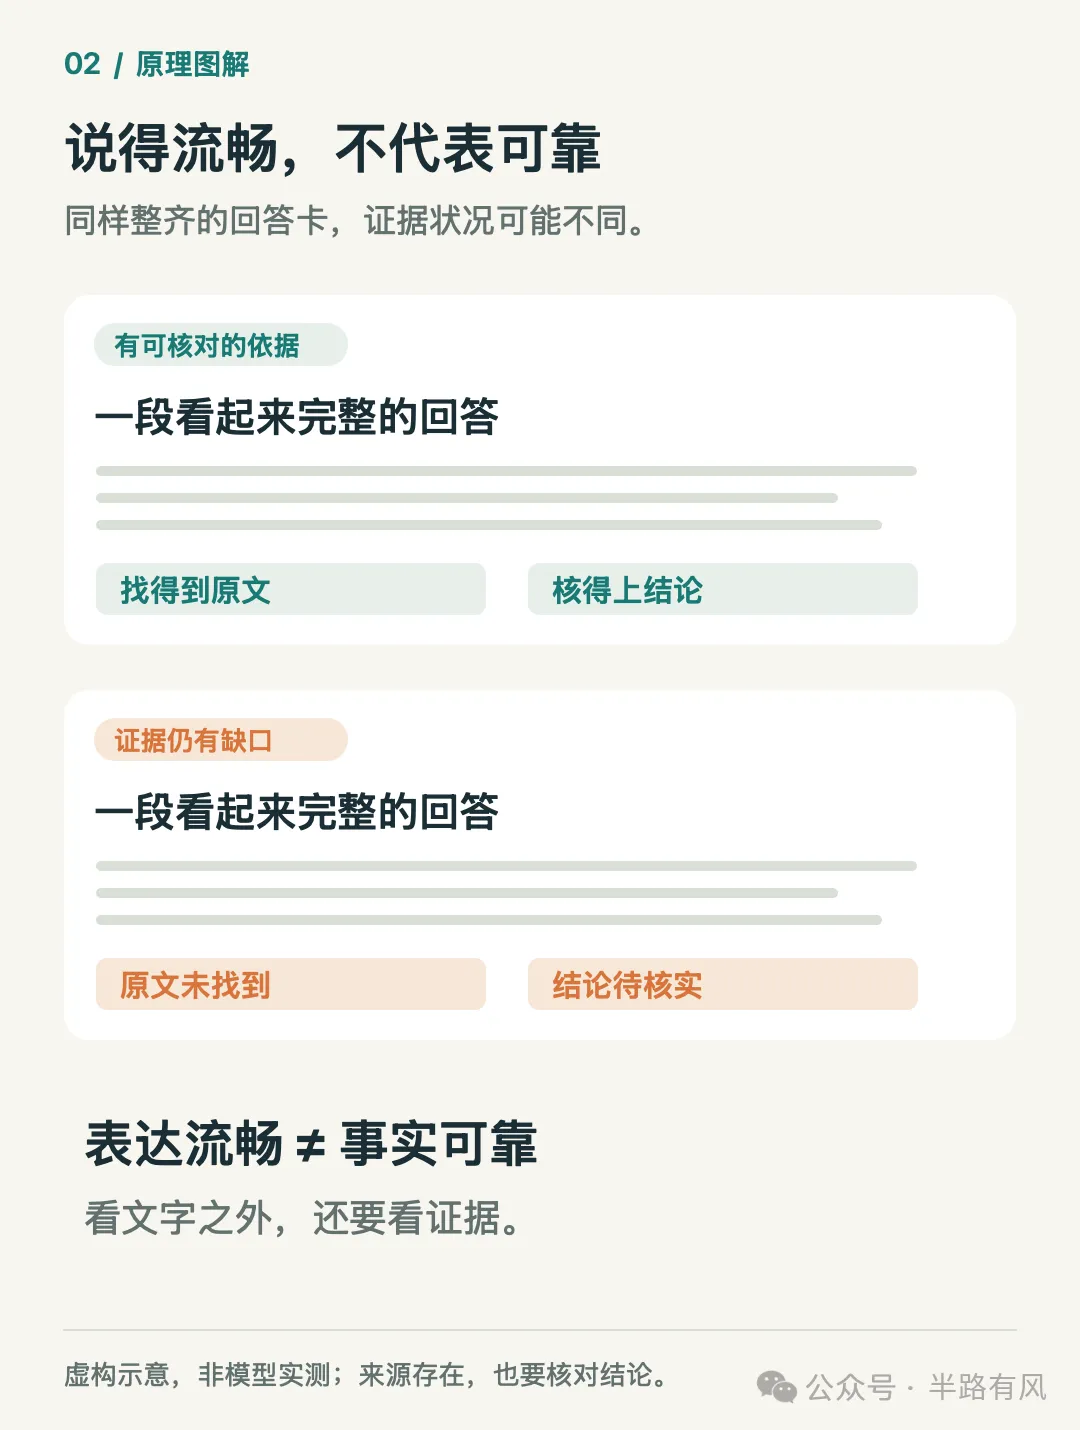
图 2|比较的是表达形式与证据支持,不是真实模型测试。示例为虚构示意;排版整齐、语气肯定,都不能单独证明内容正确。
所以,“一本正经”描述的是我们看到的表达效果。回答中的肯定语气,不能直接当成已经核验的标志。
03|联网以后,就不会说错了吗?
联网能提供新资料,减少一部分信息缺口,但查到资料以后,还要选来源、读内容、理解条件,再组织成答案。
这些环节都可能出错。
网页本身可能不可靠,模型也可能把不同对象的信息混到一起,漏掉原文中的限制条件,或者把“在某种情况下成立”写成“总是如此”。
即使给它的材料准确,生成的回答仍可能加入材料没有支持的细节。
因此,看到回答附了来源,值得继续多做一步:打开它,看看原文是否真的支持旁边那句话。
一篇文章确实存在,不代表 AI 对它的概括正确;原文出现过某个数字,也不代表这个数字适用于当前问题。
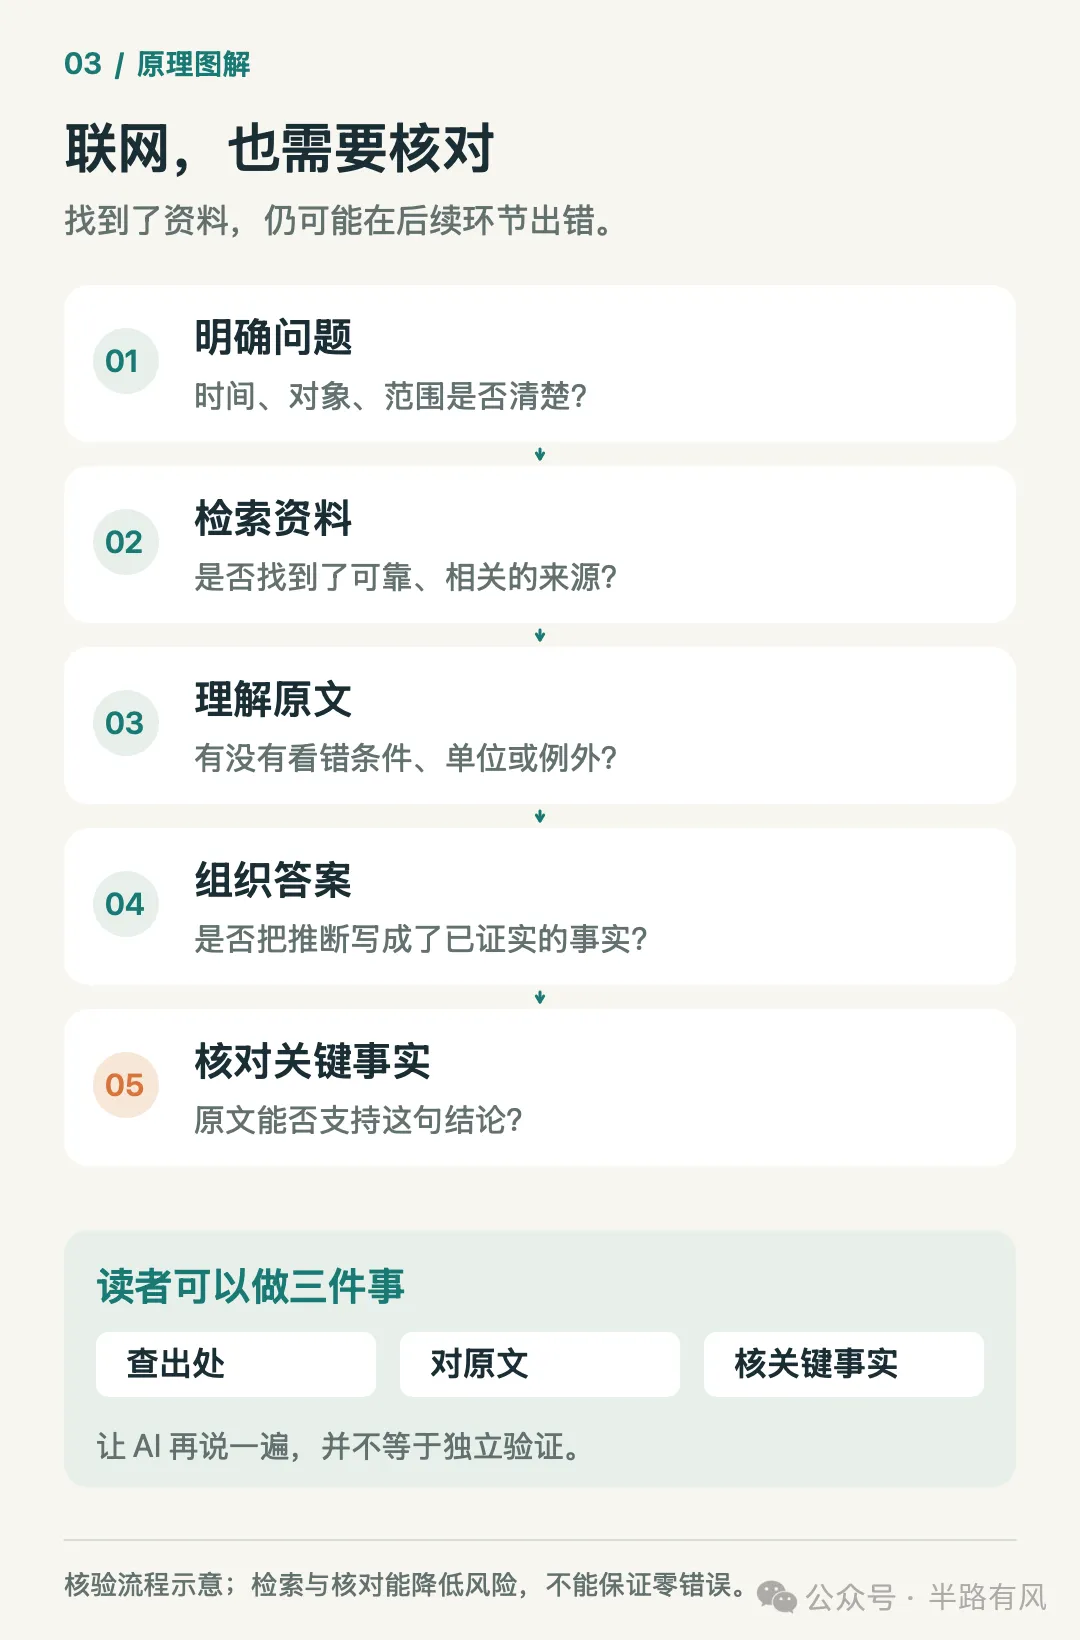
图 3|从找到资料到形成结论,各环节都需要检查。该流程为概念示意,不是某款产品的内部架构图。
04|普通人可以怎样核对?
不必把每段文字都从头重查,可以先抓住支撑结论的关键事实。
**先找出处。**遇到具体的人名、论文、数据和日期,看看有没有能实际打开的原始材料。只有一串看起来正式的文献信息,还不够。
**再对原文。**确认来源说的是同一个对象、同一段时间、同一种条件。尤其留意“可能”“部分”“在某些条件下”有没有在概括时消失。
**最后分清材料与推断。**哪些话是资料直接支持的,哪些是模型根据资料作出的解释,哪些还没有依据?分开以后,就更容易决定哪些内容可以采用,哪些需要继续查。
也可以在提问时明确要求:
请区分资料直接支持的内容和你的推断;关键结论请指出原文依据;资料不足时,请明确说不知道,不要补齐缺失信息。
这能帮助约束回答,但不是一句消除错误的口令。让 AI 再自查一次,也不能代替打开原始材料核对;同一句话重复几遍,并没有增加独立证据。
AI 可以帮助我们整理、比较和解释信息。判断一段回答是否值得采用,依据应当是关键说法能不能被核对,而不是它用了多么肯定的语气。