ARTICLE · 1278305
V4L2 源码深度解析(十四):read/write 背后的缓冲区周转——VB2 fileio 深度解析
前面几篇中,应用自己安排缓冲区:申请存储、提交 QBUF、等待完成、调用 DQBUF,处理结束再交回去。每一轮交接都能在应用代码中找到。
换成 read(fd, data, size),这些操作似乎不见了。程序只提供一段接收空间,系统调用返回时,图像已经出现在这段空间里。采集端写到哪里?谁替应用提交下一块缓冲区?如果一次只读走半帧,剩下的字节又放在哪里?
VB2 没有为 read/write 另造一套采集状态机。它在已有队列之上加了一层 fileio 适配:替应用持有内部缓冲区,直接调用核心的申请、排队、出队和停流接口,再在内部存储与应用存储之间复制字节。本篇沿这层适配往下读,直到找到每次隐式交接的位置。
主线先采用普通 CAPTURE、实际只有一个内存平面、偏移为零、连续读取的配置;随后展开 OUTPUT 和其他分支。实现使用固定 bufs[]、min_buffers_needed、prepared、synced 这些字段。具体行为以展示的函数体为准,不把其他版本的处理方式混进来。
1. read 得到的是字节副本,不是一个待归还的索引
1.1 先把两块存储摆在一起
假设当前格式仍是 640 × 480 RGB24,行尾没有额外填充,一帧有效图像是 921600 字节。现在至少要区分两块存储:内部采集平面 S,以及应用传给 read 的目标区域 A。
设备或软件驱动先写 S,报告完成。fileio 从 VB2 取回 S 对应的内部对象,再把字节从 S 复制到 A。应用处理 A,不需要再用 QBUF 把 A 归还给设备。S 则由 fileio 在合适的位置重新排队,继续下一轮。
这与 MMAP 的交接不同:MMAP 让应用通过映射访问内部存储;fileio 在这里执行复制,让应用取得自己的数据副本。read() 返回之后,已经复制到 A 的字节不会仅因 S 被重新采集而自动变化。
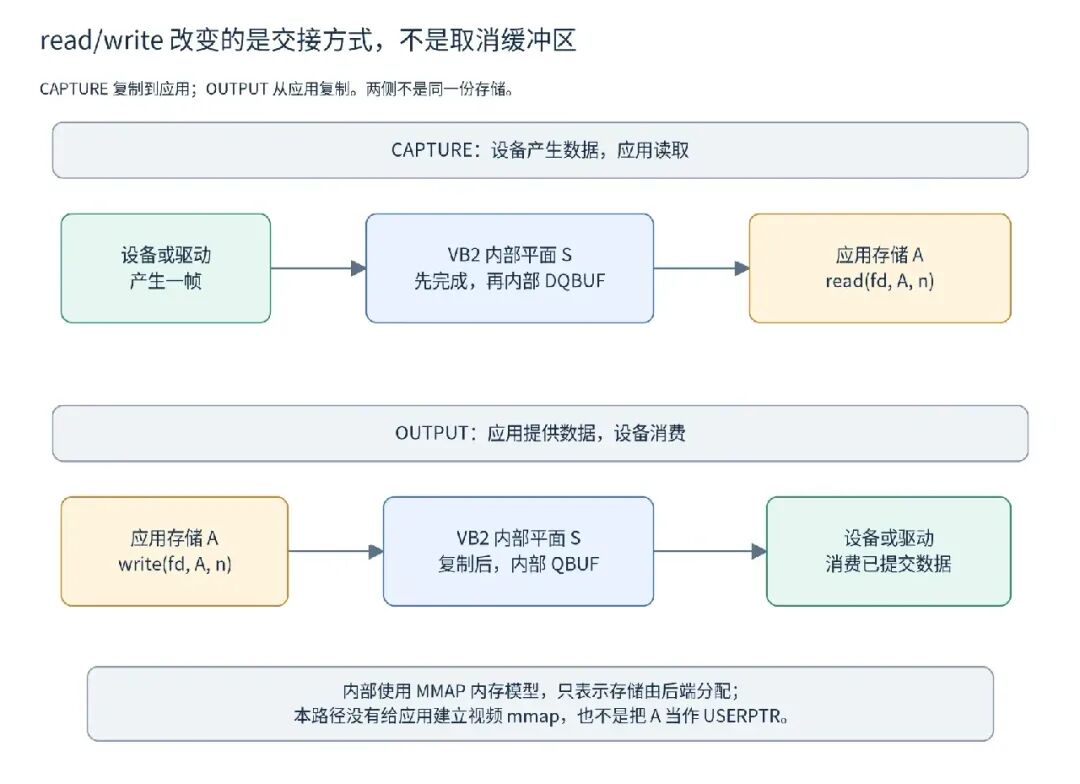
图 1:CAPTURE 向应用复制,OUTPUT 从应用复制。图中的箭头不是地址转换;复制确实传输了像素或其他载荷。
对同样的 921600 字节,若每秒成功复制 30 次,仅这一次复制的数据量就是 27648000 字节每秒。若把读源和写目标分别计入有效内存流量,则为 55296000 字节每秒。这是按假设计算的量,不是实际总线带宽测试,也没有包括设备最初写入、缓存和其他处理开销。
1.2 write 不是把应用指针直接给设备
OUTPUT 方向反过来。应用先准备 A,fileio 使用 copy_from_user() 将数据复制进内部槽位 S,达到提交条件后再把 S 交给队列。
正常返回的字节数说明本次接受了多少输入字节;它不承诺这些字节已经全部显示、编码或由设备消费。使用默认的积累策略时,某次短 write 甚至还没有把当前内部槽位提交出去。
这里也没有 USERPTR 取页,没有把 A 的指针直接写进 DMA 寄存器。设备仍然使用内存后端为 S 建立的访问关系。fileio 改变的是应用接口和数据复制,不是底层设备的地址约定。
1.3 接口变简单,也丢掉了一部分描述能力
DQBUF 返回 index、bytesused、sequence、时间戳和状态标志;read 主要返回字节数。它没有附带一份 struct v4l2_buffer,因此不能把本次 read 的系统时间当成驱动提供的采集时间戳,也不能从返回长度恢复完整的错误标志。
例如单个缓冲区以 ERROR 完成,VB2 核心仍可以成功出队;fileio 的普通 read 路径没有把该标志单独编码到返回接口中。真正的队列错误又可以让内部出队返回 -EIO。单帧错误、队列错误和系统调用结果并不是同一层信息。
实现对照:__vb2_perform_fileio()、vb2_core_dqbuf();外部接口语义见文末 read/write 文档。
2. 先换对实例:本篇采用 vivid,而不是直接沿用 VIMC
2.1 有 read 回调,不代表队列允许 read
前面的 VIMC 文件操作表虽然挂接了 vb2_fop_read,其捕获队列配置却没有声明 VB2_READ。标准包装函数会先检查这个位,因此不能只看到 .read 非空,就断言 VIMC 能跑通 fileio。
本篇改用同一套媒体驱动中的 vivid 作接入实例。它的公共文件操作表同时提供读写、poll 和标准 ioctl;vivid_create_queue() 再按队列方向声明支持方式:
q->type = buf_type;
q->io_modes = VB2_MMAP | VB2_DMABUF;
q->io_modes |= V4L2_TYPE_IS_OUTPUT(buf_type) ?  VB2_WRITE : VB2_READ;
CAPTURE 加入 VB2_READ,OUTPUT 加入 VB2_WRITE。同时,其普通视频节点会报告 V4L2_CAP_READWRITE。应用应从 QUERYCAP 的当前节点能力判断读写入口,再读取或协商格式;能力声明仍不能代替具体布局检查。
2.2 本篇先选能被字节流明确表示的布局
vivid 既可以使用单平面 API,也可以使用多平面 API;但当前 fileio 在内部申请后,检查的是:
q->bufs[0]->num_planes == 1
也就是实际内存平面数量必须为 1。多平面 API 恰好承载一个内存平面时,不会仅因 _MPLANE 后缀就在这里被拒绝;真正需要两块以上独立平面存储的格式,则不能通过本实现的 fileio。
另一个限制来自驱动。vivid 的视频布局回调会在 fileio 活跃时拒绝 V4L2_FIELD_ALTERNATE,因为 read/write 无法携带每次交替场所需的 TOP/BOTTOM 描述。这说明“支持 read/write”不是保证所有像素布局、场模式和请求模式都适用。
下面以单平面 API、普通逐帧模式为主,使用 921600 字节作为手算示例。它是解释游标的假设值,不声称 vivid 无须配置就一定采用这个格式。
2.3 驱动仍使用原来的队列回调
vivid 的 CAPTURE 和 OUTPUT 队列继续提供 queue_setup、buf_prepare、buf_queue、start_streaming、stop_streaming 以及等待回调。内部池由选定的 vmalloc 或 dma-contig 后端分配,完成由驱动的处理路径报告。
对当前普通视频配置,不启用 Request 支持时,vivid_create_queues() 传入的最低缓冲区要求为 2;布局回调也会把总数量不足 2 的申请提高。因此,后面看到 fileio 从 count=1 开始,不能理解成 vivid 最终只使用一块存储。
这里先确认接入条件。输出方向还存在一处跨层 payload 配对问题,本篇会在实际提交位置展开,而不是把函数表连接等同于完整行为一定正确。
实现对照:vivid_fops、vivid_create_queue()、vivid_create_queues()、vid_cap_queue_setup()、vid_out_queue_setup()。
3. read/write 走文件操作,不经过 video_ioctl2
3.1 两条入口汇合在一个执行函数
正常入口关系是:
read()
  → v4l2_read()
  → vdev->fops->read = vb2_fop_read
  → vb2_read()
  → __vb2_perform_fileio(..., read=1)

write()
  → v4l2_write()
  → vdev->fops->write = vb2_fop_write
  → vb2_write()
  → __vb2_perform_fileio(..., read=0)
v4l2_read()、v4l2_write() 检查节点注册状态及相应回调,之后直接转发。它们不生成 VIDIOC_QBUF,也不调用 video_ioctl2() 完成“内核自己给自己发 ioctl”。
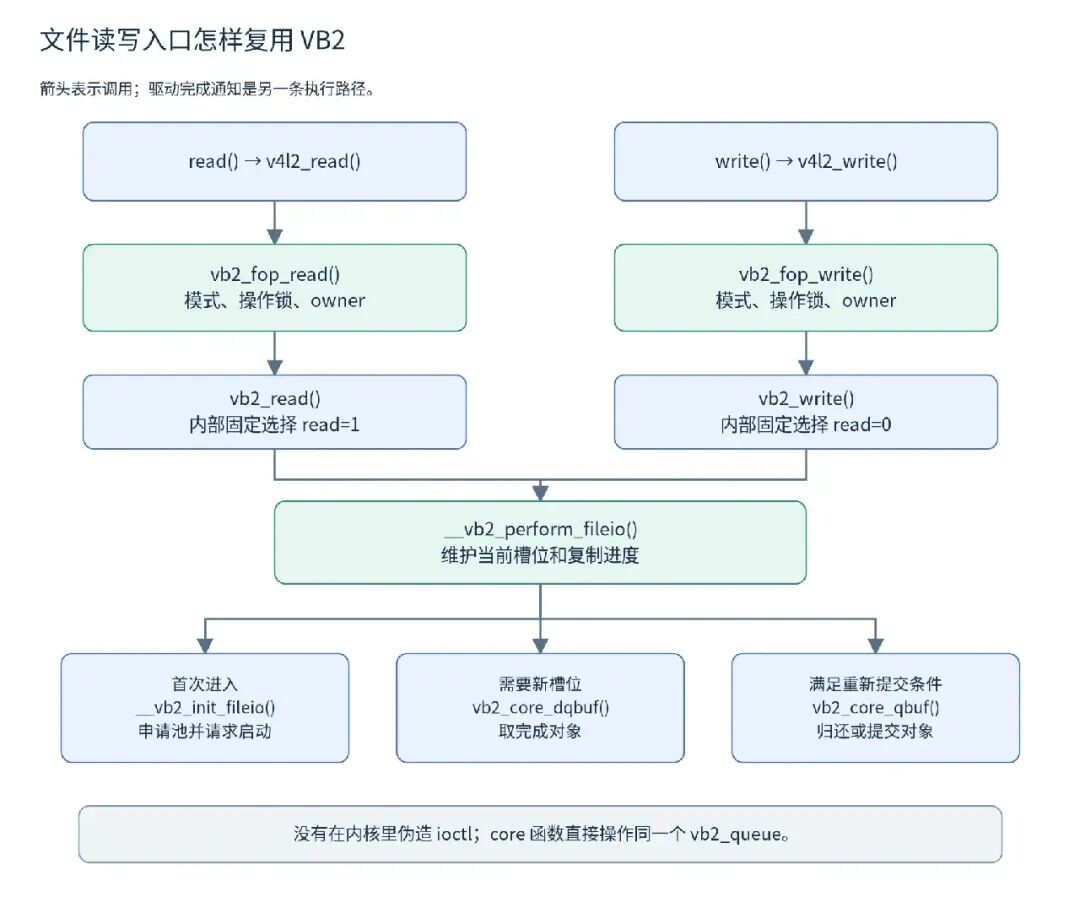
图 2:参数 read=1/0 是 __vb2_perform_fileio() 的选择值。vb2_read/vb2_write 各自固定传入其中一种,不要求应用额外提供这个参数。
3.2 包装层先解决模式、锁和队列归属
vb2_fop_read() 的完整实现如下:
ssize_tvb2_fop_read(struct file *file, char __user *buf,
size_t count, loff_t *ppos)
{
structvideo_device *vdev = video_devdata(file);
structmutex *lock = vdev->queue->lock ? vdev->queue->lock : vdev->lock;
int err = -EBUSY;

if (!(vdev->queue->io_modes & VB2_READ))
return -EINVAL;
if (lock && mutex_lock_interruptible(lock))
return -ERESTARTSYS;
if (vb2_queue_is_busy(vdev->queue, file))
gotoexit;
    err = vb2_read(vdev->queue, buf, count, ppos,
               file->f_flags & O_NONBLOCK);
if (vdev->queue->fileio)
        vdev->queue->owner = file->private_data;
exit:
if (lock)
        mutex_unlock(lock);
return err;
}
它首先检查 VB2_READ,再选择队列锁,未提供队列锁时退到节点锁。锁非空时,以可中断方式取得它;队列已被别的打开上下文占有,则返回 -EBUSY。
这里不是按 PID 判断。同一个 struct file 的别名描述符共享上下文;另一次独立打开则通常携带另一份 private_data。前面文件句柄篇建立的关系,到这里成为队列身份检查的依据。
注意 owner 的赋值条件:只要返回包装层时 q->fileio 仍存在,就把当前上下文记为 owner。它不要求这次 read 已成功复制字节。首次非阻塞 read 可能已经建池并启动,随后因为没有完成对象返回 EAGAIN;队列仍由当前上下文持有。
write 包装使用同样的结构,只是先检查 VB2_WRITE,随后调用 vb2_write()。操作串行化在这层及驱动约定中完成,不能以函数名带 core 为由,假设直接调用的核心函数会替调用方取得所有外层锁。
实现对照:v4l2-dev.c 的读写入口;vb2_fop_read()、vb2_fop_write()。
4. 为了记住“上次只读了一半”,fileio 增加了什么对象
4.1 一个槽位需要保存当前复制位置
vb2_fileio_buf 很短:
structvb2_fileio_buf {
void *vaddr;
unsignedint size;
unsignedint pos;
unsignedint queued:1;
};
vaddr 是该内部平面的内核 CPU 地址。pos 表示已走到哪里。size 在初始阶段记录容量;读取一个完成缓冲区以后,通常改为该轮的有效数据量。queued 记录适配层已经执行的排队动作,但真正的 VB2 状态仍在 vb2_buffer.state 中。
这里没有新的像素数组。fileio 记录的地址仍指向原有平面存储,额外分配的是少量控制信息。
4.2 两个索引负责不同的阶段
队列级控制块如下:
structvb2_fileio_data {
unsignedint count;
unsignedint type;
unsignedint memory;
structvb2_fileio_bufbufs[VB2_MAX_FRAME];
unsignedint cur_index;
unsignedint initial_index;
unsignedint q_count;
unsignedint dq_count;
unsigned read_once:1;
unsigned write_immediately:1;
};
最重要的是 cur_index 和 initial_index。
假设池有 N 个内部缓冲区。cur_index < N 表示已经有一个当前槽位,可以继续读写其中的剩余部分;cur_index == N 被当成一个特殊值,表示下一次必须先从完成列表取得槽位。它不是有效缓冲区索引,不能直接拿去访问 q->bufs[N]。
initial_index 用于 OUTPUT 首轮。刚初始化时,还没有任何槽位提交给设备,应用应先填槽位 0、1……,而不是立刻等待一个尚未产生的完成结果。每成功提交一个首轮槽位,它递增一次;达到 N 后,才进入后续的完成出队与重新填写循环。
CAPTURE 则在初始化时已经预排所有槽位,两个索引直接设为 N。第一次 read 因此先走内部 DQBUF,实际返回哪一块就读哪一块,不固定从 buffer 0 开始。
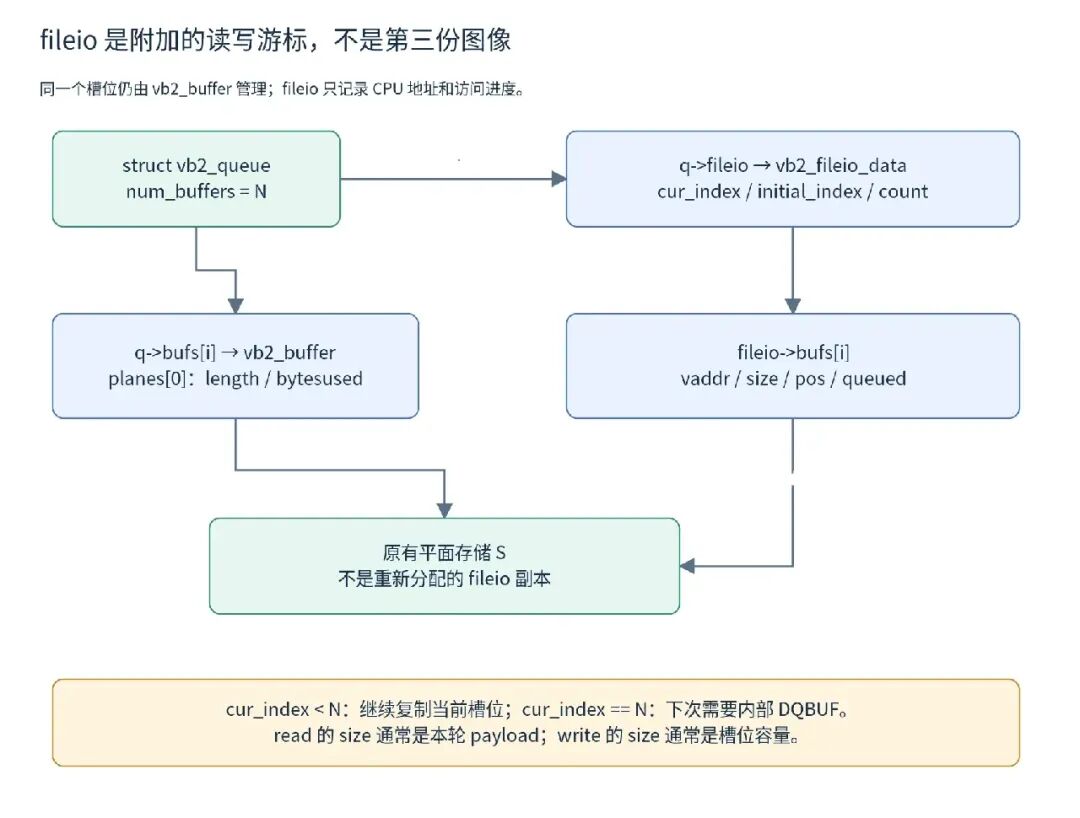
图 3:实线表达管理关联。fileio->bufs[i] 与 q->bufs[i] 共享索引,但保存的不是相同类型的对象,也不是两份像素。
q_count 和 dq_count 是这个适配控制块维护的累计动作计数,不是 q->queued_count 或 owned_by_drv_count 的替代品。初始化预排并不通过 __vb2_perform_fileio() 中增加 q_count 的那段代码,因此也不能简单把它当成全生命周期 QBUF 总次数。
5. 第一次访问:__vb2_init_fileio 怎样建立内部池
5.1 为什么还会出现 MMAP
fileio 明确设置:
fileio->count = count;
fileio->memory = VB2_MEMORY_MMAP;
fileio->type = q->type;
q->fileio = fileio;
ret = vb2_core_reqbufs(q, fileio->memory, 0, &fileio->count);
这里的 VB2_MEMORY_MMAP 使核心使用内存后端的分配路径,建立内部平面存储。它描述内部存储来源,不表示应用已经执行 mmap,也不要求 read 的目标地址来自视频设备映射。
这条路径直接进入 vb2_core_reqbufs(),不是从应用的 vb2_ioctl_reqbufs() 重新走一遍。后端必须能分配、释放,并给 CPU 提供有效地址;当前初始化函数显式检查 mem_ops->vaddr,但不替驱动证明其他所有配置组合都正确。VB2_READ 与 VB2_MMAP 也是两种支持位,不能只因内部采用 MMAP 内存模型就把它们当成同一个能力。
5.2 q->fileio 为什么要在申请前设置
初始化先分配控制块、设置内存模式,再把 q->fileio 指过去,随后申请缓冲区。这样 queue_setup() 执行时,驱动能够通过 vb2_fileio_is_active() 判断当前是不是文件读写模式。
前面 vivid 拒绝交替场的检查,就依赖这个时序。若把流程图画成“先申请完成,最后才设置 fileio”,会看不懂这类驱动检查为什么能够生效。
初始请求数量是 1,但第五篇已经讲过:核心下限、驱动布局回调和实际分配结果共同决定最终数量。后续循环全部以 q->num_buffers 或返回结果为准。
5.3 获得每个平面的 CPU 地址
核心分配成功后,fileio 拒绝实际平面数不为 1 的布局,然后为每个对象取出地址与容量:
for (i = 0; i < q->num_buffers; i++) {
    fileio->bufs[i].vaddr = vb2_plane_vaddr(q->bufs[i], 0);
if (fileio->bufs[i].vaddr == NULL) {
        ret = -EINVAL;
goto err_reqbufs;
    }
    fileio->bufs[i].size = vb2_plane_size(q->bufs[i], 0);
}
有 vaddr 回调还不够,每次返回值也必须有效。返回 NULL 时,这份实现返回 -EINVAL 并撤销已建立的池。
这同样解释了为什么并非所有可以 DMA 的存储都适合直接挂 read/write。若所选分配属性不提供 CPU 映射,设备可以使用它,却未必能完成这里需要的 CPU 复制。fileio 的限制应看实际后端与分配属性,而不是只看名字中有没有 DMA。
5.4 CAPTURE 预排全部槽位,OUTPUT 留待填写
read 模式依次调用:
vb2_core_qbuf(q, i, NULL, NULL);
把实际分配的所有内部缓冲区预排进去,随后将两个索引设为 N。write 模式跳过这个循环,两个索引保留清零分配得到的 0。
两种模式最后都调用 vb2_core_streamon(q, q->type)。读端通常已有足够的预排对象,可以立即进入驱动启动;写端尚未提交对象,在 min_buffers_needed > 0 的配置下只记录流请求,等后续写入并提交达到门槛,再由 QBUF 路径触发启动。最低门槛为 0 的配置可能更早调用启动回调,不能把“写端必然延后启动”当成无条件规则。
图 4:初始化的核心差异是预排时机。图中 count=1 是起点,不是保证最终数量为 1。
5.5 失败出口与正常关闭并不是同一条路径
初始化在申请之后失败,会尝试用 vb2_core_reqbufs(..., count=0) 撤销池,然后清 q->fileio 并释放控制块。申请本身失败则直接清理控制块。初始化失败分支没有先调用 __vb2_cleanup_fileio(),不能把正常关闭的停流顺序直接套上去。
这条安排依赖核心启动失败的回收约定,以及驱动正确撤销启动过程中取得的实际资源。公共框架回收对象,不等于替一个错误驱动停止仍在运行的 DMA。
实现对照:__vb2_init_fileio()、vb2_core_reqbufs()、vb2_core_streamon()。
6. 没有 v4l2_buffer 参数,内部 QBUF/DQBUF 怎样工作
6.1 省掉的是应用描述,不是缓冲区状态机
fileio 调用排队时已有内部索引,调用出队时只需要返回索引:
vb2_core_qbuf(q, index, NULL, NULL);
vb2_core_dqbuf(q, &index, NULL, nonblock);
QBUF 的 pb=NULL 表示没有本次应用传入的 V4L2 描述,最后一个 NULL 表示不是绑定 Media Request 的提交。DQBUF 的 pb=NULL 表示不填写一份返回给应用的 v4l2_buffer,但仍通过 pindex 告知内部调用方拿到了哪个槽位。
核心仍然执行合法状态检查、准备、驱动接收、完成队列管理、buf_finish 和 DEQUEUED 恢复。队列被配置成 requires_requests 时,直接排队依然可能被核心拒绝;fileio 不能绕过请求模式约束。
6.2 NULL 不等于跳过所有适配回调
在 vb2_core_dqbuf() 中,pb 非空才执行接口描述填充;完成对象的摘除和状态复位不以 pb 非空为前提。因此 fileio 能取得真实的完成对象,而不是伪造一个应用缓冲区来骗过接口层。
但对准备路径,不能反推“pb 是 NULL,所以 buf_ops 完全不工作”。MMAP 准备仍调用:
staticint __prepare_mmap(struct vb2_buffer *vb)
{
int ret = 0;

    ret = call_bufop(vb->vb2_queue, fill_vb2_buffer,
             vb, vb->planes);
return ret ? ret : call_vb_qop(vb, buf_prepare, vb);
}
这里仍然可能执行 fill_vb2_buffer。后面分析 write 时,就会看到这处跨层行为会影响输出载荷。读源码时必须跟到真正的回调,不能拿某一层的空指针参数替代下层执行条件。
实现对照:vb2_core_qbuf()、__prepare_mmap()、__vb2_get_done_vb()、vb2_core_dqbuf()。
7. read 的一轮:取回、复制、必要时重新排队
7.1 先取得完成槽位,而不是直接读正在写的存储
进入 __vb2_perform_fileio() 后,当前索引若达到 N,就执行内部 DQBUF。没有完成结果时,阻塞模式会等待,非阻塞模式会返回 -EAGAIN;停流和队列错误也会沿核心出队检查返回。
成功取回后,fileio 保存实际索引,重置复制位置,并使用本轮有效数据量设置读取范围:
fileio->cur_index = index;
buf = &fileio->bufs[index];
b = q->bufs[index];

/*
 * Get number of bytes filled by the driver
 */
buf->pos = 0;
buf->queued = 0;
buf->size = read ? vb2_get_plane_payload(q->bufs[index], 0)
         : vb2_plane_size(q->bufs[index], 0);
本节先取 data_offset=0。多平面 API 中单个内存平面但偏移非零的分支存在额外问题,留到第 12 节按实际算式分析。
7.2 一次调用最多跨过当前一个缓冲区的剩余部分
下一步限制请求长度,并执行复制:
if (buf->pos + count > buf->size) {
    count = buf->size - buf->pos;
    dprintk(q, 5, "reducing read count: %zd\n", count);
}

/*
 * Transfer data to userspace.
 */
dprintk(q, 3, "copying %zd bytes - buffer %d, offset %u\n",
    count, index, buf->pos);
if (read)
    ret = copy_to_user(data, buf->vaddr + buf->pos, count);
else
    ret = copy_from_user(buf->vaddr + buf->pos, data, count);
if (ret) {
    dprintk(q, 3, "error copying data\n");
return -EFAULT;
}

/*
 * Update counters.
 */
buf->pos += count;
*ppos += count;
正常前提是 0 <= pos <= size。如果本次请求大于当前剩余量,就缩短到剩余量;复制成功后,pos 与 *ppos 都增加本次复制字节数。
这里没有循环去接着取第二个完成缓冲区。因此,请求 2 MiB 不表示会把两三帧拼满这个请求。对本篇的固定帧场景,一次最多返回当前这一帧的剩余部分。
ppos 是文件位置跟踪量,不是像素存储中的长期 seek 坐标。设备文件的这套读取逻辑不是普通磁盘文件随机寻址,实际复制位置由 fileio 的 pos 管理。
7.3 未读完就保留,读完才回排
如果复制后 pos < size,函数直接返回复制量,继续保留当前内部槽位。下一次 read 不会再 DQBUF,而是从这个 pos 继续。
读完时,fileio 设置平面载荷,调用核心 QBUF;成功后将 pos 复位、恢复容量、标记已排队,并把 cur_index 设回 N。下次访问才需要再取完成对象。
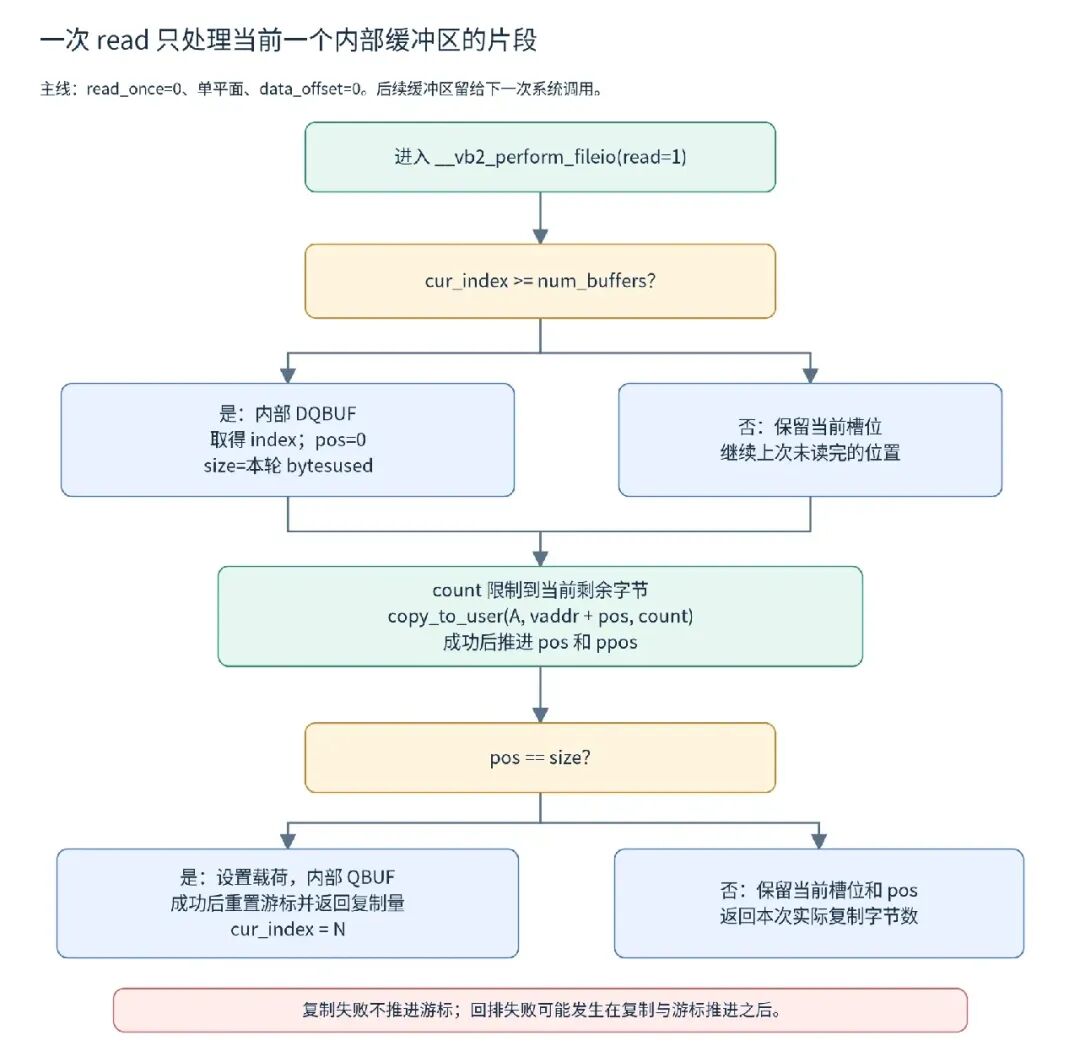
图 5:连续读取主线,忽略特殊 read_once 和非零 data_offset。重新排队成功之后仍返回本次复制量,不在同一次调用中继续读下一帧。
假设一帧 921600 字节,每次请求 400000:第一、二次各复制 400000,第三次复制剩余的 121600,并在完成后回排。第二、三次 read 不需要重新等待同一帧完成,因为该内部槽位已经由 fileio 取回。
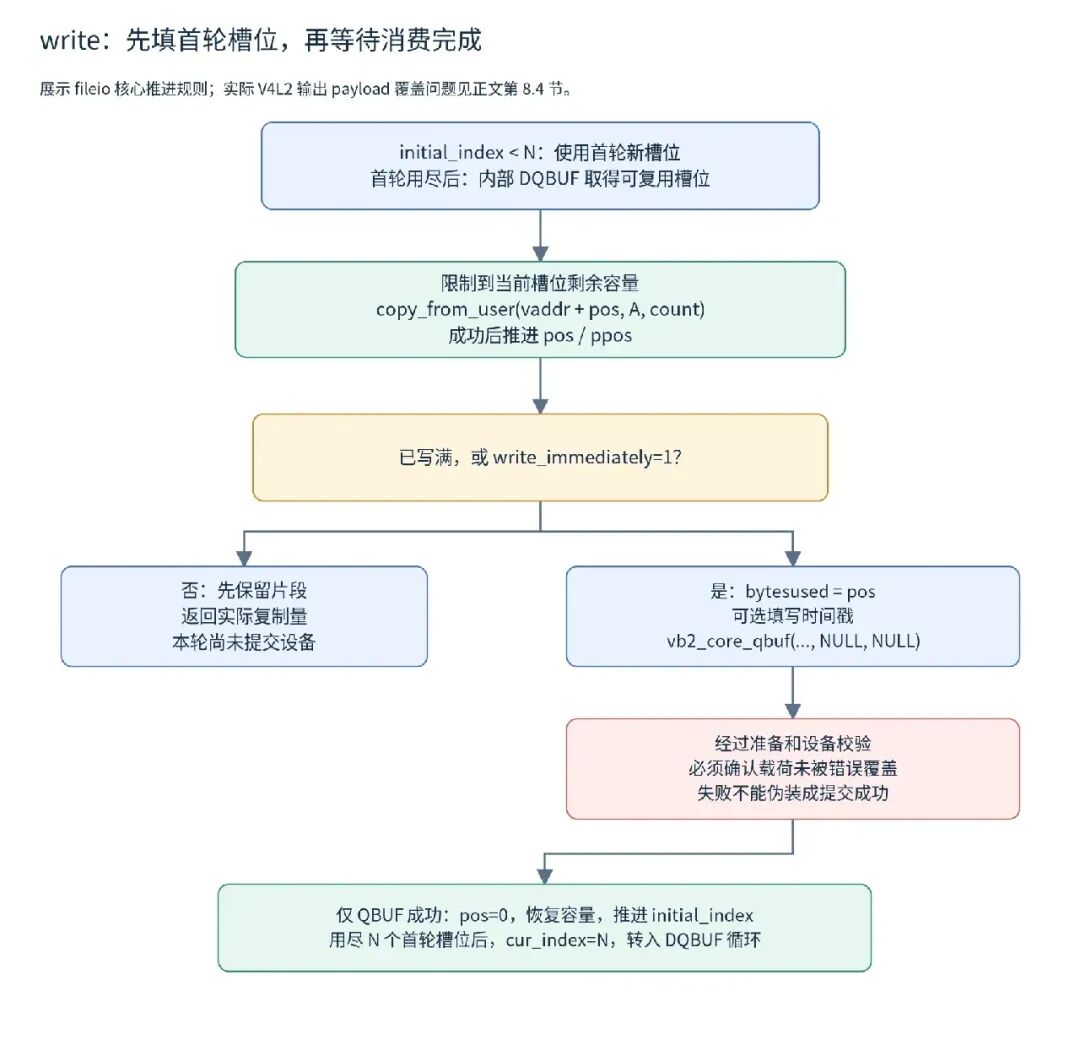
图 6:图示跟踪同一轮内部缓冲区使用,不是保证不同驱动的全部 read 错误恢复策略相同。
7.4 copy 失败和回排失败发生在不同时间
copy_to_user() 只要报告还有字节未复制,当前 helper 就返回 -EFAULT,不推进 pos。但应用目标空间可能已经被写入一部分,不能把失败解释成“一个字节都没有改变”。
另一种情况是:复制成功,游标已经增加,然后内部 QBUF 失败。函数会返回 QBUF 的错误,而不是这次已经复制的字节数。此时应用空间和内部游标都可能已变化,不能简单盲目重试并假设从同一个帧首开始。
通用 read 文档描述的是接口约定;本篇这些分支描述的是所读 helper 的真实控制流。排障时应记录失败来自 DQBUF、复制还是重新排队,不能只用最后一个 errno 推测全部过程。
8. write 的一轮:填充槽位,再把它交给设备
8.1 首轮没有可等待的完成结果
OUTPUT 初始化没有预排。cur_index=0 时,首次 write 直接取得第 0 个内部槽位,将 A 的字节复制到它的 vaddr + pos。
默认 fileio_write_immediately=0。若没有写满槽位,函数保留位置并返回本次复制量,不调用核心 QBUF。下一次 write 可以继续填剩余空间。
槽位写满,或明确配置立即提交时,进入以下代码:
b->planes[0].bytesused = buf->pos;

if (copy_timestamp)
    b->timestamp = ktime_get_ns();
ret = vb2_core_qbuf(q, index, NULL, NULL);
dprintk(q, 5, "vb2_dbuf result: %d\n", ret);
if (ret)
return ret;
这里的时间戳只在 OUTPUT 且配置了 copy_timestamp 时由内核补写。它不是应用提供的 PTS,也不能补回 write 接口没有传递的其他逐帧元数据。
8.2 提交成功后,initial_index 决定去哪里继续
首轮提交第 0 个槽位后,initial_index 变为 1;之后继续使用第 1 个尚未提交的槽位。只有首轮 N 个槽位都提交成功,initial_index 和 cur_index 才达到 N,下一次 write 才执行内部 DQBUF,等待设备已经消费完的槽位。
回收时按内部 DQBUF 返回的索引选择存储,不承诺总是按 0、1、2 固定循环。该对象随后重新填写、重新 QBUF,才形成稳定的 OUTPUT 周转。
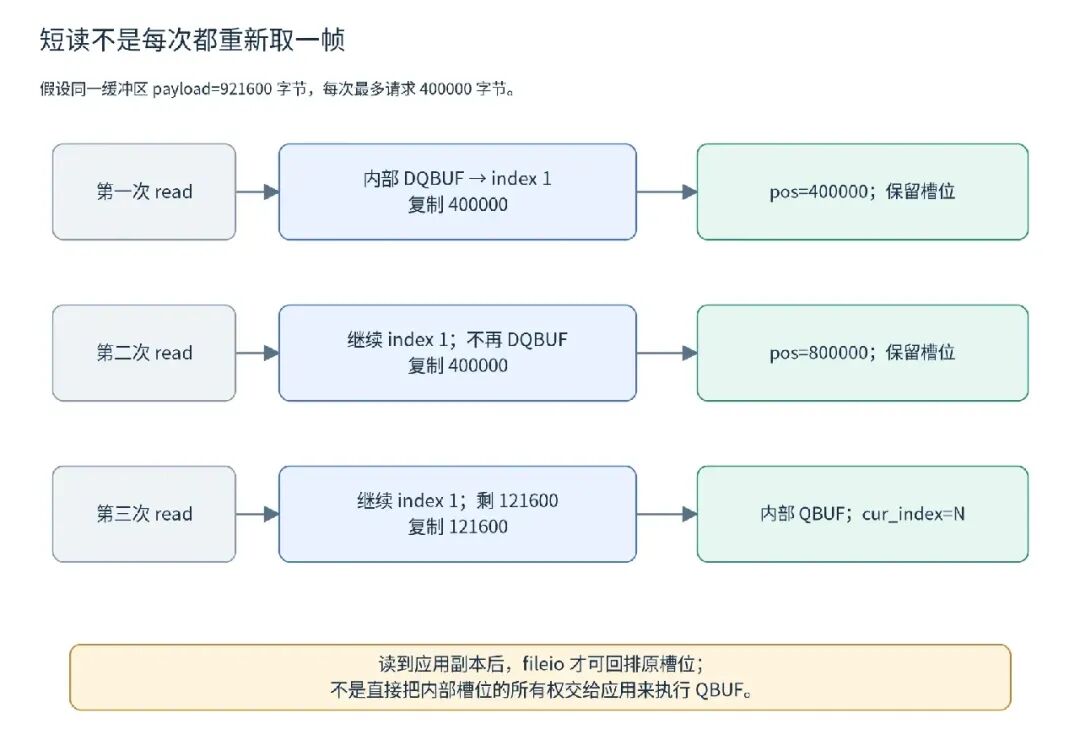
图 7:该图描述 fileio 核心推进条件。进入 QBUF 后仍需通过实际适配和驱动校验;本份 V4L2 输出配对问题见第 8.4 节。
8.3 write_immediately 不是任意短帧都能被设备接受
打开 write_immediately 后,一次成功复制的片段就可以触发提交,bytesused 取当前 pos。但驱动仍可能要求完整图像容量;一个只有几百字节的 RGB 帧可以在 buf_prepare 被拒绝。
默认积累模式同样要尊重返回值。若槽位只剩 100 字节,write 请求 500 字节,本次最多复制 100,另外 400 应由应用根据实际成功返回值处理。这里不会自动跳到下一块继续复制。
对固定大小原始图像,按协商后的完整布局组织输入最容易保证一致;压缩载荷、含头部的布局以及多平面描述,不应凭“write 可以传任意字节数”就假设都能被这一层表达。
8.4 本份实现的跨层问题:刚设置的 bytesused 会被覆盖
这是必须与正常推进规则一起读的一处细节。fileio 在提交前写的是:
b->planes[0].bytesused = buf->pos;
而 __prepare_mmap() 会继续调用 V4L2 的 __fill_vb2_buffer()。该函数从 V4L2 扩展中的平面暂存数组复制字段:
staticint __fill_vb2_buffer(struct vb2_buffer *vb, struct vb2_plane *planes)
{
structvb2_v4l2_buffer *vbuf = to_vb2_v4l2_buffer(vb);
unsignedint plane;

if (!vb->vb2_queue->copy_timestamp)
        vb->timestamp = 0;

for (plane = 0; plane < vb->num_planes; ++plane) {
if (vb->vb2_queue->memory != VB2_MEMORY_MMAP) {
            planes[plane].m = vbuf->planes[plane].m;
            planes[plane].length = vbuf->planes[plane].length;
        }
        planes[plane].bytesused = vbuf->planes[plane].bytesused;
        planes[plane].data_offset = vbuf->planes[plane].data_offset;
    }
return0;
}
普通应用 QBUF 路径事先整理了这份扩展描述;fileio 的直接核心调用没有经过同样的填入过程。在新建立的、清零分配的 V4L2 缓冲区中,vbuf->planes[0].bytesused 初值为零。
于是,本份实现的典型 OUTPUT 首轮路径可能是:
write 复制满一个槽位
    → 通用 vb->planes[0].bytesused 设为已复制量
    → __prepare_mmap 调用 __fill_vb2_buffer
    → 从扩展平面暂存值复制 0,覆盖通用 bytesused
    → 驱动 buf_prepare 观察到 0
vivid 的 vid_out_buf_prepare() 会检查有效载荷至少满足当前格式;在上述条件下,完整帧也可能被判为不足而返回 -EINVAL。这不是应用少写了字节,而是层间传递丢掉了长度。捕获端的 prepare 会按格式重新设置载荷,因此不能把相同结论机械套到 read。
本轮保留实际 __vb2_perform_fileio()、__prepare_mmap()、__fill_vb2_buffer() 的函数体,在受控依赖下复现了覆盖;驱动最小载荷检查使用了与 vivid 对应的替身。它证明这段赋值链的控制流,不等于实际内核和硬件运行测试,也不据此认定所有版本都存在同样问题。
因此,前面图示的 write 成功循环有一个必要前提:下层适配和驱动正确接受了 fileio 准备的载荷。本文没有偷偷修改源函数来得到一个“全部正常”的示例。迁移或修复时应核对对应版本,保证 fileio 的直接描述与常规 V4L2 描述转换分别有清楚的约定,而不是仅在应用端多写几次来掩盖。
9. 阻塞和非阻塞:等待的仍是同一条完成队列
9.1 O_NONBLOCK 传到了哪里
包装层取 file->f_flags & O_NONBLOCK,依次传给 vb2_read/write()、__vb2_perform_fileio(),最后在需要槽位时传入 vb2_core_dqbuf()。
没有完成对象且 nonblock 为真,核心返回 -EAGAIN。阻塞时则等待 done_wq,直到出现完成对象、队列停止、队列错误或信号等变化,再重新检查。
这份 __vb2_perform_fileio() 的参数注释把 nonblock 的 0/1 说明写反了;实际控制流以传入的 O_NONBLOCK 和出队函数判断为准。不能照抄这个注释,把“1”解释成阻塞。
非阻塞不等于整个调用零等待。首次进入还可能分配内存、取得操作锁并调用驱动;它限制的是相关数据等待语义,而不是让所有初始化步骤都变成不可睡眠操作。
9.2 操作锁为什么需要在等待时暂时让出
外层 vb2_fop_read/write 取得操作互斥锁。若内部 DQBUF 没有结果,VB2 使用 wait_prepare 暂时释放约定的锁,醒来后再通过 wait_finish 取得它。vivid 使用标准 vb2_ops_wait_prepare/finish,其 q->lock 指向 dev->mutex,与外层选择一致。
这允许其他合规操作推进队列状态或让错误条件生效。它不是允许两个线程同时无序修改 fileio 游标。另一个共享同一文件对象的线程进入时,waiting_in_dqbuf 会导致当前 helper 返回 -EBUSY,而不是为它再创建一份私有读写进度。
驱动完成路径使用自己的队列或完成锁,并不靠占有应用操作锁才能报告完成。把操作锁、完成自旋锁和设备私有锁混成一把,会错误推导出等待死锁或数据安全结论。
9.3 短读和设备回压
一次短读结束后,当前内部对象已经出队但尚未回排,驱动暂时不能再次使用它。若应用长时间只消费一小段,池中可用位置会减少。其他对象也陆续完成而未归还时,设备端如何处理缺少存储的情况,由驱动决定。
write 方向相反:所有槽位都提交且设备尚未归还时,下一次需要槽位的 write 才等待或返回 EAGAIN。某次 write 返回成功,不表示设备已经赶上消费速度,更不意味着关闭时会自动排空所有已提交数据。
实现对照:__vb2_wait_for_done_vb()、vb2_ops_wait_prepare/finish()、vivid 的两张队列操作表。
10. poll 也可能是第一次真正启动采集的入口
10.1 先登记等待关系,再决定是否启动 fileio
vb2_core_poll() 先执行 poll_wait(file, &q->done_wq, wait),然后检查请求的事件。满足以下条件时,它可以调用 __vb2_init_fileio():当前没有缓冲区、没有 fileio、队列支持对应的 READ/WRITE,并且本次关心相应的数据事件。
读端初始化会预排并请求启动;写端初始化后可立即报告可写。只订阅 POLLPRI 的事件观察,不走这条自动启动数据流的分支。
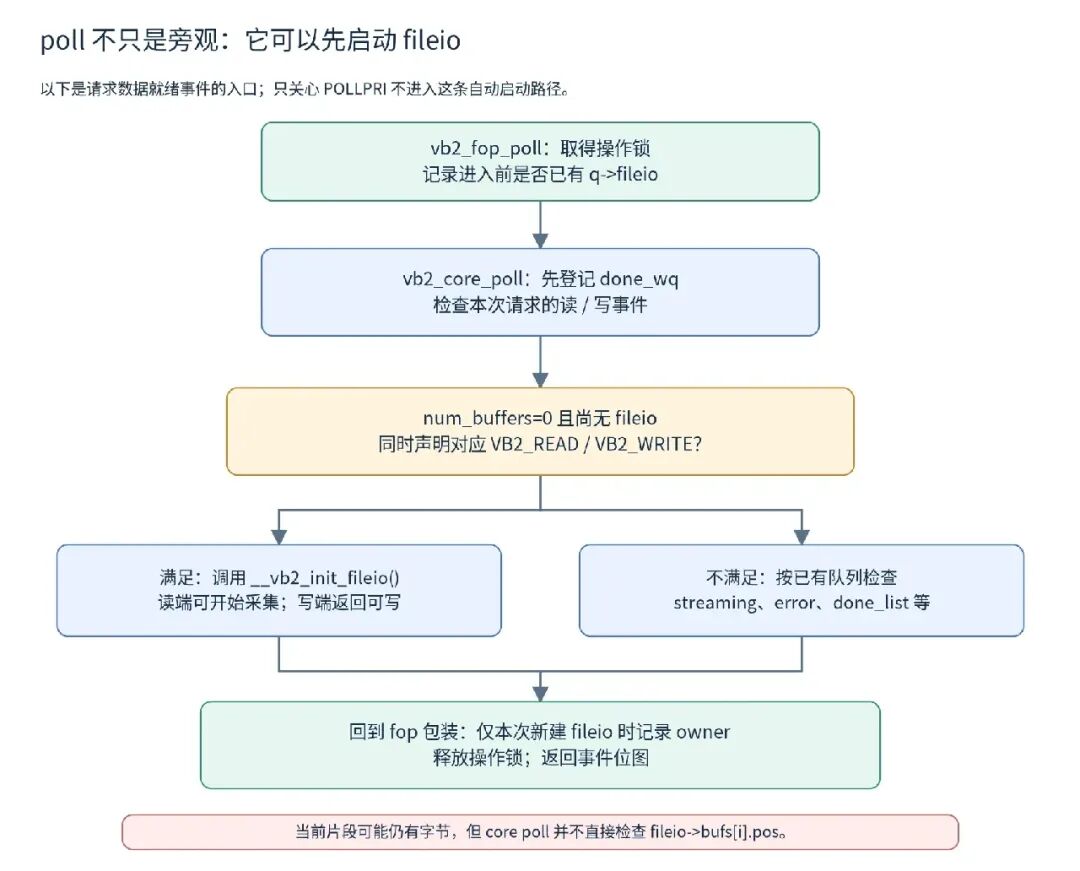
图 8:状态改变发生在 core poll 的自动初始化中;owner 则由外层 fop 包装根据“本次是否新建 fileio”更新。
因此,“还没有调用 read,所以设备一定没有开始采集”并不成立。一个先执行 poll 的程序,就可能创建内部池并进入运行状态。
10.2 POLLIN 不是对某个结果的预订
普通 CAPTURE 就绪检查观察完成列表;OUTPUT 还会判断是否有尚未提交的内部槽位。返回之后,另一个操作仍可能改变状态,因此实际 read/write 仍需处理 EAGAIN、设备断开和错误。
更细的地方是:当前 core poll 不直接检查 fileio->bufs[cur_index] 是否保留了尚未复制完的片段。一次短 read 后,即使当前槽位仍有字节,下次直接 read 可以继续复制,但 poll 可能因完成列表尚空而没有报告输入就绪。
适合本篇观察程序的组织方式是:先做非阻塞 read,只有得到 EAGAIN 才 poll 等待。 不要在每次读取同一帧的残余片段之前,都额外强制等待一个新的完成事件。
10.3 poll 包装没有 read/write 那样的 owner 前置检查
vb2_fop_poll() 记录进入时的 fileio 指针,调用 vb2_poll(),仅在本次由无到有建立 fileio 时赋值 owner。它没有在入口调用 vb2_queue_is_busy()。
这意味着可以观察就绪,不等于随后一定获准读写。同样,已有显式缓冲区时 num_buffers != 0,core poll 不会随意把队列转换成新 fileio。应把模式选择、事件观察和实际操作权限分别判断。
实现对照:vb2_fop_poll()、vb2_poll()、vb2_core_poll();接口边界见文末 poll 说明。
11. 不混用两套队列控制:谁启动,就由谁负责收尾
11.1 显式申请与 fileio 初始化互斥
如果应用已经成功 REQBUFS,即使尚未 STREAMON,fileio 初始化仍会因 q->num_buffers > 0 返回 EBUSY。申请了 MMAP 存储以后再调用 read,并不会自动“读取刚才 mmap 的那块”。
反过来,fileio 活跃时,公开的 QBUF/DQBUF、STREAMON/STREAMOFF 等 V4L2 适配入口会拒绝混用。REQBUFS 的内存方式验证也有 fileio 检查。内部直接 core 调用不会经过这些公开入口的保护分支,这正是两层接口分开的用途。
不要把这一规则扩大成“所有 ioctl 都不可用”。能力查询、适用的格式读取或控制操作是否可用,要看各自入口;格式修改也会受到池已建立等状态约束。QUERYBUF 没有统一 owner 检查,也不代表可以把观察到的内部池接管过来。
11.2 为什么不能靠公开 STREAMOFF 停掉当前 fileio
vb2_streamoff() 的函数体很明确:
intvb2_streamoff(struct vb2_queue *q, enum v4l2_buf_type type)
{
if (vb2_fileio_is_active(q)) {
        dprintk(q, 1, "file io in progress\n");
return -EBUSY;
    }
return vb2_core_streamoff(q, type);
}
fileio 自己使用 vb2_core_streamoff() 退出,而应用提交 STREAMOFF 走的是这里的公开适配层。把两者写成一条同名调用链,会得到“既拒绝 fileio 又用它退出 fileio”的矛盾。
对本文的通用文件读写路径,正常退出依赖当前 file 最终 release 所走的队列清理;不是要求应用成功调用公开 STREAMOFF 后才能 close。
11.3 清理先停止,再释放控制块和内部池
staticint __vb2_cleanup_fileio(struct vb2_queue *q)
{
structvb2_fileio_data *fileio = q->fileio;

if (fileio) {
        vb2_core_streamoff(q, q->type);
        q->fileio = NULL;
        fileio->count = 0;
        vb2_core_reqbufs(q, fileio->memory, 0, &fileio->count);
        kfree(fileio);
        dprintk(q, 3, "file io emulator closed\n");
    }
return0;
}
这个函数先 core STREAMOFF 取消实际运行和排队,再清 q->fileio,以零数量撤销缓冲区池,最后释放 fileio 控制块。清 fileio 指针没有释放像素;实际存储释放由核心和内存后端的对应路径继续完成。
最终关闭时,_vb2_fop_release() 在操作锁下检查 owner。属于当前上下文才调用 vb2_queue_release()、清 owner,之后解除操作锁,再清理标准文件句柄。vb2_core_queue_release() 先调用上述 fileio 清理,随后还有自己的队列取消和缓冲区清理,不能在图里漏掉这段外层收尾。
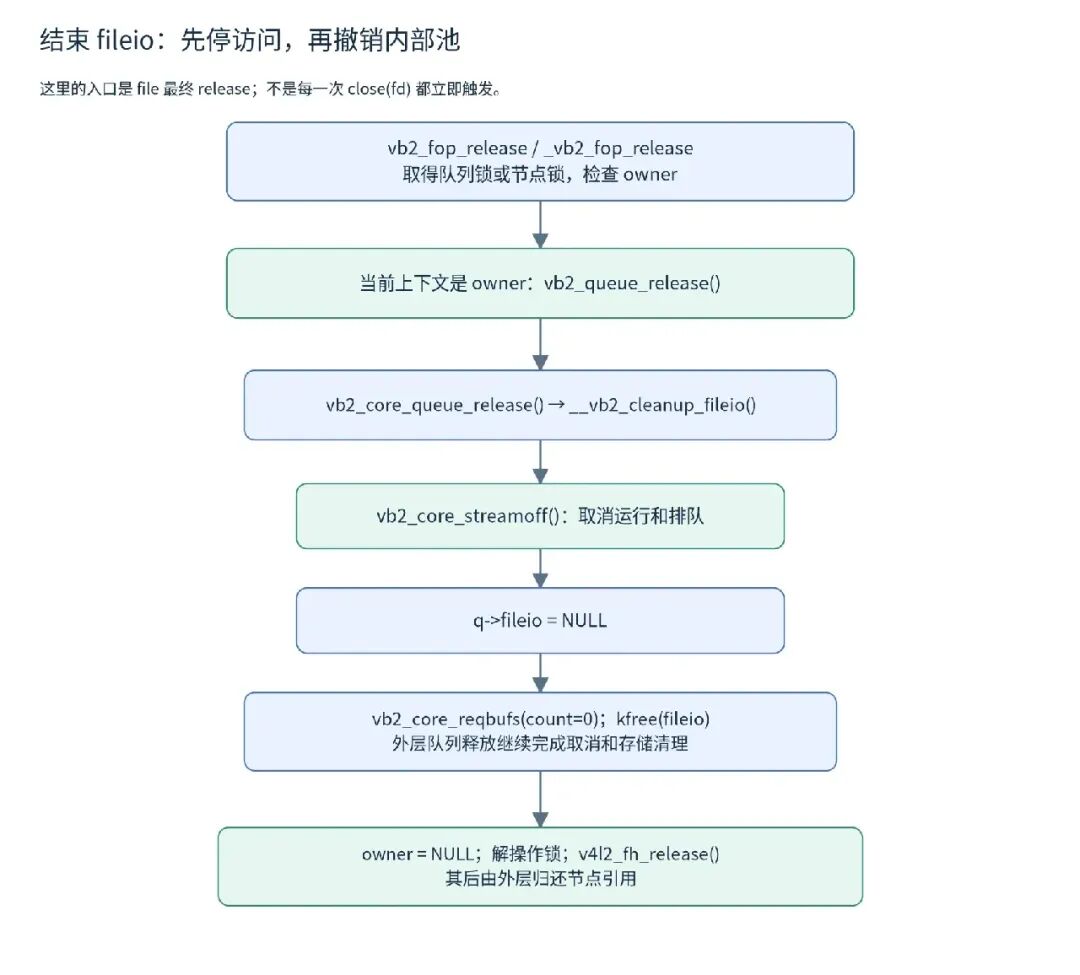
图 9:内部 core 退出不受公开 ioctl 的 fileio 拒绝检查影响。图示省略节点外层可选 Request 锁,不改变这里的对象清理顺序。
11.4 close 不是强制中断其他线程的 read
dup、继承的描述符和进行中的系统调用,都可能继续持有 struct file。另一个线程 close 一个 fd,并不能据此保证正在阻塞的 read 立即结束并释放内部池。
应用应先结束自己的读写循环,再归还最后的文件引用。示例使用非阻塞 read、有限时 poll 和信号标志实现可退出循环,不在信号处理函数中做复杂的驱动调用。对设备断开,还要由驱动结束实际访问并通过错误或注销机制配合等待者。
OUTPUT 退出也不是 drain 协议。还没写满、还没提交的片段可以被丢弃;已经提交但未消费完的对象会随停止取消。需要逐帧确认消费完成时,显式队列接口通常更能表达需要的状态。
12. 几处不能按“名字”理解的实现边界
12.1 read_once 的当前返回值与常见预期不同
这个选项的意图是读完首个出队对象后停止 fileio。但当前实现进入末尾分支时执行:
if (read && fileio->read_once && fileio->dq_count == 1) {
    dprintk(q, 3, "read limit reached\n");
return __vb2_cleanup_fileio(q);
}
复制和 pos 推进发生在这之前,而 __vb2_cleanup_fileio() 返回 0。因此,当本次复制刚好读完首个对象时,数据已复制,helper 却返回清理结果 0,而不是本次复制字节数。
若之前分多次读取,前面的片段可以返回正数,最后一段返回 0;如果一开始就请求整个有效载荷,则第一次也可能返回 0。控制块已被销毁,随后再调用还可能重新初始化,不能把它描述成一个可靠的“一帧后永久 EOF”协议。
本篇主线不设置该选项。受控测试重现了这个返回路径,但未把它修改成理想行为,更没有把 0 解释成硬件没有产生图像。
12.2 单个内存平面中的 data_offset 被重复扣减
当前 MPLANE read 分支先设置 size = bytesused,然后:
if (is_multiplanar && read &&
        b->planes[0].data_offset < buf->size) {
    buf->pos = b->planes[0].data_offset;
    buf->size -= buf->pos;
}
之后统一的剩余量计算仍然使用 size - pos。假设 bytesused=100、data_offset=20,按平面描述语义,有效区间应为 [20,100),长度 80。代码却得到 pos=20、size=80,随后只允许复制 60 字节,覆盖 [20,80),尾部 20 字节被遗漏。
如果偏移更大,使调整后的 size 小于 pos,后续无符号减法还会违反正常范围前提。本文只用受控的安全数值验证截短现象,不对真实设备执行危险边界复制。
所以,“实际只有一个平面”只解决了初始化入口的数量限制,不足以证明所有带 data_offset 的布局都被正确处理。本篇例子坚持偏移为零;非零偏移的实现必须单独核对,不能把这段代码当成通用正确模板。
12.3 零字节调用不能用来试探初始化
接口文档将 count=0 描述为无数据传输、无其他效果。当前 __vb2_perform_fileio() 却没有在初始化之前统一返回零的快捷分支,非空指针、零 count 的直接 helper 调用仍可建立 fileio;read 还可能先尝试出队。
这是函数层面的检查结论。实际系统调用还涉及 VFS 和具体驱动入口,本篇没有用替身测试断言所有架构上的 syscall 行为完全相同。观察程序不发送零 count,也不拿零长度 read/write 做无副作用的能力探测。
12.4 队列错误不等于当前残余片段一定立即拒绝
队列错误通常在核心准备或出队处被检查。如果 fileio 正保留一个已取回的槽位,它可能先复制残余字节,到回排时才碰到 core QBUF 的错误。这与“进入 helper 的第一行就统一检查 q->error”不同。
这个顺序再次说明:已经复制、已经更新游标和最终系统调用成功,不应混作同一个事件。排查错误后继续读写是否合理,要看当前阶段,不能只按一个 errno 编写无条件重试。
实现对照:__vb2_perform_fileio() 的三个特殊分支;第 8.4 节另讨论输出 payload 配对。这里的异常均限定于所读实现,不推广到所有 VB2 版本。
13. 内核线程也能复用这套机制,但不是 read 自动创建一个 vb2_thread
13.1 真正复用的入口是 vb2_thread_start
同一个核心文件还提供 vb2_thread_start() 和 vb2_thread_stop()。启动函数检查是否已有 threadio、已有缓冲区或 fileio,再调用 __vb2_init_fileio(q, !q->is_output),保存回调和私有参数,创建 vb2_thread。
源码紧挨着入口有明确的用途限制:这份辅助函数用于 videobuf2-dvb 支持;其他使用场景需要另行评估,不能把它推荐成所有摄像头驱动都应采用的通用线程模板。
它也不是前面 VIMC 的 vimc_streamer_thread,更不是 vivid 的采集生成线程。三者可以都与缓冲区有关,但创建者、工作内容和退出协议各不相同。
13.2 回调直接拿内部对象,不经过应用复制
线程的正常循环是:取得完成对象,调用 fnc(vb, priv) 处理,随后核心 QBUF。OUTPUT 首轮与 write 一样先使用尚未提交的槽位,不立即等待 DQBUF。
DVB 的具体处理回调是:
staticintdvb_fnc(struct vb2_buffer *vb, void *priv)
{
structvb2_dvb *dvb = priv;

    dvb_dmx_swfilter(&dvb->demux, vb2_plane_vaddr(vb, 0),
                      vb2_get_plane_payload(vb, 0));
return0;
}
它从内部对象取得 CPU 地址和载荷,直接送入软件解复用。这个适配入口没有 copy_to_user() 或 copy_from_user();回调自身做什么是另一回事。共享初始化辅助函数,不等于共享 read/write 的那一段字节复制。
回调使用的地址仍受本轮交接限制。返回以后,缓冲区可能重新排队;不能在回调里把裸指针交给异步消费者,又立即返回并允许下一轮覆盖。
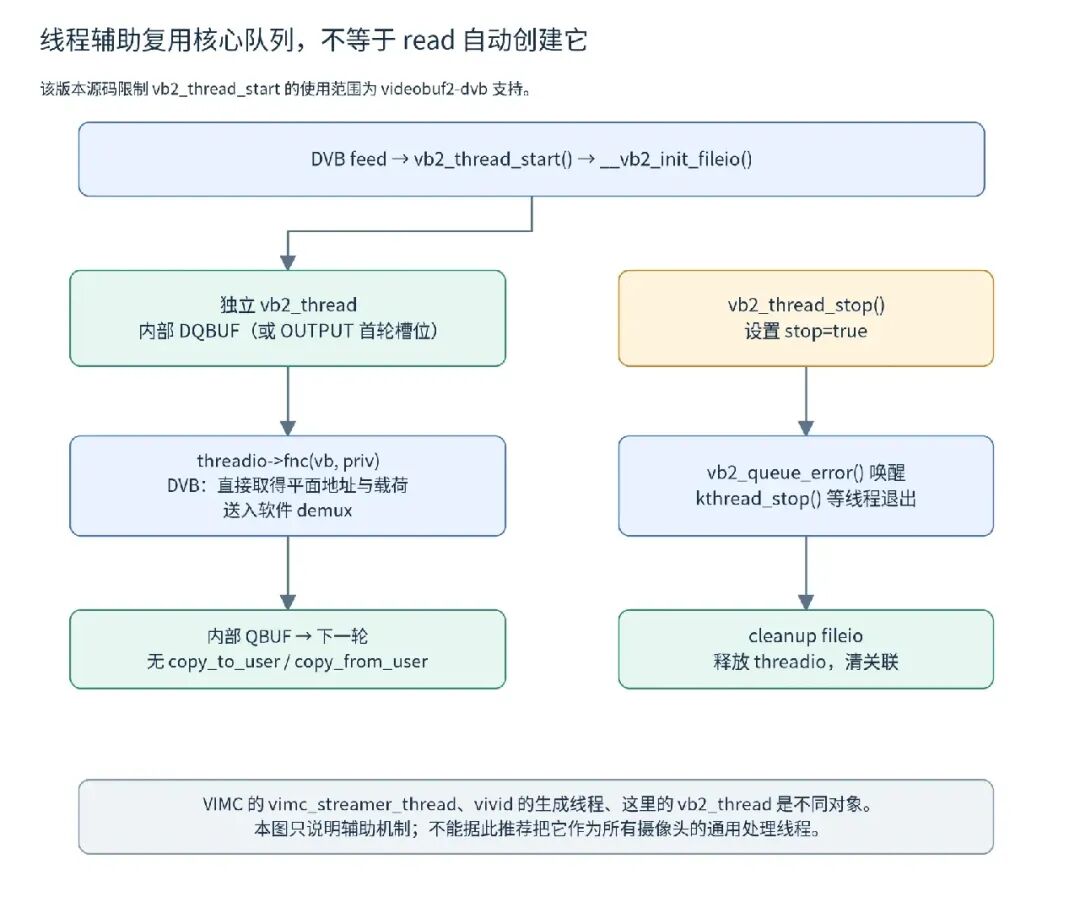
图 10:DVB 适配只是复用关系的具体证据,不把传输流对象当成普通视频帧,也不继续展开 DVB 解复用算法。
13.3 停止要先唤醒内部出队等待
vb2_thread_stop() 设置 threadio->stop,通过 vb2_queue_error() 唤醒 done_wq,再 kthread_stop() 等线程退出,随后清理 fileio、释放 threadio 并清指针。
线程在内部出队和排队周围使用 wait_finish/wait_prepare 配合操作锁。停止发起路径不能持着线程退出还需要取得的锁等待它结束;实际调用方必须满足配套约定。
这份实现还有两处不能忽略的限制。其一,核心 DQBUF 已恢复 DEQUEUED,线程随后用 vb->state != ERROR 判断是否调用回调,不能据此保证自动过滤先前 ERROR 完成的数据。其二,线程创建失败分支清理 fileio 并释放 threadio,却没有在该出口清掉已经设置的 q->threadio,需要单独审查后续错误恢复。本文只说明实际控制流,不给出“任意失败后可以直接重试”的保证。
线程辅助的这些边界不影响前面普通 read/write 的调用关系,因为那条路径根本没有调用 vb2_thread_start()。
14. 一个只通过 read 观察 fileio 的程序
14.1 实验先限定能确认的条件
配套 vb2_read_probe.c 只接受普通单平面 CAPTURE,并要求节点声明 READWRITE。它读取当前格式,不替正在使用的设备修改格式;申请普通应用存储,然后直接 read。程序没有调用 REQBUFS、QBUF、DQBUF、STREAMON、STREAMOFF 或视频 mmap。
参数中的次数表示成功返回正字节数的 read 调用次数,不是帧数。chunk 表示每次请求上限,默认使用当前 sizeimage。指定较小 chunk 时,可以观察同一对象分次复制,但打印中不虚构内核 index 或采集时间戳。
核心循环采用:
n = read(fd, data, chunk);
if (n > 0) {
/* 记录本次字节数;这不是保证取得一整帧。 */
} elseif (n < 0 && errno == EAGAIN) {
/* 只有无数据可取时才 poll,处理超时、信号和错误。 */
} else {
/* 零返回或其他错误结束观察,不伪造有效帧。 */
}
完整程序位于 examples/vb2_read_probe.c,包含能力与长度检查、参数范围、信号退出、有限时等待、错误清理和实际复制数据的简单校验和。
14.2 编译与运行
cc -std=c11 -Wall -Wextra -Werror -O2 \
    vb2_read_probe.c -o vb2_read_probe

# 使用当前格式,每次请求不超过 sizeimage,观察 6 次正返回。
./vb2_read_probe /dev/videoX 6

# 每次最多请求 65536 字节,观察 20 次正返回;不是承诺取得 20 帧。
./vb2_read_probe /dev/videoX 20 65536
在空闲测试节点上运行,先确认选择的是 vivid 的普通采集节点或其他明确支持 read 的设备,格式实际为单平面、逐帧且布局适用。程序中的 X 是需要替换的节点编号,不假定 video0 就是目标节点。
第一次 read 或先前的 poll 可能真的启动采集;它不是只查看静态属性的探针。程序退出时关闭自己的 fd,让最终 release 处理内部 fileio。它不使用公开 STREAMOFF 强行切换模式,也不声称能在别的线程仍持有文件引用时强制终止全部访问。
14.3 为什么本篇不附一个“保证成功”的 write 演示
第 8.4 节的 payload 覆盖会影响实际输出提交。给出一个不说明该前提的 write 演示,然后把返回错误归因于应用或硬件,会误导定位。
因此,本篇用受控测试观察 write 的游标、首轮推进、立即提交和适配覆盖;实际输出测试应先核对目标代码与格式约束,再确认该配对问题已经得到处理。文档没有提供未经验证的修复补丁,也没有把测试替身当作真实 vivid 输出结果。
15. 排障时,先判断卡在哪一个阶段
VB2_READ、布局回调、实际平面数及后端地址取得。 | |
bytesused 检查 fileio、V4L2 扩展转换和驱动最低载荷,而不只看 count。 | |
调试记录建议同时包含当前 fileio 是否存在、cur_index/initial_index、当前 pos/size、q->streaming、q->start_streaming_called 和实际错误返回位置。只打印“read failed”无法区分是还未申请、正在等完成、复制失败,还是回排失败。
在驱动侧再观察 queue_setup、buf_prepare、buf_queue、start_streaming、buffer_done 和 stop_streaming 的进入次数,便能把本篇隐式动作与前面显式队列篇连接起来。
16. 把 read/write 放回整套缓冲区体系
fileio 提供的不是无缓冲区采集,而是一种由框架代理缓冲区周转的访问方式。
应用的 read/write 负责提出字节请求;fileio 保存当前槽位和复制进度;VB2 核心继续执行申请、准备、排队、完成和取消;驱动仍负责真实的数据生产或消费。内存后端仍然决定像素存储和访问关系。
这套方式适合接口简单、可以接受复制、对逐帧元数据要求不高的场景。需要跨设备共享、明确的缓冲区身份、完整结果标志、逐帧时间戳和更细的消费完成控制时,显式队列通常更容易表达需求。取舍不只是调用数量,而是应用究竟要控制哪一层交接。
读到这里,应当能够独立解释三个问题:为什么没有 QBUF 系统调用,驱动仍能收到 buf_queue;为什么一次短 read 之后能继续读同一块;为什么 write 返回正数,设备仍可能尚未开始处理这部分数据。 答案都藏在内部池、两个索引和那些直接 core 调用之间。