ARTICLE · 1285192
AI 论文速览 · 把系统里多余的部件拿掉
2026 年 10 月 31 日|arXiv + HF Daily Papers 精选 5 篇
原 题|Intrinsic Distribution Matching
来 源|arXiv:2610.39633 | cs.CV / cs.AI | HF Daily 231 赞(今日最高)| arXiv + HF Daily 双源 | 代码:github.com/inclusionAI/IDM | 作者:Deyuan Liu, Yansen Han 等(8 人)
分布匹配蒸馏一步/少步文生图生成分布校准
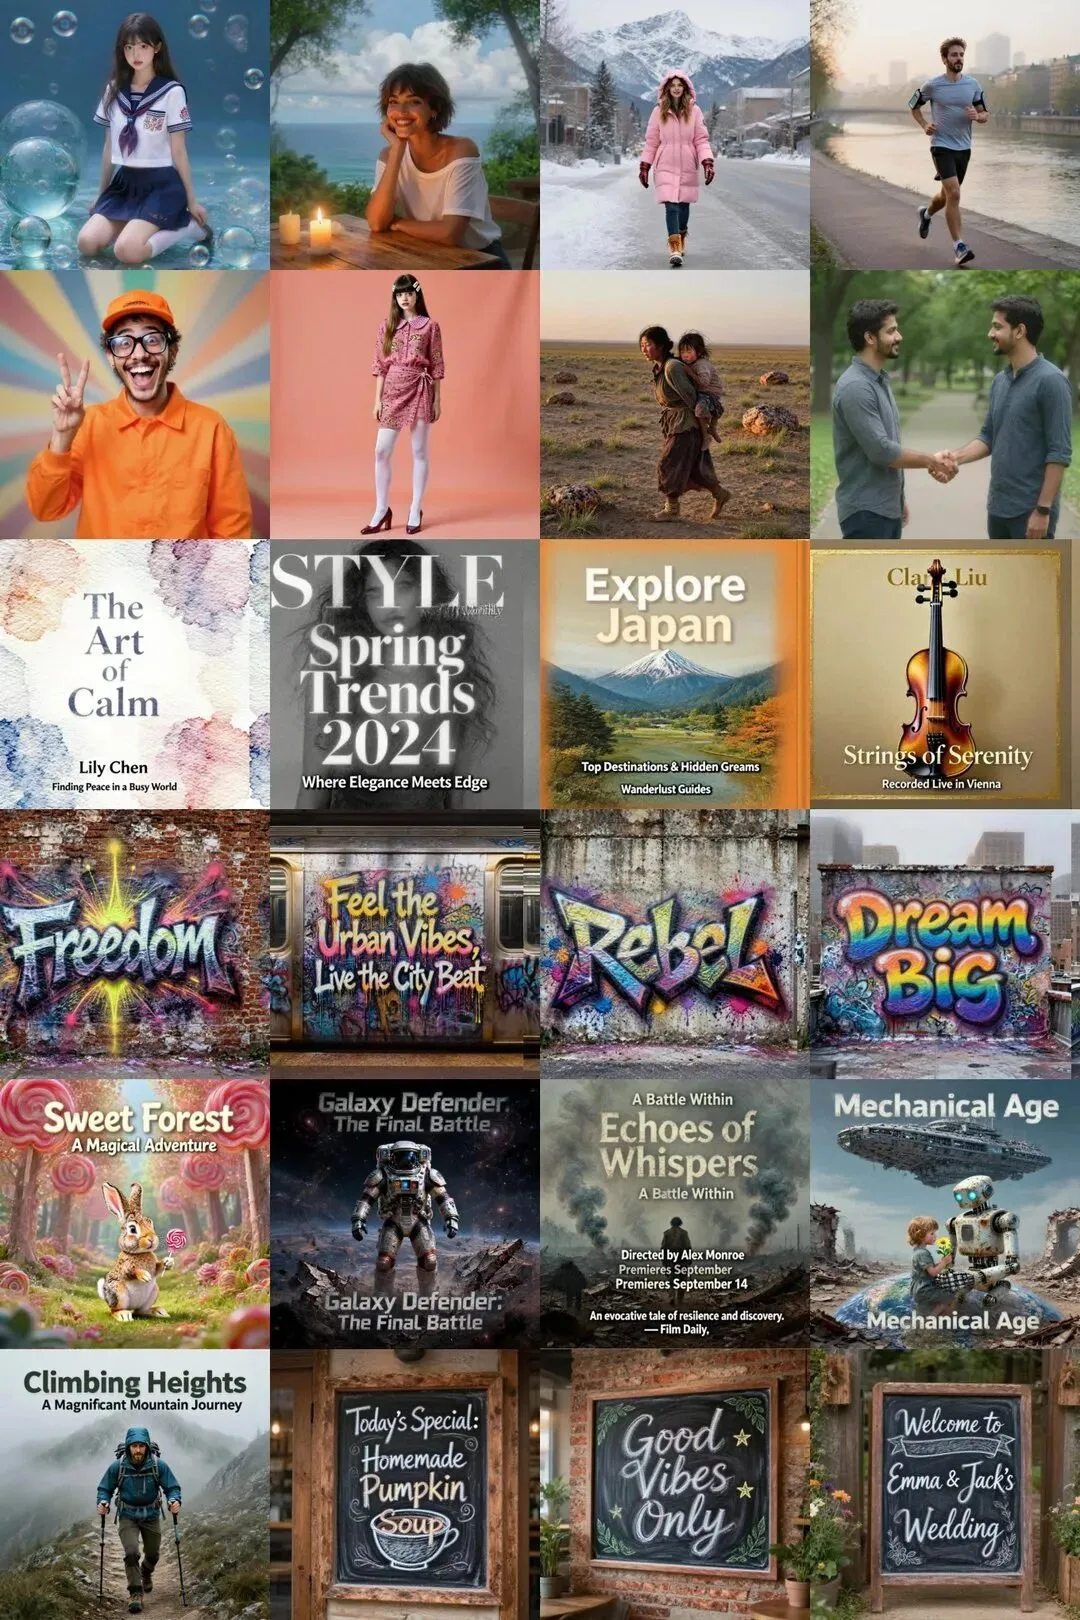
一步与少步文本生成图像(text-to-image)要在很少的修正机会里,把提示词指定的细节都画出来。分布匹配蒸馏(DMD, Distribution Matching Distillation)用分数差把生成分布拉向参考分布;沿用先前工作,这篇用模型内部的「速度分支」估计这个差,从而省掉一个独立的假分数网络。但它进一步问:显式地约束分布的某些矩(moment),能否让这套学到的监督更扎实?
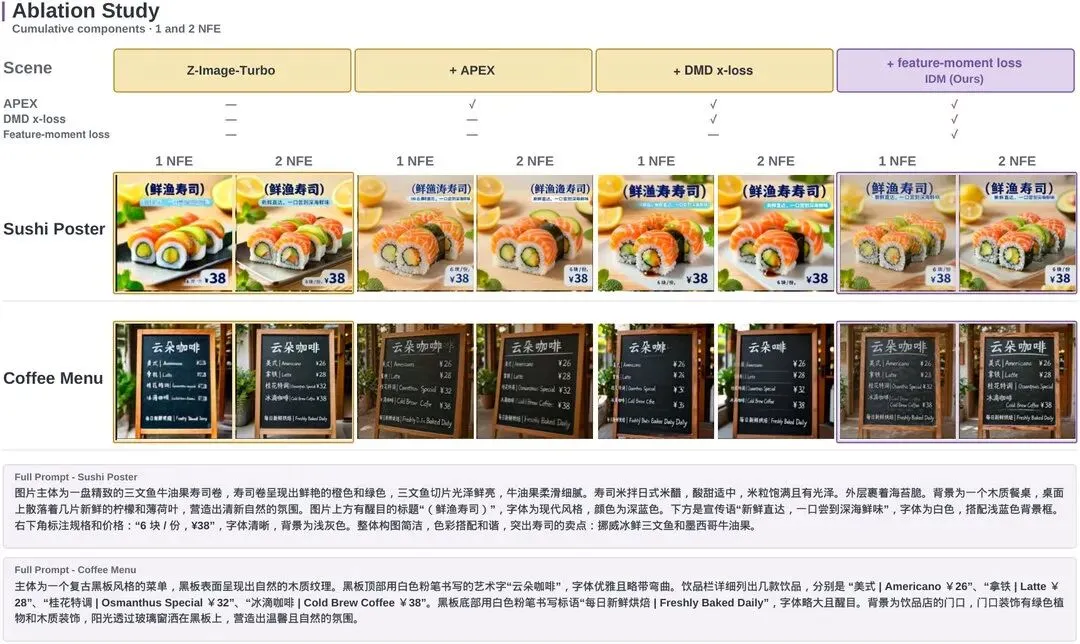
把反向 KL(reverse KL)场分解成「高斯矩分量」和「非高斯残差」两部分,就能找出可以显式约束的统计项。Intrinsic Distribution Matching(IDM)保留了完整的 DMD 修正,同时用生成器自身的指数移动平均(EMA, exponential moving average)副本去匹配特征均值和逐坐标标准差,全程不需要外部特征编码器(例如 DINOv2)。实验在 Z-Image-Turbo 6B 与 Qwen-Image 20B 上做全量微调与低秩适配(LoRA, Low-Rank Adaptation)。
2 次网络评估下,IDM 中英文 LongText-Bench 分别达 94.25% 与 90.20%,是预算内对比方法最高分。控制变量实验显示额外加的矩损失带来提升,且用生成器 EMA 特征做矩匹配在五个指标上与 DINOv2 相当。
办法|保留完整 DMD 修正,额外用生成器自身的 EMA 副本匹配特征均值与逐坐标标准差,不再依赖外部特征编码器。
结果|2 次评估下中文/英文 LongText-Bench 达 94.25% / 90.20%,同为预算内最高;EMA 特征在五个指标上不输 DINOv2。
启示|分布蒸馏里「用什么特征来约束矩」比「要不要约束」更关键,生成器自己就能提供足够好的监督。
原 题|Read, Allocate, Route: Role-Coupled Tokenization for Pixel-Space Generative Transformers
来 源|arXiv:2610.40647 | cs.CV / cs.AI / cs.LG / cs.NE | ICLR | arXiv + HF Daily 双源 | 代码:github.com/JiongfanYang/SpecSlot | 作者:Jiongfan Yang, Weichen Fan 等(5 人)
像素空间生成整流流 Transformer频谱 token 分配
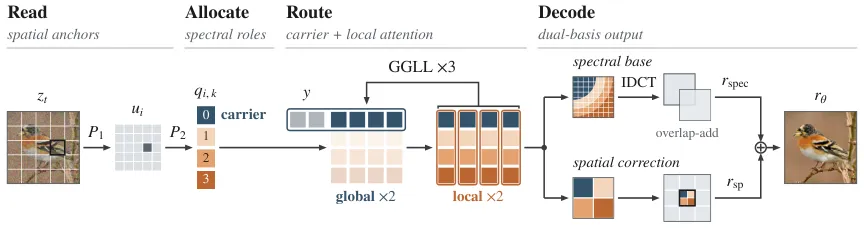
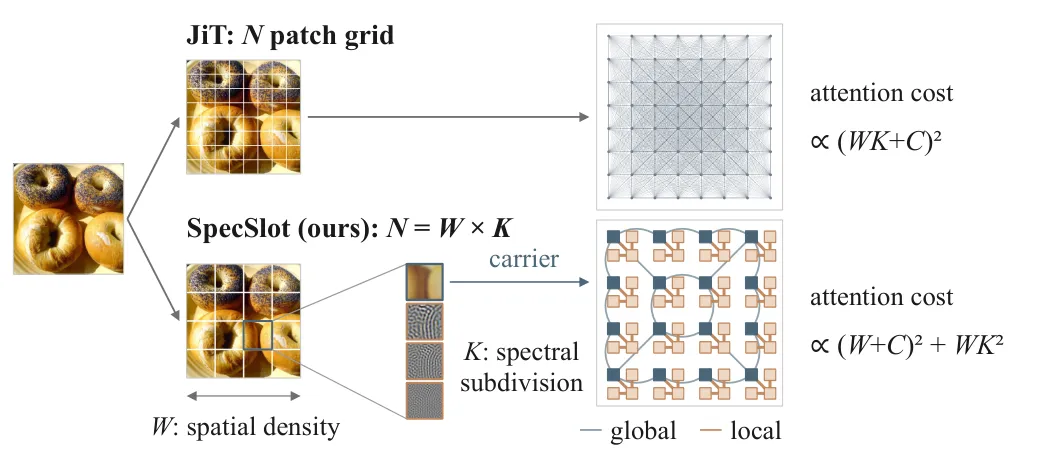
像素空间(pixel-space)生成式 Transformer 通常一块图像 patch 对应一个 token,于是想画更细就得更多 token,全局注意力(global attention)也跟着越来越贵。作者观察到一件反直觉的事:更细的细节并不必然需要更多全局通信——低频结构受益于全局交换,而高频细节可以在局部建模。
基于这个观察,他们提出 SpecSlot,一个像素空间的整流流(rectified flow)Transformer,把「输出细节」和「全局注意力序列长度」解耦。它把每个空间锚点展开成多个槽(slot),每个槽分到一段互不重叠的离散余弦变换(DCT, discrete cosine transform)系数带,于是锚点密度和频谱细分被分开。只有每个锚点里最低频的那个槽参与全局注意力,其余槽只在锚点内部做局部交互。
结果上,在 ImageNet-256 上 SpecSlot 的最终 FID(Frechet Inception Distance)与算力匹配的对照模型相当且收敛更快;在 ImageNet-512 上以少 3.9% 的 FLOPs 把 FID 提升 2.84,距离更强对照仅差 0.69 FID 却省下 38.2% 成本。文生图方向上,SpecSlot 以少 40.6% 的前向成本在 DPG-Bench 上超过 JiT-B/8 达 1.06 分。
办法|把每个空间锚点拆成多个频谱槽,只有最低频槽进全局注意力,其余在局部交互,从而把细节密度与全局序列长度解耦。
结果|ImageNet-512 少 3.9% FLOPs 仍把 FID 提 2.84;文生图以 40.6% 更少前向成本在 DPG-Bench 超 JiT-B/8 达 1.06。
启示|生成模型的「分辨率」和「全局通信量」是两件可以分开优化的事,局部细节不必占用全局注意力预算。
原 题|L3G-World: Real-Time Infinite World Generation with Latent 3D Gaussian Memory
来 源|arXiv:2610.40614 | cs.CV | arXiv + HF Daily 双源 | 代码:github.com/cvlab-kaist/L3G-World | 作者:Jinhyeok Choi, JoungBin Lee 等(8 人)
交互式世界模型3D 高斯记忆实时生成
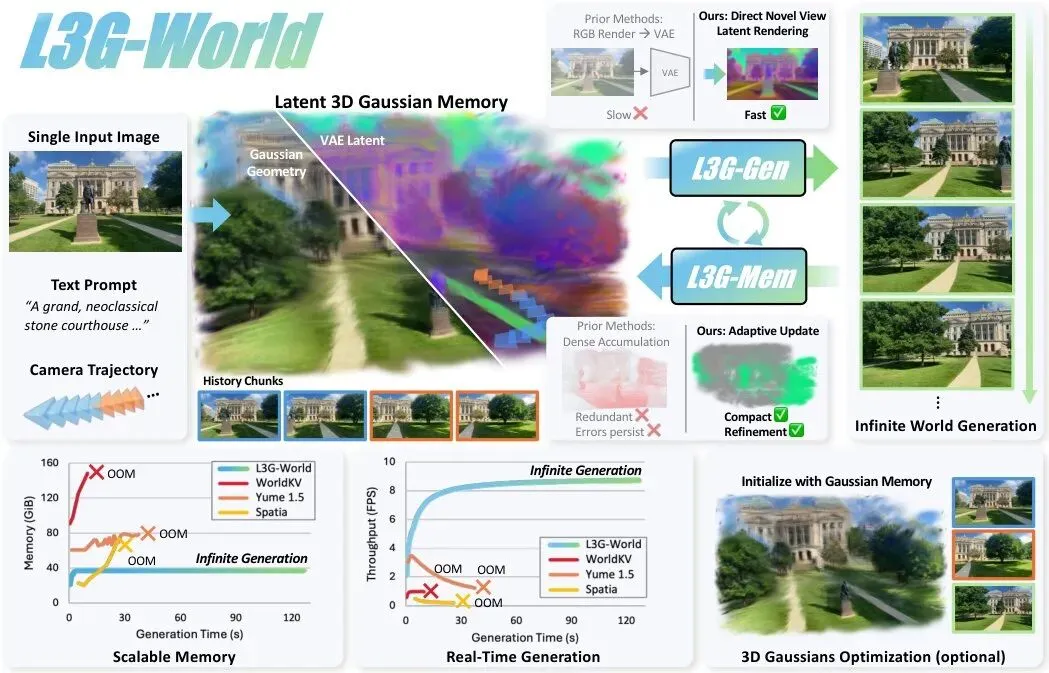
交互式世界模型(world model)按用户动作生成画面,难点在于长时间探索时如何保持空间一致、还要实时。现有方法要么靠时间上下文、要么靠显式 3D 记忆,但两者都随生成流变长而膨胀——记忆跟着视频流长度长,而不是跟着场景大小长。更糟的是,显式 3D 记忆是靠重新编码 RGB 渲染图来条件化潜在视频生成器的,这本身就快不了。
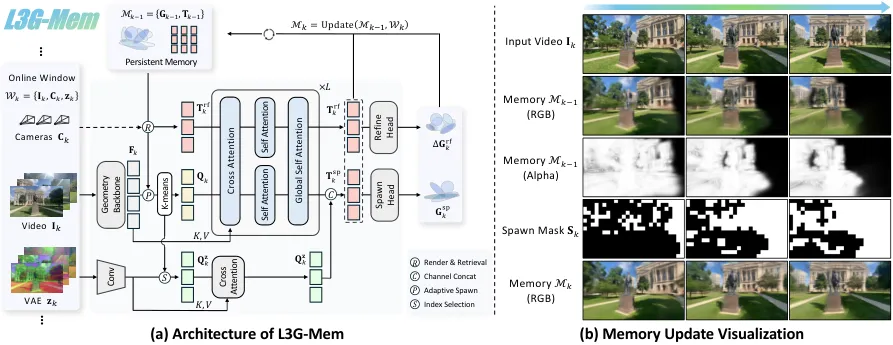
这篇提出潜在 3D 高斯记忆(L3G, Latent 3D Gaussian Memory),把前馈重建的效率与一种紧凑、可快速渲染的场景表示结合起来。在此基础上,L3G-World 让一个记忆更新器和一个视频扩散 Transformer(DiT, Diffusion Transformer)交替自回归地生成空间一致的世界。记忆更新器在新观察到的区域「生出」高斯、并细化已有的高斯,于是记忆是跟着场景范围长,而不是跟着流长。
每个高斯还额外存一个 VAE 潜在特征,记忆可以直接渲染进 DiT 的潜在空间,无需再做 VAE 重编码。实验显示 L3G-World 在生成质量与长程空间一致性上达到当前最优,且相对最高效的已有 3D 记忆基线,3D 基元最多少 38.6 倍、记忆更新快 3.2 倍、记忆渲染快 359 倍,从而以 9 FPS 实现实时世界生成。
办法|用潜在 3D 高斯记忆让记忆随场景范围增长而非随视频流增长,并把 VAE 潜在特征直接存入高斯,跳过重编码。
结果|相对最高效基线,3D 基元少 38.6 倍、记忆更新快 3.2 倍、渲染快 359 倍,实时生成达 9 FPS。
局限|记忆随场景范围线性增长,超大开放场景下的上限与误差累积仍需进一步验证。
原 题|Look Only When Needed: Certificate-Guided Visual Routing for Efficient Diffusion VLMs
来 源|arXiv:2610.36671 | cs.AI / cs.CV | HF Daily 72 赞 | 代码:github.com/hyeon9698/LOWN | 作者:Donghyeon Cho, Joowon Kim 等(4 人)
扩散视觉语言模型高效解码视觉路由
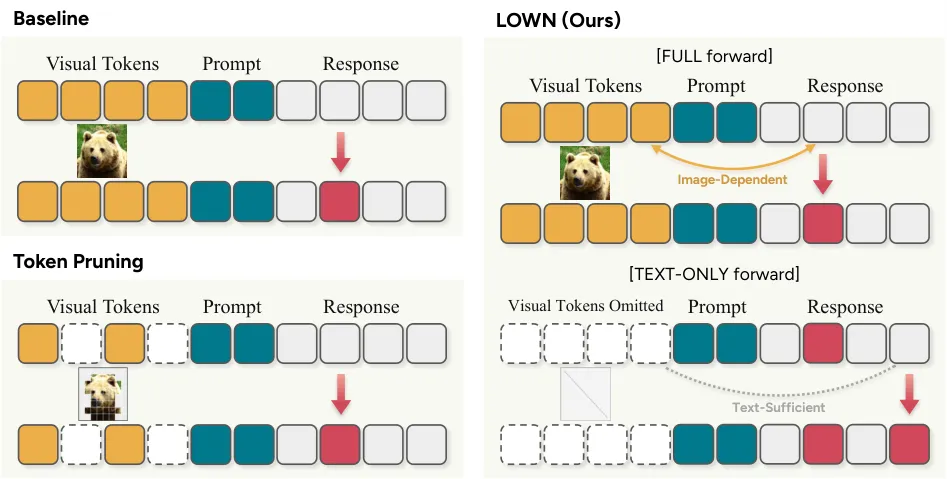
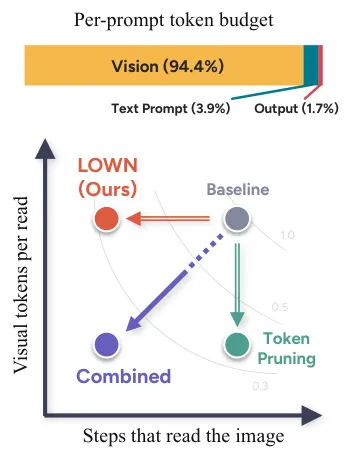
扩散视觉语言模型(DVLM, Diffusion Vision-Language Model)在每个去噪步都把整段输入过一遍。在作者测的基准上,视觉 token 占了输入的 89% 到 97%,意味着大量解码算力花在反复处理同一张图上。视觉 token 剪枝(pruning)能缓解一部分——丢掉部分视觉 token,但被丢的信息就没了,而且剩下的图在每个步还是要处理。
为了量清楚「到底多久才真的需要图」,作者对比了 LLaDA-V 在每个解码步、有图和没图时的预测差异:去掉图只在平均 22.8% 的步改变了被解掩码(unmask)的 token,最少时只有 7.9%。于是他们提出 LOWN,一个解码方法,在每个步决定「要不要处理图、一次解掩多少个 token」。LOWN 先不看图预测掩码 token,只有当这个预测和上一轮「看了图」的预测不一致时才去处理图;一致就证明之前的预测可以复用。
不需要训练、也不需要调阈值,LOWN 在十个基准上保留了 LLaDA-V 99.6% 的得分,却只用了平均 35.3% 的解码 FLOPs。它还能跨 LLaDA 系列 DVLM 通用,和视觉 token 剪枝正交可叠加,并且能在键值缓存(KV cache)下进一步提速。
办法|每个解码步先纯文本预测,仅当与看了图的预测不一致时才处理图,并用一致步数决定一次解掩多少 token。
结果|无训练、无调阈值,保留 99.6% 得分只用 35.3% 解码 FLOPs;可与剪枝叠加、兼容 KV 缓存。
启示|扩散 VLM 的算力浪费主要在每步必看图,按步自适应路由比固定剪枝更省且更保分。
原 题|Glance: The Generator Is Its Own Reranker
来 源|arXiv:2610.40454 | cs.CL / cs.IR | arXiv + HF Daily 双源 | 作者:Adilet Metinov, Chingiz Arziev(2 人)
检索增强生成生成器兼任重排共享预填充
检索增强生成(RAG, Retrieval-Augmented Generation)通常为重排(reranking)和回答各养一个模型,等于把同一个模型在显存里驻留两遍、候选段落也得处理两遍。Glance 想问:能不能让生成器自己来给候选段落打分,省掉这个独立的重排模型?
做法是给生成器加一个轻量的决策适配器(adapter)和指针头(pointer head),从一次共享的预填充(prefill)里给每个候选段落打一个分。短的相关性探针从缓存的上下文里分叉出来,不需要为每个「查询-段落」对单独做预填充。一个常驻的 9B 主干同时承担生成、通用决策和重排,每个决策技能只多约 0.1 GiB 显存。
在 MS MARCO 上微调 39 分钟后,Glance 在 SciFact 上拿到 nDCG@10 0.741、在 NFCorpus 上 0.345,对照 bge-reranker-v2-m3 为 0.721 与 0.326;在 300 道 HotpotQA 题上,它选出的上下文让答案 F1 比交叉编码器选出的高 0.045。扩展性实验里,从一个共享预填充里给最多 200 个候选(4.3 万 token)打分,nDCG@10 比交叉编码器高 0.058。
办法|给生成器加轻量适配器与指针头,从一次共享预填充里给候选段落打分,单主干同时做生成与重排。
结果|SciFact nDCG@10 0.741(对照 0.721)、NFCorpus 0.345(对照 0.326);200 候选时比交叉编码器高 0.058。
局限|目前只评估了两个检索、一个问答数据集与一个主干家族,泛化范围有限;少样本与长文档重排尚未覆盖。