ARTICLE · 1295151
端侧AI工具链原理(09):Runtime、Delegate与异构执行:零拷贝为什么仍然需要同步
本文是端侧 AI 工具链原理第 9 篇。上一篇讨论后端 Code Generation,这一篇把可执行资产放回真实系统:多个处理器如何共享 Buffer、调度子图并保证结果和时序正确。
开篇:没有 memcpy ,不代表没有数据移动
CPU 和 NPU 可以通过共享物理内存访问同一 Buffer ,应用也没有调用memcpy,但数据仍需经过 Cache、NoC、IOMMU 和设备本地存储。生产者完成写入后,消费者还必须看到最新内容。
零拷贝准确含义是“避免额外的软件显式副本”,不是“访问与同步免费”。
一、 Runtime 的核心对象
典型 Runtime 管理:
这些对象共同定义资源生命周期。一个 Buffer 只有在所有异步消费者完成后才能复用或释放。
二、 Delegate 怎样接管子图
LiteRT Delegate 或 ONNX Runtime Execution Provider 通常执行:
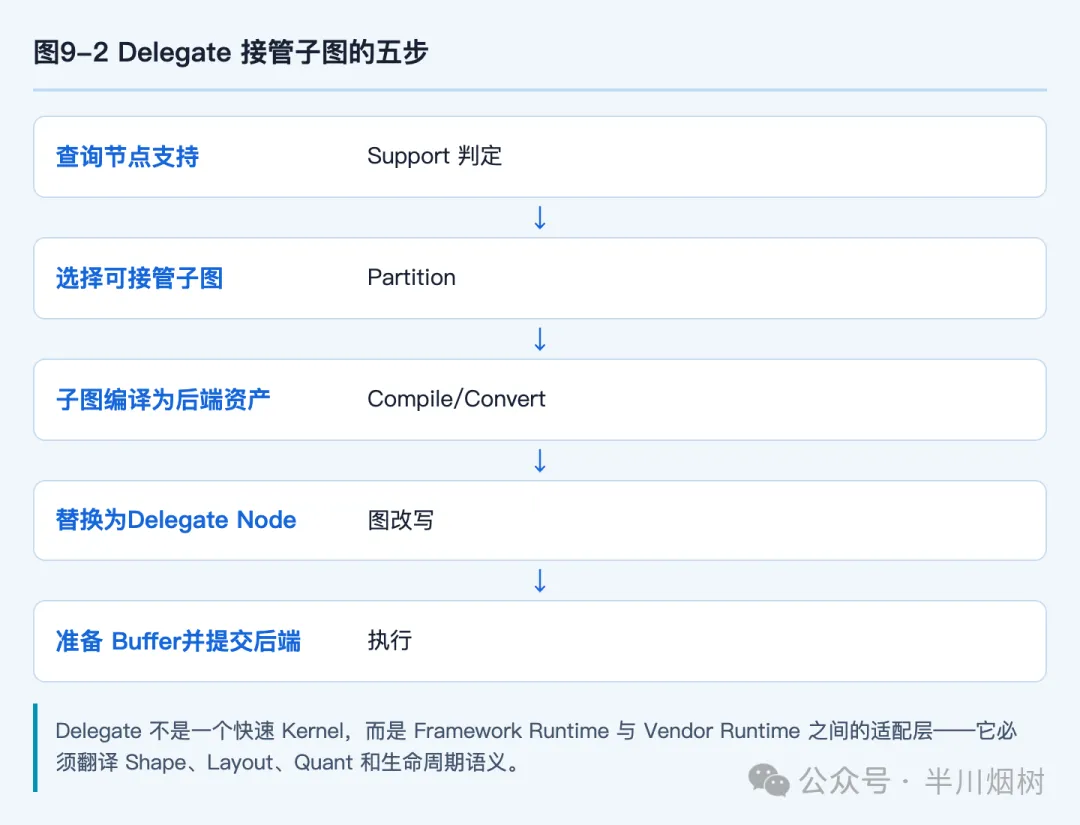
Delegate 不是一个快速 Kernel,而是 Framework Runtime 与 Vendor Runtime 之间的适配层。它必须翻译 Shape、Layout、Quant 和生命周期语义。
三、异构执行的时间线
假设 CPU 预处理、NPU 推理、GPU 后处理:

串行总时延为:
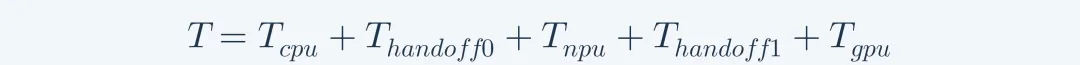
视频流可通过多 Buffer 形成 Pipeline ,让第n帧在 NPU 执行时,第n+1帧 CPU 预处理。但吞吐提高不代表单帧 Latency 下降, Buffer 数量和端到端 Deadline 必须分别计算。
四、同步包含什么
同步可能涉及:
如果 Runtime 使用阻塞等待,CPU 会空转或频繁睡眠唤醒;如果依赖链表达不完整,又可能读到未完成数据。
五、 Buffer 共享的前提
真正可用的零拷贝需要:
只满足“同一物理内存”而 Layout 不同,Runtime 仍可能插入 Reformat Buffer。
六、 Dynamic Shape 由谁负责
Runtime 获取真实输入 Shape 后,可能:
实时产品应避免首次遇到 Shape 时才执行昂贵编译。可在安装、首次启动或后台空闲时预热常用 Bucket。
七、多模型并发与优先级
手机上相机、语音、系统感知和第三方 App 可能同时请求 NPU。Runtime/Driver 需要处理:
单模型 Benchmark 无法代表并发 QoS。高优先级相机任务到来时,低优先级生成式任务是否能在可控粒度暂停,是产品级能力。
八、 Runtime 错误要可恢复
设备超时、Firmware 崩溃、内存不足和资产版本不匹配都可能发生。Runtime 需要定义:
“重启 App 解决”不是量产系统的完整策略。
九、 Runtime 性能应怎样测
分解:
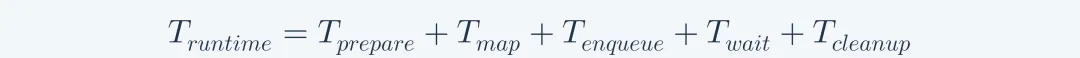
同时记录:
Kernel 很快而 Runtime 开销占比高时,应优化资产缓存、Persistent Mapping 和异步提交。
十、一个三段异构流水案例
设视频任务为CPU预处理2 ms、NPU推理10 ms、GPU后处理4 ms,交接各1 ms。串行单帧 Latency 为:

采用三 Buffer 流水后,理想稳态帧周期由 NPU 阶段决定,接近10 ms;但单帧 Latency 仍约18 ms,并且 Buffer 在三个设备间的生命周期更长。
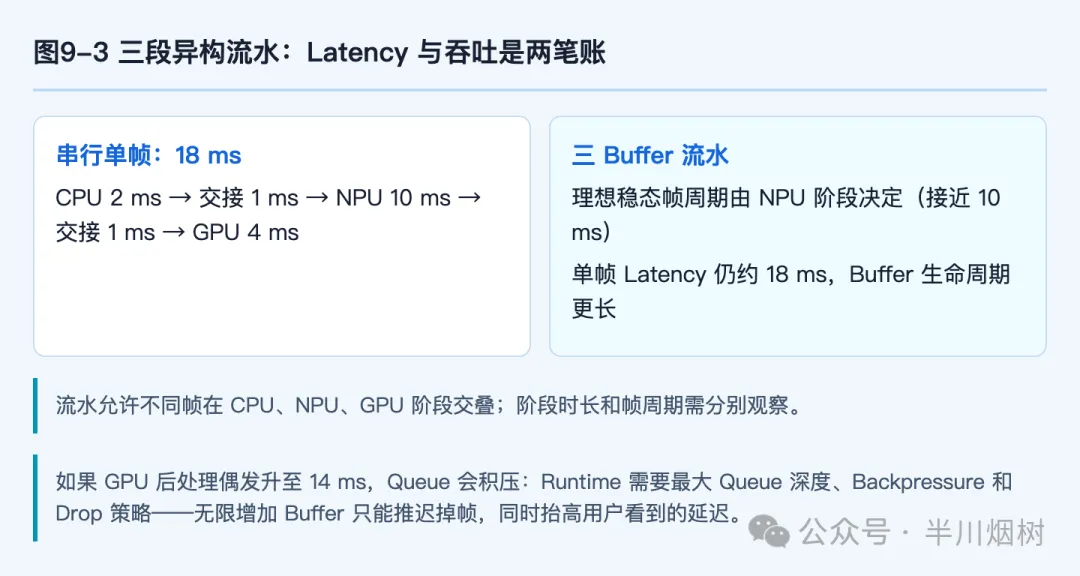
如果 GPU 后处理偶发升至14 ms,Queue 会积压。Runtime 需要设置最大 Queue 深度、 Backpressure 和 Drop 策略。无限增加 Buffer 只能推迟掉帧,同时抬高用户看到的延迟。
对 Queue 深度Q,最坏排队增加近似为:

所以吞吐、Latency 和 Buffer 数量必须联合验收。
十一、多模型调度的基本策略
Runtime 可以使用 FIFO、Priority、Deadline-aware 或 Fair Share。端侧通常需要混合策略:系统相机优先,Always-on任务保留最低服务,第三方长任务限制时间片。
调度决策至少考虑:
过细抢占提高实时性,却增加 Context 保存成本;只在 Graph 边界抢占简单,但一个大 Graph 可能阻塞高优先级任务。硬件和 Compiler 应提供可控的 Preemption Point。
十二、零拷贝的验证方法
不能根据 API 名称判断零拷贝,应通过四种证据:
即使满足四点, Cache Clean/Invalidate 和 IOMMU 映射仍可能存在。报告应写“零显式副本”或“共享物理 Buffer”,而不是笼统写“零数据移动”。
十三、 Runtime 资产缓存怎样治理
缓存 Context 和 Prepared Graph 可以降低首帧,但需要 Cache Key :

Key 缺少 Runtime 或 Shape 会加载不兼容资产。缓存还需容量上限、LRU/优先级、完整性校验、OTA 失效和低内存清理策略。
量产问题中应能区分“命中旧缓存”“重新编译”“资产损坏回退”,否则首帧抖动难以定位。
十四、一次设备超时的恢复序列
假设 NPU 请求超过 Watchdog。Runtime不应立刻释放所有输入 Buffer,因为设备可能仍在访问。安全流程通常包括:
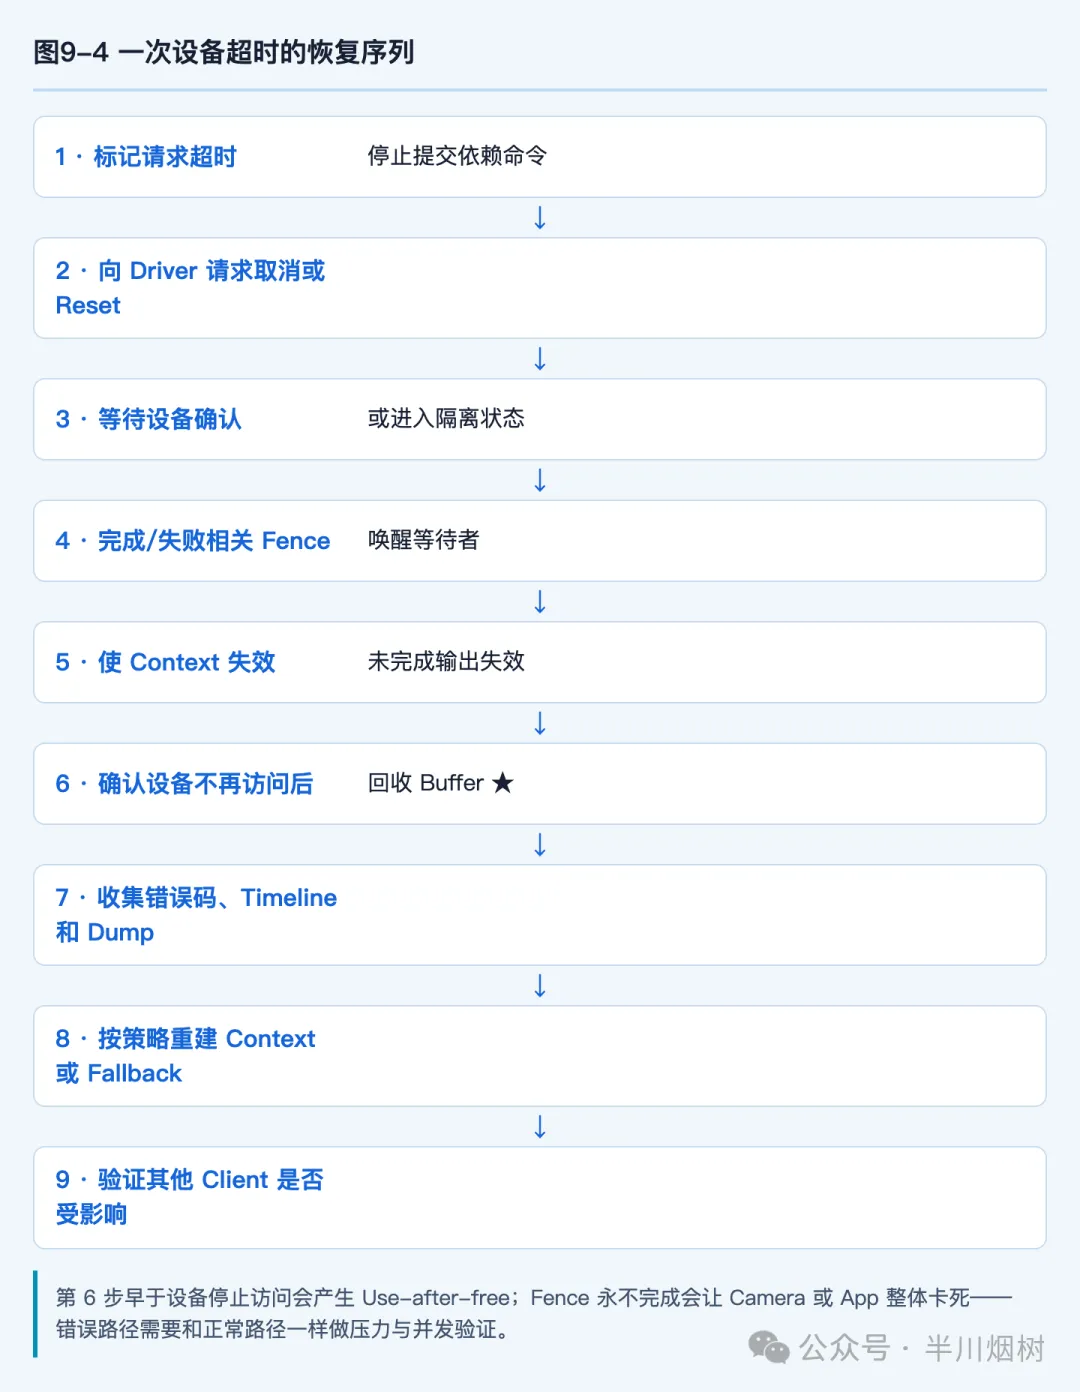
如果第 6 步早于设备停止访问,可能产生 Use-after-free;如果 Fence 永不完成,Camera 或 App 会整体卡死。错误路径需要和正常路径一样做压力与并发验证。
十五、 Runtime 接口的可测试性
应提供故障注入:分配失败、映射失败、Compile 超时、Execute 超时、设备 Reset、错误输出和 Fence 丢失。每种故障检查错误码、资源计数、后续请求和 Fallback。
Runtime 还应导出 Context 数、注册 Buffer 数、Queue 深度和最后错误,使长期资源泄漏能被自动检测,而不是等进程 OOM 后再分析。
十六、 Framework Runtime 升级时需要验证什么
Delegate 接口、Tensor Ownership、Dynamic Shape 和线程模型都可能随 Framework 版本变化。升级 LiteRT 或 ONNX Runtime 后,即使 Vendor Backend 不变,也要重新验证分区、输入输出绑定、并发、取消和 Profiler 关联。
特别关注“接管成功但边界变化”: Framework 的新 Canonicalization 可能把原来一个连续子图拆成多段,或插入新的 Cast。版本回归应对比 Delegate 节点数量、每段原始节点范围、边界 Tensor 和端到端 Timeline,而不只检查最终输出。
十七、 Android 共享 Buffer 的完整生命周期
以 Camera 产生 AHardwareBuffer、NPU 消费、GPU 显示为例:
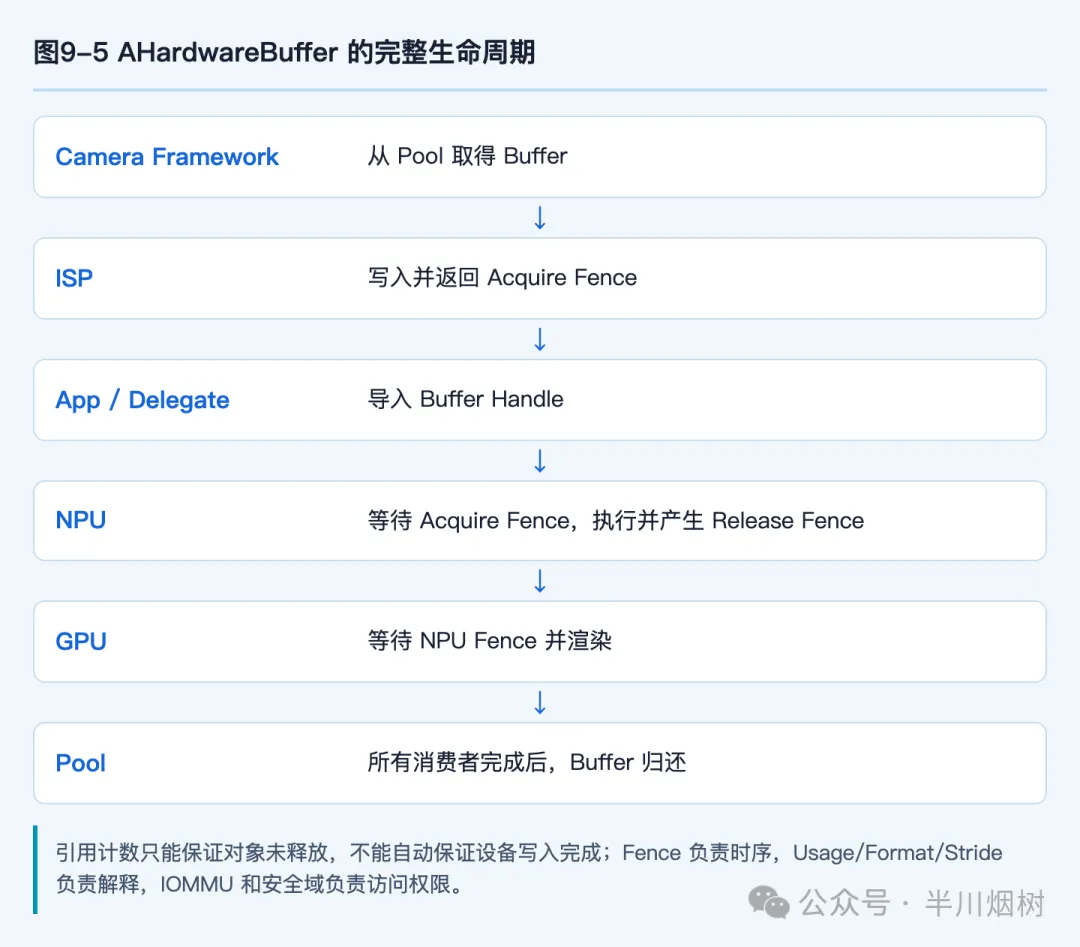
每一步都包含 Ownership。AHardwareBuffer 引用计数只能保证对象未释放,不能自动保证设备写入完成。Fence 负责时序,Usage/Format/Stride 负责解释, IOMMU 和安全域负责访问权限。
如果 NPU 不支持 Camera 原始 Stride,Delegate 可能创建内部连续 Buffer。此时 API 仍接收 AHardwareBuffer,却不是真正零副本。Profiler 和内存统计必须能看见这次转换。
十八、线程模型和回调为什么影响尾延迟
Framework Runtime、Delegate、Vendor Runtime 和 Driver 可能各有 Worker Thread。若回调在持有全局锁时执行,或所有模型共享单一提交线程,小任务会被大任务阻塞。
需要定义:
尾延迟测试应包含多 Client、CPU 负载和回调耗时。单线程 Microbenchmark 无法暴露锁竞争和优先级反转。
十九、 Context 切换与模型常驻的取舍
多个模型并发时,将全部权重常驻可降低切换,却可能超过内存;按请求加载节省内存,却增加 Load 和功耗状态抖动。
可定义模型i的常驻价值:
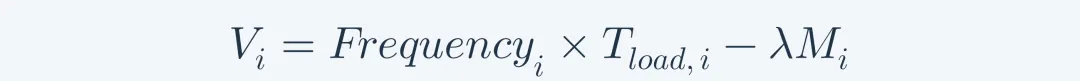
高频小模型优先常驻,低频大模型按需加载。 Always-on 语音、相机和 LLM 的策略不同。 Runtime 还需避免两个 Client 各自加载相同模型副本,可在安全允许时共享只读权重或 Context 资产。
二十、 Runtime 安全与多租户
NPU 执行第三方模型时,Buffer 地址、Command 和模型资产都属于不可信输入。Driver/Firmware 应验证地址范围、Command 长度、权限和超时,Context 之间隔离内存与错误。
Profiling 也可能泄露其他 Client 的时序和模型信息,需要权限控制。量产 Runtime 不能为了调试方便向所有 App 开放底层 Counter 或任意 Op Package 加载。
错误恢复粒度应区分 Request、Context、Process 和 Device。一个第三方 Context 失败,不应无条件 Reset 系统相机正在使用的设备。
二十一、 Runtime 验收矩阵
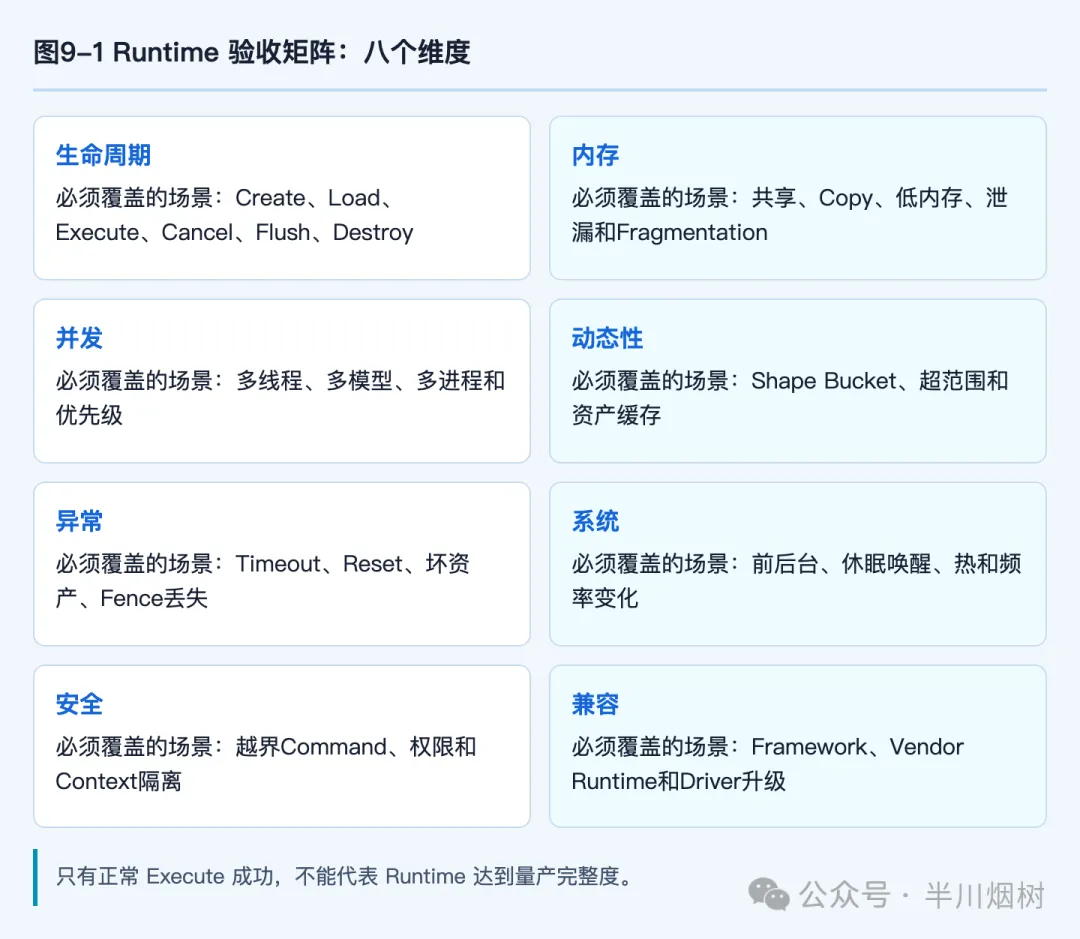
只有正常 Execute 成功,不能代表 Runtime 达到量产完整度。
二十二、一次间歇性超时怎样建立证据链
假设相机模型每万帧出现一次80 ms超时,平均时延仍只有12 ms。如果只保留 API 起止时间,团队只能在 Framework、Runtime、Driver 和 Firmware 之间猜测。
正确做法是为请求分配 Correlation ID,并贯穿 Delegate 提交、Buffer 导入、 Fence 等待、Command 入队、设备执行、中断和 Callback。超时样本至少导出:各阶段时间戳、等待对象、队列深度、设备频率、当前并发 Context、Reset 记录以及关联 Buffer 的 Ownership。
若证据显示60 ms消耗在 Acquire Fence,NPU 本身可能无责,问题应回到上游 ISP 或 Buffer Pool ;若 Command 已入队却长期未开始,需要检查优先级、队列阻塞和设备电源状态;若设备执行完成但 Callback 迟到,则检查 Worker Thread、锁竞争和 CPU 调度。相同的“Runtime 超时”表象,对应完全不同的修复路径。
量产版本可以使用低开销环形 Trace,仅在错误发生时冻结前后窗口。这样既避免持续全量 Profiling 影响性能,又能为低概率故障保留跨层因果链。一个可恢复 Runtime 还应在报告超时后明确资产是否仍可复用、 Context 是否污染、设备是否需要 Reset ,以及在途请求将返回什么错误。
工程检查清单
结尾: Runtime 把静态计划变成系统行为
编译器决定理想执行计划, Runtime 负责在动态 Shape 、并发、功耗和错误中兑现它。零拷贝、异步和多设备不是 API 标签,而是一组内存与同步契约。
下一篇是本辑收官:如何用 Profiling 、部署 CI 和资产治理,把一次成功 Demo 变成可复现、可升级的工程交付。
参考资料
参考链接
[1] Google AI Edge: LiteRT Delegates: https://ai.google.dev/edge/litert/performance/delegates
[2] ONNX Runtime: Execution Providers: https://onnxruntime.ai/docs/execution-providers/
[3] Android Hardware Buffer: https://developer.android.com/ndk/reference/group/a-hardware-buffer
--------------------------------
我是半川
一个偏爱在芯片底层与光影算法里死磕细节的工程师