ARTICLE · 1295482
0.8B 的小米文档模型开源了:发票截图扔进去,出来是表格,商用也不收钱
0.8B 的小米文档模型开源了:发票截图扔进去,出来是表格,商用也不收钱
权重、推理代码、MCP 服务一起放出来,协议 Apache-2.0,笔记本就能跑。
小米 10 月 30 日开源 Xiaomi-OCR-0:0.8B、Apache-2.0、商用免费,整页转 Markdown、票据抽 JSON、图文问答一个模型全包。
本 期 白 拿
手机相册里攒着一堆发票照片、工资条截图、PDF 合同,想变成能编辑的表格,以前只有两条路:开会员,或者手动敲。现在多了第三条——小米开源了个小模型,下到本机跑,一分钱不花。
0.8B
参数量,笔记本能跑
96.83
OmniDocBench v1.6,1B 以下第一
0 元
权重免费下,商用不收授权费
发生了什么
WHAT HAPPENED
小米在 10 月 30 日把 Xiaomi-OCR-0 正式开源。权重、推理代码、浏览器 demo、MCP 服务、Agent Skill 一起放出来,协议是 Apache-2.0:个人用、公司用、改完再卖,都不用付授权费。
说清楚一点,技术报告和权重其实 9 月 30 日就挂出来了,小米这次是正式对外宣布,顺手把这套能力接进了手机上的「超级小爱」。
底座是 Qwen3.5-0.8B,喂了大约 1.7 亿条 OCR 样本。分数不虚:Real5-OmniDocBench 95.24 排第一,OmniDocBench v1.6 拿到 96.83,总榜第二、1B 以下第一,公式识别 97.84,表格识别 92.27。
喂进去的东西不用先转换:图片和 PDF 都能直接丢,demo 里已经把 pdfium 接好了,不用自己装解析库。
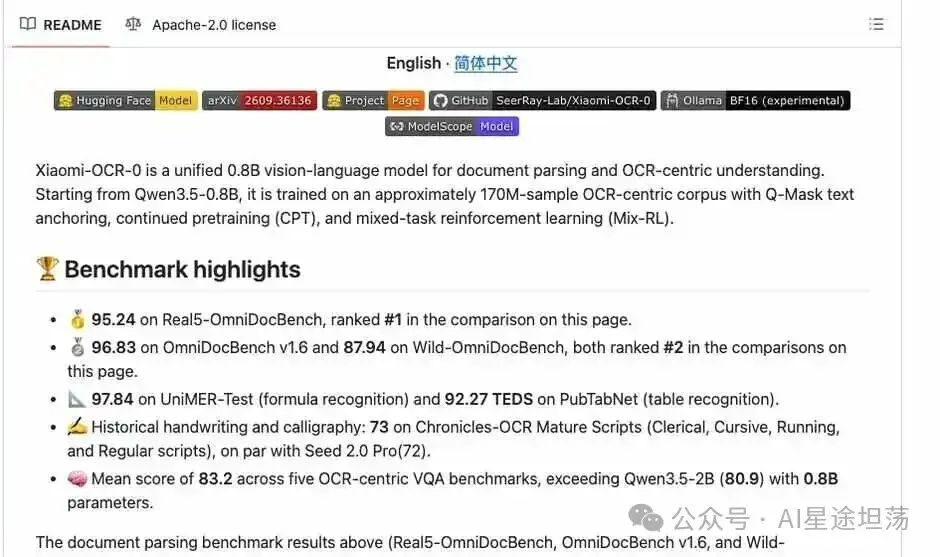
// 官方仓库 README 首屏:Apache-2.0 协议与六项基准分数,2026-11-02 实抓
能干什么,干不了什么
GOOD / BAD
真能白拿的
整页文档按阅读顺序转 Markdown,表格转 HTML、公式转 LaTeX。
给一份字段清单,票据、卡证直接输出 JSON。
对着账单截图问「总金额多少」,它答得上来。
别忽略的
官方论文自建测试集里,发票字段抽取 65%,低于 Qwen3.5-2B 的 77%。
榜单成绩走两阶段流程,得另装 PP-DocLayoutV3 做版面检测。
只认中英文;没 GPU 光靠 CPU 会很慢。
谁最该用:天天报销贴票的、要把扫描合同归档的、爱把 PDF 论文丢进知识库的。一次几十上百页,本地跑比一页页传网页版省事,票据也不用外流。
白拿清单
CHECKLIST
项目
内容
备注
许可
Apache-2.0
商用免费,可闭源分发
体积
873.44M 参数,权重 1.77GB
GitHub、魔搭、HF 都能下
附带
MCP + Skill + demo
不用自己写胶水
花费
0 元
本地推理,只剩电费
三个坑
PITFALLS
! 先看这三条
社区做的 GGUF 量化和 Ollama 镜像都不是官方评测口径,精度会掉,拿来试手可以,别直接上生产。
区域解析模式要另装 PaddlePaddle、PaddleX,环境比整页模式重得多,普通用户先用整页。
手写、书法、古籍这类不规整版面必须走整页模式,切成区域反而丢上下文。
怎么上手
QUICK START
下权重
魔搭搜 SeerRay-Lab/Xiaomi-OCR-0,国内直连不用翻墙;HF 打不开就走魔搭。
起服务
SGLang 或 vLLM 一行命令,README 里直接抄;想先试试手感就用社区 Ollama 镜像。
开 demo
跑 python demo/server.py --port 8787,浏览器里拖图进去就行。
懒人版:把 README 里那句 Read and execute SKILL.md 丢给 WorkBuddy,让它装环境、拉权重、配好 MCP,你只管拖图。
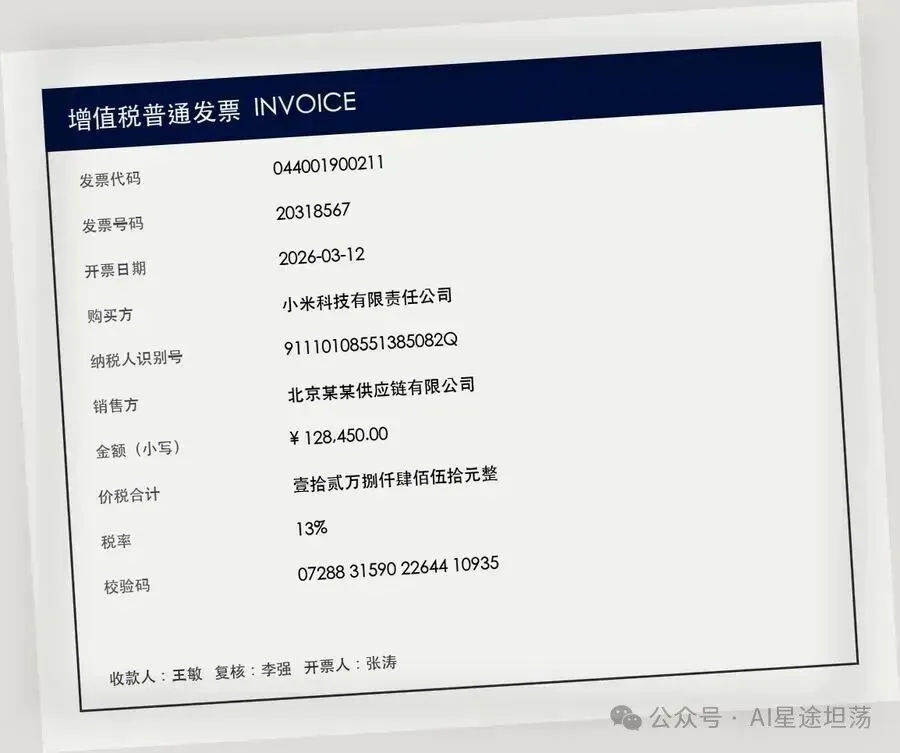
// 官方 demo 的票据样例:这类票面,模型直接输出 JSON 字段
CONCLUSION
免费的东西现在不缺,缺的是能拿来干活的。0.8B 跑在自己机器上,票据、截图、合同不出本地,这才是它比在线 OCR 值钱的地方。
AI星途坦荡
只写能免费薅的 AI 羊毛。数据来自官方仓库、官方模型页与论文,抓取时间 2026-11-02。