ARTICLE · 1300002
OpenAI 那份 34 页 PDF:第一条建议和 Anthropic 一模一样,后面全不一样
AI 工程 · 官方手册 · 深度拆解
OpenAI 那份 34 页 PDF:第一条建议和 Anthropic 一模一样,后面全不一样
OpenAI 发过一份官方手册《A Practical Guide to Building Agents》,34 页 PDF,写给第一次做 Agent 的产品与工程团队——不是论文,是操作手册,带代码、带清单、带护栏配置。上一篇拆了 Anthropic 那份,这一篇把 OpenAI 这份拆完,再做一件更有意思的事:把两份摆在一起对读。结论先剧透:第一条建议一字不差地撞车,后面的分岔,暴露了两家对“Agent 该怎么活下来”完全不同的理解。
先给结论
两家撞车的三条共识,比任何分歧都值钱
共识一:接了 LLM 不等于就是 Agent。OpenAI 的定义只有一句:“Agents are systems that independently accomplish tasks on your behalf.”紧接着补了一刀:“接入了 LLM 但不用它控制工作流执行的应用——想想简单的聊天机器人、单轮 LLM、情感分类器——不是 Agent。”Anthropic 那篇开篇也在做同样的事:把伪 Agent 从队列里请出去。两家都在 2024 年底到 2025 年初写下了同一个判断:这个赛道最大的浪费,是给不需要自主性的任务配了自主性。
共识二:先把一个 Agent 做到最大,再谈拆分。OpenAI 的原话是 “maximize a single agent’s capabilities first”——多 Agent 带来直觉上的概念分离,但也带来额外的复杂度和开销,“往往一个带工具的单 Agent 就够了”。Anthropic 那边是“从最简方案起步,只在撑不住时加复杂度”。措辞不同,结论同构:复杂度是负债,不是勋章。
共识三:护栏不是可选项。OpenAI 用了一整章讲 guardrails,并把话说死:“护栏是任何 LLM 部署的关键组件,但必须与严格的鉴权、访问控制和标准软件安全措施配套。”Anthropic 那篇也在结尾要求沙箱测试加护栏。两家的工程直觉一致:Agent 的自主性每高一格,失控的代价就贵一档。
定义与判定
三个零件,两条硬标准
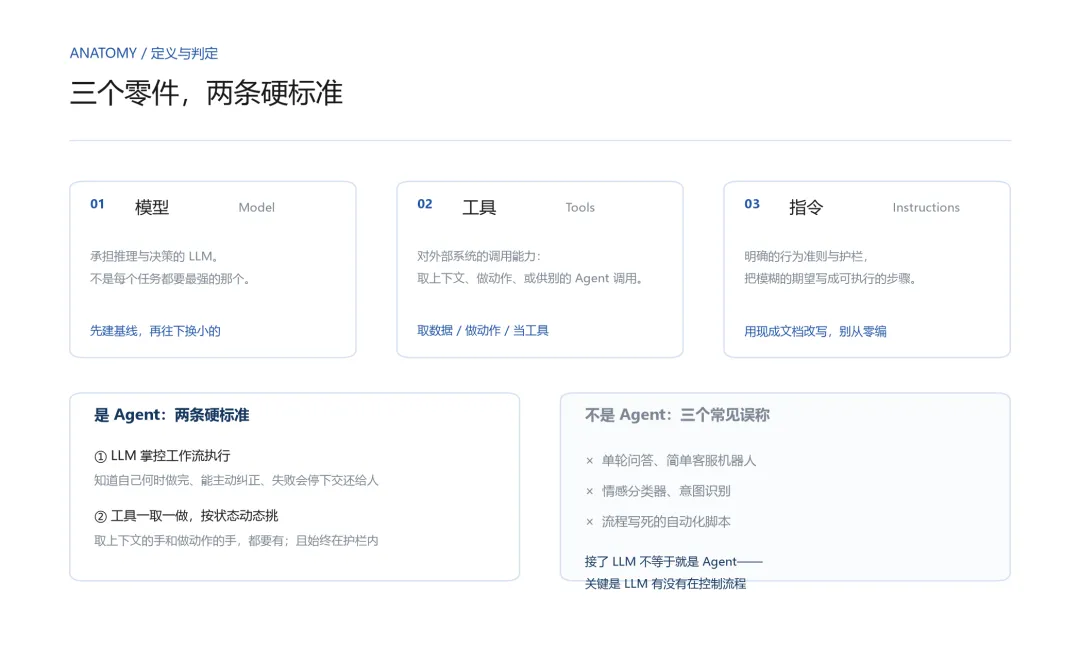
▲ OpenAI 给的“最小 Agent”:模型、工具、指令,缺一不可
OpenAI 给的最小结构朴素到近乎简陋:模型(推理与决策)、工具(对外部系统取数据、做动作)、指令(行为准则)。用他们的 Agents SDK 写出来就是几行代码。真正有信息量的是判定标准——满足两条才算 Agent:LLM 在掌控工作流执行(知道自己何时做完、能主动纠错、失败会停下把控制权交还给人),以及工具一取一做、按当前状态动态挑选,且始终在护栏之内。
什么时候才值得做?OpenAI 圈了三类“传统自动化一直啃不动”的流程:复杂决策(需要细致判断、例外处理、上下文敏感,比如客服退款审批);难维护的规则(规则集膨胀到更新成本高、易出错,比如供应商安全审查);重度依赖非结构化数据(读自然语言、抽文档含义、和人对话,比如家财险理赔)。书里那个比喻值得抄下来:传统规则引擎像一张核对清单,LLM Agent 更像一位资深调查员——评估上下文、识别微妙模式,在没有踩中任何明文规则时也能发现可疑交易。但每一条的前面都有一句同样的提醒:“先验证你的场景确实满足这些标准。否则,确定性方案就够了。”
三块地基
选模型、配工具、写指令,各有一条暗线
选模型的暗线是“先贵后省”。OpenAI 的三步法:先用最强的模型跑通所有任务,建立性能基线;再逐个换成小模型,看哪里还能达标。顺序反了就会过早封顶——你永远不知道是模型不行还是方案不行。我的点评:这是整份手册里最容易被忽略、回报却最高的建议,尤其配上“意图分类用小模型、退款审批用大模型”的混搭——很多团队的账单能砍一半。
配工具的暗线是“三类分清”。取数(Data):查数据库、读 PDF、搜网页;做动作(Action):发消息、改记录、转人工;编排(Orchestration):Agent 本身可以作为别的 Agent 的工具。没有 API 的老系统,用 computer-use 模型直接操作界面。工具要求标准化定义、文档齐全、可复用——工具一多就要考虑拆 Agent 了,伏笔在下一节。
写指令的暗线是“别从零编”。四条最佳实践:用现成的操作手册、客服脚本、知识库文章改写成 Agent 例程;把密集文档拆成更小的清晰步骤;每一步都对应一个具体动作(甚至写明对用户说的话);把边界情况写成条件分支。最实用的一招藏在中间:用 o1 这类推理模型,把帮助中心文档自动转写成编号指令清单——原文连提示词都给了。存量文档就是你的指令库,这是个被低估的工作流。
编排谱系
三种编排,升级要付代价
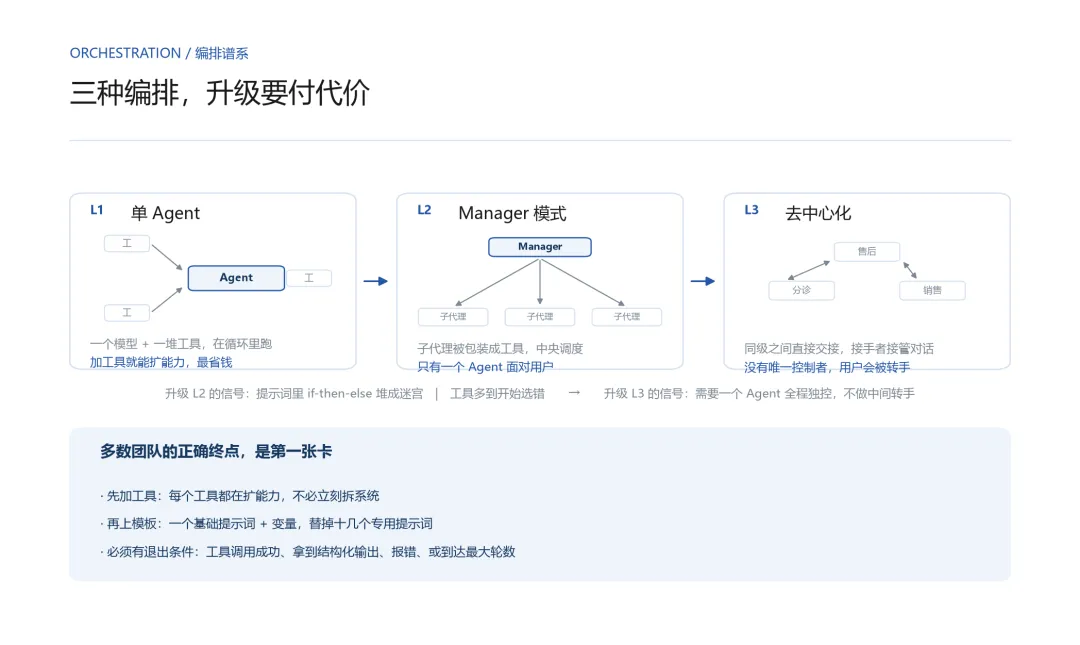
▲ 单 Agent → Manager → 去中心化,每一级升级都有明确的触发信号
单 Agent 的本质是一个 while 循环。OpenAI 把 “run” 定义为核心概念:循环执行,直到触发退出条件——调用了最终输出工具、模型不再调工具直接回复、报错、或到达最大轮数。管理复杂度未必需要拆 Agent:用一个基础提示词加变量(用户名、会员年限、历史投诉类别)的模板,就能替掉一堆专用提示词,维护和评估都简单得多。
什么时候必须拆?两个信号。一是复杂逻辑:提示词里 if-then-else 分支堆到模板都撑不住;二是工具过载。后者有个反直觉的数据:“问题不在于工具的数量,而在于它们的相似与重叠。有的实现管着 15 个以上界限清晰的工具运转良好,有的不到 10 个重叠工具就崩了。”先试着把工具描述写清楚——不行,再拆。
多 Agent 只有两种广谱形态:Manager 模式——子代理被包装成工具(agents as tools),中央调度,只有它面对用户,适合需要统一体验的场景;去中心化模式——同级 Agent 之间直接 handoff,交接时连对话状态一起转移,适合分诊类场景,比如客服系统里“分诊 → 售后/销售/订单”各管一段。附录里还有一段值得圈出来:声明式框架要求预先画好每个分支和循环的图,直观但工作流一复杂就笨重;OpenAI 选了代码优先(code-first)——用熟悉的编程结构直接写逻辑,不必预先定义整张图。这其实是对某个知名编排框架的含蓄回击。
护栏章节
这是 Anthropic 那篇没有的:五层滤网
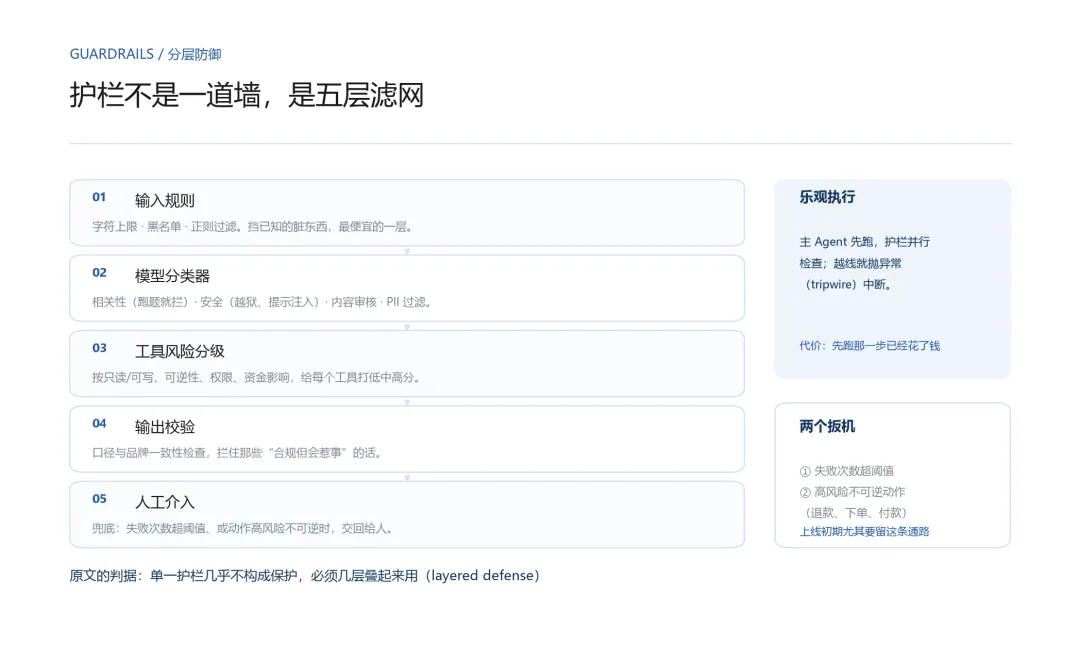
▲ 五层滤网从输入拦到人工兜底, optimism 是执行策略,tripwire 是中断机制
OpenAI 把护栏讲成了分层防御:输入规则(字符上限、黑名单、正则——最便宜的一层)→ 模型分类器(相关性:跑题就拦;安全性:越狱与提示注入;内容审核;PII 过滤)→ 工具风险分级 → 输出校验(品牌口径)→ 人工介入兜底。原文的判据很直白:“单一护栏几乎不可能提供足够保护,多个专门化的护栏叠在一起,才造得出更韧的 Agent。”建立次序也有讲究:先覆盖数据隐私与内容安全,再用真实边界情况补,最后在安全与体验之间反复调。
两个设计细节很见功力。一是给工具打风险分:按只读还是可写、可不可逆、需要什么权限、资金影响多大,分成低中高三档,高风险动作在执行前强制暂停检查或升级人工。二是“乐观执行”:主 Agent 先跑,护栏并行检查,越线就抛异常中断(tripwire)——代价是越线那一步的钱已经花了,但换来的是不阻塞正常请求。工程上的取舍写得很诚实。
人工介入的两个扳机值得抄进每一份需求文档:失败次数超阈值(多次尝试仍读不懂用户意图,升级人工);高风险动作(“取消订单、大额退款、付款——在可靠性建立信心之前,必须有人盯着”)。原文还点了一句:人工介入不是失败,它是上线初期发现缺陷、积累评估数据的主通路。
两篇对读
同一个问题,两种活法
把两份官方文档并排放,有意思的地方才刚开始。第一条建议撞车——别过度工程化、先单 Agent、复杂度是负债——这不难理解,两边都是从大量客户部署里熬出来的教训,教训总是相似的。真正 revealing 的是分岔:撞车之后,两家的笔墨花在了完全不同的地方。
Anthropic 关心“该不该做”与“做成什么形状”。它的篇幅给了工作流光谱、五种可组合模式、工具的 ACI 设计——全是设计期的问题:这个任务该用什么结构?工具该长什么样?OpenAI 关心“怎么活着上线”。它的篇幅给了编排升级路径、七类护栏、tripwire、人工介入扳机——全是运行期的问题:出了事怎么拦?谁来接盘?什么时候必须停下来叫人?
所以这两份不是竞品,是上下游。用 Anthropic 那篇决定“要不要做、做多大”,用 OpenAI 这份决定“怎么上线、出了事怎么办”。只读前者的团队,会做出优雅但脆弱的系统;只读后者的团队,会把一个不该 Agent 化的任务做得武装到牙齿。我的判断:设计期抄 Anthropic 的光谱,上线前过一遍 OpenAI 的护栏清单——两份加起来,才算把 2024—2025 这波 Agent 工程化的共识读全了。
带走这一页
上线前,按顺序过这七问
OpenAI 这份手册,压缩成七问① 这个流程,真的属于“复杂决策 / 规则难维护 / 非结构化数据”三类之一吗?不属,用确定性方案。② 模型选型顺序对吗?先用最强模型建基线,再往下换小的省成本。③ 工具是不是分清了“取数据、做动作、当工具”三类?重叠的工具先改描述,别急着拆 Agent。④ 指令是拿现成文档改的吗?还是凭空编的?⑤ 退出条件写了吗?结构化输出、报错、最大轮数,至少占一样。⑥ 护栏叠了几层?规则、分类器、工具分级、输出校验——一层都不算防御。⑦ 人工介入的扳机装了吗?失败阈值和高风险动作,是底线不是可选项。
最后是结语里最值得留下的一句:“通往成功部署的路,不是 all-or-nothing。从小处开始,用真实用户验证,再逐步长出能力。”——两家的文档,一句开场一句收尾,说的其实是同一件事:Agent 工程的第一美德,是克制。
来源:OpenAI《A Practical Guide to Building Agents》官方 PDF(34 页);Anthropic《Building Effective Agents》(2024-12-19)。英文引句为原文摘录,中文为本文译写。两篇对读与分析部分为作者观点,仅供学习交流,不构成技术或投资建议。