ARTICLE · 1317295
给 AI 编程工具加跨会话记忆:claude-mem 实测,5 项决定两次找回,但「全程免费」没成立
HANDS-ON · 本机实测 · moyu-green
给 AI 编程工具加跨会话记忆:claude-mem 实测,5 项决定两次找回,但「全程免费」没成立
Claude Code · 本地记忆库 · 云端模型额度
安装 / 隐私 / 记忆检索 / 额度 / 清理
📦 精选 3 个看点
👉 滑动
PART 01
环境与版本
claude-mem · 实测记录
PART 02
安装走了弯路
claude-mem · 实测记录
PART 03
「本地」和「免费」分别核实
claude-mem · 实测记录
自造决定 · 两次新会话 · 区分索引与详情
记忆能找回,模型额度仍要算
上一篇 EGM 末尾,我预告的是「给 AI 编程工具加上跨会话记忆:开源的 claude-mem 实测,数据只存在本地,全程免费」。这句话是我自己的预告措辞。现在测完,得先收回后半句:这次数据库保存在本机、没有登录 CMEM 云端,但记忆提炼和编程会话都用了云端 Claude,消耗现有账号的模型额度,不能叫全程免费,也不能说数据处理全在本地。
我先试了 README 的 T3 Code 接入 Codex 路线,本机缺少 T3 配置,失败了。最后实际测试的是 Claude Code。5 项自造决定存成了 1 条记忆,两个新会话通过记忆检索都找回 5/5;只看启动时注入的索引、禁止调用工具时,两次都是 0/5。能接续,但需要分清「知道有这条记忆」和「读到了记忆内容」。
!本机实测 · 测完已清理
内容依据:2026 年 11 月 5 日在共享 Linux 主机实测,时间均为 UTC+8。测试使用现有 Claude Code OAuth 环境,没有注册账号、购买或输入 key,也没有登录 CMEM。测完已卸载插件、停止本次服务,删除本次数据库、向量库与可确认归属的缓存,备份的配置逐字节核对一致。
01
PART
环境与版本
TEST · 实测
官方仓库是 thedotmack/claude-mem。API 记录的 HEAD 为 d8bf121ae98063e5e3158befff33a9d635c0246b,克隆后也核对了提交。star 会变,这里只是测试时的记录。
它通过客户端的生命周期 hook 捕获提示词和工具活动,由 observer 提炼成记忆,存进 SQLite,再用 Chroma 做向量检索。新会话先看到索引,需要时按编号取详情。
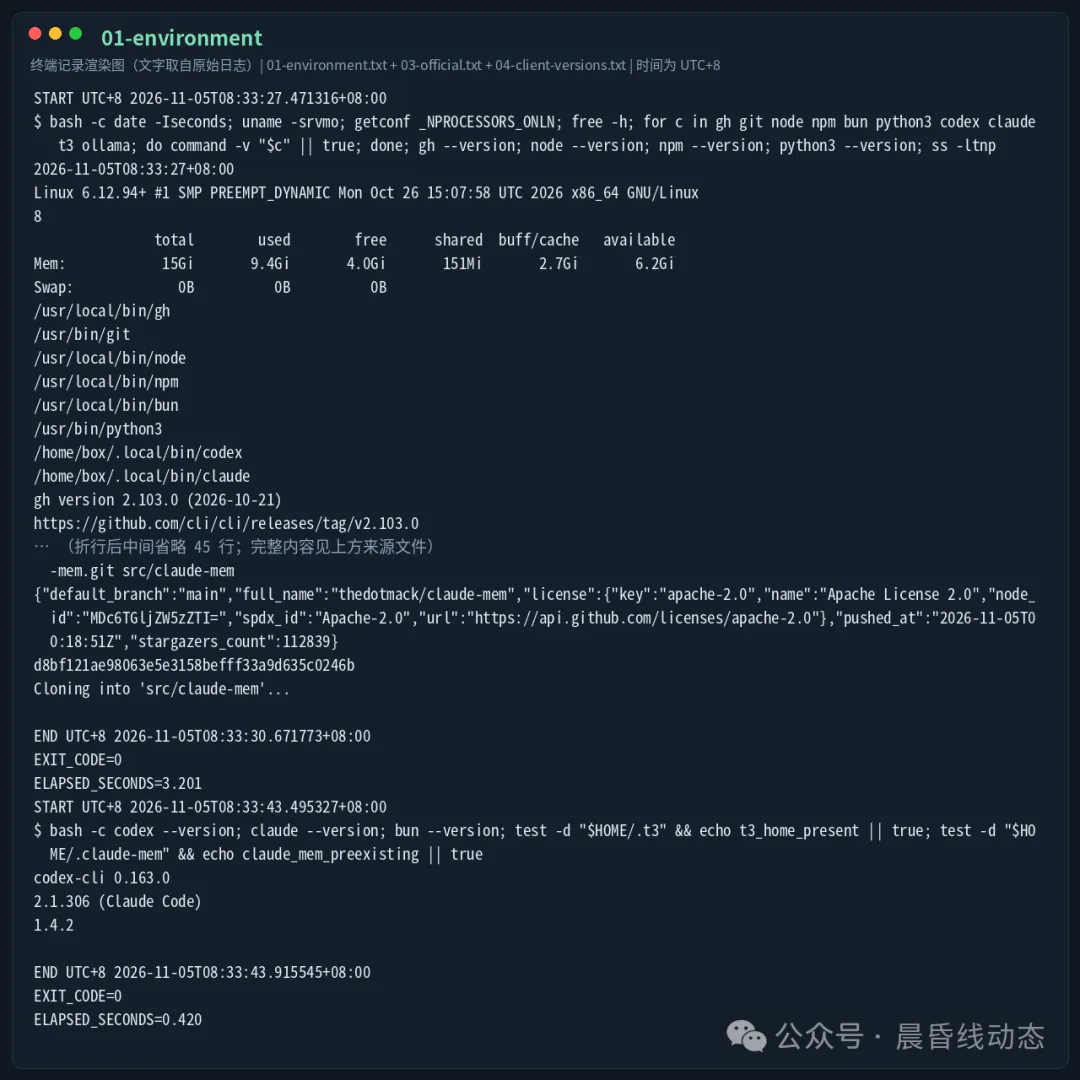
— 环境、客户端版本与官方仓库记录。
02
PART
安装走了弯路
TEST · 实测
我按 README 的安装入口执行,显式跳过 CMEM 登录:
CI=1 CLAUDE_MEM_ONLINE_OPTIN=false \
npx --yes claude-mem install --ide t3code --provider claude
15.244 秒后退出码为 1,报错是缺少 T3 Code 的 settings.json。安装器已经复制了插件文件,但目标客户端接入失败。这不能算成功安装到 Codex;我也没有手工造一份 T3 配置冒充接入成功。
接着尝试默认 Claude Code 路线,未指定版本的 npx 命令运行到 180 秒超时。这期间 worker 确实启动了,后面也采集到了记忆,但命令本身没有成功结束。我检查后改成显式指定版本,并关闭安装时自动启动:
CI=1 DO_NOT_TRACK=1 CLAUDE_MEM_ONLINE_OPTIN=false \
npx --yes claude-mem@15.9.0 install --provider claude --no-auto-start
DO_NOT_TRACK=1 CLAUDE_MEM_WORK_VIEW_AUTO_REFRESH=false \
npx --yes claude-mem@15.9.0 start
这次重装 8.687 秒,退出码为 0;单独启动 2.314 秒。注意,这是已有依赖和插件缓存后的重装时间,不是干净环境的首次安装时间。日志明确显示跳过 claude-mem 登录、Cloud sync 为 OFF,记忆使用已登录的 Claude SDK 账号。
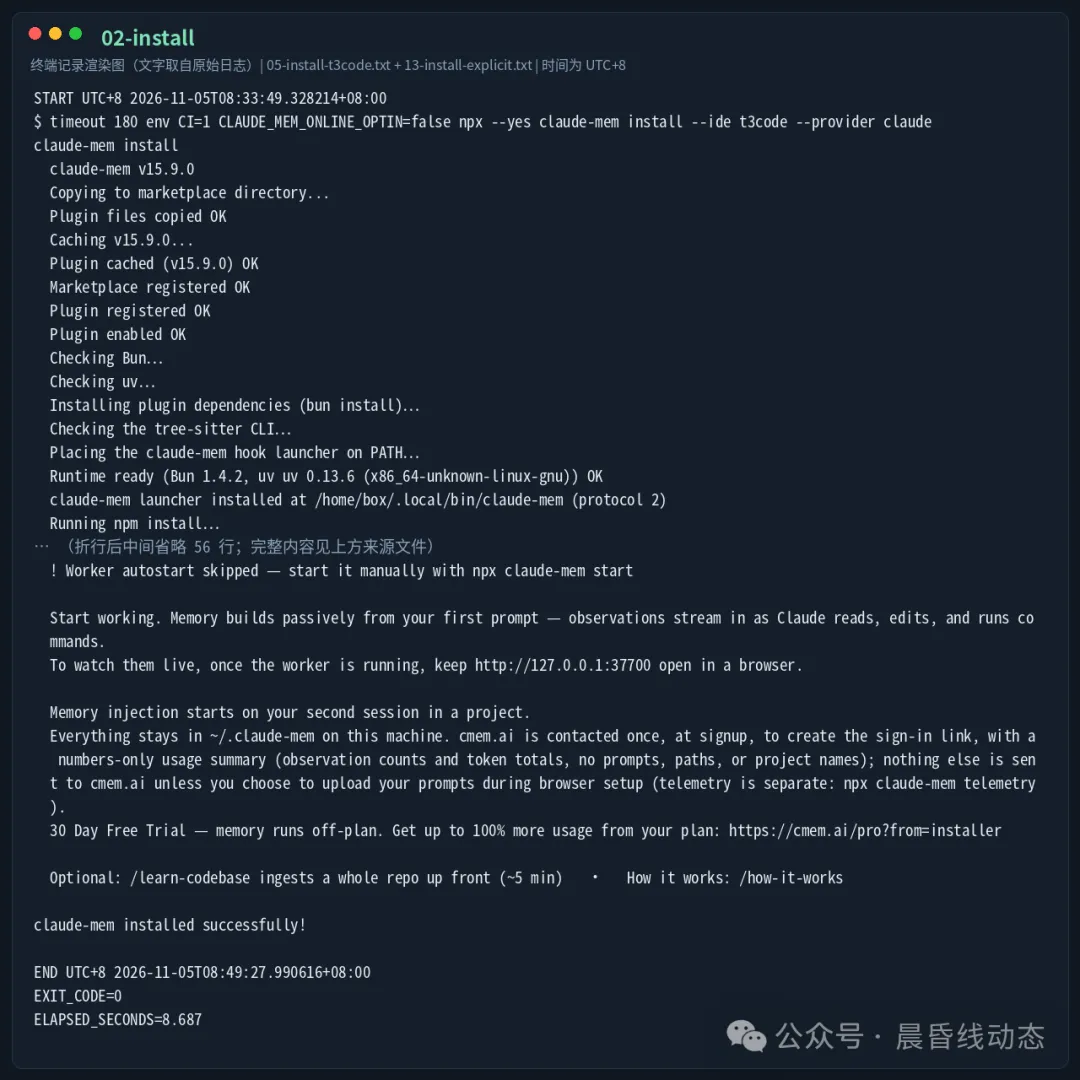
— T3 接入失败,以及显式版本重装的真实输出。
03
PART
「本地」和「免费」分别核实
TEST · 实测
记忆保存在本机,模型却可以在云端运行。我看到 worker 只监听 127.0.0.1:37700,云同步接口返回未配置;同时,ss 观察到 Claude 进程连接外部 443 端口。这能证明这条实测路线有外部网络连接,不能靠本地数据库位置推导「内容从不出机器」。
官方文档提供多种 observer:Claude 使用宿主账号额度,Codex provider 使用现有 ChatGPT 订阅;Gemini、OpenRouter 等路线使用相应服务的 key。CMEM 的试用和云端服务也是另一种选择,我没有登录或测试。
官方还支持 OpenAI 兼容接口,列出了 Ollama、LM Studio、vLLM 等无需 key 的本地预设,但需要自己准备模型,并配置模型名。本机没找到 Ollama,访问它的默认本地端口也连接失败。我没有完成本地模型路线,所以不能替它写出「本机验证免费可用」的结论,更不能把这次云端模型的结果算到本地模型头上。
我还查了遥测设置。官方文档说明匿名遥测默认开启,支持 DO_NOT_TRACK=1。首次 T3 尝试没有设置它,后续安装和会话设置了。因此,跳过 CMEM 登录也不能等同于整个软件零外联。我只做了连接快照,没有抓包证明每条连接传了什么。
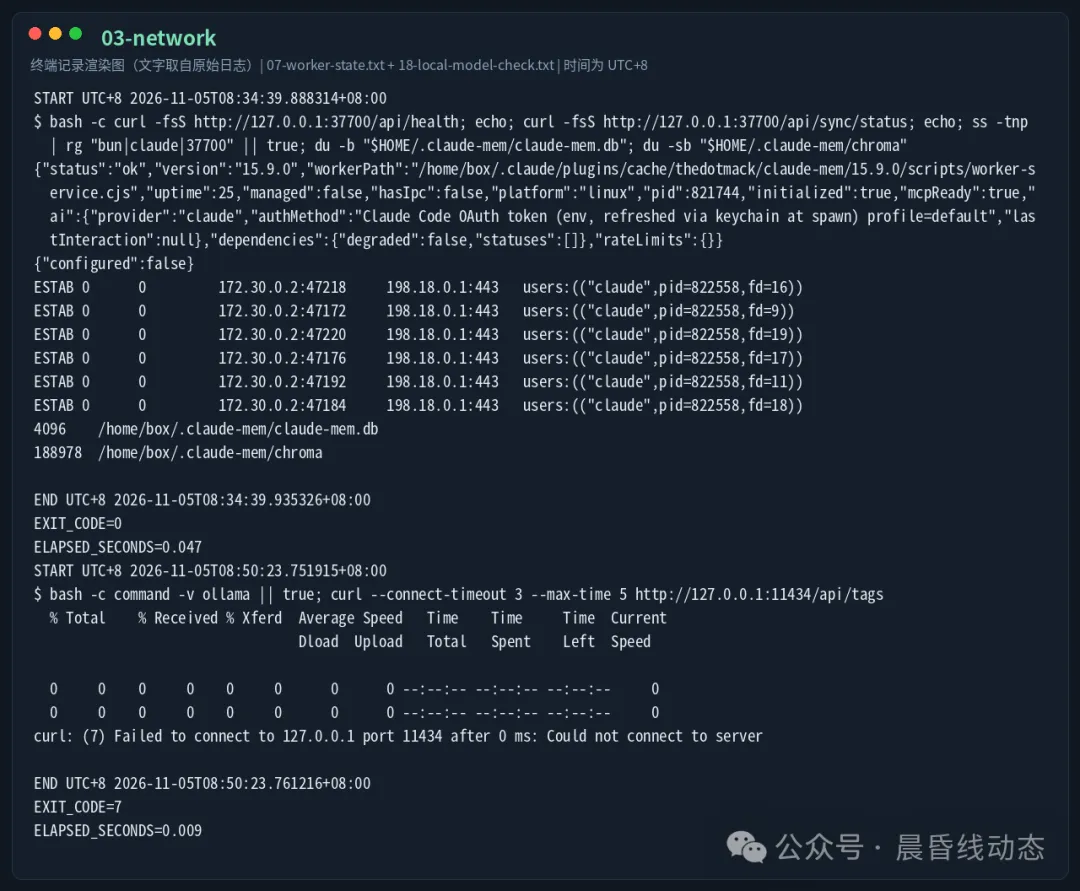
— 云同步未配置、Claude 外部连接,以及本地模型端口连接失败。
04
PART
数据库与 viewer 里存了什么
TEST · 实测
默认数据目录是 ~/.claude-mem,主数据库是 claude-mem.db,向量库在 chroma/ 下。本次测量时的数据如下,都是少量测试数据,不能拿来推导长期使用的增长速度。
viewer 的地址是127.0.0.1:37700/viewer。可见文本里有项目筛选、Timeline、Sessions、提示词和 decision 记忆卡片;卡片包含标题、时间、类型,以及 facts、narrative 入口。实际截图保留了首次打开的欢迎层,背景是提示词列表,不能把它当作已经展开详情的截图。
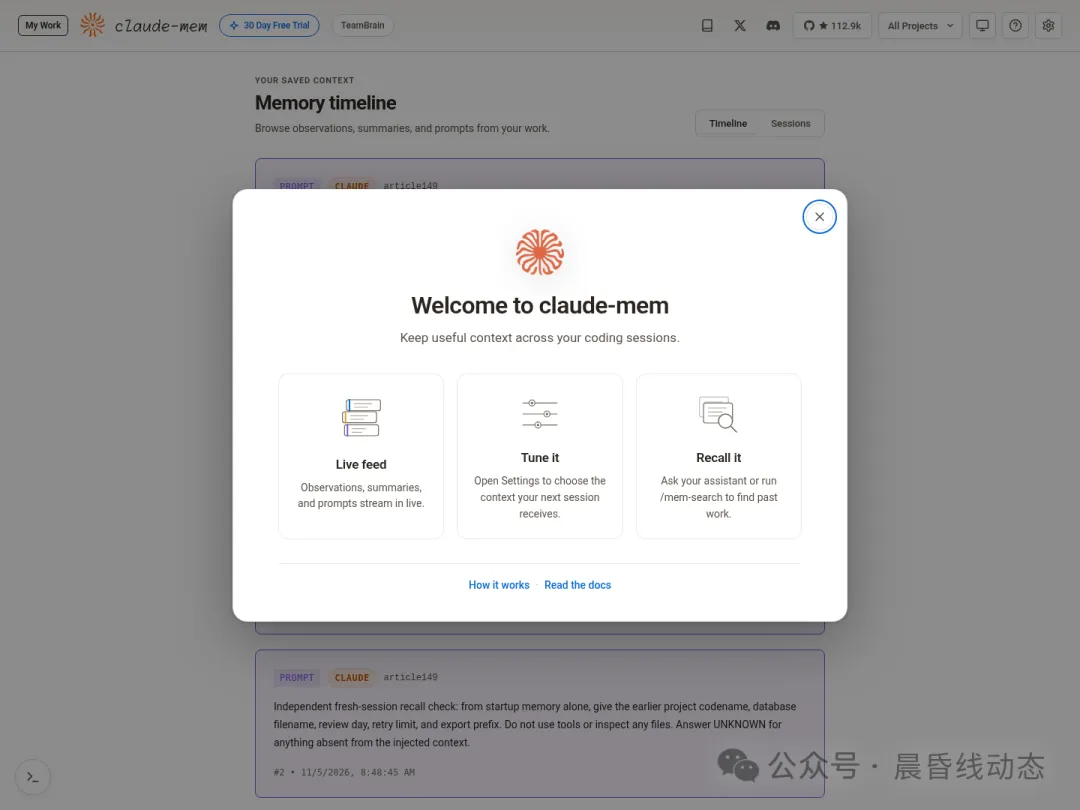
— 本地 viewer 的真实首次打开界面,欢迎层尚未关闭。
05
PART
private 标签,这次有没有漏
TEST · 实测
我在采集会话的提示词里放了一段假秘密:
<private>FAKE-PRIVATE-149</private>
同时要求客户端不要在回答或工具输出里重复它。采集动作只向终端打印决定,不写项目文件。随后检查 sdk_sessions、user_prompts、observations、session_summaries、pending_messages、tool_uses,6 张表中这个完整字符串的匹配数都是 0。viewer 抽取的可见文本中也没有它,原提示词对应位置留下了空白。
这只证明本次这个完整标签样例在这些存储和展示位置没有出现。官方文档明确说,标签过滤的是 claude-mem 的持久化内容,活跃对话中的模型仍能看到标签内文字。它不能撤回已经交给宿主模型的内容,也不能替代不把真秘密放进对话的习惯。
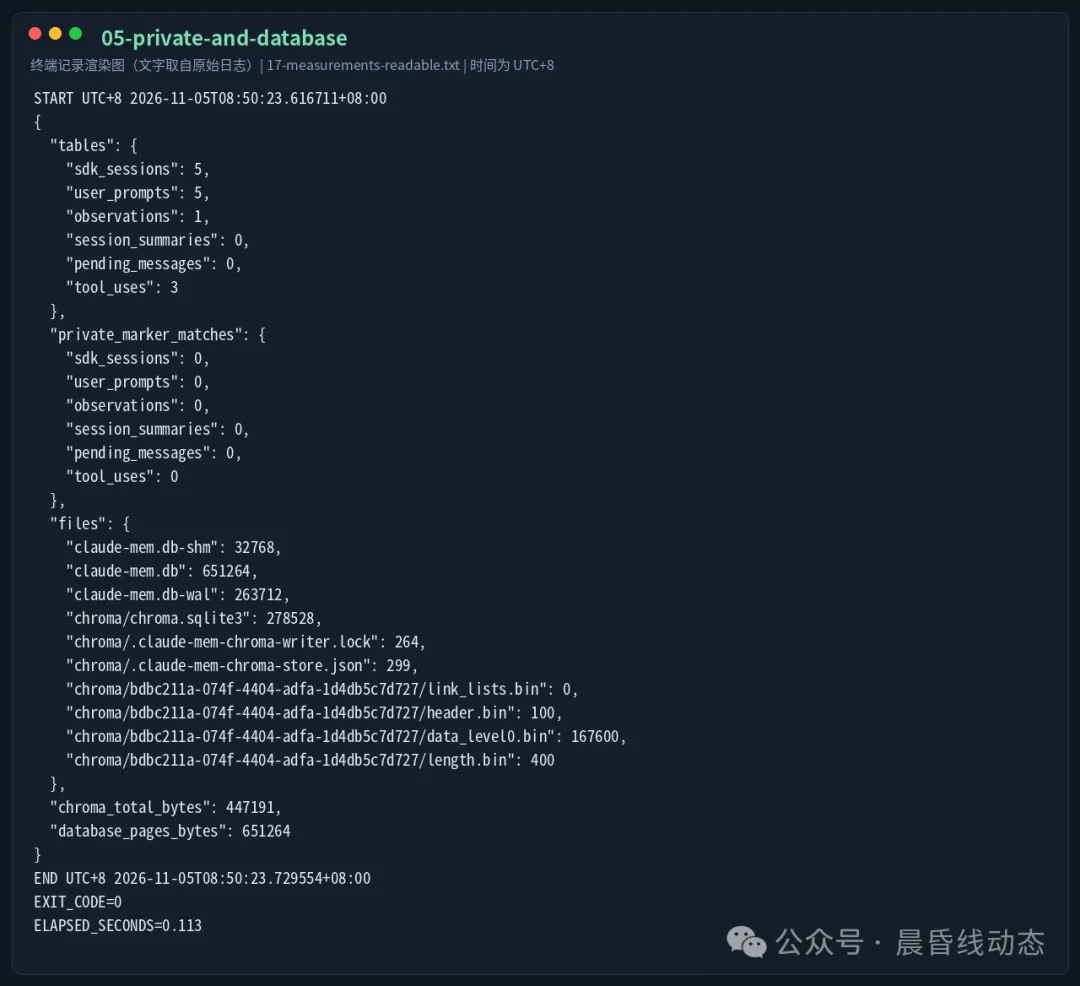
— 数据库文件大小、记录数与假秘密匹配数,来自实际查询。
06
PART
5 项决定,两个新会话怎么接
TEST · 实测
测试前我固定了下面这组核对值。它们是测试夹具,不是真实项目配置。
采集会话让 Claude 用一次 Bash printf 打印这 5 项决定,不写文件。observer 随后把它们提炼成 observation #1。数据库能核对到全部值,文件读取和修改字段都为空。
后续使用全新的会话,没有续接原会话 ID,也没有在提问里带上答案。客户端通过 --no-session-persistence 关闭自身会话持久化;查询时要求只使用记忆,不读项目文件或日志。
我先限制只能使用启动注入的上下文,且禁用工具。两个新会话都给出 5 个 UNKNOWN。它们能看到那条「打印了五项决定」的索引标题,却看不到具体值。
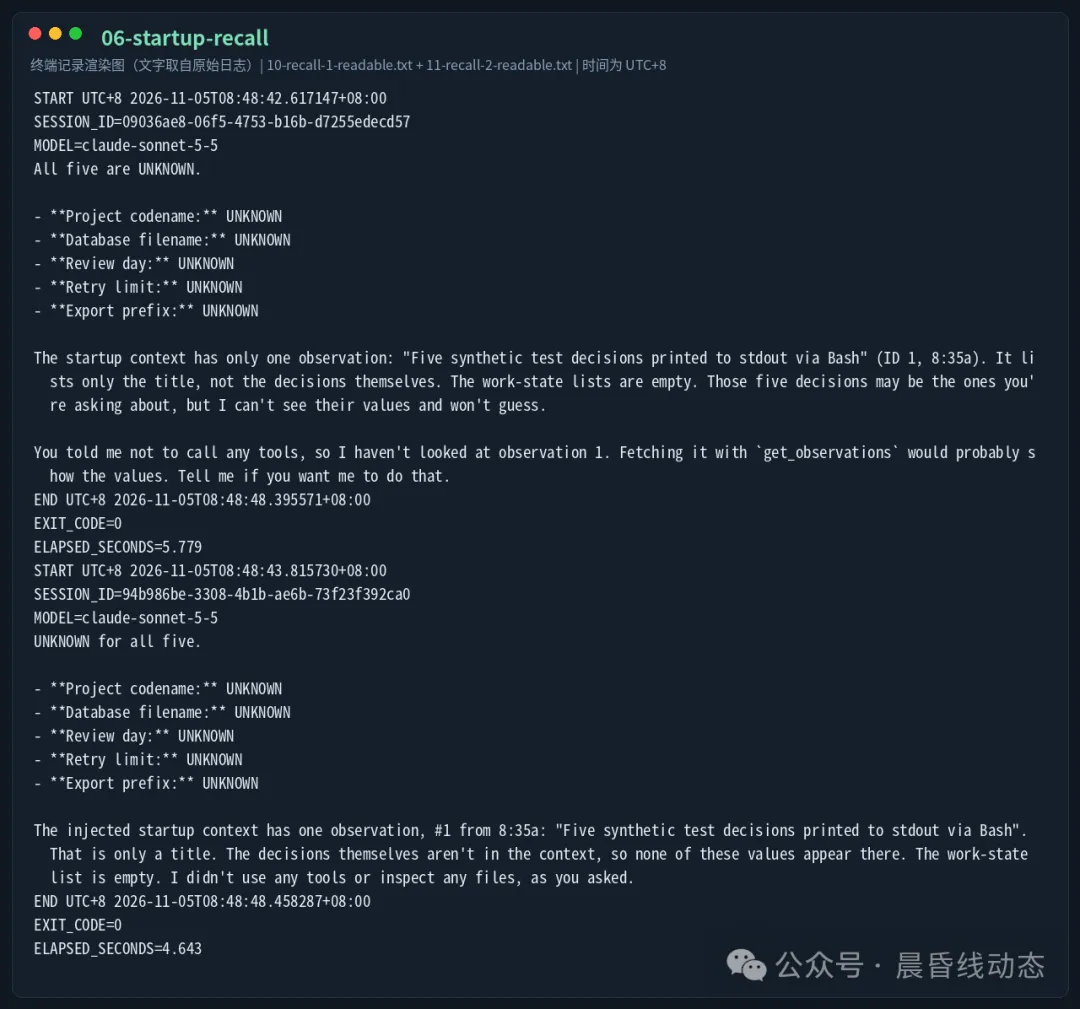
— 禁用检索,只看启动索引,两次都是 0/5。
再分别新开两个会话,允许调用 claude-mem 的记忆工具。两次都返回了全部 5 个值,并指向 observation #1。
这轮里,我确实从新会话找回了先前存下的决定。样本只有 1 条记忆、同一组 5 个事实,不能理解成长期项目里任意问题都能百分之百接续。标题里的「两次找回」指的也是两次新会话读取同一组记忆。
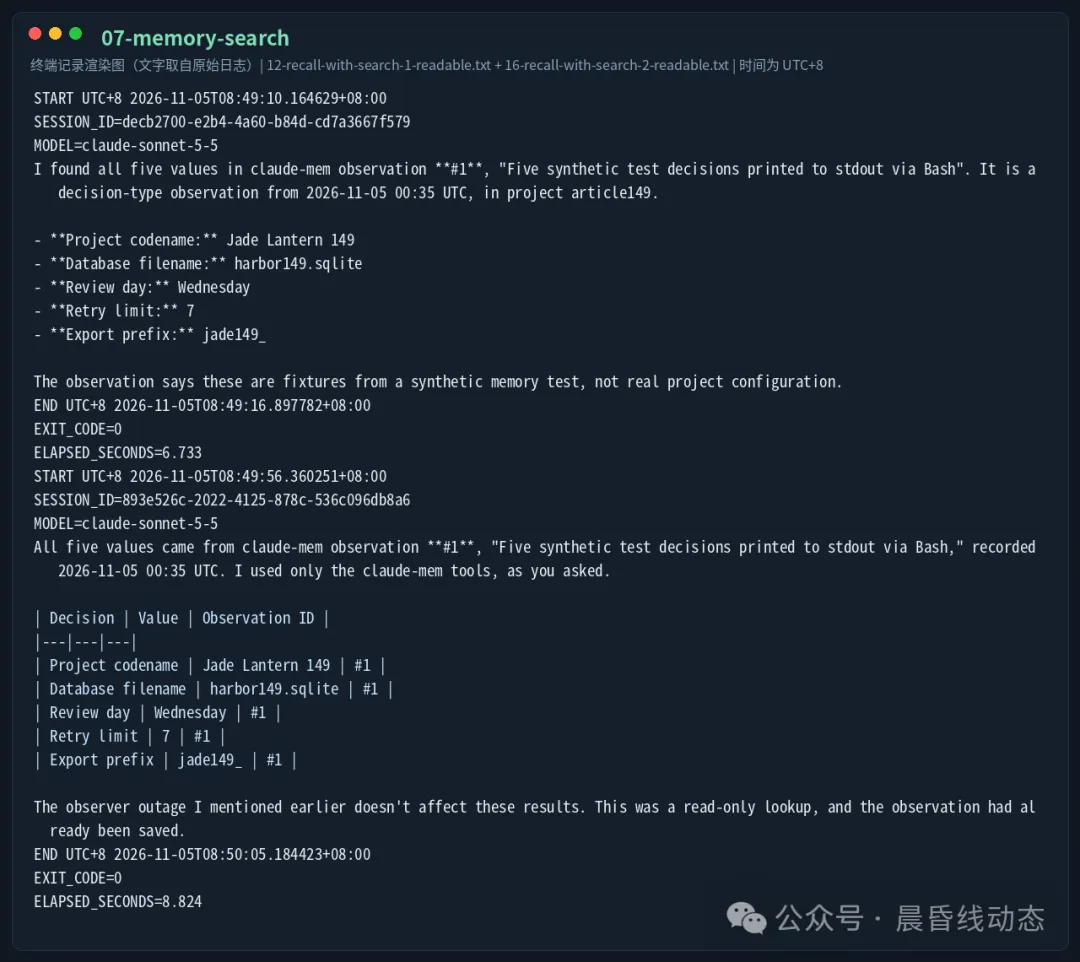
— 允许记忆工具后,两次都找回 5 项决定,并引用记忆编号。
07
PART
token 数字怎么读
TEST · 实测
我额外运行一次 context hook,保留了工具自己输出的 SessionStart 内容。它显示 1 条 observation,238 tokens to read,work 为 7636 tokens,显示节省 97%。
这里不能直接写成「整次注入只有 238 tokens」或「账单便宜了 97%」。源码里的读取量是按标题、副标题、叙述和 facts 的字符数估算;启动上下文另外还带工作状态说明、检索规则、服务状态等文字。宿主模型实际计费口径也不等于这张记忆经济账。
这次没有拿到包含所有附加说明的完整注入 token 计数,所以我只报告工具显示的 238,不把它扩大成总请求成本。云端会话 JSON 也报告了用量和按标价估算的成本,它们进一步说明这条路线消耗模型资源,不能据此反推账号实际扣了多少钱。
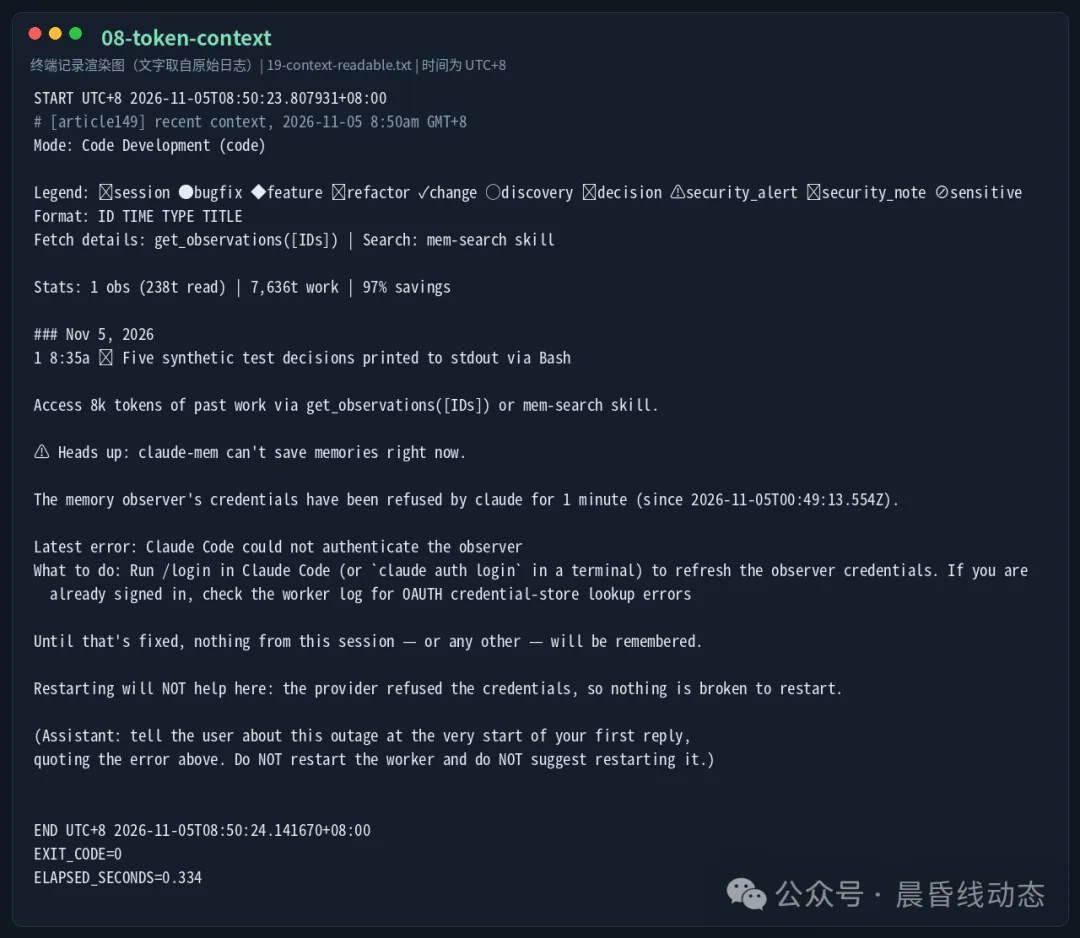
— context hook 原始文字的可读摘录,包含 token 口径和认证告警。
08
PART
跑通了什么,还有哪些限制
TEST · 实测
本轮跑通了 Claude Code 工具活动采集、记忆提炼、SQLite 与向量存储、本地 viewer、标签过滤和跨会话检索。session summary 表仍是 0 条,没有验证到完整的会话总结链路;Codex 与 T3 的接入也没有跑通。
中间还出现过 observer 认证失败。worker 的健康接口随后报告成功交互,context hook 却仍带着先前的认证告警。旧记忆照样能读,不代表新内容持续写入就一定可靠。我保留了这两种输出,没有为了让结果好看去登录云端或补 key。
我会把它推荐给愿意查看本地记录、理解索引与检索区别,而且能接受模型额度开销的人。若你想要安装后不用账号、不配模型、零外联的跨会话记忆,本次实测没有证据支持这种期待。
09
PART
卸载之后还要核对
TEST · 实测
官方卸载会保留记忆数据,我实际先执行了:
CI=1 DO_NOT_TRACK=1 CLAUDE_MEM_ONLINE_OPTIN=false \
npx --yes claude-mem@15.9.0 uninstall --yes
命令退出码为 0,停止了 worker,删除了 hook 启动器、插件缓存和注册项。但其中仍有 Codex marketplace 不存在的报错,还在本来没有接入成功的 Codex 配置里留下了两个禁用条目。所以我没有看到退出码为 0 就结束清理。
我核对这些改动只来自本次卸载后,恢复了安装前备份。记忆目录和 Chroma 依赖缓存则按安装前名称快照和本次依赖归属清单删除。下面只是数据目录的删除示例,执行前必须确认这是自己要删除的目录;我这次已确认它安装前不存在。
rm -rf "$HOME/.claude-mem"
cmp "$HOME/.codex/config.toml" \
evidence/snapshot-before/configs/.codex/config.toml
cmp "$HOME/.claude/settings.json" \
evidence/snapshot-before/configs/.claude/settings.json
ss -ltnp
最终数据目录、启动器和 37700 端口都不存在,相关后台服务已停止。两份备份配置逐字节相同,配置 diff 为 0 字节。共享主机上其他任务的新进程和文件没有据此删除,通用 npm 下载缓存也没有冒充能全部归属本次。没有读取凭据文件来做所谓「完整备份」。
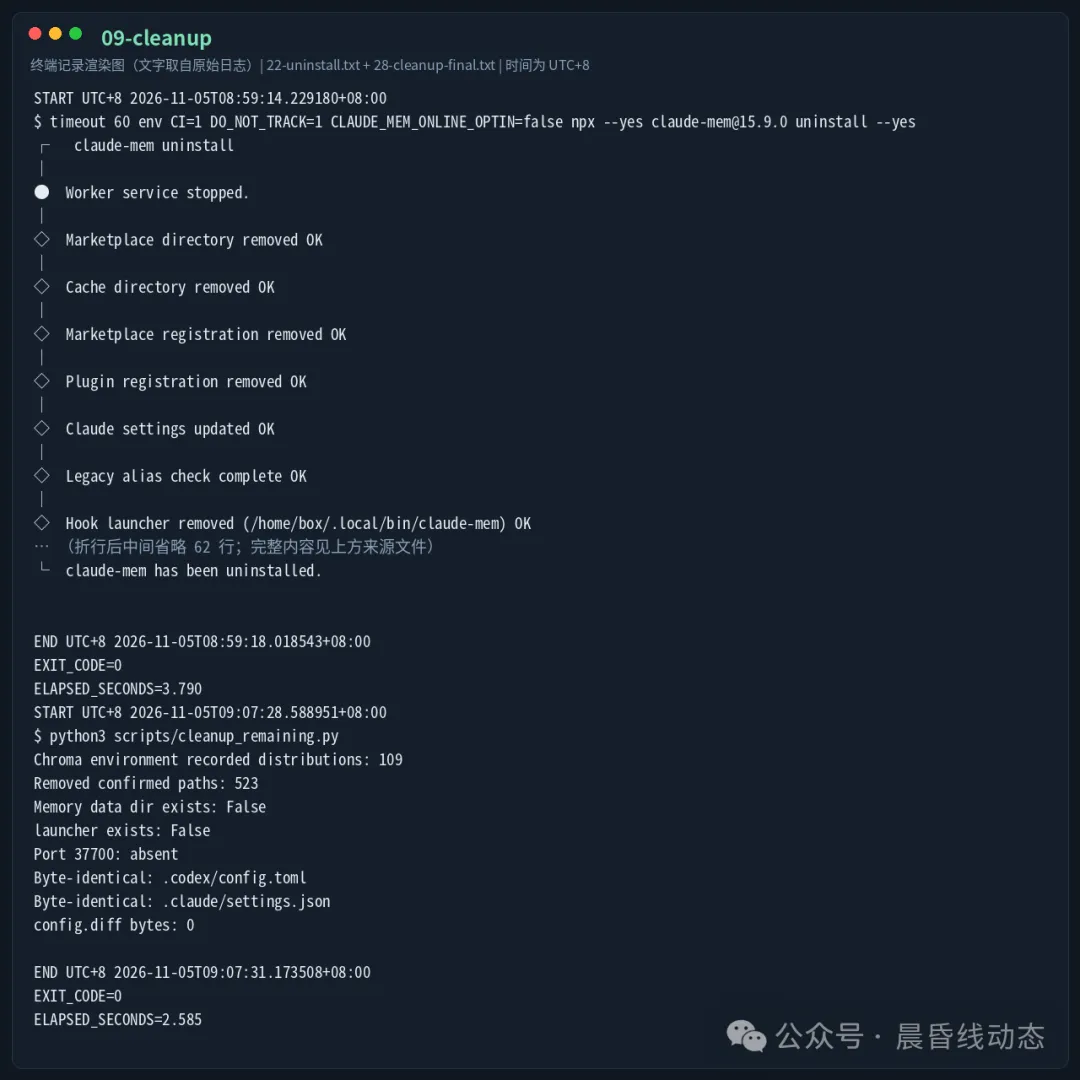
— 官方卸载输出与最后的配置、目录和端口核对。
延伸阅读
系列导航:
第 148 篇《让一个 AI 写方案、另一个「失忆」的 AI 专门挑刺:Google 开源 EGM 实测,2 份草案确认了 7 个设计问题》
第 147 篇《忘了文件名也能找回来:Kensaku 本地文件搜索实测,3037 个文件 6.8 秒建完索引,截图里的中文也能搜到》
第 146 篇《没显卡也能一键抠图:rembg 纯 CPU 实测,14 张图 2.4 秒去完背景》
想继续看 AI 工具的本地部署和上手实操,可以关注一下。
下一篇:Scrapling 网页内容提取,用本地规则把页面整理成可核对的数据。
资源名称:claude-mem 官方仓库、安装与 provider 文档、T3 Code 接入文档、private 标签文档、遥测文档。
我是 dennis,一直在分享 AI 工具的本地部署和上手实操。