ARTICLE · 1352892
读懂 DSH 的插件机制
上一篇拆的是 evolve 怎么给 AI 造大脑,那是一个产品内部的认知设计。这一篇换个位置:站到要动手改它的那一侧——当二开的需求真的落到自己头上,你才会发现,决定这次改造难易的,不是代码写得漂不漂亮,而是它的组装机制允不允许你只加不改。
起因:一个不得不读源码的下午
项目上需要基于 dsh 做二次开发。
dsh 是 DeepSeek Harness 的缩写,开源的 AI 编程客户端。我们要做的事不复杂:给它接上公司内部账号,让用户必须先登录才能进工作区。
按经验,这类改动的第一反应是找配置文件。但翻了一圈发现行不通——它的登录逻辑不是配置项,而是代码。
于是只能往下翻。翻到一半,意识到一件更基础的事:我其实不是在看某个功能的实现,而是在看这个软件到底是怎么被组装起来的。
它的每一块能力——模型适配、工具注册、会话日志、界面——都不是写死在主流程里的,而是一个个独立单元。主流程干的事只有一件:把这些单元按依赖关系拼起来。
这个拼装机制叫 Cordis。
一、先说清楚它是什么
Cordis 是一个 TypeScript 的插件框架,以 vendor 方式内置在 dsh 里。它的作者也是 Koishi(一个知名聊天机器人框架)的作者,所以这套东西的成熟度不低。
但对从 Java 过来的人来说,最好的理解方式不是记概念,而是做个映射:
@Configuration 类 / starter | ||
ctx | ApplicationContext | |
@Service | ||
inject: ['tools'] | @Autowired | |
cordis.yml | application.yml |
如果你按这个理解往下走,八成是对的。但有三处关键差异,恰恰是这次改造能不能做成增量的分水岭。
第二条「按字符串名字找」,是理解后面一切的钥匙。
二、五个核心概念,其实只有两条规则
官方文档给了五个核心概念。但那五条压缩一下,其实是两条规则:
规则一:插件是个「贡献包」。
一段代码被加载后做三件事——注册服务、监听事件、挂载子插件。就这么多,没有别的要求。
规则二:所有人按名字找东西,谁也不认识谁。
这是整个机制的灵魂。看代码最直观。
一个提供方插件,想对外提供一个能力:
export class CorpAccount extends Service { constructor(ctx: Context) { super(ctx, 'corpAccount') // 就这一句,注册成名为 corpAccount 的服务 } async getState() { /* 读凭据 */ }}一个消费方插件,想用这个能力:
export const inject = ['corpAccount'] // 我要这个服务export function apply(ctx: Context) { const state = await ctx.corpAccount.getState() // 拿得到,因为容器保证就绪}注意两件事。
第一,消费方从来没有 import 过 CorpAccount 这个类。它只知道有个叫 corpAccount 的东西存在,符合某个接口。具体实现是谁写的、叫什么名字、在哪个包,它一概不知。
第二,容器看到 inject 声明后,会等到这个服务就绪才让插件启动。所以进到 apply 里面时,ctx.corpAccount 保证可用,不用写判空、不用写重试。
这两条合起来,就得到了一句很有分量的话:
换掉提供方,消费方一行都不用改。
这句话不是修辞,是这套机制的实际能力。而它,就是我们这次改造的着力点。
三、被严重低估的:装配层级
理解了「按名字找」,还要理解第二件事:这些插件是怎么被装进去的。
这是我觉得最容易被忽略、但工程价值最高的一层。dsh 的插件树不是一份配置文件拼出来的,而是多层叠加的:
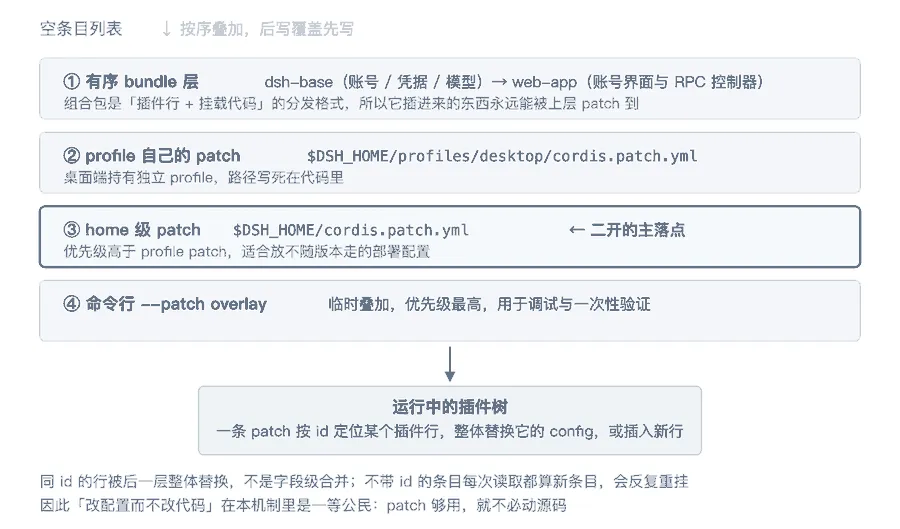
这套设计里有两个细节,值得单独说。
第一个:patch 是「按 id 整体替换」,不是字段级合并。
意思是,如果我要改 webserver 这一行的端口,写 patch 时必须把它的完整 config 都重述一遍,不能只写要改的那个字段。这看起来麻烦,但它消除了「我改了 A,结果 B 被谁悄悄覆盖了」这类问题——要么整行是我的,要么整行是别人的,没有中间地带。
第二个:patch 里插入的插件可以是文件路径。
这条让我当时愣了一下。插入的插件名允许是绝对文件系统路径、file URL 或者包名。也就是说,我可以在不发布 npm 包的前提下,把自己的插件挂进 dsh 的插件树——只要在 patch 里写个路径。
对二开来说这个口子太关键了:新增能力的成本,从「发一个包」降到了「写个文件、加一行配置」。
四、三个反直觉的地方
机制讲完,说三个第一次接触时一定会踩的点。这三条也是我翻源码时花时间最多的地方。
反直觉一:文件顺序不代表加载顺序
- name: './greeter.ts' # 谁先加载?- name: './consumer.ts' # 不一定这两条是并发启动的。谁先谁后,由 inject 的依赖关系决定——consumer 声明了要用 greeter,它就一直等到 greeter 就绪才启动。把这两行顺序调换,结果完全一样。
这条直接回答了我们方案里的一个实际问题。我们要挂两个插件:一个账号服务,一个内部认证的对接层。谁写在前面?答案是:无所谓。只要对接层声明 inject: ['corpAccount'],容器会自己把顺序排对。
为什么这件事重要? 因为它把「启动顺序」从一个需要人工维护的隐性知识,变成了一个由声明推导出来的必然结果。人多手杂的时候,这类隐性知识最容易出错。
反直觉二:找不到依赖时,它会「等等等」而不是报错
这是最需要警惕的一条。
在 Spring 里,@Autowired 找不到 Bean,启动直接失败,报错告诉你少了哪个 Bean。
Cordis 不是。它会让插件停在 PENDING 状态,不加载、不报错、不输出,进程照常运行。
插件「没生效」时,第一件要做的事不是看代码,而是查它是不是卡在了 PENDING——多半是 inject 里写的某个服务,根本没人提供。
官方文档给了诊断办法,直接枚举插件注册表、把 PENDING 的挑出来:
for (const runtime of ctx.registry.values()) { for (const fiber of runtime.fibers) { if (fiber.state === FiberState.PENDING) { console.log(`${fiber.name} is PENDING — a required service is missing`) } }}插件的完整状态机是这样的:
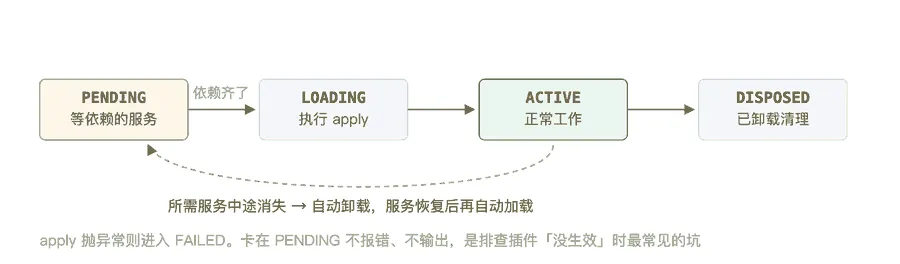
注意那条从 ACTIVE 绕回 PENDING 的虚线。它说明了一件事:依赖不是启动时检查一次,而是持续跟踪的。
如果运行中提供方被卸载,所有依赖它的插件会跟着卸载;提供方恢复,它们再自动加载回来。所以运行中替换实现是安全的——竞态和悬空引用这些问题,机制层面就已经消掉了。
反直觉三:注册会自动撤销,但你得「把东西交给它管」
用 Cordis 的注册接口搭起来的东西——事件监听、子插件、路由——卸载时都会自动清理。你不需要写 removeListener,不需要写 close()。
但前提是它们真的经过 Cordis 的手。 自己 new 出来的定时器、socket 连接、文件监听,不在管辖范围内,必须用 ctx.effect() 包住,并返回一个清理函数:
ctx.effect(() => { const listener = createServer().listen(0) return () => listener.close() // 卸载时自动调用})这条对我们的登录流程恰好是天然的契合。回环回调要起一个本地监听端口,方案要求「只接受一次请求,用完即关」——用 ctx.effect() 包住,登录成功或用户取消时端口自动释放,不用写额外的清理逻辑,也不会因为异常路径漏关。
五、为什么这套机制值得单独写一篇
回到最开始那个问题:我们到底要改什么。
把机制摸清之后,方案里那五处改动,性质一下子清楚了:
| 纯新增 | |||
| 纯新增 | |||
①② 是「加东西」,③④ 是「减东西」(删掉填 key 的表单、删掉准入的第二个条件),⑤ 是「改配置」。
没有一处需要重构官方架构。
之所以能这样,全靠第三节那个「按名字找服务」的机制。我核对过上游代码:账号能力就是一个标准的 Service 子类,占着 ctx.deepseekAccount 这个名字;界面层的账号控制器写的是 inject: ['deepseekAccount', 'agents']。
也就是说——只要我们的插件用同一个名字注册服务,上游的账号界面和 RPC 控制器就会自动用上我们的实现,它们那侧一行都不用改。
这就是「增量式改造」在工程上的确切含义。它不是一句「我们尽量少改」,而是一个由架构机制保证的结论。
顺便,机制也解释了另一个我们讨论过的问题:为什么改了授权之后必须改更新源。
因为我们的插件和 patch 文件,都躺在应用目录和用户数据目录里;而自动更新会覆盖整个应用目录。一次静默更新,插件、patch、页面改动全部回滚,表现就是「登录功能时好时坏」。
所以更新源必须和插件改动同批交付——这不是一个可以往后放的优化项,而是这套机制下的必然要求。
最后
这篇写的是一次二开过程中的机制梳理。但拉远看,我觉得它有价值的地方不在 dsh,而在那个对比。
我们习惯的框架,组装发生在启动那一刻——配置定死,跑起来就改不了,遇到变化只能重启、只能重新发布。这套思路在单体时代没问题。
但当软件开始需要「按环境长成不同的样子」,需要「不同客户装不同能力」,需要「改了不用重启」——启动时组装这件事,本身就成了约束。
Cordis 的选择是把组装变成运行时的、持续的能力。代价是引入了 PENDING 这种静默状态,需要一套新的排查直觉;换来的是,能力之间彻底解耦——谁提供、谁消费,两边互不相识,替换任何一方都不惊动另一方。
这个取舍的方向,和我们前一篇里 evolve 那句「模型越强,越应该把决策权交给模型」其实是同一种思路:不是在既有结构上加约束,而是先把结构做对。
结构对了,加法才能做轻。
而对做企业级落地的人来说,这一点格外实用:判断一个系统能不能低成本二开,不该看它有没有插件市场,而该看它的依赖是不是声明式的、组装是不是可叠加的。 前者是宣传口径,后者才是你改代码时会不会被拖住的原因。