ARTICLE · 1358513
Office 365变364:微软这次为什么修了十几个小时
365 变 364:微软这次为什么修了十几个小时
11 月 12 日下午,很多人先发现 Outlook 不动了。到晚上,它已经变成整个 Microsoft 365 的全球事件:Teams、Outlook、Copilot 一起不可用,至少波及 70 个国家。
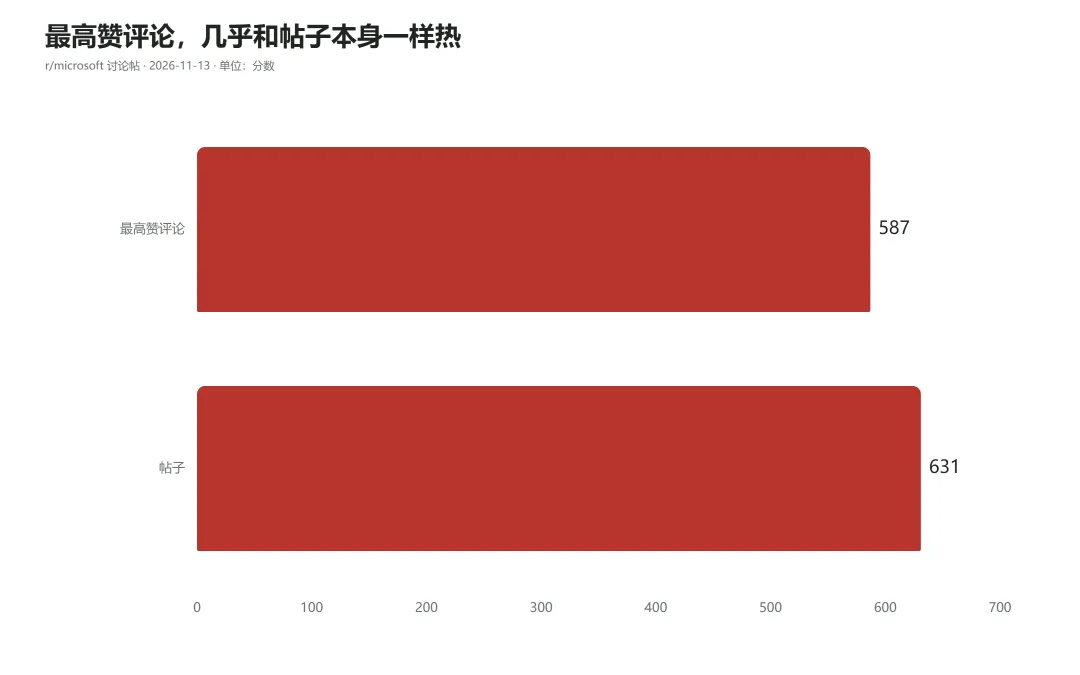
r/microsoft 有条帖子标题很直白:「10 个多小时了,只有边际改善」,631 分、515 条回复。最高赞那条(587 分)是这么写的:
我是微软 365 首席 SRE……回滚需要通过 Microsoft Authenticator 做 MFA 审批,而这个审批正在等我们要恢复的那套基础设施……应急账户的密码存在受影响租户的一个 OneNote 笔记本里……一线支持让我们跑 sfc /scannow 并截图……根因认定为客户配置错误。
这是讽刺,不是内部爆料。但它被翻成中文搬上微博时,标注着"真实性未知",但转发依然很快——因为它用玩笑补齐了通报没说清的部分。
24 小时里官方说了什么
按第三方对状态页的记录,Exchange Online 的故障 12 日 16:17 GMT 开单,18:26 GMT 扩大为整个 Microsoft 365 事件。
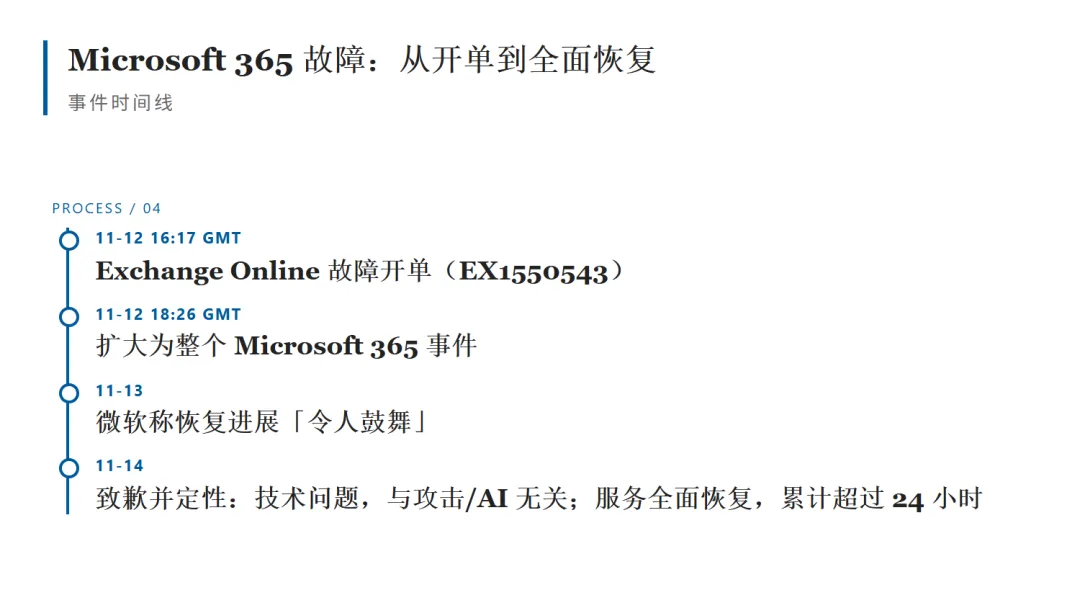
13 日,微软说看到了"令人鼓舞的恢复进展",服务可用性和邮件投递性能在改善。14 日,微软在官方账号道歉,给出定性:这是一起技术问题,与网络攻击或人工智能/智能体无关;源于此前一次"网络容量升级",问题在最近一次网络变更后显现;根本问题已解决,其余客户和地区仍在恢复;待调查完成会发布完整的事后报告。当天微软称服务已全面恢复并趋于稳定,此时距事发超过 24 小时。
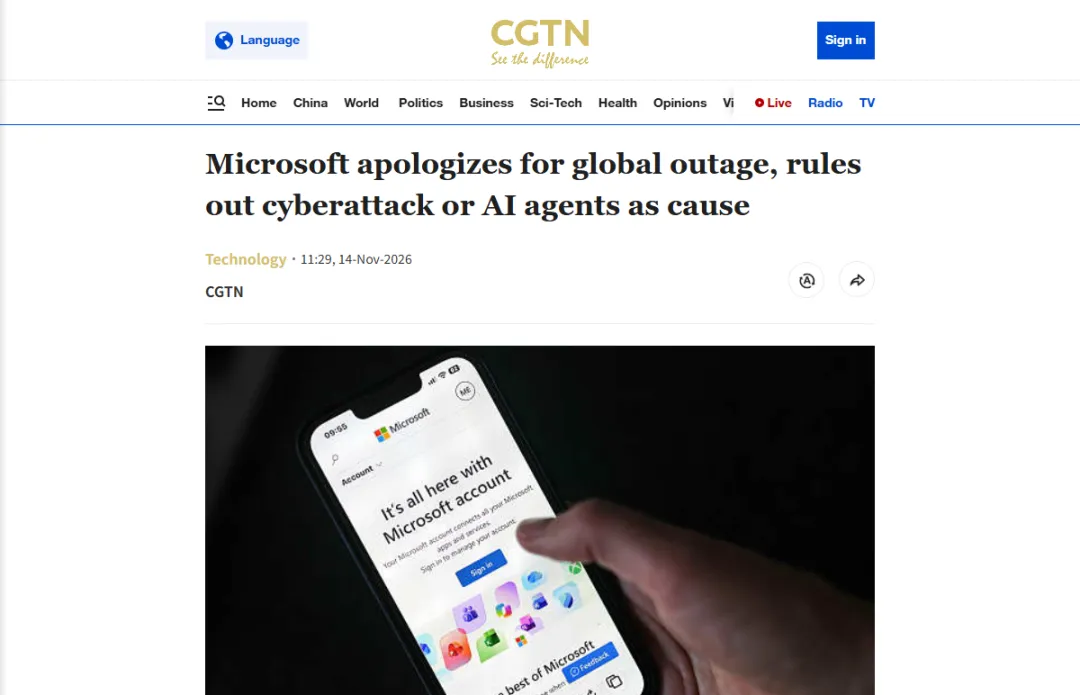
"令人鼓舞的进展"和"尚无法预计何时完全恢复"(央视报道里的口径),是同一家公司隔一天的两句话。
为什么会崩:不是被用户压垮的
因果链很短:容量升级 → 变更未按预期生效 → 流量管理失衡 → 负载升高。
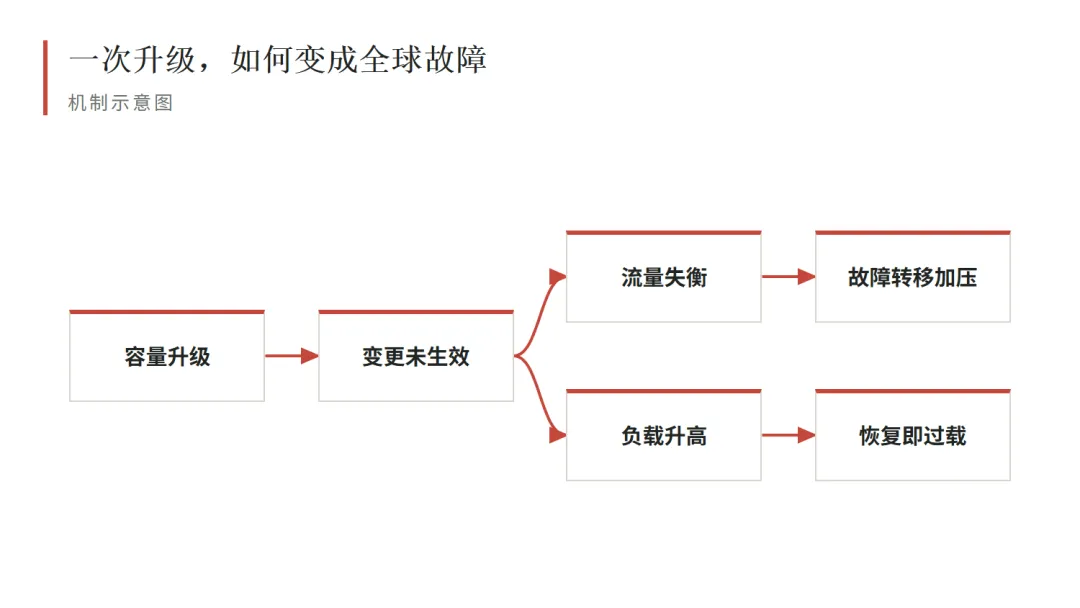
反直觉的是,微软说负载上升不是流量增长带动的。系统是被自己的变更和随后的恢复动作压垮的。
一家做 M365 托管服务的公司在 13 日复盘里写得更直白:修好的服务器,在流量回来之后又倒了一次。
自动化故障转移平时是保险:节点挂了,流量去别处。但前提是别处有余量。一旦容量本身出问题,它就从保险变成放大器。
为什么修了十几个小时
因为恢复不是一个动作,而是一条按顺序点亮的链。
先要恢复身份,而身份服务本身就在受灾范围里; 不能一起启:一个区域刚"看起来好了",积压的客户端和重试会同时涌进来; 涌进来又把刚起来的节点打趴,只能回退、重新排队。
微软自己的说法几乎印证了这套机制:因为需求规模大,他们选择逐步恢复,并在每个阶段验证稳定性——"虽然这花费了更长时间,但有助于确保服务稳定恢复"。
所以状态页写"正在恢复"时,工程团队真正在做的往往是"控制恢复速度":故障是一瞬间发生的,恢复是一条一条排队发生的。
364 这个梗戳的是什么
帖子里有人干脆改叫「Office 364」,说它"已进入内测";也有媒体把标题写成「发不出邮件,我们用了传真」。
笑完回看官方那几句话,规律很清楚:
"技术问题,与网络攻击无关"——它回答的是"不是什么",不是"是什么"; "令人鼓舞的进展"——没有分母,也没有对照; "逐步恢复并在每个阶段验证稳定性"——这句话恰恰说明,慢不是意外,而是策略。
细节受调查与法律限制,而用户要的是确定性,中间这段空白只能由讽刺和猜测填。这次"AI 把会修的人裁了"传得很广,但微软明确否认与 AI 智能体有关,也没有证据支持——当段子可以,当结论不行。
打工人能带走的一句话
云不会不挂,只会挂得比你预期的久。
下次刷到"我们正在恢复中,部分用户可能遇到间歇性问题",可以多问一句:这是已经稳住、正在收尾,还是刚点亮一段、马上又要再冲一次?区别很简单:前者会给你一个时间,后者不会。
写代码的还有一层自省:如果你的回滚审批、应急账号、身份校验全压在同一个会挂的依赖上,你的系统躺下的姿势会和这次一模一样。
资料来源:微软官方 X 声明两条(2026-11-13、11-14)、微软道歉与排除攻击、AI(CGTN 转央视新闻,2026-11-14)、事件时间线与官方措辞(CXM,2026-11-13)、托管服务商复盘(Wursta,2026-11-13)、社区讨论(r/microsoft,2026-11-13)