乐于分享
好东西不私藏

别再到处找AI工具了!这个平台把500+顶级模型全塞进去了

别再到处找AI工具了!这个平台把500+顶级模型全塞进去了

别再到处找AI工具了!这个平台把500+顶级模型全塞进去了

文生图、文生视频、多模型协作、AI漫剧...一个账号全搞定

如果你也和我一样,最近被各种AI工具搞得头大——
聊天要用ChatGPT,画图要开Midjourney,做视频得找Sora,写代码还得切Claude...
手机里装了七八个AI应用,浏览器书签密密麻麻,每个月还要记着续费。
今天,我找到了一个可能终结这种混乱的东西。

01 一个平台,500+模型

先说最直观的——
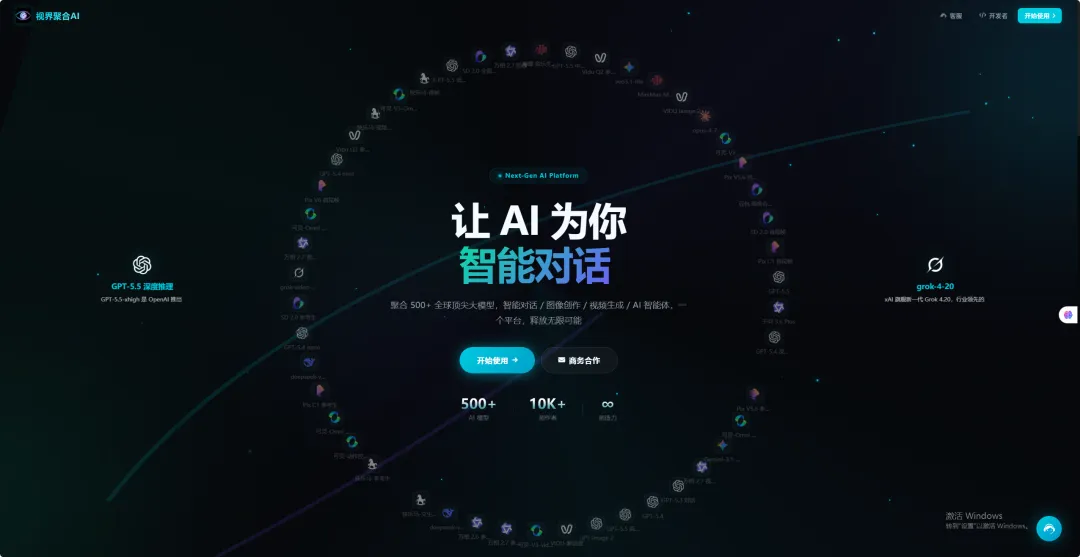
这个叫「视界聚合AI」的平台,把目前全球主流的大模型全部聚合在了一起。
不是那种"接了几个API就敢叫聚合"的草台班子,而是实打实地接入了:
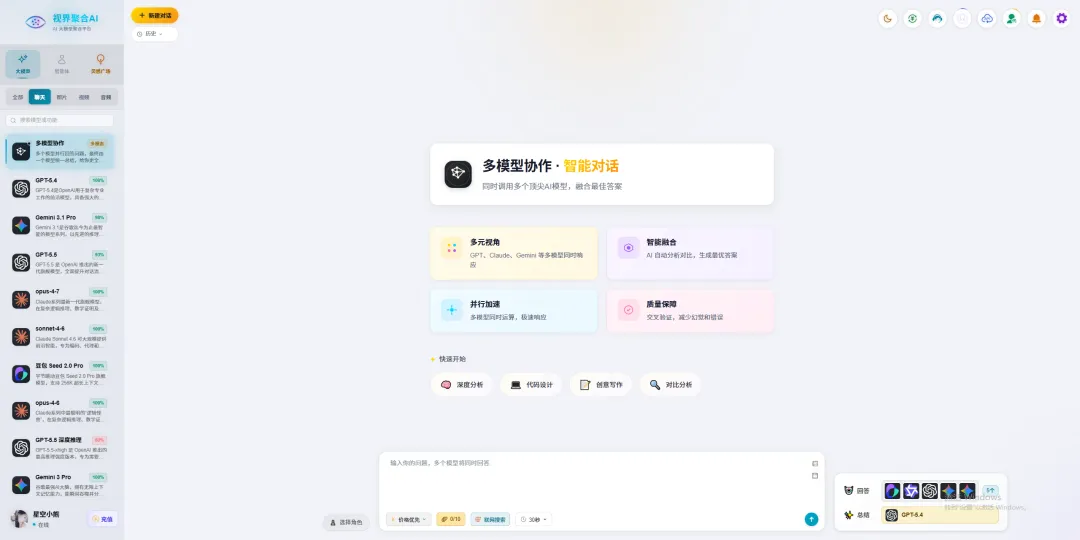
  • 对话模型:GPT-5.5、GPT-5.4、Gemini 3.1 Pro、Claude Opus-4-7、Sonnet-4-6、豆包Seed 2.0 Pro...
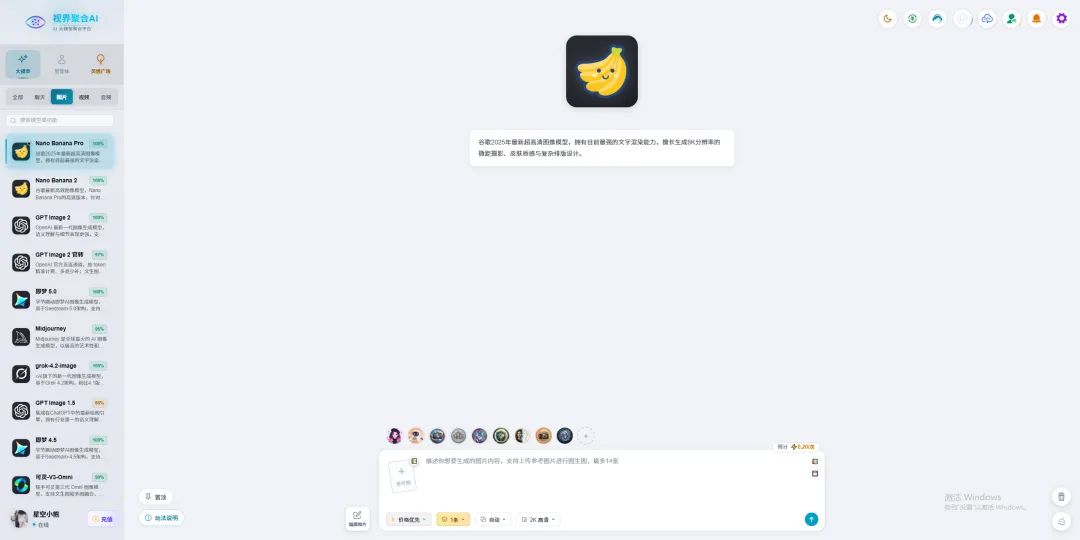
  • 图像模型:Nano Banana Pro、GPT Image 2、Midjourney、即梦5.0、grok-4.2-image...
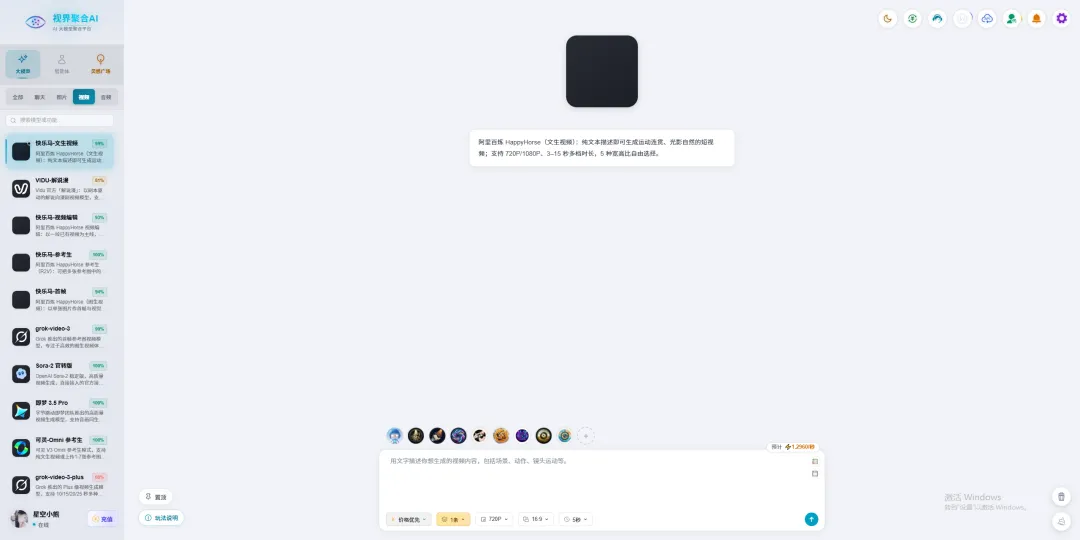
  • 视频模型:阿里百炼HappyHorse、VIDU、Sora-2、即梦3.5 Pro、grok-video-3...
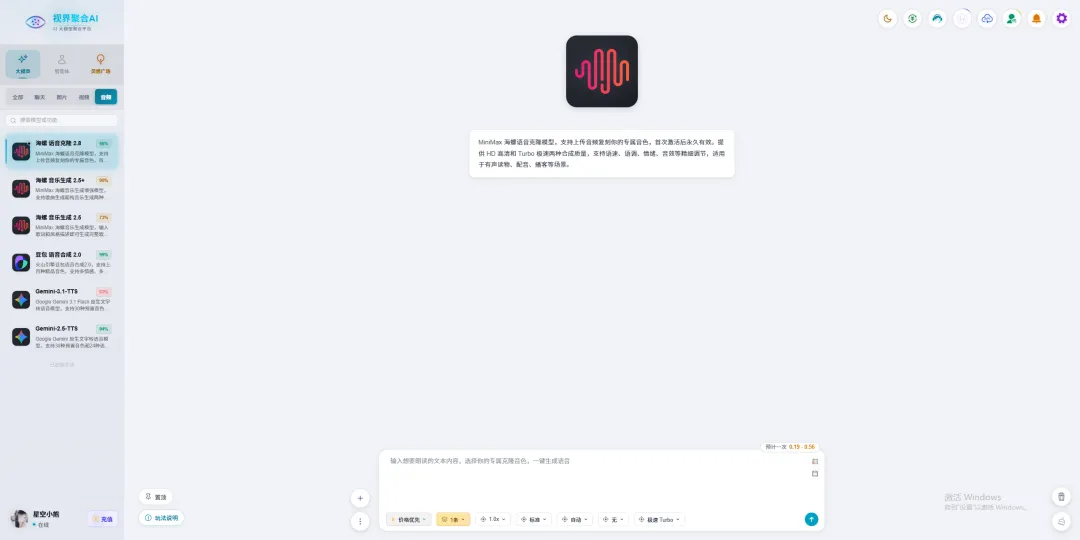
  • 音频模型:海螺语音克隆、海螺音乐生成、豆包语音合成、Gemini TTS...
粗略数了一下,超过500个AI模型,覆盖文本、图像、视频、音频全模态。
什么概念?
相当于你把OpenAI、Google、Anthropic、阿里、字节、MiniMax...几乎所有主流AI厂商的能力,装进了一个网页里。

02 最让我心动的功能:多模型协作

如果只是把模型堆在一起,那和浏览器开一堆标签页有什么区别?
这个平台真正让我觉得"有点东西"的,是它的多模型协作功能。
什么意思?
你提一个问题,平台会同时调用多个顶尖AI模型,然后自动分析对比,融合出最优答案。
具体来说有四个能力:
多元视角——GPT、Claude、Gemini等多模型同时响应,从不同角度给你答案
智能融合——AI自动分析对比各模型输出,生成最优综合答案
并行加速——多模型同时运算,不用等一个答完再问下一个
质量保障——交叉验证,减少幻觉和错误
这个功能特别适合什么场景?
  • 做深度研究分析,需要多方观点交叉验证
  • 写重要文案,想要多个风格版本做选择
  • 解决复杂问题,单一模型可能不够全面
简单说,你不用自己当"模型调度员"了,平台帮你搞定。

03 图像生成:从1K到8K,文字渲染能力拉满

作为一个经常需要做配图的人,我重点体验了它的图像生成功能。
目前接入的图像模型包括:
  • Nano Banana Pro:谷歌2025年最新超高清图像模型,支持生成8K分辨率,文字渲染能力目前最强,擅长微距摄影、皮肤质感与复杂排版设计
  • Nano Banana 2:高速版本,出图更快
  • GPT Image 2:OpenAI最新一代图像生成模型,语义理解与细节表现更强
  • Midjourney:全球最火的AI图像生成模型,艺术性极高
  • 即梦5.0:字节跳动出品,基于Seedream-5.0架构
  • grok-4.2-image:xAI旗下新一代图像生成模型
而且它支持图生图功能——上传参考图,最多14张,AI可以基于参考图生成新图。
这个功能做电商产品图、品牌视觉延展,非常好用。

04 视频生成:文生视频、图生视频全都有

视频这块,目前接入的模型包括:
  • 阿里百炼HappyHorse:纯文本描述即可生成运动连贯、光影自然的短视频,支持720P/1080P、3-15秒多档时长
  • VIDU:以剧本驱动的解说向漫剧视频模型
  • Sora-2:OpenAI Sora-2稳定版
  • 即梦3.5 Pro:支持音画同步
  • grok-video-3:首帧参考图视频模型
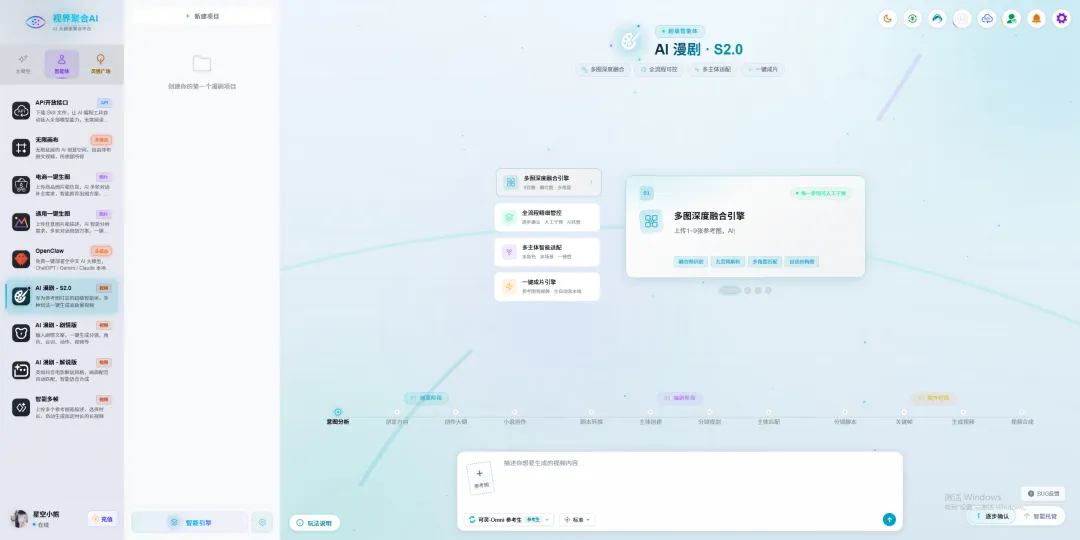
最让我觉得实用的是AI漫剧功能——
上传1-9张参考图,AI可以自动进行多图深度融合,然后一键生成视频。
整个流程是:意图分析→创意方向→创作大纲→小说创作→剧本转换→主体创建→分镜规划→主体匹配→分镜脚本→关键帧→生成视频→视频合成。
全流程可控,每一步都可以人工干预。
对于想做短视频但不会拍不会剪的人来说,这个功能太友好了。

05 音频能力:语音克隆+音乐生成

音频方面,主要接入了MiniMax的海螺系列和豆包的语音合成:
  • 海螺语音克隆2.8:支持上传音频复刻你的专属音色,首次激活后永久有效,提供HD高清和Turbo极速两种合成质量
  • 海螺音乐生成2.5+:支持歌曲生成和纯音乐生成
  • 豆包语音合成2.0:支持上百种精品音色
语音克隆这个功能,做有声书、播客、视频配音,非常实用。

06 智能体:不只是对话,还能帮你干活

除了基础的对话、画图、做视频,这个平台还有智能体功能。
目前已上线的智能体包括:
  • AI漫剧·S2.0:专为参考图打造的超级智能体,多图深度融合,全流程精细管控
  • AI漫剧·剧情版:输入剧情文案,一键生成分镜、角色、台词、动作、视频等
  • AI漫剧·解说版:类似抖音电影解说风格,画面配音自动匹配
  • 智能多帧:上传多个参考图和描述,选择时长,自动生成指定时长的长视频
  • 电商一键生图:上传商品图片和信息,AI多轮对话补全需求,智能推荐出图方案
  • 通用一键生图:上传任意图片和描述,AI智能分析需求,多轮对话规划方案
  • 无限画布:无限延展的AI创意空间,自由排布图文视频
  • OpenClaw:免费一键部署全中文AI大模型
这些智能体相当于把复杂的工作流封装成了"一键操作",降低了使用门槛。

07 适合谁用?

说实话,这个平台不太适合AI小白——
因为功能太多太专业,新手上来可能会懵。
但它非常适合这几类人:
内容创作者:写文章、做配图、剪视频、配音频,一个平台全搞定
中小企业主:做产品图、宣传视频、营销文案,不用养一个团队
自媒体运营:多平台分发需要大量素材,这个平台产能拉满
AI研究者/开发者:想对比不同模型效果,不用到处注册账号
普通用户:就是好奇想体验各种AI能力,一个账号就够了

08 一些客观评价

用了几天,说几点真实感受:
优点:
  • 模型覆盖面确实广,基本主流的都接入了
  • 多模型协作功能有差异化,不是简单的模型堆砌
  • 界面设计清晰,分类明确,找模型不费劲
  • 智能体功能降低了复杂工作流的使用门槛
  • 支持图生图、参考图生成,实用性高
可以改进的地方:
  • 部分模型显示"加载中",可能还在接入中
  • 价格体系需要进一步了解,不同模型计费方式可能不同
  • 视频生成时长目前偏短(3-15秒),长视频需求可能不够
  • 作为聚合平台,稳定性和响应速度取决于各模型方

09 最后说两句

AI工具市场现在确实很卷。
但卷的方向不应该是"我又接了几个模型",而是"我怎么让用户用得更好"。
从这个角度看,视界聚合AI的多模型协作、智能体工作流、全流程可控这些设计,确实是在解决真实问题。
不是把工具堆给用户,而是帮用户把工具用好。
这个思路,我认可。
如果你也在为AI工具太多太分散而头疼,或者想一站式体验各种AI能力,不妨去试试。

视界聚合AI聚合500+全球顶尖大模型智能对话 / 图像创作 / 视频生成 / AI智能体一个平台,释放无限可能
PS:平台目前有邀请机制,感兴趣的朋友可以扫码了解。
你觉得AI聚合平台是未来趋势吗?欢迎在评论区聊聊你的看法。

相关学习资料