 夜雨聆风
2026大厂AI工程师面试必考:Spring AI核心50题精讲
适读人群:准备2026年春招/秋招AI相关岗位的Java工程师
阅读时长:约20分钟
文章价值:50道高频面试题 + 深度答案解析 + 源码追踪
面试趋势分析
2026年,AI工程师面试呈现三大趋势:
- 框架层深度考察
:不再停留在"会用",要求理解源码原理 - 系统设计必考
:给你一个业务场景,要你设计完整的AI应用架构 - 生产问题排查
:如何排查LLM调用慢、响应质量差、成本失控等真实问题
Spring AI作为Java AI领域的标准框架,在2026年的面试中出现频率极高。本文整理了50道最高频考题,配以深度解析。
核心概念类(Q1-Q15)
Q1:Spring AI的核心抽象层是什么?设计理念是什么?
答案:
Spring AI的核心设计理念是"用Spring的方式构建AI应用"——通过统一抽象层屏蔽不同LLM提供商的差异,就像Spring Data统一了各种数据库访问一样。
核心抽象层包括:
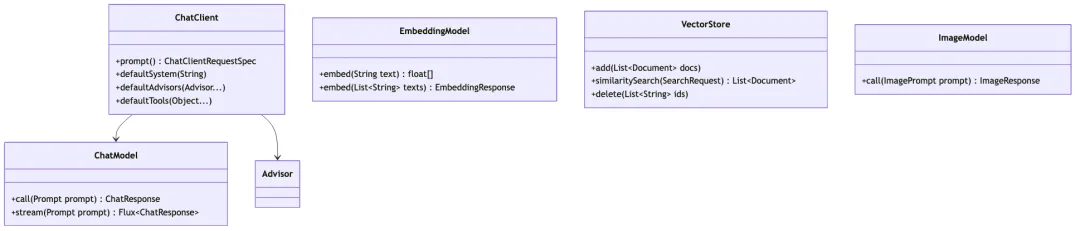
设计理念体现:
ChatModel是底层接口,不同厂商各自实现(OpenAiChatModel、OllamaChatModel等) ChatClient是高级门面,在ChatModel上叠加了Advisor链、defaultXxx配置 业务代码只依赖抽象,切换模型提供商无需改动业务逻辑
Q2:ChatClient 和 ChatModel 的区别,什么时候用哪个?
答案:
// ChatModel - 底层,无状态@AutowiredChatModel chatModel;Prompt prompt = newPrompt("解释Java虚拟机");ChatResponse response = chatModel.call(prompt);// ChatClient - 高级,功能丰富@AutowiredChatClient.Builder builder;ChatClient client = builder .defaultSystem("你是Java技术专家") .defaultAdvisors(newMessageChatMemoryAdvisor(memory)) .build();String answer = client.prompt() .user("解释Java虚拟机") .call() .content();面试答题重点:生产代码推荐ChatClient,因为它封装了Advisor链机制,让你可以透明地插入对话历史、RAG检索、日志监控等横切关注点。
Q3:Advisor机制的本质是什么?执行顺序如何?
答案:
Advisor本质是AOP思想在AI调用链中的应用。它是一种拦截器模式,允许在LLM调用前后插入自定义逻辑。
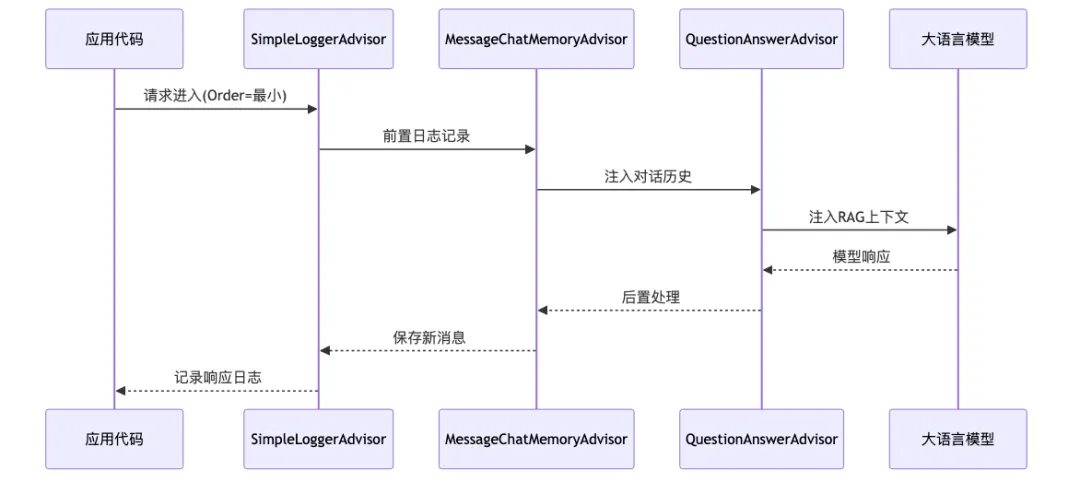
执行顺序规则:
Advisor按 Order值从小到大排列,值越小越先执行(越靠外层)- 推荐Order配置
:SimpleLoggerAdvisor(最外层) > MessageChatMemoryAdvisor > QuestionAnswerAdvisor(最内层,靠近LLM) 类似AOP的around advice:前置从外到内,后置从内到外
ChatClient client = builder .defaultAdvisors(newSimpleLoggerAdvisor(), // Order=0(最外层)newMessageChatMemoryAdvisor(memory), // Order=1newQuestionAnswerAdvisor(vectorStore, SearchRequest.defaults()) // Order=2(最内层) ) .build();Q4:Spring AI的Auto-Configuration是如何工作的?
答案:
Spring AI的自动配置遵循标准的Spring Boot Auto-Configuration机制:
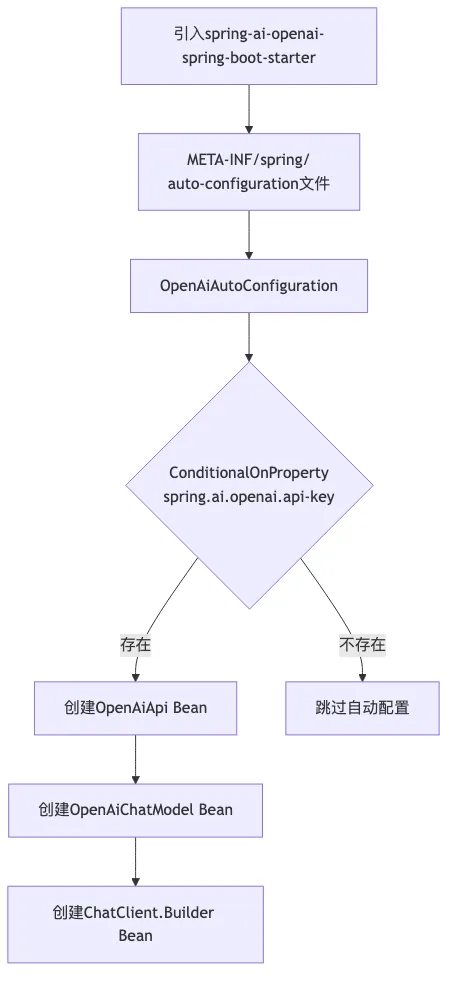
关键配置:
spring:ai:openai:api-key: ${OPENAI_API_KEY}base-url: https://api.openai.com # 可替换为代理地址chat:options:model: gpt-4otemperature: 0.7max-tokens: 2048面试加分点:提到可以通过@ConditionalOnMissingBean覆盖自动配置,注入自定义的ChatModel实现(例如实现带Mock的测试Bean)。
Q5:如何实现多LLM提供商的动态切换?
答案:
生产环境常见需求:根据不同业务场景使用不同模型(成本控制、能力互补)。
@ConfigurationpublicclassMultiModelConfig {@Bean("openAiClient")publicChatClient openAiClient(OpenAiChatModel openAiModel) {returnChatClient.builder(openAiModel) .defaultSystem("你是OpenAI驱动的助手") .build(); }@Bean("deepSeekClient") publicChatClient deepSeekClient(OllamaChatModel ollamaModel) {returnChatClient.builder(ollamaModel) .defaultSystem("你是DeepSeek驱动的助手") .build(); }}@ServicepublicclassSmartRoutingService {privatefinalMap<String, ChatClient> clientMap;publicSmartRoutingService(@Qualifier("openAiClient") ChatClient openAiClient,@Qualifier("deepSeekClient") ChatClient deepSeekClient ) {this.clientMap = Map.of("premium", openAiClient,"standard", deepSeekClient ); }publicString chat(String query, String tier) {ChatClient client = clientMap.getOrDefault(tier, clientMap.get("standard"));return client.prompt().user(query).call().content(); }}RAG架构类(Q16-Q30)
Q16:RAG的检索质量差,有哪些优化手段?
答案(按优先级排列):
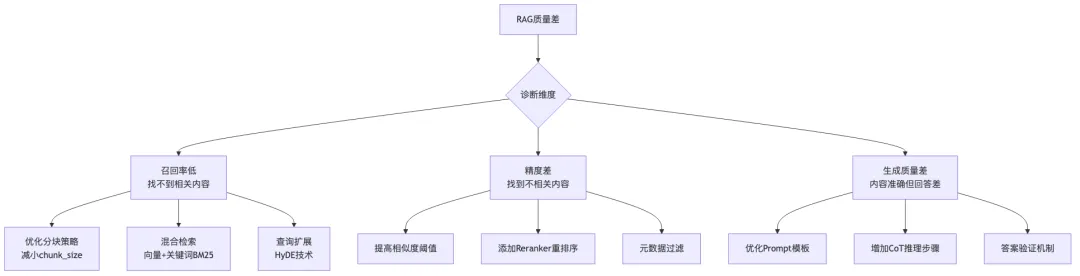
核心优化代码示例:
// 混合检索:向量检索 + 关键词检索结果融合@ServicepublicclassHybridSearchService {privatefinalVectorStore vectorStore;privatefinalKeywordSearchService keywordSearch;publicList<Document> hybridSearch(String query) {// 向量检索List<Document> vectorResults = vectorStore.similaritySearch(SearchRequest.query(query).withTopK(10) );// 关键词检索(BM25)List<Document> keywordResults = keywordSearch.search(query, 10);// RRF融合排序(Reciprocal Rank Fusion)return rerankByRRF(vectorResults, keywordResults, 5); }privateList<Document> rerankByRRF(List<Document> list1, List<Document> list2, int topK ) {Map<String, Double> scores = newHashMap<>();int k = 60; // RRF参数,通常取60for (int i = 0; i < list1.size(); i++) { scores.merge(list1.get(i).getId(), 1.0 / (k + i + 1), Double::sum); }for (int i = 0; i < list2.size(); i++) { scores.merge(list2.get(i).getId(), 1.0 / (k + i + 1), Double::sum); }return scores.entrySet().stream() .sorted(Map.Entry.<String, Double>comparingByValue().reversed()) .limit(topK) .map(e -> findDocById(e.getKey(), list1, list2)) .collect(Collectors.toList()); }}Q17:分块(Chunking)策略如何选择?
答案:
Spring AI实现父子分块:
@ServicepublicclassParentChildChunkService {privatefinalVectorStore vectorStore;publicvoid indexWithParentChild(List<Document> docs) {TokenTextSplitter parentSplitter = newTokenTextSplitter(1000, 50, true);TokenTextSplitter childSplitter = newTokenTextSplitter(200, 20, true);for (Document parent : parentSplitter.apply(docs)) {String parentId = UUID.randomUUID().toString(); parent.getMetadata().put("chunk_type", "parent"); parent.getMetadata().put("chunk_id", parentId);List<Document> children = childSplitter.apply(List.of(parent)); children.forEach(child -> { child.getMetadata().put("chunk_type", "child"); child.getMetadata().put("parent_id", parentId); });// 子块存入向量库(用于检索) vectorStore.add(children);// 父块存入关系库(用于生成时获取完整上下文) parentDocStore.save(parentId, parent); } }}生产实践类(Q31-Q45)
Q31:如何实现AI接口的限流和熔断?
答案:
@ServicepublicclassResilientAiService {privatefinalChatClient chatClient;privatefinalRateLimiter rateLimiter;// 使用Resilience4j实现熔断+限流@CircuitBreaker(name = "aiService", fallbackMethod = "fallbackChat")@RateLimiter(name = "aiRateLimit")@Retry(name = "aiRetry")publicString chat(String message) {return chatClient.prompt() .user(message) .call() .content(); }// 降级方案publicString fallbackChat(String message, Exception e) { log.warn("AI服务降级,原因:{}", e.getMessage());return"抱歉,AI服务暂时不可用,请稍后重试。"; }}application.yml配置:
resilience4j:circuitbreaker:instances:aiService:slidingWindowSize: 10failureRateThreshold: 50waitDurationInOpenState: 30sratelimiter:instances:aiRateLimit:limitForPeriod: 100 # 每秒100次limitRefreshPeriod: 1stimeoutDuration: 500ms系统设计类(Q46-Q50)
Q46:设计一个高并发的LLM推理服务,如何保障P99延迟在5秒内?
参考答案(系统设计要点):
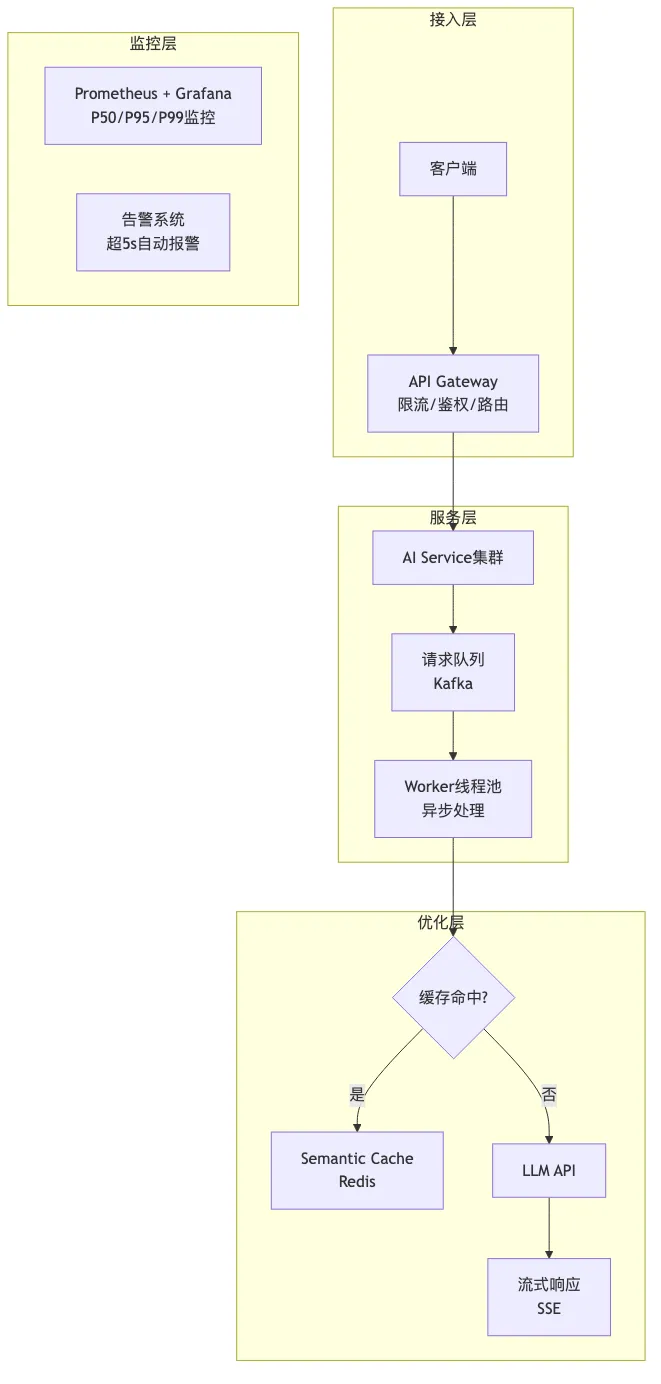
关键优化手段:
- Semantic Cache
:相似问题直接命中缓存,命中率通常20-40% - 流式输出
:首token延迟感知从5s降到1s以内 - 连接池复用
:避免每次请求重建HTTP连接 - 请求批处理
:合并相同时间窗口内的独立请求 - 模型路由
:简单问题路由到快速小模型
学习建议
Spring AI面试准备的三个层次:
- 会用
:每个API都亲手写过Demo - 懂原理
:核心类的源码看过一遍 - 能设计
:能根据业务场景给出合理的Spring AI架构方案
加入星球,少走半年弯路
写文章最难受的一件事,是篇幅到了,内容没到。
很多真正有用的东西——完整可跑的源码、踩坑血泪史、一对一答疑、简历诊断——放在公众号里要么太长,要么涉及太多私货,不太适合发出来。
所以我把它们攒在了一起,放进了「AI转型加速器」知识星球。
扫码进来,你会发现:
- 📦 完整项目源码
:每篇文章配套的完整工程,可以直接跑,省掉"为什么我的跑不起来"的时间 - 🔥 星球专属内容
:不在公众号发的进阶专栏,现在已有 150+ 篇,持续更新 - 💬 随时提问,我认真回
:架构选型、代码报错、方向选择,直接在星球问,不让你一个人扛 - 🎯 简历诊断 & 面试陪练
:看过上百份 AI 工程师简历,知道哪些写法让HR眼前一亮,哪些直接进废纸篓 - 🚀 行业动态速递
:每周大模型圈发生了什么、哪些工具值得学、哪些坑别踩——帮你把信息噪音过滤掉
目前已有 1200+ Java工程师 在里面。有人三个月后拿到了心仪的 AI 方向 offer,有人直接在老东家内部转岗成功,还有人靠星球里的项目模板把简历改头换面。
长按识别下方二维码,立刻加入 👇
进来之后发一句「打卡」,我会根据你现在的情况,给你推一份专属学习路线,不用自己摸索。
本文由「老张聊AI转型」原创发布,转载请注明出处