ARTICLE · 1034174
管道串联:从文档到答案的完整流程
管道串联:从文档到答案的完整流程
四个环节并非孤立模块,而是首尾相接的数据流水线。以个人知识库助手为例,一次完整查询的调用链路如下:
文档入库(分块 + Embedding) 原始 PDF/Markdown 按语义边界切分为 512 token 的块,每块经 text-embedding-3-small转为 1536 维向量,写入向量数据库(如 Chroma),同时保留块元数据(来源、页码)。查询处理(检索) 用户提问“去年的营收目标是多少?”→ 同一 Embedding 模型编码查询 → 在向量库中执行余弦相似度搜索,取 top-20 候选块。 精排(重排) 候选块送入 cross-encoder重排序模型,逐对计算查询-文档相关性得分,重新排序后仅保留 top-5 作为上下文。生成答案(LLM 调用) 将重排后的块拼接为上下文窗口,连同原始问题一起传给大模型,生成带引用的回答。
关键设计决策:分块大小直接影响检索粒度(块小则精准、块大则上下文连贯);Embedding 模型需与查询编码保持一致;重排阶段可显著提升 top-5 准确率(通常 +15~20%),但会增加 ~50ms 延迟——在实时助手场景中,可用“先粗排后精排”的级联策略平衡速度与质量。
调试时建议逐环节打印中间结果:检查分块是否切碎语义、检索召回是否遗漏关键文档、重排是否误杀正确块,从而精准定位瓶颈。
要点 — 向量检索管道由分块、Embedding、检索、重排四环构成,每环都影响最终答案质量,需整体调优。
光看文字描述,可能还不太容易把整个流程串起来。下面我们用一张流程图,把分块、嵌入、检索、重排这几个关键步骤直观地展示出来。
展示Agentic RAG检索管道的完整流程图,从用户查询开始,经过意图识别、检索、重排、自反思(Self-RAG/CRAG)到最终生成回答,并包含记忆系统的接入点。
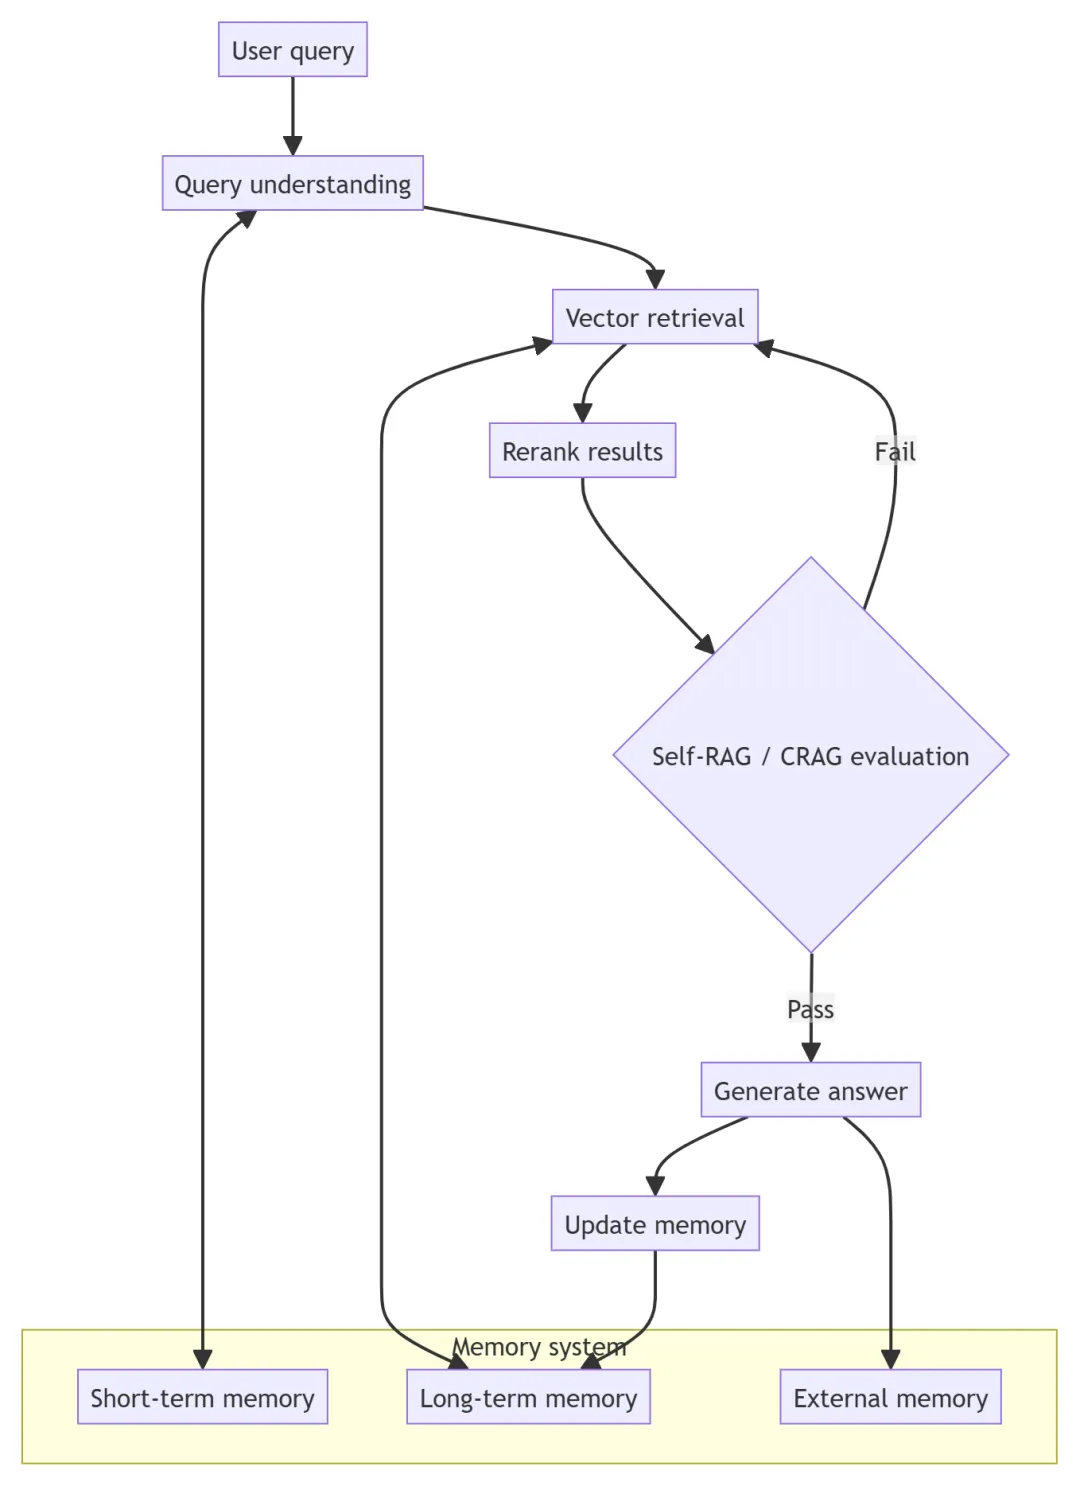
上面这张图展示了记忆与检索增强的整体流程,而管道中的每一步都会影响最终输出质量。接下来做几道小题,检验一下你的理解。
1. 关于智能体记忆系统的分类与职责,以下哪项描述是正确的?
A. 短期记忆对应上下文窗口,长期记忆对应向量库,外部记忆对应mem0/Redis等外部存储。 B. 短期记忆对应向量库,长期记忆对应上下文窗口,外部记忆对应mem0/Redis等外部存储。 C. 短期记忆对应mem0/Redis,长期记忆对应上下文窗口,外部记忆对应向量库。 D. 短期记忆、长期记忆与外部记忆均使用同一实现方案,无需区分。
✅ 答案
A
在智能体记忆系统中,短期记忆通常依赖上下文窗口(如对话历史),长期记忆常使用向量库存储和检索语义信息,外部记忆则借助mem0/Redis等外部存储实现持久化。
2. 搭建一个用于 RAG 问答的向量检索管道时,通常需要依次完成分块(Text splitter)、Embedding、top-k 检索与重排(LLM rerank / 查询增强)等环节。请按正确的顺序描述这条管道的完整搭建流程,并分别说明「分块」「Embedding」「top-k 检索」与「重排」各环节在管道中的作用。
✅ 答案
标准流程可分为离线建库与在线检索两个阶段。离线建库:① 加载并解析原始文档,用文本分割器(Text splitter)把长文档切分成语义完整、长度适中的小块——分块的作用是让检索单元粒度合适,既避免整篇长文放入上下文的高成本,又能保证每个片段语义相对独立、可被单独召回;② 用 Embedding 模型把每个文本块向量化,得到能表达语义的向量,再连同元数据一起写入向量数据库(如 Chroma)建立索引。在线检索:③ 将用户问句同样向量化,在向量库中按语义相似度(如余弦距离)匹配最相似的 top-k 个文本块——top-k 检索的作用是从海量片段中快速召回与问题最相关的候选;④ 对召回结果做重排:可用 LLM rerank(让模型按相关性对文档编号排序)或查询增强(用前几篇文档生成更具体的新查询再检索),以提升最终进入上下文的片段质量。最后把重排后的文本块作为上下文与问题一起放入 prompt,交给大模型生成答案。整体对应「数据处理→检索→增强→生成」的 RAG 四步流程,其中检索与重排的质量(精确率、召回率)对最终回答影响最大。
这道题考查向量检索管道的搭建顺序与各环节职责。正确顺序是「分块 → Embedding → 建索引 → 问句向量化 → top-k 检索 → 重排 → 入 prompt 生成」。分块决定检索单元的粒度,Embedding 把文本映射为可计算语义相似度的向量,top-k 检索负责快速召回候选,重排(LLM rerank / 查询增强)则对召回结果进一步精排,提升送入上下文的质量。检索与重排环节的精确率和召回率是影响 RAG 整体效果的核心工程点。
**3. 与「固定流程的普通 RAG」相比,自反思检索模式(Self-RAG / CRAG 精神)与 Agentic RAG 在「谁来决定检索」这一问题上发生了本质变化。请围绕以下三个层面展开论述:
(1)为什么说「检索不保证正确」是这类模式存在的根本动机?请结合「召回错误片段时,模型可能围绕错误材料生成看似合理的答案」这一现象加以说明。
(2)自反思检索与 Agentic RAG 分别如何让模型参与检索决策?请说明「反思/评估检索结果并决定是否修正或继续检索」与「把检索注册为工具、由模型自主决定何时搜索、搜索什么、是否继续搜索、何时结束」这两种机制的区别与联系。
(3)这类模式在什么场景下适用、什么场景下可能并不划算?请给出你的判断并说明理由。**
✅ 答案
参考答案要点:
(1)检索不保证正确是这类模式存在的根本动机。普通 RAG 按固定流程检索一次再生成,隐含假设「检索到的就是相关的」;但实际中检索可能召回错误或不相关的片段,而模型本身缺乏对检索质量的判断,可能围绕错误材料生成看似合理实则错误的答案。因此必须引入模型对检索结果的反思与评估,才能降低这种风险。
(2)两种机制都让模型参与检索决策,但层次不同。自反思检索(Self-RAG / CRAG 精神)在检索后增加「评估」环节:模型判断检索结果是否充分(Self-RAG 的反思令牌),CRAG 则对检索质量分级,不足时降级为网络搜索或知识精炼,必要时修正后继续检索。Agentic RAG 更进一步,把检索注册为工具(如 Function Calling),由模型在生成过程中自主决定何时调用、调用几次、是否继续搜索,形成「思考→检索→观察→再思考」的多轮闭环(如 Search-R1 的轨迹 τ=(x,a₁,o₁,a₂,o₂,…,a_T))。区别在于:前者是「检索后反思」,后者是「检索全程由模型编排」;联系在于二者都承认检索不可靠,并把决策权交给模型。
(3)适用场景:问题开放、答案分散在多个文档、需要多轮求证、知识更新频繁、对可追溯性和准确性要求高的场景(如研究型问答、个人知识库智能体)。不划算的场景:简单事实问答、检索一次即可满足、对延迟和 token 成本敏感的场景——多轮检索会增加时延与成本,且模型自身的检索决策也可能出错,需要设置步数上限与预算。
本题考察自反思检索模式与 Agentic RAG 的原理及适用场景。核心在于理解「检索不保证正确」这一前提:普通 RAG 的固定流水线(检索一次→生成)隐含了「检索结果必然相关」的假设,一旦召回错误片段,模型可能围绕错误材料生成看似合理的答案。自反思检索(Self-RAG/CRAG 精神)在检索后引入评估/反思环节,判断结果质量并决定是否修正或继续检索;Agentic RAG 则把检索注册为工具,由模型自主编排检索时机与次数(如 Search-R1 的多轮轨迹)。两者都把检索决策权交给模型,区别在于反思发生在检索后、编排贯穿检索全程。适用场景上,这类模式适合开放、分散、需多轮求证的高准确性任务,而在简单问答或对延迟成本敏感的场景下,多轮检索的额外开销可能并不划算。
不过,基础管道虽然能完成检索,却未必能保证答案的可靠性。接下来,我们看看如何让智能体学会“质疑”和“修正”检索结果,这就是自反思模式的核心思路。
传统 RAG 一次检索、一次生成,结果质量取决于首次召回。Self-RAG 与 CRAG 引入自反思机制,让模型在生成前后评估证据质量,动态决定是否重试或修正,从而提升可靠性与可追溯性。