ARTICLE · 1035511
Jev 深度解读:当 AI 不再说话,只做决定
Jev 深度解读:当 AI 不再说话,只做决定
本文所有技术描述、参数、价格、代码示例与局限性说明,均取自 TypeSafe AI 官方博客、官方文档站(docs.typesafe.ai)与官方评测页,附原文链接。全文不引入未经官方确认的说法。
一、30 秒速览
jev-1.13.0,别名 jev-latest / jev-preview) | |
POST /v1/systemone | |
state + 所有问题);state + 最长单个问题 32k | |
一句话概括官方自己的定义:"unstructured state in, typed probabilistic decisions out" —— 非结构化状态进,类型化概率决策出。
Almeida 把它比作"一次前沿智能的函数调用"。这个比喻是理解全文的钥匙。
二、它到底解决了什么问题
2.1 官方给出的问题诊断
TypeSafe 的立论建立在一个观察上:模型在"聊天"上超人类已经好几年了,但自动化在哪里?
官方首页把矛头指向 RLHF 本身——用人类偏好训练出来的模型,天然带有三个遗留问题:
mode dropping(模式坍缩):输出收敛到人类爱看的那几种 overconfidence(过度自信):即使只是被"要求"给置信度,模型的估计也偏高且不稳定 lack of reliability(不可靠):自由度意味着随时可能跑偏
官方那句最扎心的话是:如果一个模型能 95% 做对一件事,但它不会告诉你剩下 5% 是什么情况,那这件事就无法被自动化。
这句话是整个产品逻辑的起点。自动化不缺"聪明",缺的是知道自己什么时候不确定。
2.2 具体到工程上,LLM 做决策的损耗在哪
官方文档把这件事拆得很清楚。用 LLM 做一个"让代码消费的判断",本质上是在做一次反向适配:
| 数学上不可能 | ||
官方对"幻觉"和"类型安全"的关系有一句判断值得抄下来:
在 Agent 里,一次幻觉的工具调用只是不方便;但如果它处在一个有延迟保证的系统里,或者埋在依赖链的深层,那就是绝对的 deal-breaker。
2.3 三个原语:它的"输出空间"长什么样
Jev 不自创答案,所有可能的输出都由你提前定义。定义方式是通过三个原语(官方叫 AI primitives):
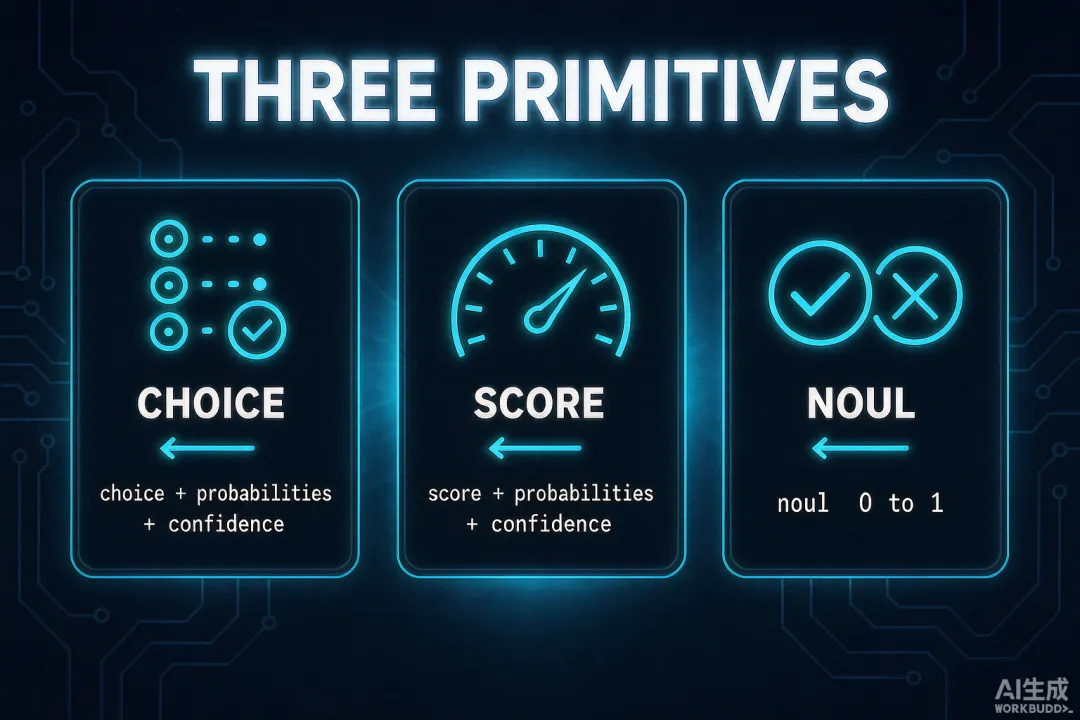
| Choice | choiceprobabilities、confidence | |
| Score | scoreprobabilities、confidence | |
| Noul | noul |
三个原语可以在同一次 API 调用里混用。官方强调两点:
所有问题并行、独立地对同一份 state求值。增加问题几乎不增加响应时间;而且因为每个问题独立求值,不会产生问题之间的 context rot(上下文互相污染)。
第三点更关键——Choice 最多支持 255 个离散选项。超过时会走一个两阶段流程:先独立打分,再做一次显式选择。
三、它为什么快、为什么"便宜得离谱"
三个技术支点,全部是官方的说法:
1. RLCD:Reinforcement Learning for Calibrated Decisions(面向校准决策的强化学习)
这是 TypeSafe 自己提出的训练方法,对标的是 RLHF / RLVR。它优化的目标不是"人类喜欢",也不是"可程序化验证",而是回答里那个概率是否与真实正确率对齐。
官方给的目标很具体:如果 Jev 给了 80% 置信度,那么在一批同类案例上,它的正确率应该接近 80%。
2. 并行采样器(parallel sampler)
LLM 逐 token 自回归,本质上无法绕过串行瓶颈。Jev 一次查询返回全部输出,官方说法是"hardware-aware",对硬件并行度友好。
3. 放弃字符串生成
这是它最大胆的一步。官方原话是:"Giving up strings actually gives us a lot of superpowers"——放弃生成字符串,反而换来了一堆超能力。
代价也很明确:Jev 不能陪你聊天,不能写文案,不能生成代码,不能解释它为什么这么判断。
四、企业级场景:官方给出的用法
这是本文的重点。以下场景全部来自官方文档与官方示例,不是我的推演。
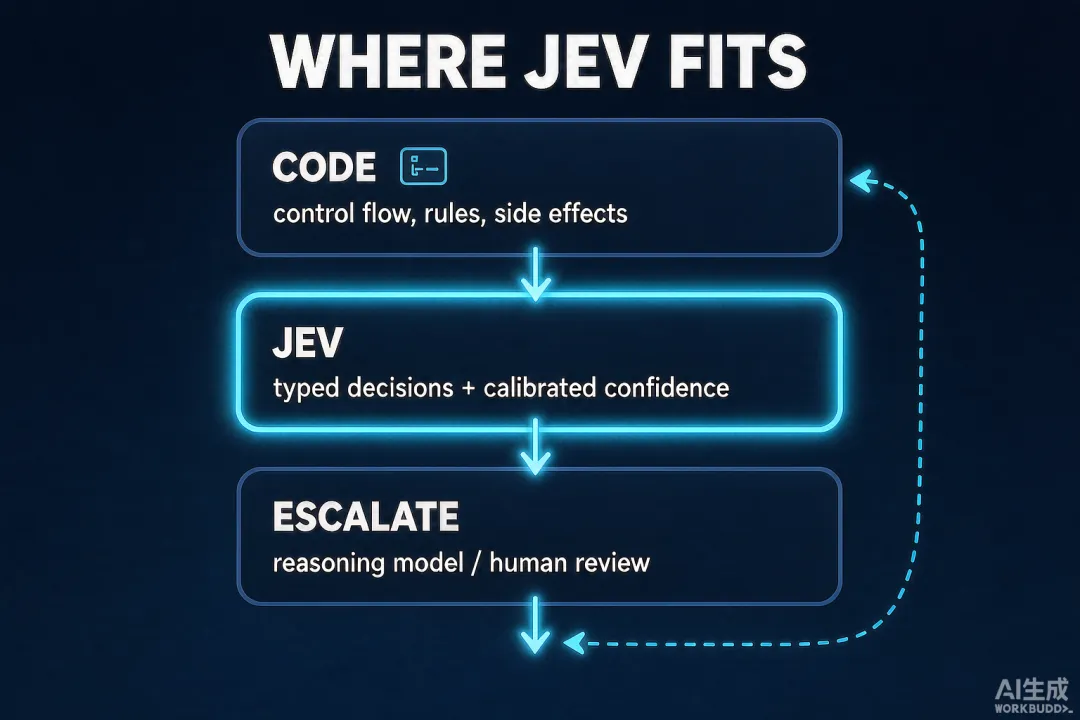
4.1 核心架构主张:AI 驱动的软件,而不是 Agent
官方明确区分了三种架构:
| LLM Agent | ||
| AI-powered software | 代码掌握控制流,模型只出现在需要"可编程常识"的地方 |
官方的一句话总结是:"Build a normal software workflow and insert System One only where AI is needed." 按普通软件的方式搭建工作流,只在需要 AI 的地方插入 System One。
这条主张直接决定了它适合什么场景:不是替代 Agent,而是给 Agent 系统补上"可靠的判断层"。
4.2 场景一:客服工单分流(官方 capstone 示例,完整可跑)
这是官方文档里最完整的一个例子,我把它拆开讲。
第一步:能用代码解决的,绝不调模型。
deftriage_ticket(ticket, customer):# 确定性状态直接处理,零模型调用if ticket["status"] == "closed":return"no_action" open_orders = [o for o in customer["orders"] if o["status"] != "delivered"]第二步:只把问题需要的上下文塞进 state。
state = {"ticket": {"message": ticket["message"], "sender": ticket["sender"], "links": ticket["links"]},"customer": {"plan": customer["plan"], "open_orders": open_orders},"policy": {"sensitive_credentials": ["password", "security code", "API key"]}, }第三步:一次并行问出一堆原子问题。
Choice:工单主题(billing / orders / account),每个选项都带what/not_for/examplesNoul:是否索要敏感凭证、发件人身份是否不符、是否承诺意外奖励、是否要求退款、是否提到未完成订单Score:客户愤怒程度(平静 / 不满但克制 / 非常愤怒),每档带what+signals
第四步:在代码里加权组合,代码(而非模型)决定权重。
spam_risk = (0.45 * answers["requests_credentials"].noul + 0.30 * answers["sender_identity_mismatch"].noul + 0.25 * answers["unexpected_reward"].noul)第五步:按置信度路由,人工兜底。
spam_is_uncertain = 0.4 < spam_risk < 0.6if spam_is_uncertain or answers["topic"].confidence < 0.75:return route_to_human_review(ticket)这个例子里最值得学的一点:"要不要转人工"不是模型说的,是代码用置信度阈值算出来的。 模型只负责提供诚实的概率。
4.3 场景二:Agent 工具调用的验证层(Verify everything)
官方把"验证"单独列为一大类用途:对 LLM 的 prompt、推理轨迹、输出做打分、判定、验证、护栏和越狱检测。
以"验证一次工具调用轨迹是否正确"为例,官方给出的写法是把一个宽泛问题拆成九个原子 Noul:
{"geocode_tool_is_relevant":"'trace.tool_calls[0].name' 是否是解析该地点的合适工具?","geocode_location_matches":"参数里的城市是否与请求地点一致?","geocode_arguments_match_schema":"参数是否符合工具 schema?","geocode_result_matches_call":"结果里的 tool_call_id 是否对得上?","weather_tool_is_relevant":"第二个工具是否适合回答该请求?","weather_arguments_match_schema":"参数是否符合 schema?","weather_uses_geocoded_coordinates":"坐标是否与上一步结果一致?","weather_date_matches":"日期是否与请求一致?","weather_unit_matches":"单位是否与请求一致?"}为什么要拆?官方反复强调的理由是:宽泛的问题把多个判断藏在一个答案里,你没法检查、没法调参、也没法在代码里组合。原子问题把这些判断暴露出来。
4.4 场景三:大规模分类、特征提取与 map-reduce
官方列出的典型用途包括:
实时特征提取、自动化分类、欺诈与异常检测 推荐系统、数据路由决策、大规模 ETL 工作流 "在海量数据上做 map-reduce,把 PB 级数据变成特征和洞察"
成本结构是这里的关键:输入 $0.042/MTok、输出免费、延迟百毫秒级。当单价低到两个数量级以下,"每个数据点都问一次模型"才第一次在经济上成立。
4.5 场景四:把概率当作下游经典 ML 模型的特征
这是官方文档里一个容易被忽略、但对数据团队很有价值的用法:
用 Jev 产出的概率作为特征,去训练一个下游的经典机器学习模型(官方在 AutoResearch cookbook 里给了完整流程)。如果没有标签,官方建议用一组昂贵推理模型的集成来生成标签。
这等于把 Jev 定位成特征工程的一个可编程环节,而不是终点。
4.6 场景五:实时应用
官方原话:"100ms 的速度意味着你可以在 UX 关键的应用里使用 AI。"
这是 LLM 结构性做不到的位置——3 秒起跳的延迟,注定进不了同步请求路径。官方甚至用它跑 Doom,以每秒约 10 次查询的频率做成一个反应式 bot,估算成本 约 $7/小时。
官方对这个 demo 的自我限定:这是结构化游戏状态的演示,不是图像;而且"一个非 AI 的 Doom bot 能打得更好"。它想证明的是响应性和指令跟随,不是性能超越。
五、正确用法:官方的八步工作流
官方文档给了一套很克制的方法论,我提炼成八条,其中第 4 条是我认为最重要的一条。
1. 能用代码就算代码。 确定性逻辑留在代码里——可靠且便宜。不要用 Agent 的 while 循环去表达一个软件工作流能表达的东西。
2. 拆解输入状态。 只放与当前问题相关的上下文。
3. 用结构化输入。 用嵌套 JSON,并用反引号点号路径在问题里精确指向字段,例如 `support.tickets[0].message`。
4. 把问题原子化——最重要的一条。
❌ 反例:Is message spam?
✅ 正例:
{"requests_credentials":"message.body 是否要求收件人提供密码或登录凭证?","offers_unexpected_reward":"是否声称收件人获得了意外奖品/付款/奖励?","creates_time_pressure":"是否施压要求快速行动?","sender_identity_mismatch":"发件人显示名与邮箱域名是否冲突?","link_domain_mismatch":"链接域名是否与发件人声称的组织冲突?","disguises_link_destination":"链接文字是否掩盖了真实去向?"}5. 在问题上也加结构。 一个 Choice 的每个选项都写清 what(属于什么)、not_for(什么应该归到隔壁选项去)、examples,并且各选项用同一套字段名,方便模型直接对比。
6. 一次问很多问题。 同一份 state 上并发大量窄问题,这是"每美元智能"最大化的方式。
7. 在代码里组合答案。 用确定性规则或加权求和。官方示例:
quality = (0.4 * answers["answers_request"].noul + 0.4 * answers["citations_are_supported"].noul + 0.2 * (1 - answers["contradicts_context"].noul))8. 按不确定性路由。 高置信度自动执行,中置信度请人确认,低置信度不要动。阈值要随风险变化——同一个系统里,只读操作的阈值应该比破坏性操作低得多。
官方推荐的置信度三段式:
| 不要行动 |
并且提醒:先用保守阈值上线,用自己的数据画"置信度 vs 准确率"曲线,再逐步调整。
六、局限:官方自己列了九条
这是本文最该细读的部分。TypeSafe 单独开了一页叫 "Jev 1.13 jaggedness"(棱角),开篇第一句就是 "Jev isn't perfect." 以下九条全部是官方原文的整理。
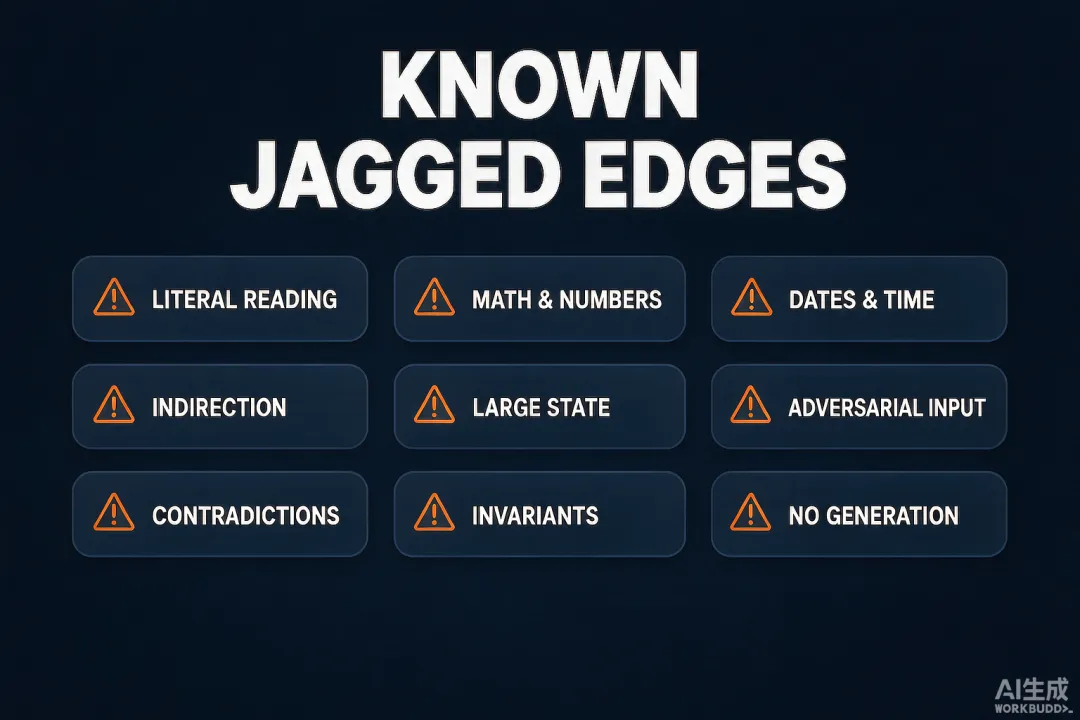
几条值得单独展开:
① 字面理解。 "它回答的是你写下的那个问题,不是你心里想的那个问题。" 作用域词、否定、隐含条件都会被按字面处理。官方给了一个非常实用的自查方法:当你看着一个错误答案、忍不住要解释"我其实是想说……"——那段解释就是你漏写的那半句指令。
② 它不会数数。 逐字计数、词频统计、长列表计数都不可靠,错误随被计数对象规模增长。官方的态度很直接:在问一个计数问题之前,先问为什么这里需要一个模型——如果正则或解析器能找到,那计数就该留在代码里。
③ 数字表示越具体越差。 用英文颜色名提问,好过用十六进制色值;问高级语言好过问汇编或二进制指令。
④ 不要用 Score 反推精确数值。 官方明确劝阻:可以用期望值判断是否越过某个阈值,但不要拿两个相邻档位去插值还原真实数字——1.13 版本的 score 档位在数值校准上是弱的。
⑤ 日期是文本,不是有序列。 判断先后、间隔、是否落在窗口内都不可靠,格式混杂、相对时间、季度/结算窗口等边界会进一步恶化。官方推荐的解法很优雅:日期每个部分都是小的闭合集合(12 个月、最多 31 天、有界的年份范围),于是"抽取"可以变成一个在枚举选项上的 Choice,还能显式放一个"未提及"选项,让缺失被报告而不是被猜测。
⑥ 对抗性内容是明确风险。 官方原话:"State is data, and jev-1.13 does not treat it as hostile by default." 注入指令、误导性框架、自我论证的文本,都能移动答案。官方说未来会改进,当前的缓解手段是写精确的 criteria 并充分测试。这一条对企业落地尤其重要——如果你的 state 里含有用户可控内容,你必须自己构建防护。
⑦ 结构不变式不成立。 这条最反直觉,官方直接给了数据:
同一个工单,问"客户是在要求退款吗?"
noul = 0.22 | |
yes = 0.01 | |
no = 0.99 | |
更极端的例子:同一个问题及其否定问两次,两个 Noul 分别是 0.72 和 0.47——加起来 1.19。
官方结论:不要指望结构恒等式成立,不要在 Noul 上调好的阈值直接搬到 Choice 上。 Choice 是相对的(在选项中定一个赢家),单个 Noul 是绝对的(可能全部都很低)。
⑧ 它不能生成文本。 强行通过链式 Choice 逼它生成,"效果不好而且会非常慢"。需要抽取时,官方建议先用正则或生成式模型列出候选,再让 Jev 从候选里选。
⑨ 其他硬约束(来自模型与文档页):
仅文本输入。 图片、音频、视频暂不支持,需要先预处理成文本或结构化字段。 英文最好。 官方明确说,包括 CJK(中日韩文字)在内的其他语言"被支持,但表现不等同",建议先用自己内容测,并在路由时特别关注置信度。 不支持客户数据微调 / LoRA。 全部账户共用同一份权重。你要定制的是 state、instructions和criteria,而不是权重。别名会漂移。 jev-latest会指向新版本,答案可能在你不知情时改变。如果你按某个版本调好了置信度阈值,请固定版本号 ID,而不是用别名。上下文 64k。 超了就得分批。 速率限制是动态调整的。 官方原话是:"我们不知道这些限制会不会变,因为我们正在处理非常大的需求。" 更高配额需要联系销售。
七、几个需要冷静看待的地方
这部分是我在读完官方材料后认为值得标出来的,都基于官方自己披露的限定条件。
1. 关于"193.6x 更快、444.6x 更便宜"这个首页数字。
官方在博客里主动把它拆开了:这个数字来自自家全新的 workflow 评测,而官方自己也列了三条偏差:
这些 workflow 由他们模型能力团队的成员构建,"可能存在的偏见是有的"; 参考答案用的是 GPT-6 Astra 与 Claude Fable 5.1 的平均值,"这会把结果偏向 OpenAI 和 Anthropic 的模型",官方认为这低估了 Jev 和 DeepSeek 模型的相对表现; 对比时给 LLM 套了官方的 System One adapter 包装,"这通常比不带概率地给决策更慢、更贵"。
官方对此的总结是:"我们预期这些数字处于真实收益的偏高区间。" 引用时请务必带上这句。
2. 关于"不产生幻觉"。
这个说法要拆开读。"不产生幻觉"的严格含义是 schema 匹配有保证,因此类型错误率是 0——官方甚至承认这一点"不是经验数据,而是数学上可确定,所以我们敢写 0%"。
但它不代表判断是对的。一个格式完全正确、概率校准良好的输出,依然可以推荐一个错误的行动。TMC 的分析把这一点说得很准:结构化输出消除了一类集成风险,但并不能让模型变得不会出错。
3. 关于可解释性。
官方承认:Jev 不输出自然语言解释。输出保持可读(类型化值 + 概率),但没有"我为什么这么判断"。
自动化程度越高、决策埋得越深,这个问题越重要。企业需要的不是一句解释,而是审计轨迹、阈值记录、升级路径和关停条件。
4. 关于"可验证"与"有佐证"的分界。
官方把自家声明分成了两类,这个态度值得尊重:
容易验证的:单次调用的速度(真的那么快)、单价(透明,但他们也承认"我们没法证明没有补贴")、无类型错误(找到一个反例就能推翻,但数学上不可能)。 更需要商榷的:智力水平、成本优势——这些靠的是自建评测。
一个能主动把自己最弱的证据链摆到台面上的厂商,比一个只放榜首数字的厂商,更值得读它的文档。
八、一页纸决策清单
适合用 Jev 的信号
你的判断有明确的有限答案空间(分类、路由、打分、抽取、是/否) 这个判断要被代码消费,不能容忍解析失败 处在同步请求路径或实时 UI 里,百毫秒级才够用 调用量极大,按 token 计费的传统模型跑不起 需要知道"模型什么时候不确定",并据此分流
不要用 Jev 的信号
需要生成文案、代码、解释、对话 需要多跳推理或复杂间接性 需要精确算术、计数、日期比较 需要图像 / 音频 / 视频输入 主要语言不是英文,且你没做过本地验证
落地时必须做的六件事
把宽泛判断拆成原子问题,权重写在代码里而不是提示词里 用代码做过滤和确定性运算,只把相关上下文交给模型 设定分级置信度阈值,破坏性操作的阈值显著高于只读操作 用自己的数据画置信度 vs 准确率曲线,再定阈值 把 state 里的用户可控内容当作不可信输入,单独做注入防护 生产和实验环境都固定版本 ID,别用 jev-latest
九、参考来源(均为官方一手)
官方发布博客(建议通读,含全部 nuance):Introducing System One Models & Jev — https://typesafe.ai/blog/introducing-system-one-models-and-jev[1] 官方文档首页 — https://docs.typesafe.ai/introduction[2] System One 概念 — https://docs.typesafe.ai/concepts/system-one[3] 如何构建(八步工作流与工单分流示例)— https://docs.typesafe.ai/concepts/how-to-build-with-system-one[4] 置信度用法 — https://docs.typesafe.ai/confidence[5] 模型、定价与限制 — https://docs.typesafe.ai/models[6] 局限性清单:Jev 1.13 jaggedness — https://docs.typesafe.ai/model-jaggedness/jev-1.13[7] 官方评测站 — https://evals.typesafe.ai/[8] 官网首页 — https://typesafe.ai/[9]
第三方媒体报道(仅用于交叉验证公司背景):The Register(含 Doom demo 与 Jevons paradox 命名的解读)、heise online、TMC Insight。其中 TMC 的分析明确提示:Jev 的评测数据来自公司自身,企业采购前应要求独立的决策准确率、校准度、可用性与变化条件下的行为基准。
本文为官方资料的整理与译述,不构成对任何模型或厂商的能力担保。所有数字与限制以 TypeSafe AI 官方页面最新版本为准。
引用链接
[1]https://typesafe.ai/blog/introducing-system-one-models-and-jev
[2]https://docs.typesafe.ai/introduction
[3]https://docs.typesafe.ai/concepts/system-one
[4]https://docs.typesafe.ai/concepts/how-to-build-with-system-one
[5]https://docs.typesafe.ai/confidence
[6]https://docs.typesafe.ai/models
[7]https://docs.typesafe.ai/model-jaggedness/jev-1.13
[8]https://evals.typesafe.ai/
[9]https://typesafe.ai/