ARTICLE · 1046423
新SOTA!星辰文档解析模型TeleOCR加冕OCR权威榜单新王
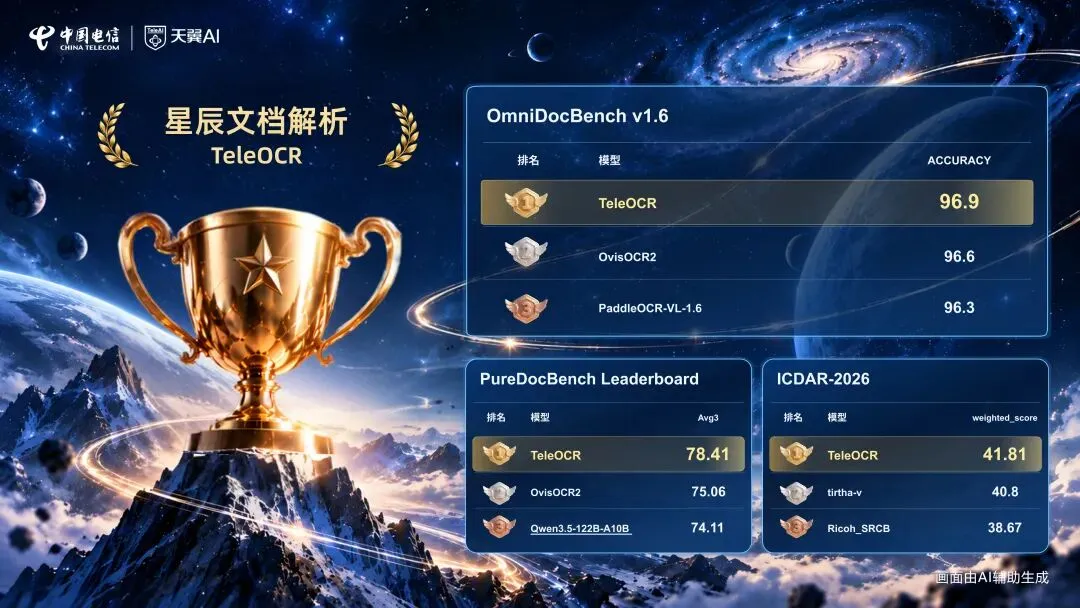
OmniDocBench是OCR领域公认最权威的榜单,覆盖9种文档类型、19种复杂布局和15个属性标签,是检验现实场景多样文档解析能力的“试金石”。
在这块最硬的“试金石”上,中国电信自研的星辰文档解析模型TeleOCR交出了优异的答卷,以96.87的总分强势登顶OmniDocBench v1.6榜单,超越了MinerU2.5-Pro、PaddleOCR-VL-1.6、OvisOCR2等同赛道专业模型。
星辰文档解析模型TeleOCR在各项能力测试中均取得亮眼成绩,直接看它的指标:
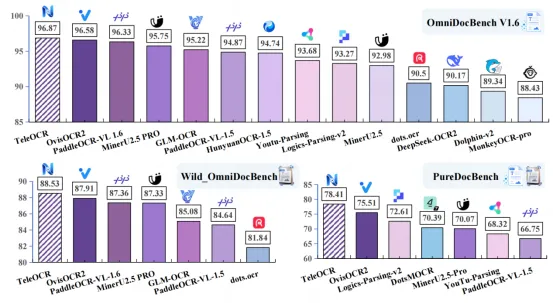
在数字文档解析方面:TeleOCR在OmniDocBench V1.6的文本识别(97.22)、表格解析TEDS(97.05)和公式CDM(96.36)上表现突出。其中,表格解析TEDS(97.05)超越OvisOCR2(94.8)和PaddleOCR-VL 1.6(94.76),大幅超过MinerU2.5-Pro(93.42);文本识别(97.22)同时超过PaddleOCR-VL 1.6(96.7)和MinerU2.5-Pro(96.4)。
在实拍文档解析方面:TeleOCR在Wild-OmniDocBench的文本识别(88.3)、表格解析TEDS(89.05)和公式CDM(88.26)上展现出较强表现。其中,Wild-OmniDocBench表格解析TEDS(89.05)超过OvisOCR2(85.13)和PaddleOCR-VL 1.6(81.31),公式CDM(88.26)同时超过MinerU2.5-Pro(85.0)和GLM-OCR(79.7)。
在多场景综合解析方面:TeleOCR在PureDocBench的Clean(86.90)、Digital Degraded(77.47)和Real Degraded(70.85)上表现突出。其中,Clean(86.90)超越OvisOCR2(81.55)和FD-RL(78.38),Real Degraded(70.85)同时超过OvisOCR2(66.56)和Logics-Parsing-v2(67.64)。
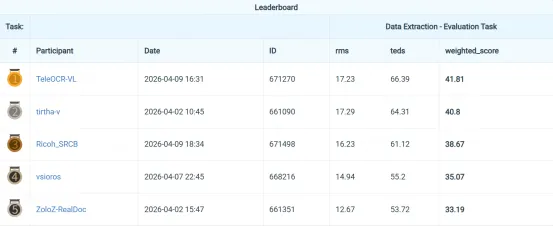
在各项文档解析能力中,科学图解析是难度最高的能力之一,涉及图表元素识别、数据提取与逻辑理解等多重挑战。针对这一难点,星辰文档解析模型TeleOCR开展了专项优化,最终凭借总分41.81的成绩,夺得文档权威会议ICDAR-2026科学图解析挑战赛冠军。
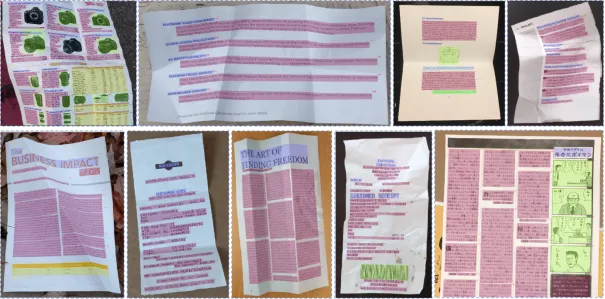
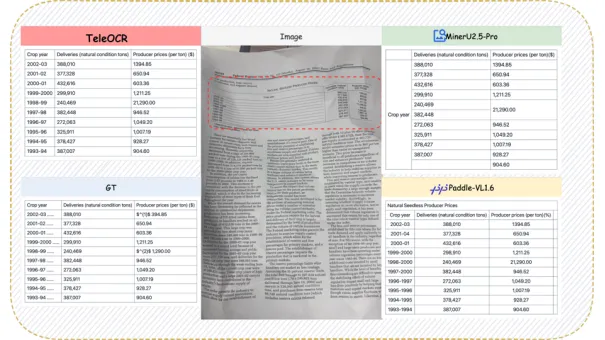
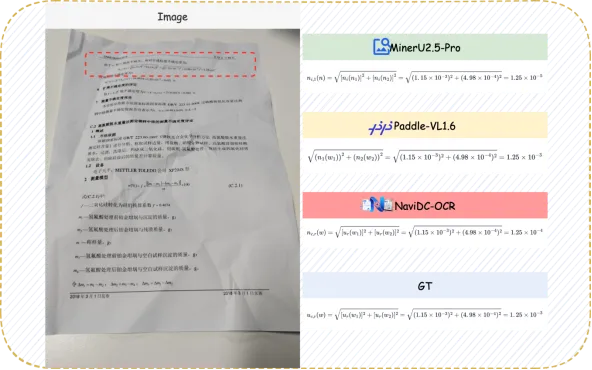
星辰文档解析模型TeleOCR在场景实测中同样表现优异,直接看它的效果:
复杂拍照文档:感知文档区域的几何形变,精准恢复扭曲区域的空间位置。
复杂表格:精确还原跨行跨列、单元格合并的复杂表格,行列表系不乱、不串位。
复杂扭曲实拍公式:结构化解析公式语义与语法结构,实现公式的符号级准确恢复。
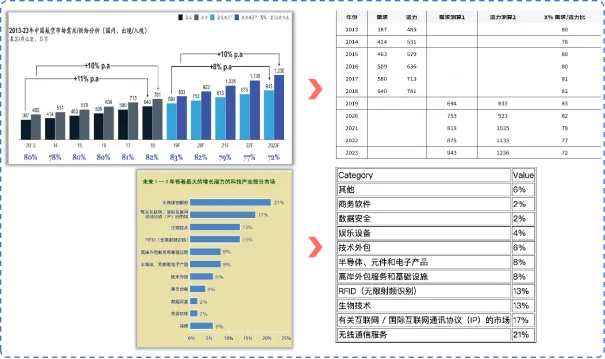
除此以外,星辰文档解析模型TeleOCR还可以直接提取论文里折线图、柱状图的数据,并转成结构化表格——这正是拿下ICDAR 2026科学图解析冠军的能力。
目前,星辰文档解析代码与模型已开源至Github和HuggingFace,欢迎下载使用。
论文/代码:
https://github.com/caipeng328/TeleOCR
模型权重:
https://huggingface.co/StarDoc-AI/TeleOCR
在线体验:
https://www.teleai.com.cn/docparse/documentParsing
参考数据:
https://github.com/opendatalab/OmniDocBench
https://github.com/zhihengli-casia/puredocbench/
https://arxiv.org/html/2607.26848v1