ARTICLE · 1048190
重新理解 AI 系列40:不是所有任务都需要 Agent:什么时候 Workflow 更好?
副标题:从任务复杂度、不确定性、风险边界出发,判断 AI 应用到底该用问答、工作流,还是 Agent
引言
在上一篇《重新理解 AI 系列39:Agent 设计模式:不是万能大脑,而是任务循环的增强方式》里,我们讨论了几个最基础的 Agent 设计模式。
计划-执行,让复杂任务有步骤;工具优先,让判断贴近事实;草稿-验证,让结果接受检查;人工验收,让风险和责任回到人类边界。
这些模式很重要。
但讲完它们之后,我觉得反而要马上踩一脚刹车。
因为越是理解 Agent,越容易产生一个新的误解:既然 Agent 能规划、能调用工具、能观察反馈、能修正路线,那是不是所有 AI 应用都应该尽量 Agent 化?
我的答案很明确:不是。
很多任务不需要 Agent。甚至有些任务,一旦强行做成 Agent,反而会更慢、更贵、更难调试,也更不可控。
所以这一篇,我想和你一起讨论一个非常实际的问题:
面对一个具体任务,我们到底应该用单轮问答、Prompt 模板、固定 Workflow,还是 Agent?
这不是名词之争。它关系到一个 AI 应用能不能稳定运行、能不能被测试、能不能被监控,出了问题能不能复盘。
Anthropic 在《Building effective agents》里有一个很有用的区分:workflow 更像是预设路径,agent 更像是让模型在执行中动态决定过程和工具使用。LangGraph 和 OpenAI Agents SDK 的文档里,也都能看到类似的工程取舍:有些流程适合代码编排,有些环节适合让模型动态判断,而真实系统往往会把它们组合起来。
你可以先记住一句话:
不是所有任务都值得交给 Agent。很多时候,固定 Workflow 不是落后,而是更可靠。
一、先把几个层级分清楚
我们先把几个常见形态放到同一条线上看。
第一种,是单轮问答。
用户问一个问题,模型生成一个回答。比如解释一个概念、润色一段文字、总结一小段内容。它的特点是:任务边界比较小,基本不需要连续执行。
第二种,是Prompt 模板。
输入可能不同,但任务方式相对固定。比如“把用户反馈整理成三类问题”“把会议纪要整理成固定格式”“按照某个风格生成一段说明”。这里已经不只是随便聊天了,而是有比较固定的输入、输出和格式要求。
第三种,是Workflow,也就是工作流。
Workflow 通常由多个步骤组成,但步骤顺序相对稳定。比如先读取数据,再清洗字段,再调用模型做分类,最后生成结构化结果。中间可以有 LLM,也可以有普通程序、规则、数据库查询、API 调用。
第四种,才是Agent。
Agent 的特点不是“步骤多”,而是路径需要在执行过程中动态决定。它有目标,但下一步怎么走,可能要看工具返回什么、文件里发现什么、用户确认什么、验证结果是否通过。
这里的四个层级不是官方标准分类,而是一个帮助我们判断自动化程度的理解工具。
它们不是从“低级”到“高级”的关系。
更准确地说,它们是从确定性更强,逐渐走向动态性更强。
单轮问答最轻,Workflow 最稳,Agent 最灵活。问题不在于哪个名字更时髦,而在于你的任务到底需要多少灵活性。
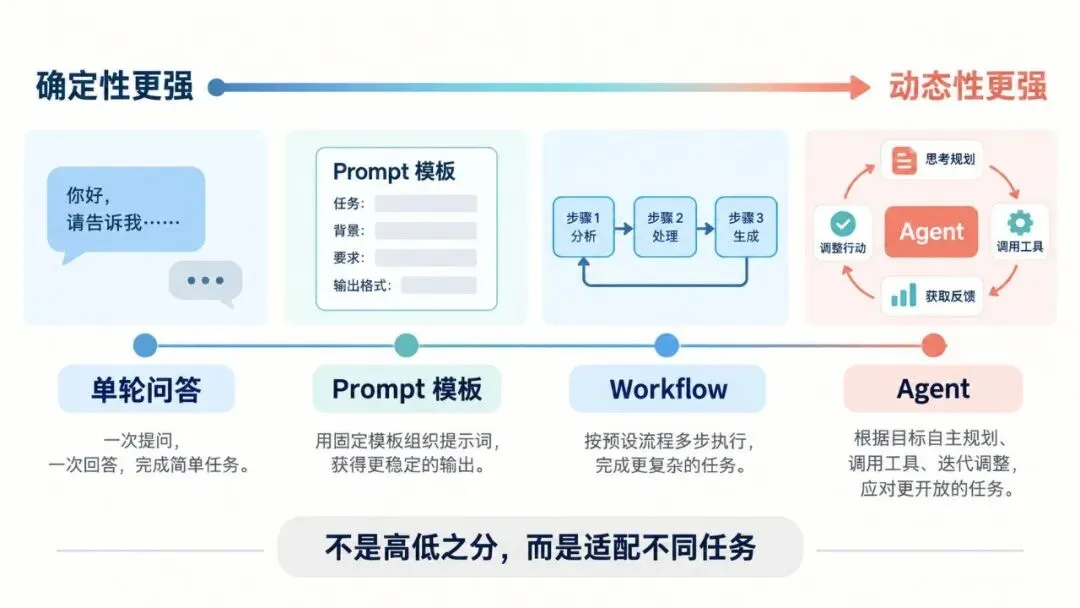
图:单轮问答、Prompt 模板、Workflow、Agent 不是“低级到高级”的关系,而是从确定性更强走向动态性更强。
二、Workflow 不低级,它只是把不确定性提前消化掉了
现在一说 Agent,很多人会下意识觉得 Workflow 好像“不够智能”。
我觉得这个直觉要反过来。
在工程里,Workflow 很多时候不是落后,而是成熟。
因为 Workflow 的前提是:我们已经把任务中的大部分不确定性提前想清楚了。
它知道第一步做什么,第二步做什么,什么时候分支,什么时候失败,什么时候重试,什么时候停止。
这听起来没有 Agent 那么“自由”,但自由本来就不是免费的。
Workflow 的好处非常具体:更容易测试,更容易监控,更容易复盘,也更容易控制成本。
你可以拿固定输入跑一遍,看输出是否符合预期;也可以记录每一步是否成功、耗时多少、失败在哪个节点。一旦出问题,你更容易判断是数据错了、规则错了、模型输出错了,还是某个接口返回异常。
这就是 Workflow 的价值。
Workflow 的优势,不是它更聪明,而是它更稳。
比如固定格式的信息抽取、标准化报表生成、简单审批流、按规则查询和汇总,这些任务本来就有明确步骤。强行让 Agent 每次自己规划,不但没有必要,还可能引入额外的不稳定。
如果一条路每天都一样,你没有必要每天让一个向导重新探索一遍。
三、Agent 真正适合什么任务?
那什么时候才值得上 Agent?
我觉得关键不在于“任务有几步”,而在于“下一步能不能提前写死”。
Agent 真正适合的是路径不确定的任务。
比如,你要排查一个复杂故障。一开始你不知道问题在日志、配置、权限、网络、数据库,还是最近一次变更。你只能先看一个线索,再根据线索决定下一步。
比如,你要让 AI 辅助修改一段真实代码。它不能只凭经验直接改。它需要先读现有实现,理解调用链,可能还要运行测试,看到失败信息之后再调整方案。
再比如,你要做一次开放式资料调研。一开始你不知道哪些来源有用,也不知道哪些问题会在中途冒出来。调研过程本身就需要不断追问、筛选、验证和改写方向。
这些任务的共同点是:目标相对明确,但路径不能完全提前写死。
中间结果会改变下一步。
工具调用结果会改变判断。
验证反馈会改变计划。
这时候,Agent 的价值才体现出来。
Agent 不是为了多走几步,而是为了在不知道下一步时,能够根据反馈决定下一步。
所以,一个三步任务不一定需要 Agent;一个看起来只有一句话的任务,如果背后需要不断探索,也可能需要 Agent。
关键不在步数,而在不确定性。
四、判断标准一:任务路径是否稳定?
第一个判断标准很简单:
这个任务的路径稳定吗?
如果路径稳定,优先考虑 Workflow。
如果路径不稳定,再考虑 Agent。
你可以问自己几个问题:
这个任务的步骤能不能提前写出来?
每次执行是不是大致相同?
中间结果会不会经常改变后续步骤?
异常分支能不能提前列清楚?
如果答案是:步骤基本能写出来,分支也比较明确,那就不要急着上 Agent。用 Workflow 更简单,也更稳定。
反过来,如果你发现每次执行都像是在摸索:先看一个结果,再决定查哪里;先试一种方案,再根据反馈改方向;先确认一个假设,再生成下一个假设,那 Agent 才可能是更合适的结构。
路径越稳定,越不需要 Agent。
路径越不确定,越可能需要 Agent。
这个判断比“有没有调用工具”更重要。
因为 Workflow 也可以调用工具,Agent 也可以调用工具。差别不在工具,而在谁来决定下一步。
五、判断标准二:错误成本有多高?
第二个判断标准,是错误成本。
Agent 的优势是灵活,但灵活的另一面,就是不可预测。
如果一个任务出错的成本很低,比如生成几个备选标题、整理一段内部草稿、给一个初步分析方向,那么你可以给模型更大的探索空间。错了也可以改。
但如果一个任务涉及删除、覆盖、发布、发送、资金、权限、隐私、对外承诺、法律合规、品牌表达,那就不能只看“能不能自动化”。
你还要看“自动化之后,谁负责”。
高风险任务不一定不能用 Agent,但不能把高风险动作完全交给 Agent 自己决定。
更稳的方式往往是组合结构:Workflow 做主干,保证关键流程可控;Agent 做局部判断,处理那些确实需要动态推理的部分;验证机制负责检查结果;人工确认卡住高风险动作。
比如,Agent 可以帮你准备一篇文章草稿,可以帮你检查引用和图片,可以帮你生成公众号 HTML;但真正发布之前,仍然需要确认标题、封面、原创设置、合集、创作来源这些关键信息。
这不是不相信 AI。
这是工程责任边界。
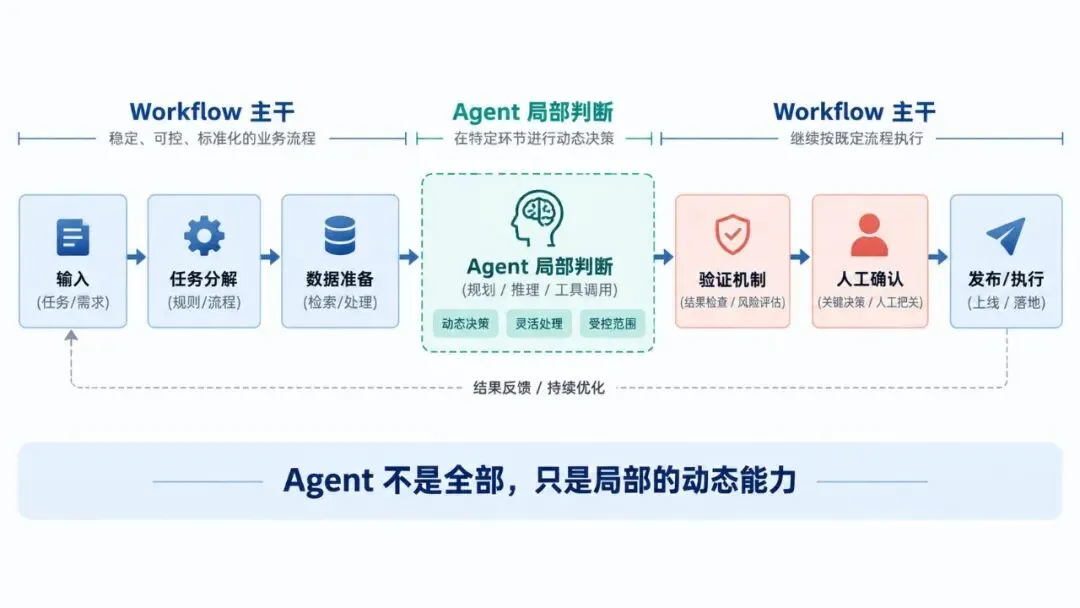
图:更常见的可靠结构,不是把整个系统都做成 Agent,而是在稳定 Workflow 里放入局部动态判断,再用验证机制和人工确认守住边界。
风险越高,越不能只追求自动化;越要追求可控性。
六、判断标准三:可验证性强不强?
第三个判断标准,是结果能不能验证。
如果一个任务的结果容易验证,Agent 可以有更大的发挥空间。
比如代码任务。它当然可能写错,但你可以跑测试、类型检查、lint,也可以做代码 review。
比如数据任务。你可以对账、查行数、核字段、比口径。
比如结构化输出。你可以校验 JSON 格式、必填字段、枚举值、长度限制。
这些任务即使用了 Agent,也不是完全放飞。因为后面有验证机制兜底。
但如果一个任务很难验证,比如“判断一个战略方向是否正确”“决定一个敏感表达是否合适”“评估一个品牌风险能不能接受”,那就要更谨慎。
这类任务当然可以让 AI 参与分析,但不应该让它独自完成判断。
因为你没有一个简单的测试告诉你:这就是对的。
所以我觉得可以这样说:
能验证的任务,才更适合放大自动化。不能验证的任务,不要轻易放大自主性。
这也是为什么前面几篇我们反复提到验证、人工验收、风险边界。
Agent 真正可靠,不是因为它永远不犯错,而是因为它犯错以后,有机制把错误拦下来。
七、一个实用选择框架
讲到这里,我们可以给自己一个很简单的判断框架。
如果一次回答就够用,用单轮问答。
如果输入不同,但套路固定,用 Prompt 模板。
如果步骤固定、规则稳定,用 Workflow。
如果路径不确定,需要动态观察、判断、修正,才考虑 Agent。
如果结果高风险,无论用哪一种形态,都要加验证和人工边界。
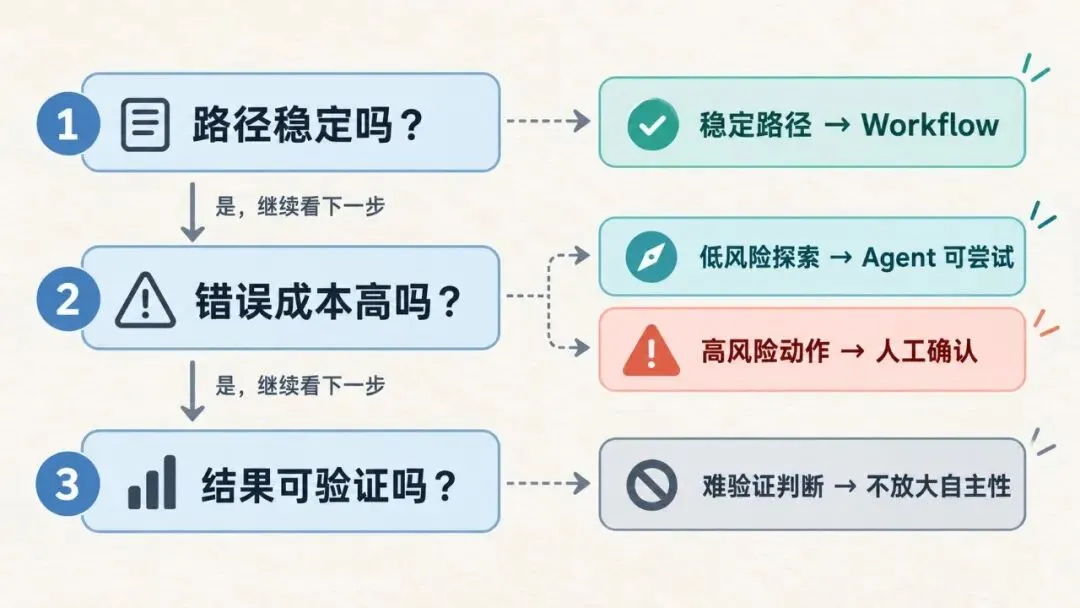
图:判断一个任务要不要 Agent,可以先问三件事:路径稳不稳定、错误成本高不高、结果能不能验证。
你会发现,这个框架的起点不是“我要不要做 Agent”,而是:
这个任务需要多少自主性?
很多时候,我们不需要一上来就设计一个完整 Agent。
可以先从 Prompt 模板开始。模板不够,再做 Workflow。Workflow 某些环节不够灵活,再把局部环节交给 Agent。Agent 的输出不够可靠,再加验证、回放、人工确认。
这是一条逐步增加复杂度的路线,也是一条更符合工程常识的路线。
不要先问“能不能做成 Agent”。
要先问“这个任务到底需要多少自主性”。
结语
第 39 篇,我们讨论了 Agent 设计模式。
这一篇,我们讨论 Agent 的边界。
这两件事要放在一起理解。
理解 Agent 的能力,是为了知道它能解决什么;理解 Agent 的边界,是为了知道它不该被用在哪里。
很多失败的 AI 应用,并不是因为“不够 Agent”,而是因为把本来应该固定的流程,交给了不必要的动态决策。
也有很多看起来不够炫的 Workflow,反而能在真实业务里稳定跑很久。
因为它们把该固定的固定住,把该验证的验证掉,把该由人负责的边界留给人。
所以,AI 应用真正成熟的标志,不是看起来越来越像一个万能 Agent。
而是越来越清楚:什么时候问答就够了,什么时候 Workflow 更好,什么时候才值得让 Agent 上场。
最后这一句,我觉得可以先记下来:
AI 应用的成熟,不是越来越像 Agent,而是越来越知道什么时候不需要 Agent。
参考资料
• Anthropic Engineering: Building effective agents, 2024-12-19. https://www.anthropic.com/engineering/building-effective-agents • LangGraph Docs: Workflows and agents. https://docs.langchain.com/oss/python/langgraph/workflows-agents • OpenAI Agents SDK: Agents. https://openai.github.io/openai-agents-python/agents/ • OpenAI Agents SDK: Agent Orchestration. https://openai.github.io/openai-agents-js/guides/multi-agent/