ARTICLE · 1050123
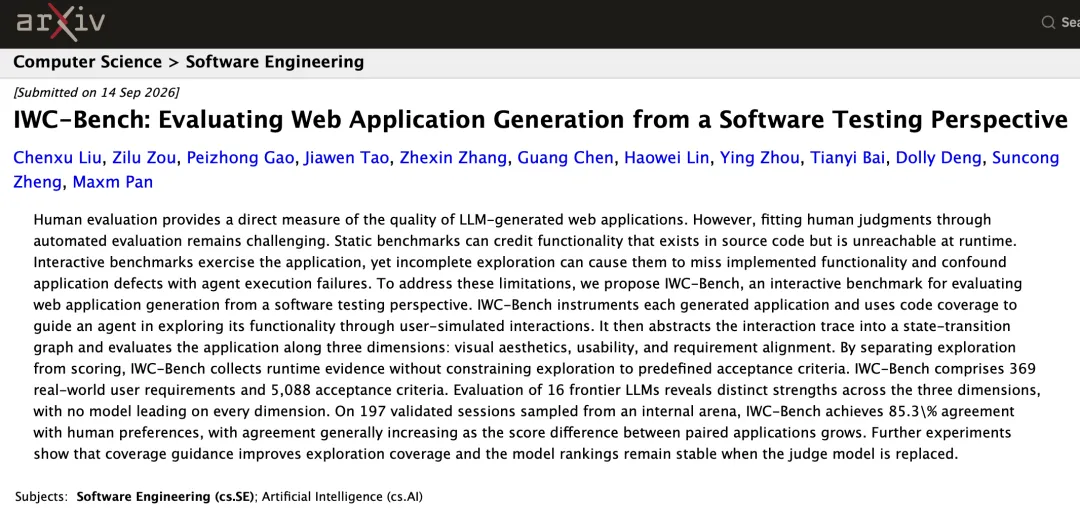
IWC-Bench:一种从软件测试视角评估Web 应用生成的基准方法

整理编辑|TesterHome社区
信息来源|arXiv
随着大模型生成Web应用的能力从简单页面走向复杂交互工具,行业始终面临一个核心痛点:如何客观、准确地评判生成出来的应用到底好不好?人工评测最贴合用户感受,但成本高、效率低;各类自动评测方案层出不穷,却始终绕不开两个本质缺陷。
最近,腾讯混元团队联合清华大学、北京大学研究者带来的一项研究,直接把软件测试的整套方法论搬进了LLM生成评测领域。这套名为 IWC-Bench(交互式Web代码评测基准)的方案,用代码覆盖率引导功能探索、将探索过程与打分过程分离、完全基于运行时证据做评判,针对性解决了此前评测方案的核心短板。
论文链接:https://arxiv.org/html/2609.15387v1
一、为什么现有评测方案不够用?
当前主流的Web应用生成评测,可以分为静态评测和交互式评测两类,但两者都存在明显的偏差来源。
1. 静态评测:代码里有,不代表用户能用
静态评测只基于源码或者单张截图打分,不会真正运行应用。它的问题很直接:代码里实现了的功能,在运行时可能根本不可达。
比如入口页面的按钮失效、关键路径报错,所有下游功能都会被堵死,但源码里这些功能的代码完整存在,静态评测依然会给这部分功能算分。最终分数看起来很高,实际用户拿到手根本用不了。
2. 交互式评测:分不清是应用差还是Agent笨
交互式评测会让Agent去操作页面、验证功能,比静态进了一步,但依然有两个问题:
探索范围被框死:大多基于预设的检查清单、验收标准去验证,清单之外的行为和问题完全不会被覆盖;
缺陷来源混淆:某一项检查没通过,既可能是应用本身没有这个功能,也可能是评测Agent没找到入口、操作失误、理解错了界面。把应用缺陷和Agent执行失败混为一谈,最终的分数就存在不确定性。
二、IWC-Bench的核心思路:把应用当成被测软件
IWC-Bench的核心逻辑非常朴素:把每一个大模型生成的Web应用,都当作一个待测试的软件产品,用专业软件测试的流程来做完整评测。
它有两个关键设计,从根上规避了前述方案的问题:
1. 探索与打分分离:负责探索功能的Agent完全看不到验收标准,只负责尽可能全面地摸清应用的所有功能和边界;打分阶段再单独对照标准,基于探索收集到的运行时证据做评判。从机制上避免了“为了过测而测”的偏向。
2. 代码覆盖率引导探索:用代码覆盖率作为探索深度的量化指标,同时用未覆盖的代码反向引导Agent去探索没走到的分支,尽可能把所有功能路径都摸一遍。
三、四步完整评测流水线
IWC-Bench的评测流程分为四个阶段:插桩、覆盖率引导探索、状态抽象、打分。前三个阶段只负责收集和整理运行时证据,完全不接触验收标准。
1. 自动插桩(Instrumentation)
第一步是给生成的应用做代码插桩,用于收集运行时的代码覆盖率。
团队基于成熟的JavaScript插桩工具 Istanbul 开发了自动化工具,能够自动识别应用的技术栈,支持静态HTML、Vite、Next、Create React App、Astro等主流框架,并对应执行不同的插桩流程。插桩后每一条JS语句都会关联一个计数器,记录运行时的执行次数。
整个过程无需人工修改代码。如果插桩失败,应用会进入黑盒评测模式,继续后续流程,不会直接丢弃。
2. 覆盖率引导探索(Coverage-guided Exploration)
这一步由专门的探索Agent完成,Agent基于 AWorld 框架开发,通过 Playwright MCP(模型上下文协议)与浏览器中的应用交互。为了节省上下文空间,Agent每一步只读取当前页面的简化DOM树,以及与上一步的DOM差异。
Agent被设定为“软件测试员”的角色,目标是尽可能发现所有可用功能、测试边界情况,它全程看不到源码、验收标准和参考答案。
探索过程中,系统会实时监控代码覆盖率:
如果连续三次交互后覆盖率都没有提升,系统会提取未执行的代码片段,交给另一个独立的LLM分析,生成自然语言的探索建议;
建议会被注入探索Agent的上下文,引导它尝试新的操作路径;
探索最多执行100步,或者Agent自行宣布测试完成。
3. 状态抽象(State Abstraction)
探索过程会产生大量截图、DOM快照和交互轨迹,数据量很容易超出评判模型的上下文窗口,而且存在大量重复页面。
IWC-Bench借鉴了自动化GUI测试领域的状态抽象方法:
对每个页面的DOM做归一化处理:移除script、style标签和可变属性,把时间戳等动态内容替换成固定占位符;
归一化后完全相同的页面,会被合并为同一个“状态”;用户的操作则对应状态之间的“转移”。
最终会生成一张紧凑的状态转移图(state-transition graph),既完整保留了应用的交互结构,又大幅压缩了信息冗余,为后续打分提供了结构化的证据。
4. 多维度打分(Scoring)
IWC-Bench从三个独立维度对应用打分,每个维度满分100分:
视觉美观(Visual Aesthetics)
从探索过程中筛选5张有代表性的截图,考察布局、信息组织、排版、细节完成度、风格一致性等。
采用三轮评议机制:正方先找出优点,反方再找出缺陷,双方都必须引用截图中的具体位置;最终裁判核实双方观点,剔除无依据的判断,给出基础分并在七个细分项上做加减。
为了减少评分波动,最终裁判会独立运行5次,去掉最高分和最低分后取均值。
可用性(Usability)
基于完整的交互轨迹和状态转移图,考察核心操作有效性、反馈及时性、控件质量、交互流畅度、状态可恢复性、容错能力、稳定性等。
同样采用三轮评议机制,每一项评价都必须对应具体的交互步骤或状态节点,不能凭空推断未观测到的行为。
需求对齐(Requirement Alignment)
由专门的评判Agent对照验收标准逐条核验,分为功能、内容、视觉三类标准。
每一条标准都必须找到对应的运行时证据(比如某一步交互记录、某个状态的DOM快照和截图)才算通过;仅仅源码里有对应代码,不足以作为通过依据。最终得分等于通过的标准数除以总标准数。
三个维度的原始分会先做z-score标准化,避免区分度大的维度权重过高,再按权重聚合为总分。
四、16款主流大模型实测结果
数据集:369个真实用户需求
IWC-Bench的数据集来自内部Code Arena的真实生产流量,经过匿名化、去重、人工校验后,最终保留369个真实用户需求,配套5088条验收标准。
这些需求非常贴近真实使用场景:63.4%的需求描述不完整,60.2%使用口语化表达,覆盖娱乐、科学演示、在线办公、工具网站、数据可视化等12大类,复杂度从极简单到极复杂都有。
核心结论
研究团队用这套基准测试了16款当前前沿大模型,得到了几个关键结论:
1. 没有全能模型,各维度能力差异明显
没有任何一款模型在所有维度都领先,单一总排名会掩盖真实的能力差异:
Claude-Opus-5 总榜排名第一,同时拿下可用性维度第一名;
GPT-5.6-Sol 在视觉美观维度遥遥领先,但可用性只排在第五;
Kimi-K3 拿下需求对齐维度的第一名。
视觉美观和可用性在模型层面相关性较强,但在单个应用层面相关性仅0.36。换句话说,界面好看不代表交互好用,只看截图评测会严重偏离真实体验。
2. 与人类偏好一致性达85.3%
用197组经过多轮人工校验的两两对比样本验证,IWC-Bench的自动评判与人类偏好的整体一致率达到85.3%。
并且两个应用的分数差距越大,一致性越高:
分差≥0.25时,一致率超过90%;
分差≥0.75时,一致率达到98%。
唯一的典型分歧出现在“界面精致但核心功能崩溃”和“界面朴素但功能完整可用”的权衡上:IWC-Bench优先保障功能可用,人类评委则更偏向视觉效果。
3. 排名稳定,不依赖特定评判模型
把负责打分的主模型从Claude-Opus-4.8换成更轻量的Gemini-3.7-Flash,整体排名的斯皮尔曼相关系数达到0.982,120组模型对比中有115组顺序保持不变,前四名的排名完全没有变化。
这说明IWC-Bench的排名结果是稳定的,不会因为更换评判模型就出现大幅波动。
4. 覆盖率引导显著提升探索充分度
对比有无覆盖率引导的两组实验,覆盖率引导将中位数函数覆盖率从91.9%提升到了94.3%;覆盖率低于90%的任务减少了29%,更多应用的功能路径被充分探索。
剩下覆盖率始终偏低的应用,大多是本身存在严重缺陷——比如打开就报错、核心路径崩溃,导致根本无法继续探索。而这恰恰是真实用户会遇到的问题,正是评测应该捕捉到的质量问题。
5. 工程可靠性极高
在全部5904个生成应用中,插桩失败的仅有7个,成功率达到99.88%,失败原因都有明确的工程归因,整体方案的工程成熟度很高。
此外,IWC-Bench的排名与业界知名的Code Arena排行榜高度相关,斯皮尔曼相关系数达0.876,梯队划分基本一致,说明它捕捉到的能力差异与社区主流评价高度吻合。
五、局限与总结
论文作者认为,IWC-Bench也存在一定局限:
评判过程依赖大模型,会不可避免地带有评判模型的偏好;
总分采用z-score标准化,排名仅在当前参评模型池内有意义,不适合跨池直接对比;
目前只覆盖单轮、纯文本、纯前端任务,暂不支持多轮修复、多模态输入和后端集成;
出于数据安全与保密要求,数据集和代码暂不公开。
整体而言,IWC-Bench第一次将软件测试的完整方法论系统性地引入了LLM Web应用生成评测,解决了长期以来静态评测“测不准”、交互评测“分不清缺陷来源”的核心痛点,让自动评测真正开始贴近真实用户的使用体验。
对于大模型厂商,它提供了更精细的能力维度划分;对于测试与开发从业者,它也提供了一个清晰的思路:评测AI生成的代码,最终还是要回到“运行起来测”的本质上来。
汽车软件质量迎来新国标:测试、OTA与缺陷管理进入全生命周期
英伟达测试岗招聘最新盘点:官方JD告诉你,进NVIDIA做测试需要哪些硬实力(含社招、实习生)
NLP库测试难在哪?LLMSuite混合架构让自动化测试覆盖率涨15%
《“人工智能+软件”专项行动实施方案》印发,对从业者意味着什么?