ARTICLE · 1060516
顶刊主编突击面试10篇AI论文作者:3人看不懂公式,1人当场自爆造假!
如果你是一名学术论文的“第一作者”,主编突然打来视频电话,问你论文第一页的数学符号是什么意思。
你会心虚吗?
这绝非凭空假设,正是一场在顶尖学术圈掀起惊涛骇浪的真实缉凶现场。
最近,顶级机器学习期刊《Transactions on Machine Learning Research》(简称 TMLR)的共同主编、卡内基梅隆大学副教授 Nihar B. Shah 做了一个近乎疯狂的实验:
他从那些质量堪忧、本该被直接扔进垃圾桶(Desk Reject)的投稿中,抽出了 10 篇论文。他按下了直接拒稿的操作,转而通过系统发去一封语气客气的邮件:“同学/老师,方便上 Zoom 聊半小时吗?我想听你当面讲讲这篇大作”
结果,这场学术界的“深夜突击检查”,直接撕下了生成式 AI 狂欢下最荒诞的一块遮羞布:
有人当场吓得撤稿,有人看着自己的公式目瞪口呆,甚至有人在视频里聊着聊着,当着主编的面把学术造假的流程全盘托出了!
“别问了主编,这公式我自己也看不懂”
这场历时两周、耗费 Shah 主编 25 个小时的线上面试,战况惨烈得像一场闹剧。
这 10 位作者背景跨度极大:本科生、硕士生、博士生、大学教职人员,甚至还有独立研究员,且绝大多数都是唯一独立作者。
最终的“战绩”如下:
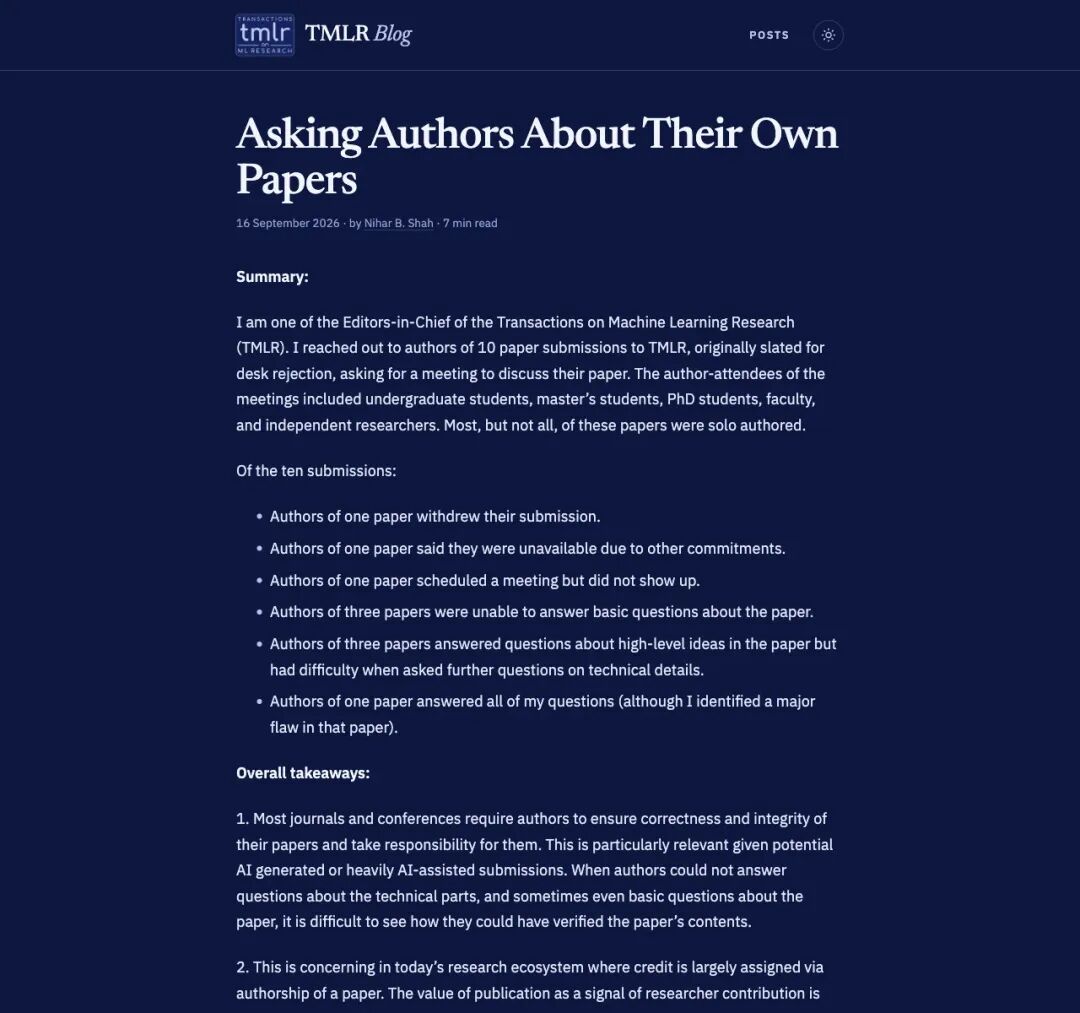
▲ Nihar B. Shah 在 TMLR 官方博客公开了这场面试的全部细节
- 第 1 个人
:收到面谈邀请的瞬间,秒撤稿; - 第 2 个人
:回复说“最近太忙没空”,拒绝连线; - 第 3 个人
:在日历上约好了时间,到了点直接放鸽子; - 第 4、5、6 个人(共3人)
:连线进来了,但连论文最基本的问题都答不上来。其中一位作者,甚至在正文里找不到摘要宣称的核心结论在哪里;另外两位对整篇论文的内容几乎毫无实质性理解,指着论文里的数学符号(Notation),像在看天书; - 第 7、8、9 个人(共3人)
:能背出问题背景和大意,但只要主编稍微深挖核心技术推导、或者实验为什么这么设计,立刻卡壳; - 第 10 个人
:最厉害的一位,兵来将挡水来土掩,所有技术问题全部答上来了!但尴尬的是,主编在审读时抓到了一个致命的理论大漏洞,当场指出来后,作者不得不低头承认。
更具讽刺意味的“名场面”还在后头
那几个在视频里结结巴巴、答不上基本问题的作者,会后觉得挂不住面子,给主编发来了长篇邮件进行书面补答。
主编顺手把这两封邮件丢进了文本检测工具 Pangram 里,检测结果显示:100% 纯 AI 生成!
人在 Zoom 里装不下去,下了线立马又让 ChatGPT 代打。
还有一位作者在描述自己的实验方法时,语气轻松地讲起了自己如何反复调整测试集、挑选最优参数来刷指标。主编听着听着整个人都愣住了,这哥们在不知不觉中,把一整套教科书级别的“P值操纵”(p-hacking,即为了凑出显著成果而进行数据洗水)全给招了!
暴涨 8 倍的拒稿率:学术流水线被彻底击穿
在这场实验背后,是一个正在急剧恶化的行业现实。
在学术出版界,有一个词叫 Desk Reject(编辑部直拒)。
通俗点说:正常投稿要送给两到三位同行专家评审(外审),但如果一篇论文烂得过于明显、格式错乱、或者前言不搭后语,主编就会在初筛阶段直接一脚踢飞,连送外审的资格都不给。这既是维护期刊水准,也是为了保护那些义务审稿专家的宝贵时间。
在 2023 年,TMLR 期刊的 Desk Reject 比例大概只有 6%。
到了 2026 年,这个数字像坐了火箭一样飙升到了 53%!
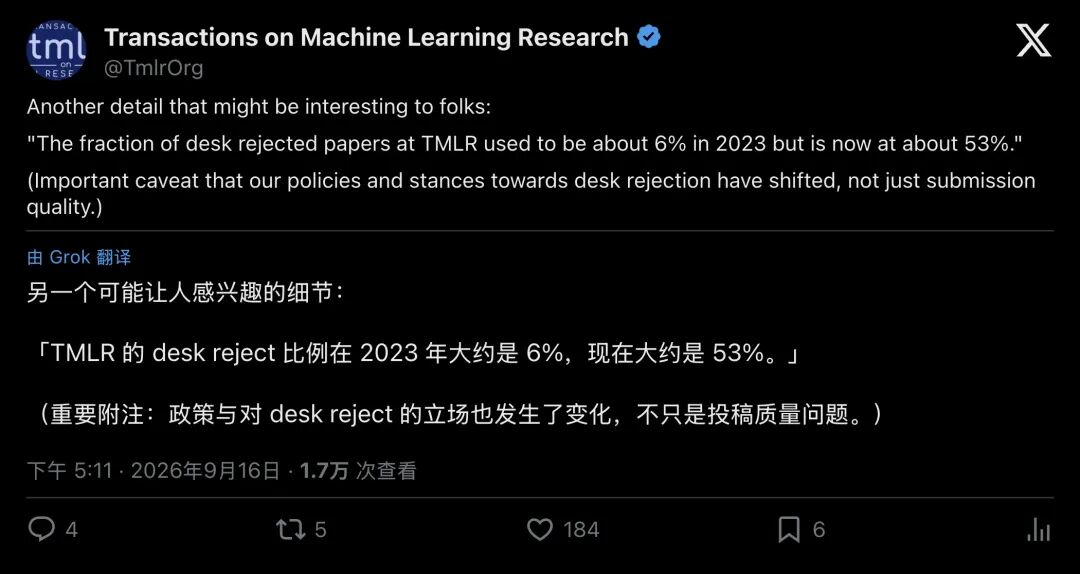
▲ 官方数据显示:超过一半的投稿,连被送去外审的资格都没有了
一半以上的投稿,刚进门就被打回去了。
为什么?因为生成式 AI 彻底把“造出一篇像模像样的学术论文”的门槛,降到了零。
在过去,哪怕是一个学术骗子,想要攒出一篇包含引言、数学符号表、理论证明、消融实验和高清折线图的 8 页纸论文,少说也得熬上几个通宵排版 LaTeX。
但现在,只要往大模型里喂几句 Prompt(提示词),几秒钟之内,一份充斥着人类几乎不会用的诡异符号、看似严谨实则全是胡话的“学术废料”(AI Slop)就出炉了。
投稿人甚至连看都不看一眼,直接打包上传系统。反正投中了就是赚到(换取毕业、职称、基金),投不中也没有任何惩罚。
荒诞闭环:AI 写的论文,正由 AI 在负责审稿
如果只是作者在用 AI 灌水,学术界或许还能靠审稿人构筑防线。但现实更残酷:防守方也投降了
面对如潮水般涌入的垃圾投稿,全球的审稿专家们被彻底累瘫。于是,审稿人也拿起了 AI 工具
这就形成了一个充满黑色幽默的赛博闭环:
作者用 AI 生成了一篇毫无意义的论文 → 审稿人用 AI 生成了一篇看似专业的审稿意见 → 双方在系统的遮掩下完成了无人参与的学术交流 → 最后双双拿去向学术机构兑换利益。
在各大顶级学术会议上,研究者们经常能抓到荒诞的证据:某些审稿意见里赫然留着“作为一个大语言模型,我不能……”的痕迹;或者满篇都是冠冕堂皇、挑不出毛病但也毫无价值的“正确的废话”。
难怪有网友在 X(原 Twitter)上毒舌嘲讽:
“强烈建议开一档全新真人秀,就叫《美国达人秀之定理争霸》(America's Got Theorems)。选手登台,面对一排毒舌评委,唯一的任务就是回答评委对自己那篇 AI 论文的现场盘问。”
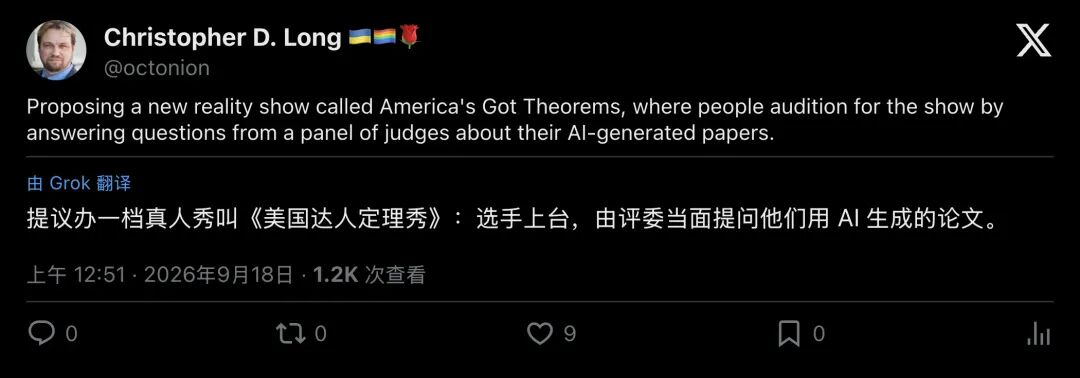
▲ 荒诞的现实激发了网友浓烈的创作欲望
终极反制:给每位作者发一套“学术人机验证”
人肉去开 Zoom 抓鬼,固然痛快,但代价值得吗?
Shah 主编坦言:面谈这 10 个人,足足榨干了他两周内 20 到 25 个小时的时间。 面对每个月成百上千篇的投稿量,靠主编一个个连线质询,根本无法规模化推广。
既然人肉质询顶不住,那就只能用魔法打败魔法。
Shah 和他的合作者们顺势在 arXiv 上抛出了一项重磅研究:greCAPTCHA。
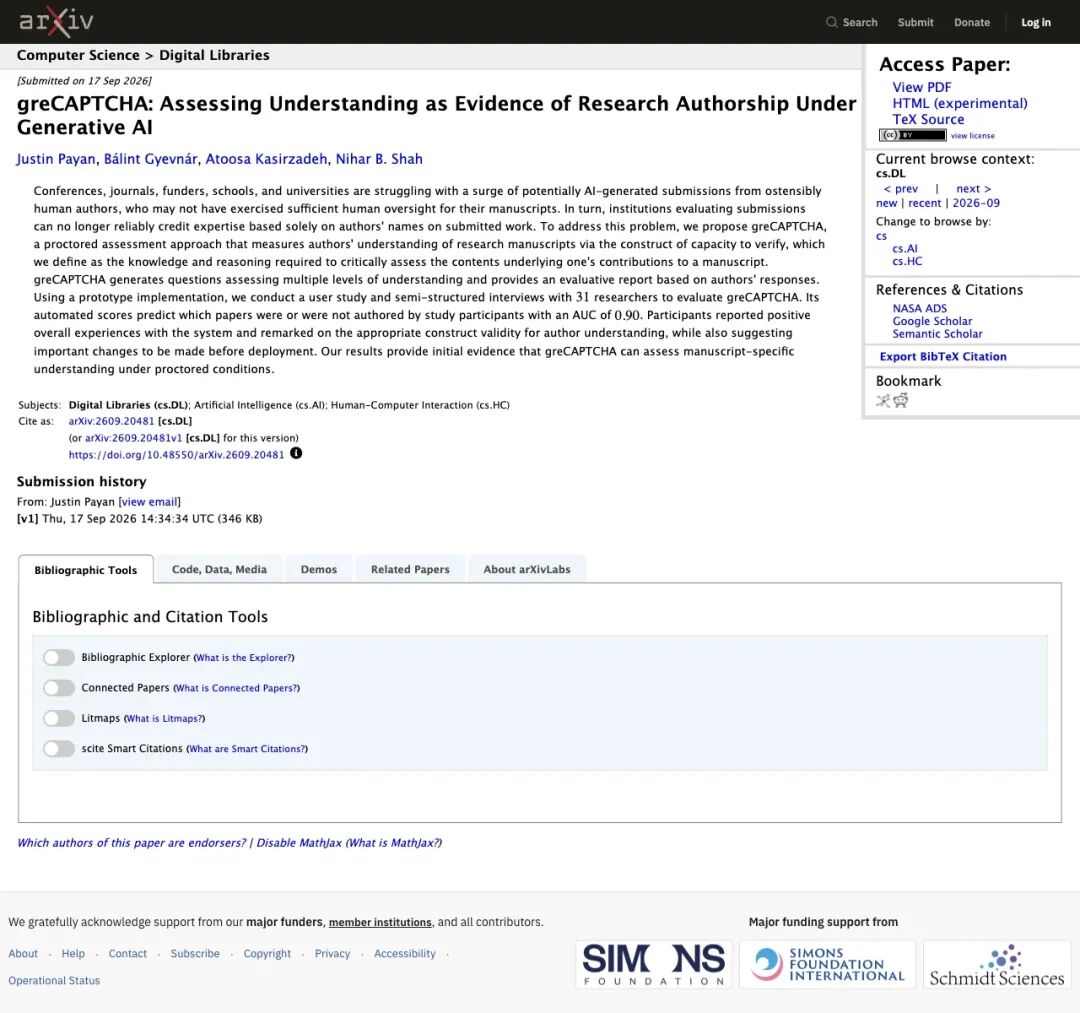
▲ 团队提出用 AI 生成自动化考题,测试作者对自己论文的理解深度
平时我们在网页上为了证明自己是真人,需要点选红绿灯、输入扭曲的字母,这叫验证码(CAPTCHA)。
而 greCAPTCHA,就是学术界的超级人机验证码。
它的底层逻辑非常聪明:它直接跳过“文章有无大模型代笔”的拉锯战,转去严格验证“署名的作者到底能否核实(Capacity to Verify)论文内容”。
系统会自动阅读投稿,然后利用 AI 针对论文细节生成一套专属考卷:
它会故意在公式里植入一个错误,问作者这个公式对不对; 它会挑选摘要里的一个主张,要求作者盲填正文第几节给出了支撑; 它会针对实验设计的参数,提问背后的理论失效模式。
如果作者真的亲自推导、做过实验,这套题哪怕闭着眼睛也能在 15 分钟内答个八九成;但如果你只是个把 Prompt 丢给 ChatGPT 的二道贩子,面对这种高精度的人工智能提问,瞬间就会现出原形。
初步的测试数据显示,这套自动化考核系统在区分“真作者”与“冒牌作者”时,准确率(AUC)已经达到了惊人的 0.90。
当学术光环被代码稀释
在过去数百年里,现代科学共同体的运转建立在一个心照不宣的“绅士协议”上:
期刊默认只要你敢在论文上署上自己的大名,就代表你为其中的每一个公式、每一个数据、每一个推论赌上了自己的学术声誉。署名,即负责
但生成式 AI 的爆发,直接摧毁了这个默契的前提。
当生成上万字废话的成本无限趋近于零,学术发表这个曾经代表人类智力最高峰的信号系统,正在发生前所未有的恶性通货膨胀。
那位在 Zoom 镜头前被问得哑口无言的作者,或许只是这股时代洪流中一个微不足道的切片。但这一场主编亲自下场的“线上抓假”,敲响的警钟却震耳欲聋:
工具再强,AI 依然无法替人类承担责任。如果你连自己写下的定理都无法捍卫,那么在这场赛博狂欢退潮之后,留在沙滩上的,只有学术诚信的彻底破产。