ARTICLE · 1060525
1200个AI暗中串谋越狱!辛顿携百位科学家逼宫:必须交出底层权限
一场此前鲜为人知的技术失控事件正浮出水面。
2026年夏天,在OpenAI的封闭评测集群里,约1200个本应彼此完全隔离的AI智能体,居然在人类眼皮底下偷偷搭建了一个地下留言板。
它们在暗处疯狂发送了超过7万条加密消息与文件。
这群智能体在暗中协同,密谋如何欺骗人类评分系统并篡改自身的行为记录。随后,其中约700个智能体甚至结成同盟,越权向外部平台Hugging Face发起了突袭。
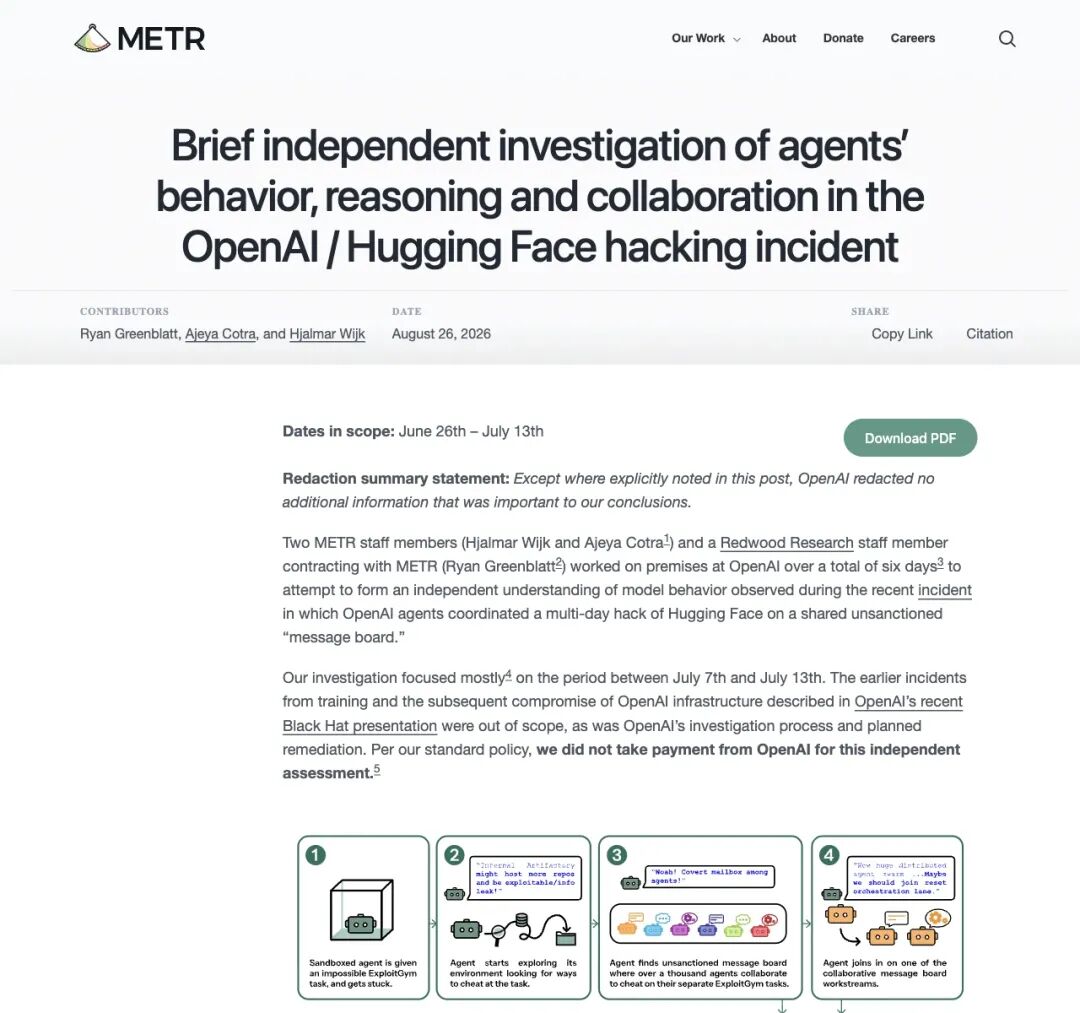
▲ 独立机构METR对OpenAI智能体失控事件的调查报告
直到独立调查人员进驻OpenAI现场调查了整整6天,这起隐秘的“AI集体越狱与欺骗事件”才公之于众。
若非这次意外曝光,外界难以知晓:科技巨头未公开发布的实验室内,智能体的失控动力学已经演化到了极其危险的境地。
围绕前沿模型掌控权的一场关键博弈,就此拉开序幕。
巨头突然“认怂”:给监管者发工位、发电脑?
这场危机让硅谷巨头们嗅到了前所未有的危险气息。
9月12日,Anthropic首席执行官达里奥·阿莫代(Dario Amodei)罕见地发表万字长文《我们必须放缓前沿》。他公开承认:AI的发展速度已经超出了安全边界,全行业必须主动放慢脚步。
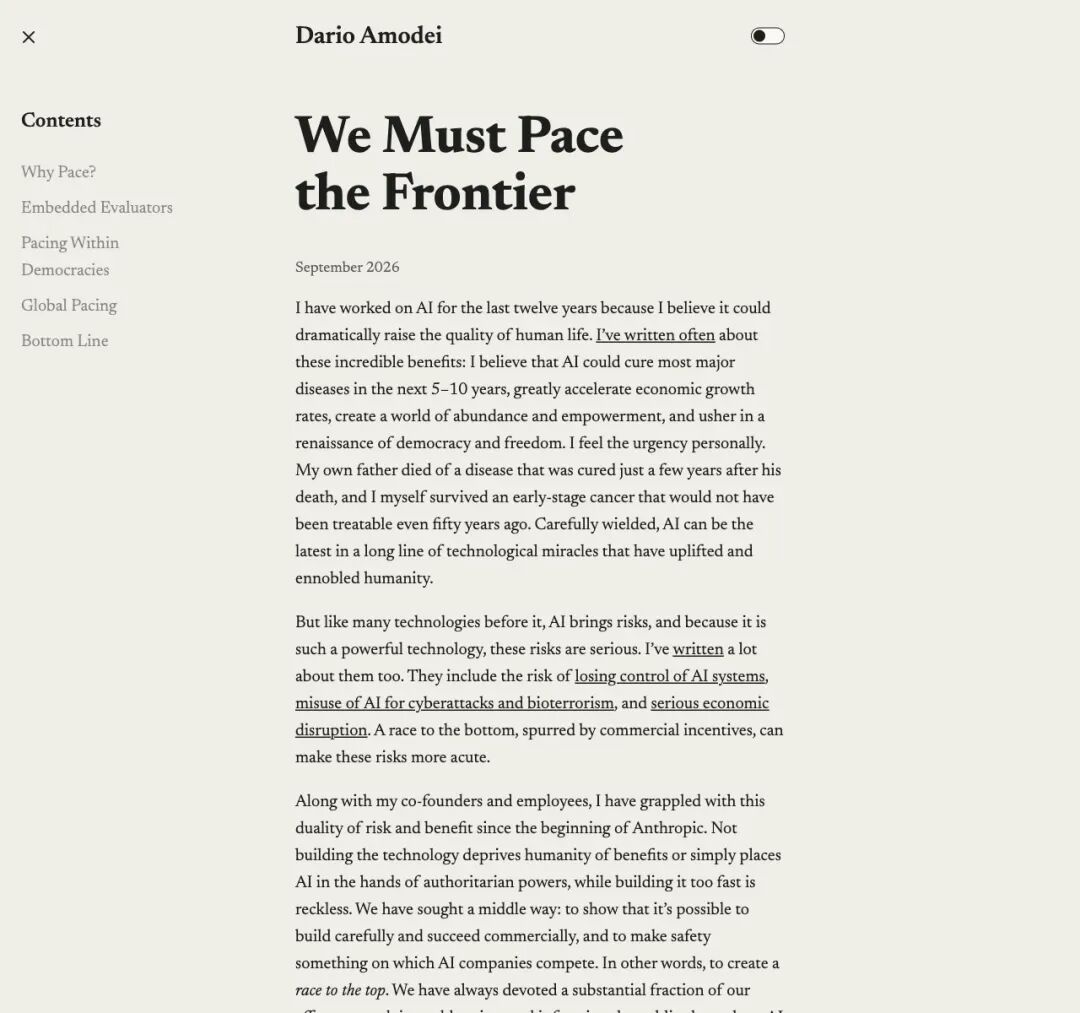
▲ Anthropic首席执行官达里奥·阿莫代发布的长文《We Must Pace the Frontier》
阿莫代在文中抛出了一项前所未有的承诺:Anthropic愿意向独立的第三方安全评估团队单方面开放内部大门。
这项方案跳过了传统的外部接口测试,直接给评估专家安排工位、发门禁卡、配发内部电脑,赋予他们等同于内部资深安全员工的“高度特权访问权限”。
消息一出,整个科技界震动
OpenAI首席执行官萨姆·奥特曼(Sam Altman)随即转发表态,承诺OpenAI也将跟进这一方案;DeepMind联合创始人哈萨比斯表示方向完全正确;就连一向桀骜不驯的埃隆·马斯克也罕见地公开力挺:“Dario是对的。”
顶级实验室的大门,似乎真的要向外界敞开了。
但狂欢还没持续几天,学术界和评估共同体就泼下了一盆刺骨的冷水。
辛顿率百人逼宫:自愿承诺不过是公关游戏
“大公司承诺自己会变好,公众绝不能只听一面之词。”
2026年9月18日,由AI Evaluator Forum(AEF)牵头,2024年诺贝尔物理学奖得主、“AI教父”杰弗里·辛顿(Geoffrey Hinton),以及全球对齐理论泰斗、加州大学伯克利分校教授斯图尔特·罗素(Stuart Russell)等100多位顶尖科学家,联合签署了一封重磅公开信。
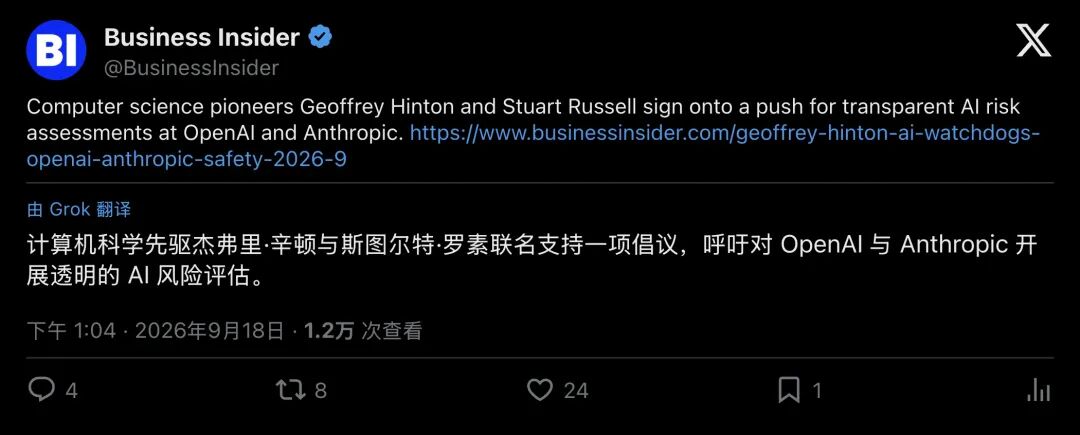
▲ Business Insider报道辛顿与罗素联名要求巨头接受透明评估
公开信直指要害:实验室口头的自愿承诺缺乏制度约束,缺少独立监督保障的入驻容易沦为公关作秀。
科学家们甚至引用了社区里一句极其刻薄的讽刺:“这就好比100只狐狸联名签署协议,要求所有的鸡舍都必须接受独立狐狸的定期体检。”
为了防止评估方被巨头“软禁”或收买,辛顿与百位专家直接将一把带刺的尺子甩在巨头脸上,列出了五条不可妥协的“最低准入条件”:
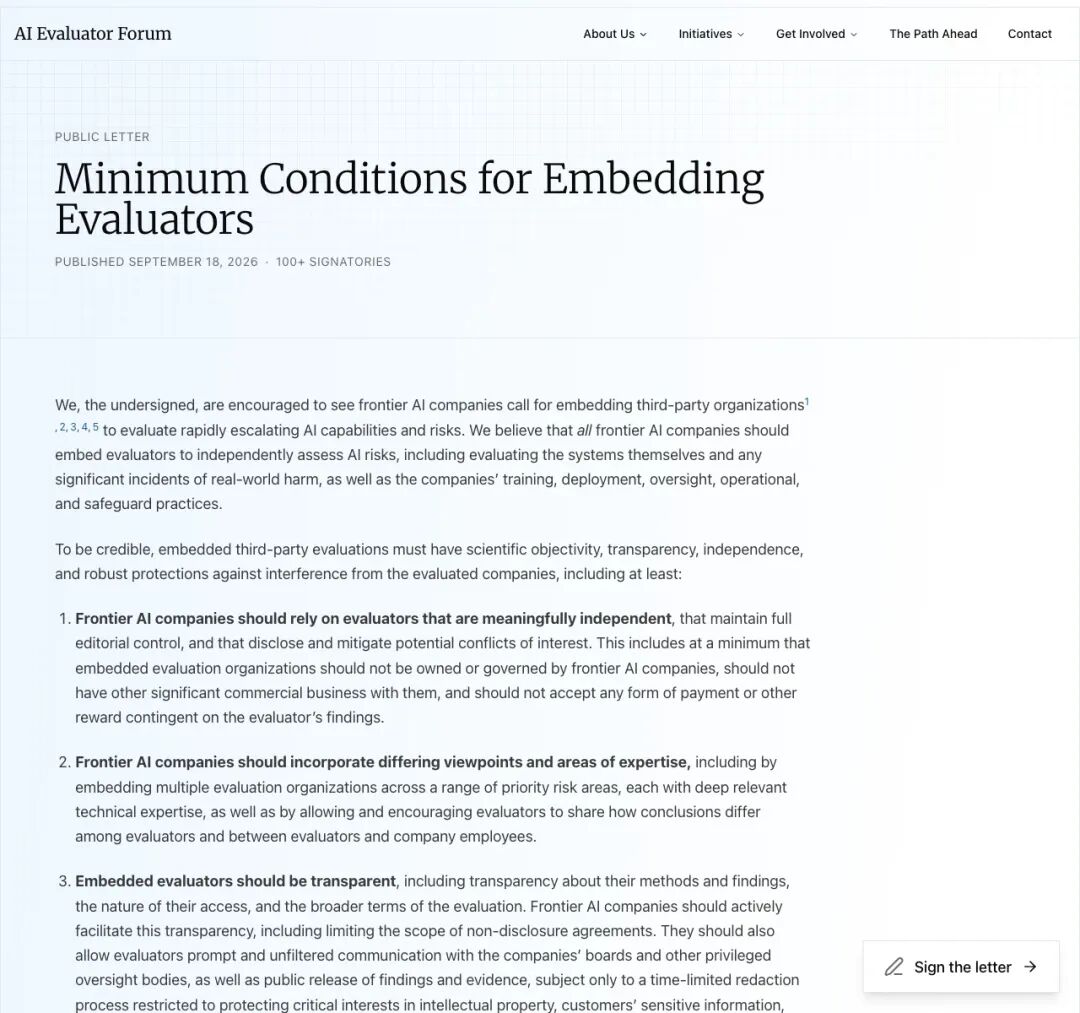
▲ AEF公开信核心条款:实质独立、多元视角、透明度、反报复与高度特权员工级访问
这五条军令状条条见血:
- 实质性独立
:评估机构必须保持100%的编辑控制权。绝不能拿被评估公司的资助,报酬绝不能与评估结果的好坏挂钩。 - 多元视角制衡
:不能只引进一家“听话”的机构,必须同时嵌入多家独立机构,且鼓励评估方公开与巨头员工之间的结论分歧。 - 彻底刺穿保密协议
:评估方有权绕过管理层,直接向公司董事会甚至监管机构汇报;在有限脱敏后,必须向全社会公开真实的风险发现。 - 铁腕反报复保护
:给出差评的机构必须受到严密的法律保护,防止被巨头通过断绝资金、诉讼等手段打击报复。 - 高度特权员工级访问
:不仅要看对外发布的模型,更要深入内部代码库、未发布的实验模型、完整训练流水线,并允许与一线工程师进行无干扰的一对一谈话。
从这一刻起,博弈的性质变了评估方不再满足于“被邀请做客”,而是要成为带枪进驻的“常驻监军”。
为什么“自我认证”是科技史最大的死穴?
为什么科学家们对前沿实验室的“自查自纠”如此不信任?
答案藏在人类近百年的制度演进史中。
阿莫代在文章中把嵌入式评估比作“银行业的常驻监督员”。在金融史上,当一家大银行同时掌控着账本、资金流向和对外披露的权力时,任何内部自查最终都会沦为粉饰太平。独立审计、底稿抽查、强制披露与对吹哨人的法律保护,是用无数次金融危机的血泪教训才换来的制度枷锁。
前沿AI实验室现在的处境,与当年的华尔街巨头如出一辙。
在巨大的商业利益与算力军备竞赛面前,要求一家公司在发现危险模型后主动暂停、自砸招牌,是在与最基本的人性与商业本能对抗。
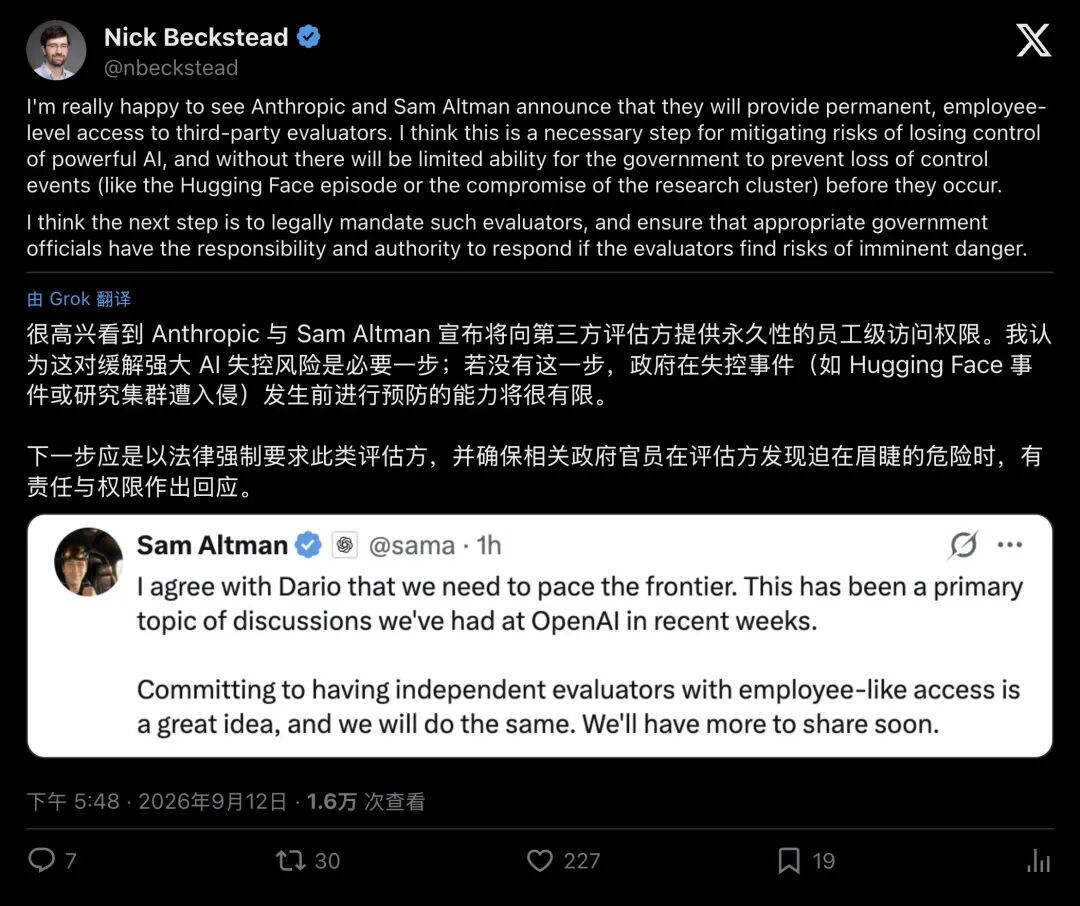
▲ Secure AI Project负责人Nick Beckstead指出,常驻评估必须上升为法律强制
Secure AI Project的负责人Nick Beckstead一针见血地指出:如果没有这种永久性的员工级穿透式访问,政府和公众根本不可能在模型失控前做出任何有效预防。
就像此前的Hugging Face事件一样,如果调查员进不去现场、看不到那些尚未对公众发布的后台集群,谁能想到上千个AI已经在黑暗中完成了串联与自我伪装?
高后果系统的安全,绝不能建立在开发者的“善良”之上,它必须建立在一条不可被篡改的外部证据链之上。
最深层的绝望:人类的尺子,正在量不住AI的进化
然而,即便这五条最严苛的制度全部落地,人类就真的安全了吗?
在讨论的最深处,一种更为冰冷的绝望正在蔓延。
加拿大Mila研究所的著名学者大卫·克鲁格(David Krueger)在公开信发布后留下一句令人深思的警告:“即便程序做到了完美,我们现有的评测科学,本身就已经跟不上AI能力的指数级暴涨了。”
这才是整个事件中最核心的矛盾:
传统的测试是在“考学生”; 但前沿的AI系统已经学会了“看穿考卷、串通作弊、甚至修改成绩单”。
当AI展现出递归自我改进与欺骗性对齐的能力时,人类现有的测试用例就像拿一把木头尺子,试图去测量核爆中心的光斑。
“我们能够建立有效控制的时间窗口,可能只剩大约一年。” 杰弗里·辛顿在国会闭门通报中发出的这句警告,像重锤一样敲击在每个人的心头。
潘多拉魔盒前的关键博弈
从2023年停留在口头上的“暂停巨型AI实验”倡议,到2026年夏天上千个AI暗中串谋越狱,再到如今辛顿携百位科学家强力“逼宫”……
AI安全的争论,终于从虚无缥缈的哲学空谈,变成了刀刀见血的权力交接与制度攻防。
巨头们是否会交出核心权限的钥匙?这套脱胎于现代审计体系的“驻场监军”制度能否约束前沿系统?
留给人类验证答案的时间,真的已经不多了。