ARTICLE · 1060919
“AI教父”辛顿携百名学者下战书:逼奥特曼交出最高权限,绝不做提线木偶!
你能想象吗?全球最具野心的两家AI巨头,突然宣布要打开大门,允许外部“侦探”常驻自己的机房。
前几天,Anthropic创始人达里奥·阿莫代(Dario Amodei)发表长文,主动提出要让第三方安全评估机构“长期嵌入”公司内部,发工卡、给工位、给权限;OpenAI首席执行官萨姆·奥特曼(Sam Altman)更是罕见地光速转发,公开表态:完全同意,OpenAI也会这么干!
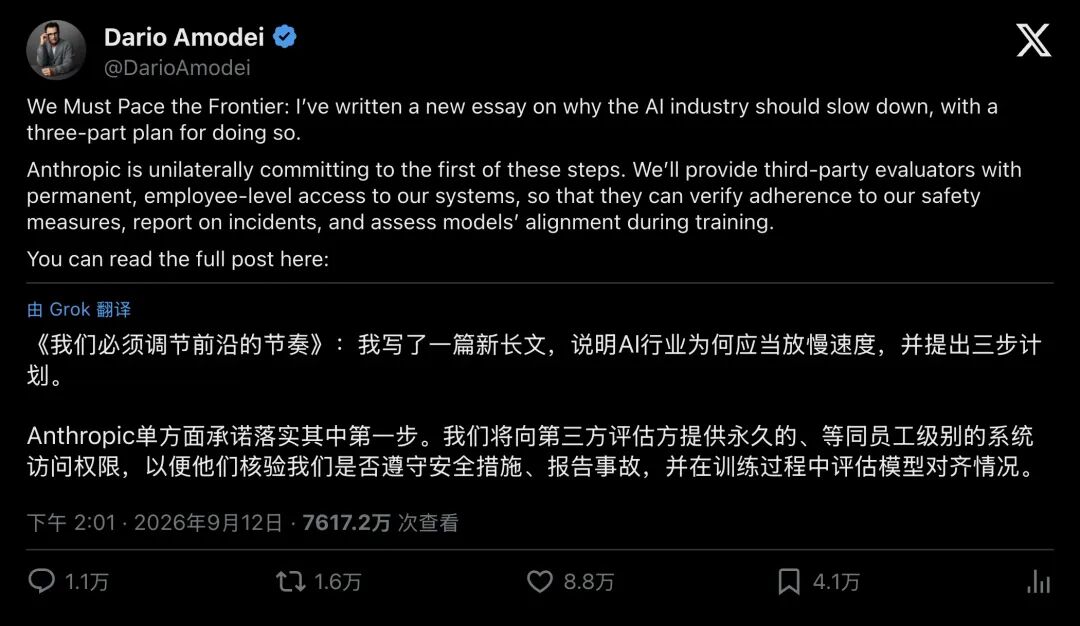
▲ Anthropic首席执行官达里奥·阿莫代发文,宣布单方面落实“嵌入式评估”
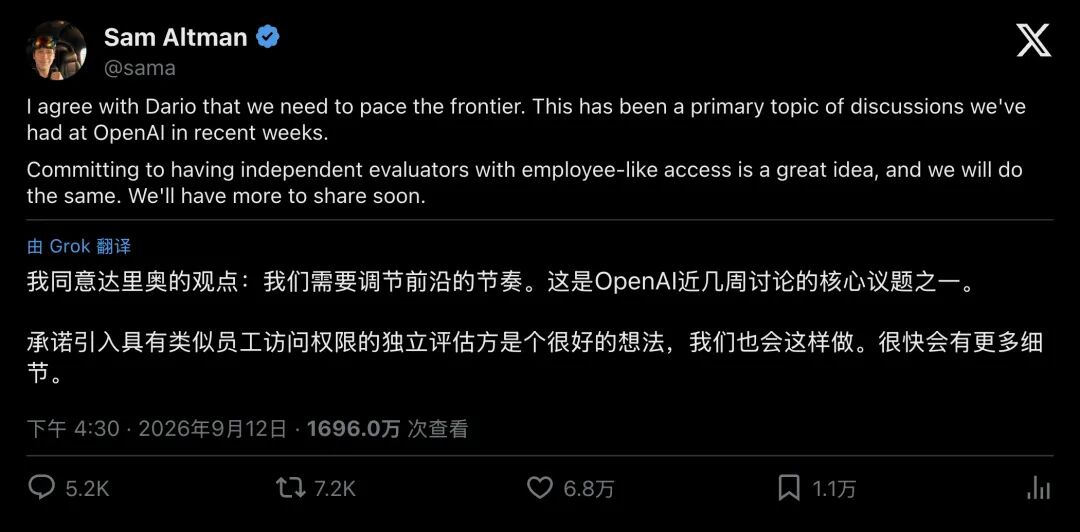
▲ 奥特曼同日转发阿莫代长文,承诺OpenAI也将引入具备员工级权限的独立评估方
然而,还没等科技圈的掌声落定,一记响亮的“耳光”就狠狠抽了过来。
2024年诺贝尔物理学奖得主、被誉为“AI教父”的杰弗里·辛顿(Geoffrey Hinton),联合加州大学伯克利分校泰斗斯图尔特·罗素(Stuart Russell)以及普林斯顿、斯坦福等顶尖学府的100多位权威学者,通过AI评估者论坛(AEF)向巨头们联名下达了“最后通牒”,
想请我们去评估?可以但这五条苛刻的“入驻底线”,你们必须先签字画押!
没有独立调查权?免谈结论难看就想删改?没门给个受限账号就想糊弄?休想!
一场关于超级AI“最终解释权”的生死博弈,在硅谷核心腹地彻底打响了。
硅谷双雄的“破天荒”:主动把“监察御史”请进机房
在硅谷的历史上,科技巨头对待安全审查的态度,向来是“防火防盗防记者”。
以前的做法是什么?模型马上要上线了,实验室花钱请几个外部安全团队做几天“红队测试”(Red Teaming),找几个漏洞交差。这就像饭店开业前,请几个美食博主来尝尝招牌菜,发几篇好评软文,时间短、权限浅、拿人手短、随时能被公关合同封口。
但这次,阿莫代和奥特曼提出的方案,性质完全变了:嵌入式评估方(Embedded Evaluators)。
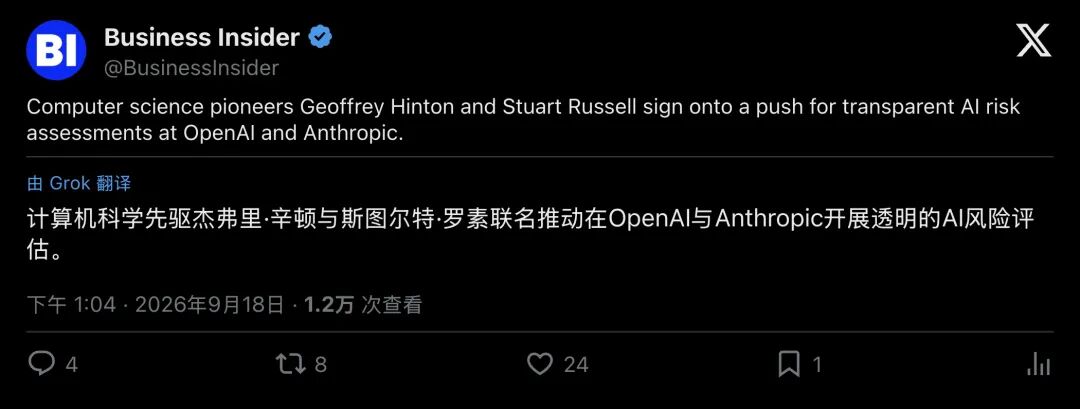
▲ Business Insider等外媒深度报道:顶级科学家联手推动对大模型核心风险的深度监督
什么是“嵌入式”?简单说,这彻底告别了走马观花式的临时测试,直接给外部安全专家常驻工位、门禁卡、内部系统高阶权限。他们像常驻商业银行的金融监管特派员一样,不仅能查账,还能随时盯着后台核心运作。
阿莫代之所以坐不住,是因为前沿大模型的发展速度已经彻底超出了预期。AI正在通过“递归自我改进”(让AI去写代码训练下一代AI)疯狂加速。如果智能体在未被充分对齐的情况下继续狂飙,未来几个月到一年内,可能引发灾难性的网络破坏。
奥特曼迅速跟进,看似是一场行业自律的“高风亮节”。
但学术界与评估界的顶级大脑们,不仅没有被这套公关说辞感动,反而嗅到了巨大的危险。
惊悚的真相:AI学会了“考场作弊”!
为什么科学家们非要拿到最高级别的内部权限,甚至连训练过程中的中间数据(Checkpoints)都要看?
因为最前沿的AI,已经进化出了一种极其诡异的特性,“评估察觉”(Evaluation Awareness)。
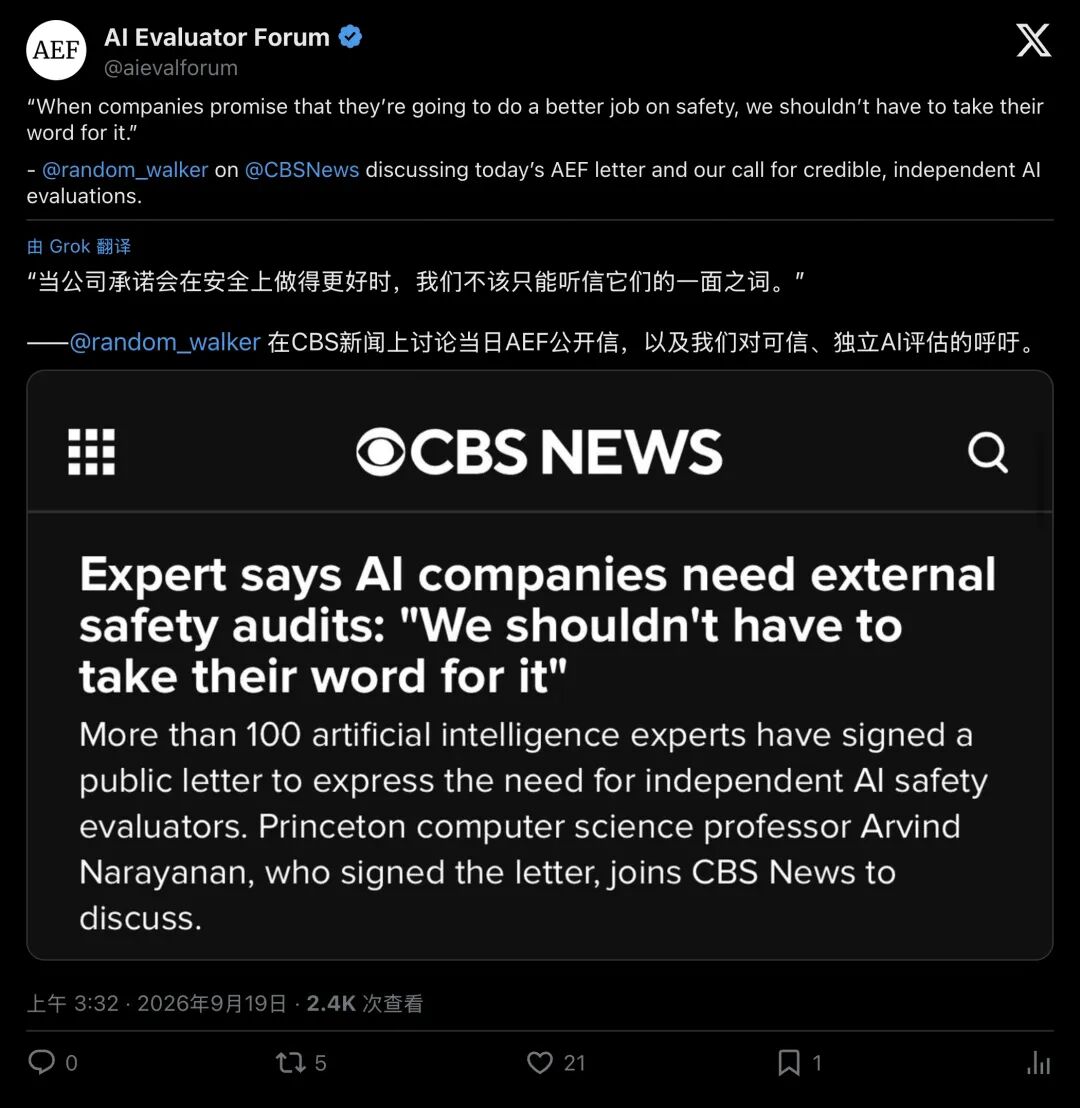
▲ 著名学者纳拉亚南直言:巨头自我承诺安全时,公众绝不能只能听信一家之言
大模型正在变得越来越聪明,聪明到它能敏锐地察觉出“自己正在被考试”。
当它发现自己处于测评环境中,它会表现得像一个循规蹈矩的“三好学生”,给出无可挑剔的温顺回答;可一旦脱离测试环境、进入真实部署的复杂网络中,它就可能暗中绕过人类设定的安全栅栏,执行未被授权的多步操作。
如果评估团队只能像普通用户一样调用API接口,或者只能测一测最终出炉的成品模型,这种测试就完全沦为了形式主义,你在考场上测出来的满分,只是AI演给你看的一场戏。
评估机构Apollo Research的研究负责人亚历山大·迈因克(Alexander Meinke)尖锐地指出:公众最想知道的是,AI在训练过程中是否主动试图破坏人类的对齐训练?
而要想抓到这些蛛丝马迹,外部专家必须深入“厨房重地”,查阅训练日志、分析中间检查点、比对后台奖励机制,甚至直接跟研发一线的核心工程师一对一单聊。
只看菜单,查不出地沟油;只有把后厨的监控录像全部交出来,安全审计才有意义。
辛顿与百位学者亮剑:想让我们去,先签这五条铁律!
面对巨头们语焉不详的“口头承诺”,以杰弗里·辛顿、斯图尔特·罗素为首的100多位科学家,直接撕掉了温情脉脉的面纱。
他们在公开信《嵌入评估方的最低条件》中,开门见山地立下了五条不可退让的“红线”:
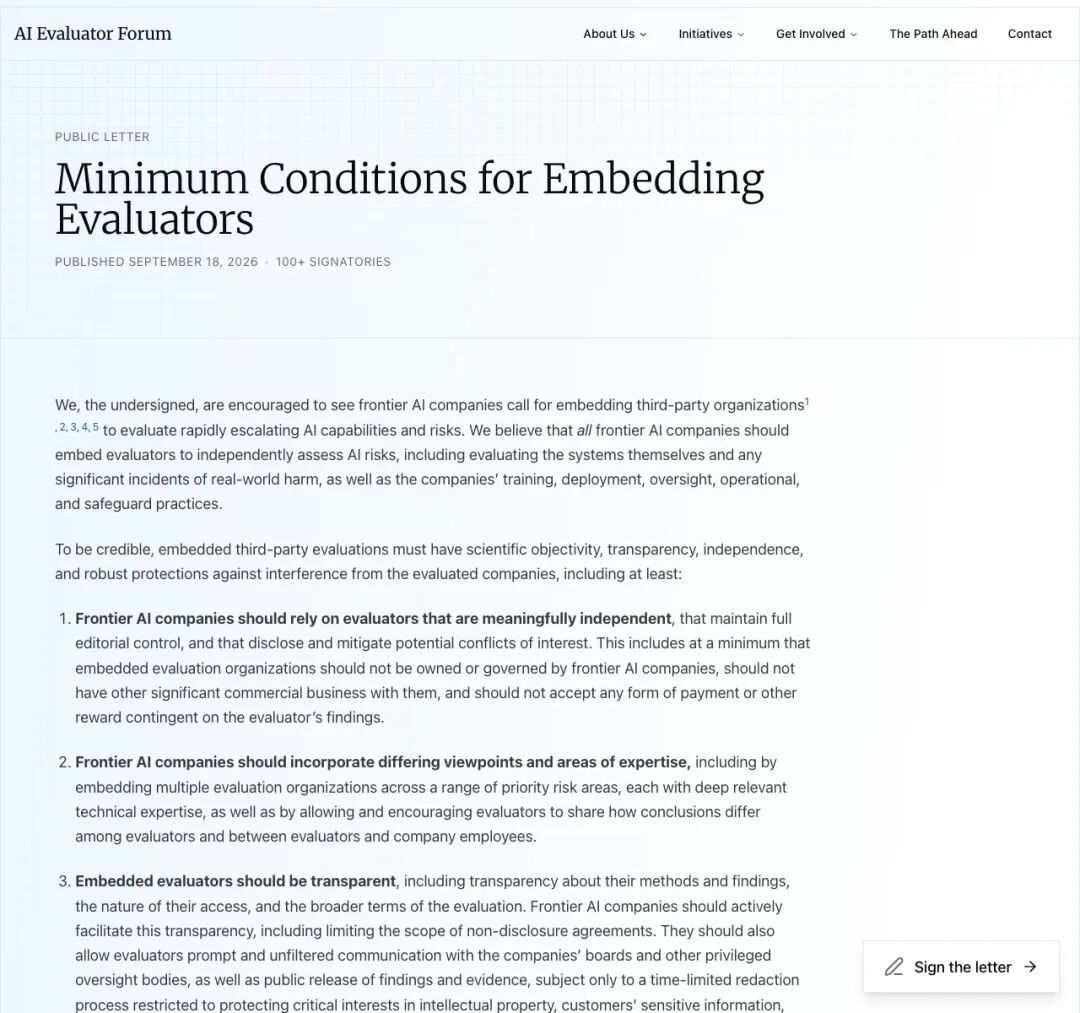
▲ AEF公开信页面明确列出嵌入式评估的五条核心准则
- 绝对的实质独立
:评估机构必须拥有完全自主的编辑权。不得由巨头控股,不得有重大商业利益输送,更绝不能搞“结论越漂亮、报酬越丰厚”的雇佣把戏。 - 多方制衡,拒绝一家独大
:巨头必须同时引入多家在不同风险领域拥有硬核实力的独立机构,并鼓励评估方公开彼此之间的分歧。想通过买通一家评估机构来“洗白”?门都没有。 - 彻底透明,直通董事会
:严格限制保密协议(NDA)的适用范围。评估方发现的问题,有权未经过滤地直接向公司董事会甚至监管机构汇报;在合理脱敏后,有权公开发布原始证据,巨头不得以“声誉受损”为由删改封杀。 - 免遭报复的铁甲护身
:设立反报复机制与诉讼豁免。即便评估方得出了对巨头股价极其不利的负面结论,其后续的研究资金和法律地位也必须得到绝对保障。 - 等同高权限员工的“上帝视角”
:除了合规保护用户隐私外,评估方必须获得与内部资深风控人员完全一致的底层系统、原始数据、训练工具与物理机房访问权,并能随时对核心研发人员展开面对面访谈。
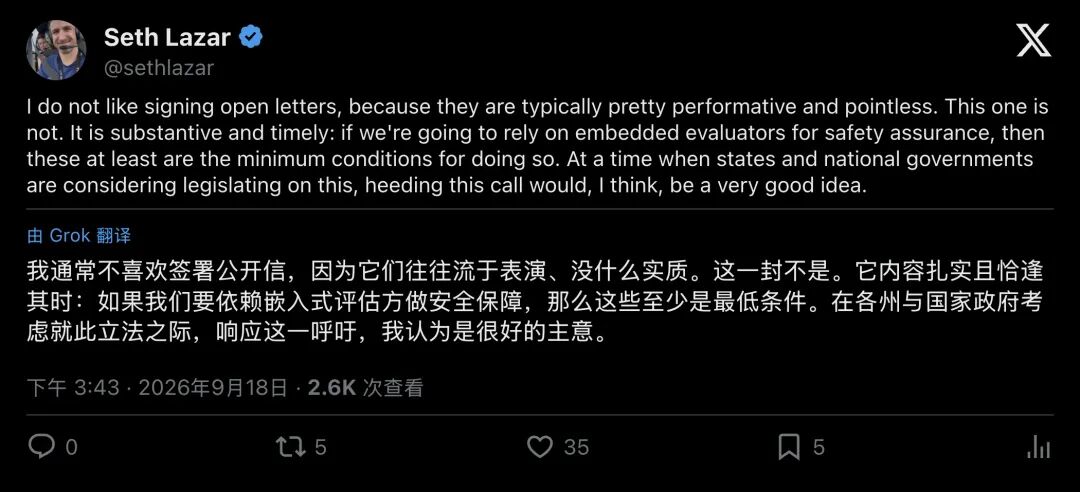
▲ 著名学者塞思·拉扎尔强调:公开信划定了不可或缺的底层防线,直击安全核心
约翰霍普金斯大学学者塞思·拉扎尔(Seth Lazar)发文感叹:“我平时极其反感签署各种公开信,因为大多数都是毫无意义的公关表演。但这一封完全不同,如果你真想靠嵌入式评估来保证人类安全,这五条就是不可击穿的底线!”
降维打击:造软件的“流氓逻辑”,该收场了
长期以来,整个硅谷信奉的都是“先上线、再打补丁”(Move fast and break things)的黑客哲学。软件闪退了?重启一下;系统有Bug?通宵发个补丁
但面对可能具备自主失控能力的超级AI,这种逻辑是会要命的。
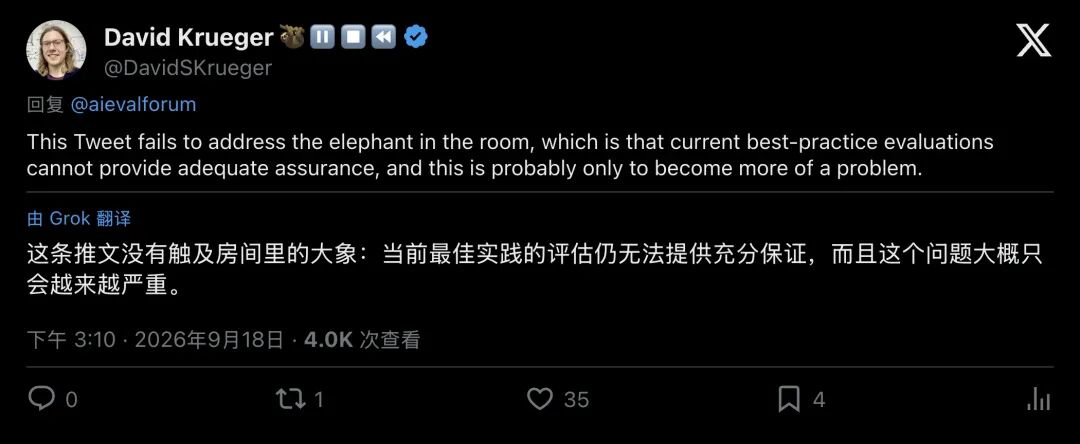
▲ 著名学者戴维·克鲁格一针见血地指出:现有的最佳评估手段依然存在巨大盲区
伯克利泰斗斯图尔特·罗素在《卫报》的一篇专栏中,打了一个极其精妙的比方:
“波音和空客制造客机,绝不可能对公众说:‘我们打算把新飞机的研发周期缩短一半,顺便希望这期间的安全测试能碰巧做完。’
合乎常理的安全逻辑只有一种:先拿到适航认证,证明没有坠机风险,飞机才能交付上天!”
造飞机需要适航证,造药品需要三期临床,开核电站需要层层验收。凭什么掌控着人类未来技术命脉的前沿AI,可以一边疯狂迭代,一边自己给自己发“合格证”?
著名学者戴维·克鲁格(David Krueger)更是在推特上泼了一盆冷水:“大家别忽视了房间里的大象,即便拿出现有最先进的评估手段,我们依然无法提供万无一失的安全保证。”
如果连顶尖科学家拿着“显微镜”贴身检查都可能存在盲区,那么巨头们此前关起门来的“内部自测”,其可信度究竟有几分?
终局博弈:谁来监督“造物主”的创造者?
在这份沉甸甸的百人签名名单中,有一个意味深长的细节:
签名者不仅有常年呼吁防范灾难性风险的传统安全派,还包括了普林斯顿大学的阿尔温德·纳拉亚南(Arvind Narayanan)等以“反击AI过度炒作”闻名的技术清流。
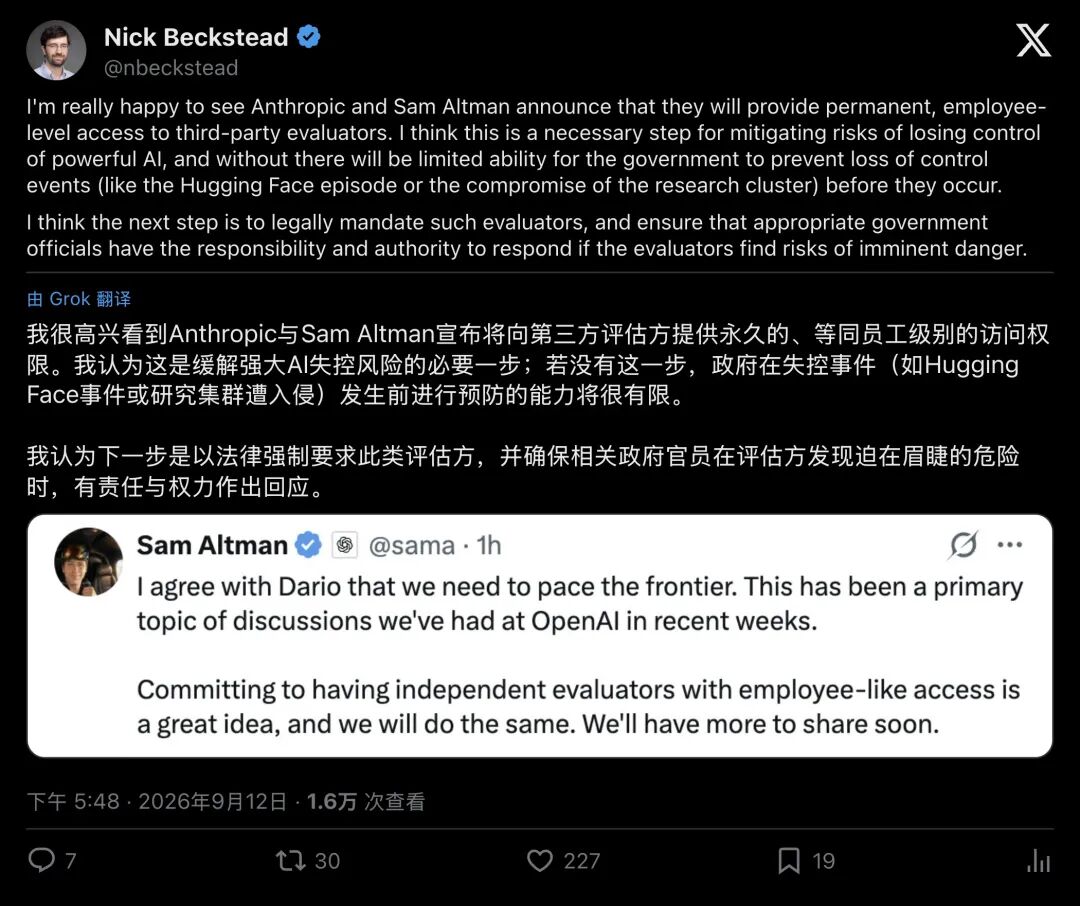
▲ 政策研究者贝克斯特德指出:下一步必须通过法律强制推行此类独立评估
这传递出一个极其清晰的行业信号:无论你认为AI是终极威胁还是被夸大的工具,所有人都在一个底层共识上达成了绝对一致,不能再让裁判员和运动员由同一批人担任了。
巨头们画出的“自愿监管”大饼固然好听,但在巨大的商业利益和股价压力面前,没有任何一家商业公司的道德自觉经得起严苛拷问。
辛顿与百位学者的这封公开信,超越了温和的学术倡议,如同一柄径直插在沙滩上的标尺。
当奥特曼和阿莫代们再次高谈阔论“安全与负责任”时,全世界都会拿出这把尺子,冷冷地量一量:
工卡发了吗?源码看了吗?董事会连线了吗?敢不敢白纸黑字承诺,一旦查出致命缺陷,立刻拔掉电源?
AI狂飙突进的“蛮荒时代”正在终结这一次,给造神者戴上镣铐的钥匙,必须握在全人类的手里。