ARTICLE · 1065412
当 AI 不再"说话",而是直接"下判断"——TypeSafe 的 Jev 与"系统一"范式,正在改写软件自动化的底层逻辑
文 / 格寻记2026-09-21来源:新华社、澎湃科技、TypeSafe 官方博客等
2026 年 9 月中旬,一家名为TypeSafe AI 的旧金山创业公司结束两年蛰伏,抛出一款名为 Jev 的模型。它不写文章、不写代码、不聊天——你把一段"程序状态"喂进去,它直接吐回一个类型确定、附带概率和置信度的判断,让软件原地执行。这听起来不像"又一款大模型",而像是给机器装上了"条件反射神经"。本文拆解它为何震动开发者,以及它折射出的 AI 从"生成"走向"决策"的范式转移。
一、从卡尼曼的"系统一"说起:命名本身就是一份宣言
Jev 被 TypeSafe 称为首款"System One(系统一)"模型。这个名字直接借自诺贝尔经济学奖得主丹尼尔·卡尼曼在《思考,快与慢》中的经典二分法:系统一是快速、直觉、自动化的判断(看见红灯就踩刹车),系统二是缓慢、刻意、需要推演的思考(解一道微积分题)。以 ChatGPT 为代表的大语言模型(LLM),恰恰被归为"系统二"——它们擅长用一串串 token 慢慢"想"出答案、写出完整文本。
TypeSafe 的创始人迪奥戈·阿尔梅达(Diogo Almeida)不是无名之辈。他在 OpenAI 期间参与构建了对话机器人的底层方法,更关键的是,他是RLHF(基于人类反馈的强化学习)的共同发明者之一——这项技术几乎是现代 ChatGPT 的奠基性训练方法。他坦言,过去四年里他一直在困惑一件事:"模型在聊天上早已超人,可自动化到底在哪?"离开 OpenAI 后,他在 2024 年参与创办 TypeSafe,结论是:问题不在于模型不够聪明,而在于我们一直在为"人类语言"做优化,而计算机说的是另一种语言。
关键转折:阿尔梅达的原话是——"四年来我们在人类语言方面做得非常出色,但这对于自动化毫无用处,因为计算机说的是另一种语言。"Jev 的全部设计,就是绕开"人类语言"这个中介,直接输出"机器语言"(类型化、可校验的结构值)。
模型名 Jev还有一重深意:它致敬 19 世纪经济学家威廉·斯坦利·杰文斯提出的"杰文斯悖论"——当某种资源的使用效率提升、成本下降后,总需求不降反升。TypeSafe 的潜台词是:当机器智能的单位成本暴跌后,软件和机器人会产生大量此前因成本与速度限制而"想都不敢想"的决策需求。
二、Jev 到底做了什么:把"判断"变成函数调用
与传统 LLM 的"输入文字→逐 token 生成文字"不同,Jev 的交互方式是:开发者传入一段非结构化信息或程序状态,并预先声明若干问题与候选答案;Jev 在同一份状态下并行、独立地处理所有问题,返回类型化、附带概率的结果。它当前支持三种问题类型:
类型 | 作用 | 输出 |
Choice (选择) | 从给定选项中挑一个,如 " 该转交账单 / 技术支持 / 销售哪个部门 " | 选项的概率分布+置信度 |
Score (评分) | 按设定标准打分,如 " 这条投诉紧急程度高 / 中 / 低 " | 有序等级+概率 |
Noul (是非) | 判断某陈述成立的概率,如 " 当前动作是否安全 " | 0到1之间的数值 |
这意味着开发者不必再让大模型逐个生成自然语言或 JSON、再写解析器去校验。Jev 的可能输出和结构在调用前就被定义好,模型"永远不犯类型错误",且每个答案都带校准过的概率。TypeSafe 称其训练方法为RLCD(Reinforcement Learning for Calibrated Decisions,用于校准决策的强化学习)——优化目标不是"人类评审更喜欢",而是"给出的概率诚实反映真实正确率":高置信度就意味着高准确率。
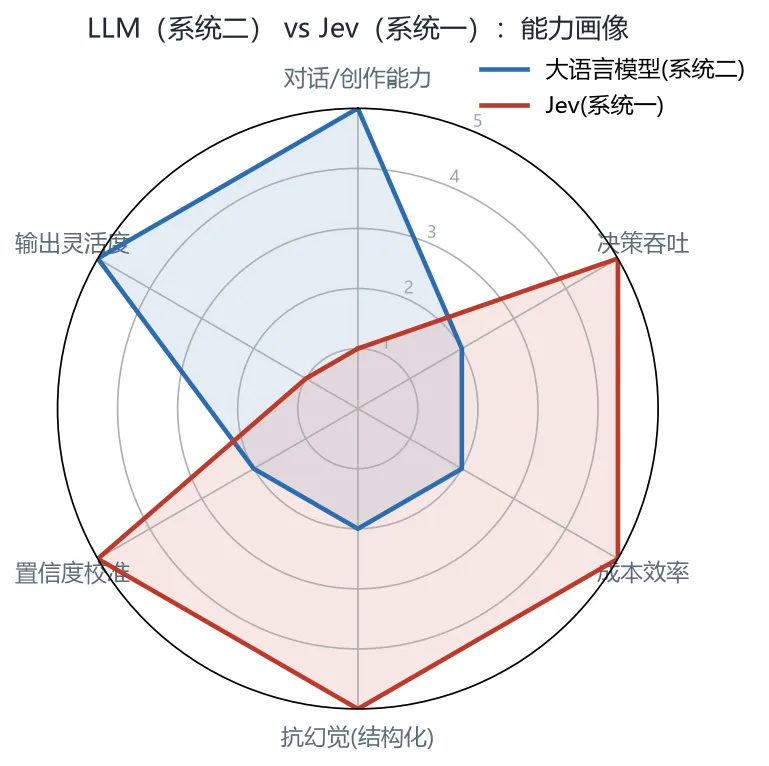
图 1|LLM(系统二) vs Jev(系统一):能力画像对比(各维度按"越强得分越高"定性刻画)
三、两个数量级的差距:为什么开发者会"涌入到把 API 挤爆"
Jev 引爆开发者社区,核心在速度与成本。TypeSafe 公布的对比极具冲击力:现有前沿 LLM 端到端响应时间约3–329 秒(对人类对话够快,但嵌进代码就是瓶颈);TypeSafe 的端到端响应仅70–500 毫秒。在相同水平的"系统一型"决策任务上,速度可达同类大模型的40–200 倍(公司最高宣称 193.6 倍提速、444.6 倍降本)。
成本端更极端:现有 LLM 输入 token 约 0.20–10 美元/百万 token,且输出 token 更贵(约 5 倍);Jev 输入仅0.042 美元/百万 token(每十亿 token 42 美元),且不收输出 token 费用——因为模型压根不做自回归文本生成,"便宜到无需计量"。Vercel 工程师在安全分类器上实测替换 OpenAI 模型后,速度提升 5–18 倍且准确率反而提高;Bryo AI 将 Jev 与 Google Gemini 比拼邮件分类,Gemini 略准,但 Jev 便宜得多。
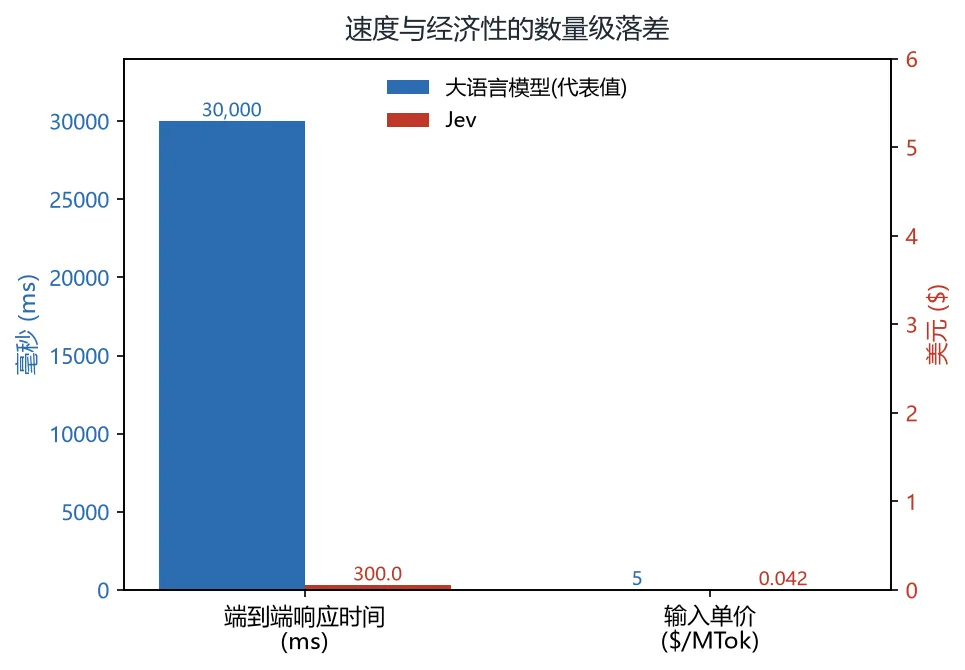
图 2|速度与经济性的数量级落差(左轴毫秒,右轴美元/百万 token,LLM 取区间代表值)
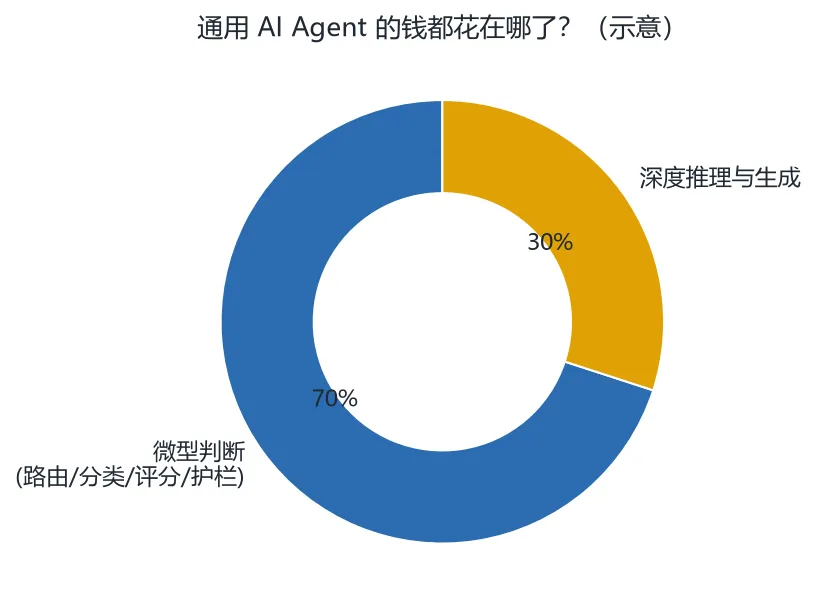
图 3|通用 AI Agent 的钱都花在哪了?(示意:大量预算消耗在微型判断,而非深度推理——这正是 Jev 的用武之地)
为什么这件事重要:多数"AI 智能体"的账单爆炸,不是因为规划多聪明,而是因为成千上万次"该调哪个工具 / 这页相关吗 / 这动作有风险吗 / 任务完成了吗"的微小 yes/no 与多选判断,每次都让前沿 LLM 写一段文字。Jev 就是为这一层而生。
四、必须泼的冷水:哪些说法是"上限"而非"常态"
务实地说,上面那些亮眼数字主要来自 TypeSafe 自己的评测,尚未在生产负载上被大范围独立验证。公司也承认,最高 193.6 倍提速、444.6 倍降本来自其团队设计的四项工作流测试,参考答案并非人工标注的客观标准,而是由其他大模型生成,"处于实际收益的较高一端,内部测试也可能带来偏差"。独立机构 Every/explainx.ai 的实测为:抽取类任务约25 倍更快、580 倍更便宜,但综合准确率 67.8%,低于高阶对比模型的 74.1%——更快更便宜,但并非总是更准。
另一个常被误读的点是"不会产生幻觉"。准确含义是:Jev 无法在预定义输出之外"编造文字",所以不会出现"虚构一个不存在的工具名"。但它仍可能做出错误的有界判断——概率不是正确性的保证。生产系统必须自己决定:置信度高到什么阈值才自动执行,否则就转人工复核。正如开源框架 Pi 的 CTO 阿明·罗纳彻所言,这把"多高的置信度才算安全"的责任,转移给了开发者。
五、结论:它不是来取代 ChatGPT 的,是来给机器当"反射神经"的
Jev 的正确定位,是嵌在 Agent 框架里的"有界判断层",而非另一个聊天机器人。LLM 继续负责开放式推理与文本生成,Jev 负责路由、分类、评分、护栏、停/行闸门。具身智能(机器人"大脑")从业者已表现出兴趣:机器人不仅需理解环境与规划任务,还要在候选动作、工具调用、安全约束之间持续抉择——传统方案是先生成文字再解析,Jev 则把整理好的环境状态直接映射为类型明确、带概率的决策。发布后 TypeSafe 的 API 一度因访问洪峰无法服务,恰是开发者用脚投票的证明。
从更大的视角看,Jev 标志 AI 正从"生成内容"迈向"做出决策"——当智能的单位成本下降两个数量级,"自动化"才真正从 demo 走向流水线。这或许正是阿尔梅达想说的:聊天很精彩,但计算机要的是判断。
数据来源:TypeSafe AI 官方博客《Introducing System One Models & Jev》;新浪科技/澎湃科技 2026-09-20 报道;TechCrunch、The Next Gen Tech Insider、AlphaMatch、Arabian Post 技术评测与第三方实测。 说明:文中性能倍数来自 TypeSafe 自有评测(公司承认处于收益上限、存在内部偏差);独立实测约 25 倍更快但准确率略低。雷达图与饼图为定性/示意刻画,仅供理解范式差异。
— 格寻记 · 看懂技术背后的生意与逻辑 —