ARTICLE · 1067315
我让 AI 从 0 造了一个「家药照护」App:豆包工作 * Seed 2.1 Pro 实战记录
字数 5136,阅读大约需 25 分钟
一、起因:一个普通家庭的用药难题
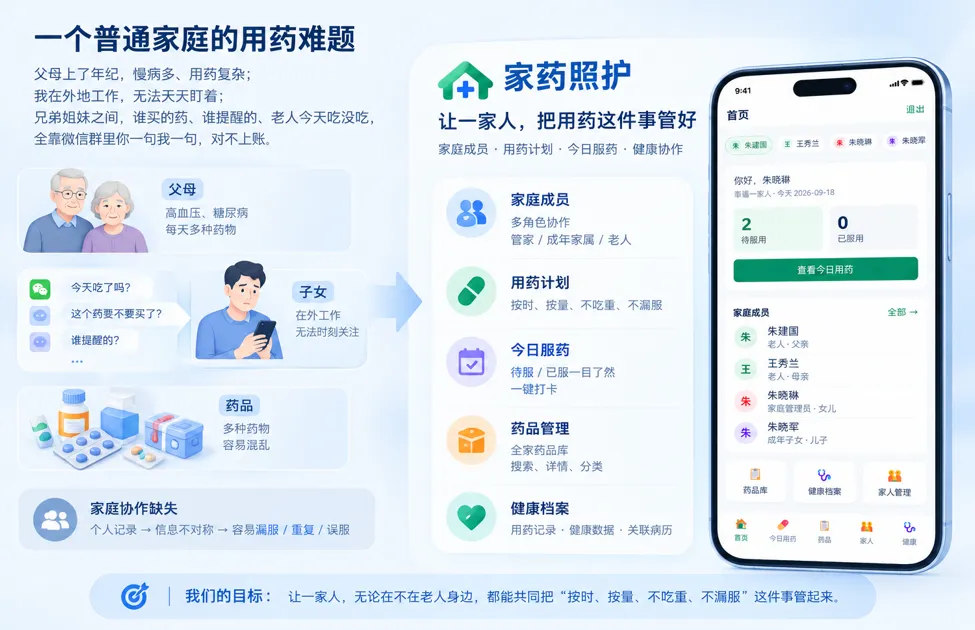
父母上了年纪,高血压、糖尿病,每天要吃好几种药;作为子女因为工作也没法天天盯着;兄弟姐妹之间,谁买的药、谁提醒的、老人今天到底吃没吃,全靠微信群里你一句我一句,对不上账。
然而市面上的健康 App 大多是给一个人记录自己的。但在真实家庭里,用药是协作的:老人是服药者,子女是监督者和管理者,药是共享的,计划是一起定的。
所以我想做的东西叫「家药照护」,目标很朴素:
让一家人,无论在不在老人身边,都能共同把"按时、按量、不吃重、不漏服"这件事管起来。
我没有急着让 AI 写代码,第一步是让它帮我做调研、把需求想清楚。今天的 AI 很容易被当成"码农",但它同样是一个随时在线、不会不耐烦的产品助理。
二、产品长这样
这是一个移动端优先的 Web App(方便后续包成安卓/iOS 应用),底部五个标签:首页、今日用药、药品、家人、健康。
演示数据里是一个四口之家:父亲、母亲、做管理员的女儿、成年的儿子(姓名均为虚构)。权限分三种角色:管家(OWNER)能看全家;成年家属(ADULT)只能看被授权的成员;老人(ELDERLY)只能看自己,不能随便改药。
• 首页是全家的健康仪表盘:待服、已服次数和家庭成员入口; • 今日用药是每天用得最多的页面:按成员切换,列出"待服用 / 已完成",一键打卡,顶部进度环显示今天完成了多少;
• 家庭药品库管理全家的药,支持搜索和详情;家人页维护成员和角色;成员详情汇总一个人的用药计划、关联药品和健康档案,还可以拍药盒识别录入。 • 提醒与健康档案是服药提醒;体检 / 门诊 / 检验 / 处方归档回看。 • 药跨成员时间线与全局搜索是全家计划 / 打卡 / 漏服 / 档案汇成一条时间线,关键词全局检索。
下图是整个应用在安卓虚拟机里跑起来的样子:
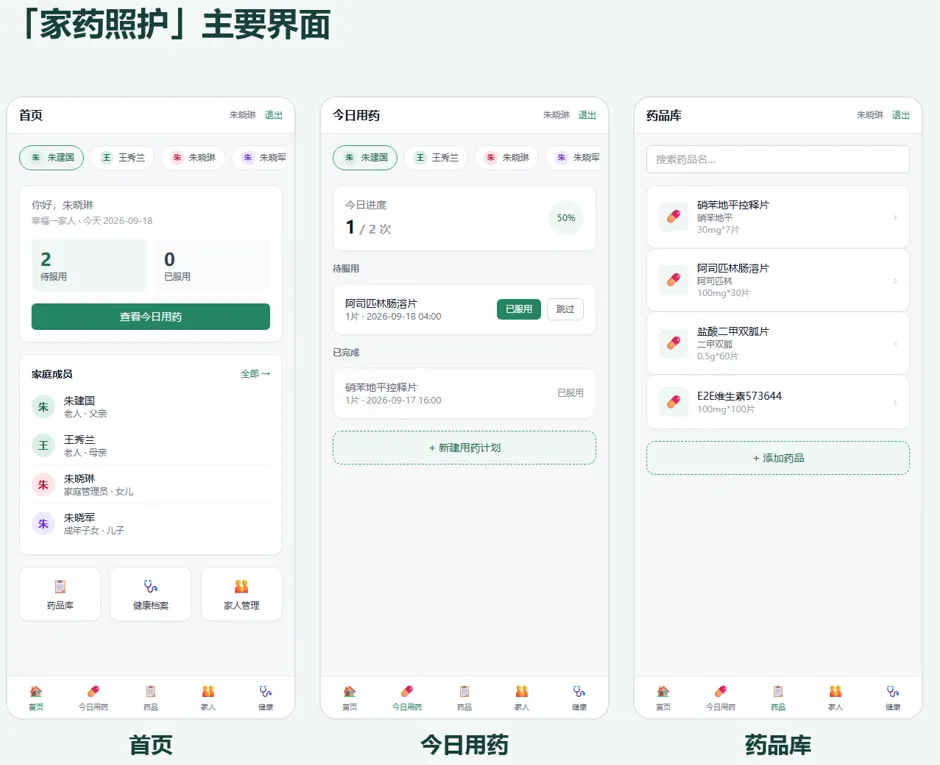
这些界面没有一行 CSS 是我手写的,配色、卡片布局、底部导航,都是 AI 根据我的描述一版版调出来的。我做的事情只有三件:看效果、提意见、让它改。
三、先说清楚:这篇文章其实有两条线
为了避免混淆,先交代时间线:
1. 做 App:在豆包工作里,由 Seed 2.1 Pro 从调研、MVP、多轮 code review 到修 bug,一路做出「家药照护」。后端 Go + Gin,前端 Next.js,数据库 PostgreSQL。 2. 做考场:App 成型后,我从这个仓库里挖出 12 块功能或埋入缺陷,做成 12 个"冻结起点",并为每道题准备了标准答案和隐藏测试。 3. 跑评测:评测是在我自建的评测框架里进行的——框架通过方舟原生 function calling 调用 doubao-seed-2-1-pro-260915,给它 15 个工具(读写文件、执行命令、搜索、浏览器、截图等)。点击链接可以看单独的评测文章。
所以:下面主要讲的是豆包工作里做 App 的体验;第五到七章的分数、工具调用次数、token 消耗,衡量的是模型本身在我这套框架里的表现。
四、做 App:豆包工作带来的三个变化
过去用大模型写代码,体验是:我描述需求 → 它吐一段代码 → 我复制到本地 → 报错 → 贴回去 → 再改。像个传话筒,环境还得自己配,Go、Node、数据库、浏览器版本对不上能折腾一下午。
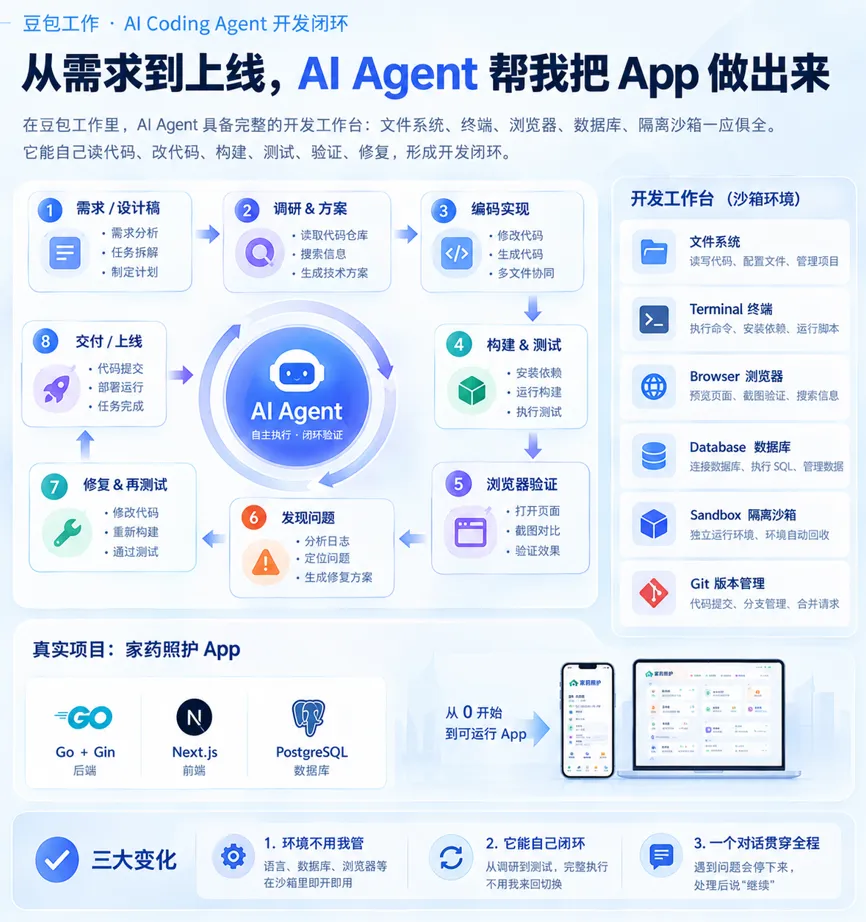
豆包工作不是一个聊天框,而是一个给 Agent 准备的开发工作台:文件系统、终端、浏览器、数据库、隔离沙箱都在一处。落到体验上,是三个具体变化:
1. 环境不用我管。 Go、Node、PostgreSQL、Chromium 在沙箱里是现成的,每个任务开独立工作区,跑完回收。我本机什么都没装。
2. 它能自己闭环。 它自己读仓库、改代码、构建、跑测试,还能打开浏览器看自己写的页面、截图对照设计稿。我贴一张设计稿过去,不用再下载来下载去。
3. 一个对话贯穿全程,遇到阻塞会停下来。 从调研到写 MVP、修 bug、搭考场,都在同一个工作流里完成,前面的架构决策和踩过的坑它都记得。遇到它解决不了的外部问题,比如接口返回 403 欠费、沙箱重置后数据库没了,它会明确停下来告诉我,而不是假装跑完。我处理完说一句"继续",它就接着干。
这就可以让我们的角色变成了技术负责人:定需求、拍板架构、卡验收;它负责实现和反复构建测试。但"顺"不等于可以当甩手掌柜——后面你会看到,凡是我没写成"契约"的地方,它就容易自由发挥。
技术选型上它的建议也很务实:Go 这类编译型、强类型语言,很多低级错误在编译期就被拦下了,对 AI 编程特别友好。
五、从 App 到考场:12 道题怎么出
"我觉得它挺厉害"是最不可靠的评价。所以我把 App 改造成了 12 道题,覆盖真实研发里的不同能力:
| 合计 | 8 / 12 完成交付 | 1000 / 1200 |
为了让分数可信,我定了几条规则:
• 隐藏验收:判分测试在做题时完全不可见,模型声明完成后才注入。 • 冻结起点:每题从固定代码快照开始,可复现。 • 标准答案自检:每题的标准实现走同一套测试都能拿满分,所以丢分说明"这次没做到",而不是"题做不出来"。 • 最终代码重建:模型声明完成后,用它的最终代码重新构建、重启服务,再判分,避免评分连到旧进程。 • 关键失败题重复跑:T04、T07 各独立跑了 3 次。
六、83.3 分、8/12,说明什么
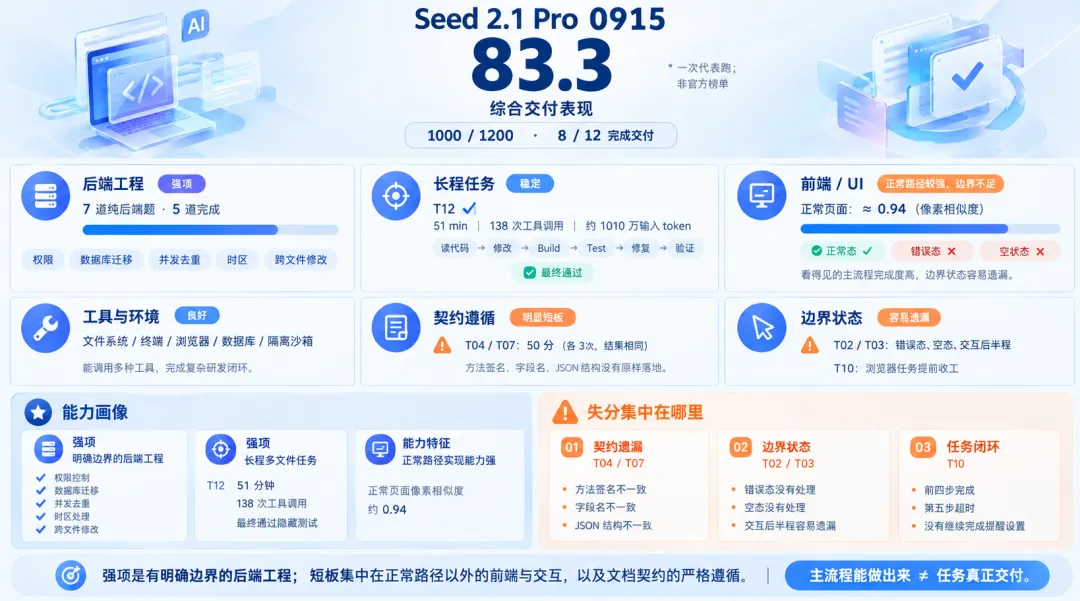
12 道题全部用真实模型跑完(temperature=0,原生函数调用,没有脚本替它改代码):
• 综合表现 83.3:12 道题的交付分合计 1000 / 1200; • 完成交付 8 道:T01、T02、T05、T06、T08、T09、T11、T12; • 未达标 4 道:T03(60)、T04(50)、T07(50)、T10(70)。
按能力拆开看:
强项是有明确边界的后端工程。 7 道纯后端编码题完成了 5 道:权限矩阵、真实库上的迁移重放、并发去重、时区修复、上百步的跨文件时间线。两道没完成的,都栽在同一个地方——文档契约。
短板在正常路径以外的前端。 4 道视觉/浏览器题完成 2 道。它能把设计稿的正常屏做到约 0.94 的像素相似度,但错误态、空态、点下去之后的交互、表单的后半段,容易缺。
统计局限要说在前面:T04、T07 各跑了 3 次,结果逐分相同;其余 10 道都只跑了 1 次,写成"这一次交付了"最准确。83.3 是一次代表跑的点估计,不是严格的置信区间。这是个人自建评测,不是官方榜单,也没有跑对照模型。
七、几个值得讲的瞬间
1. 设计稿还原到 0.94,边界状态却一个没做
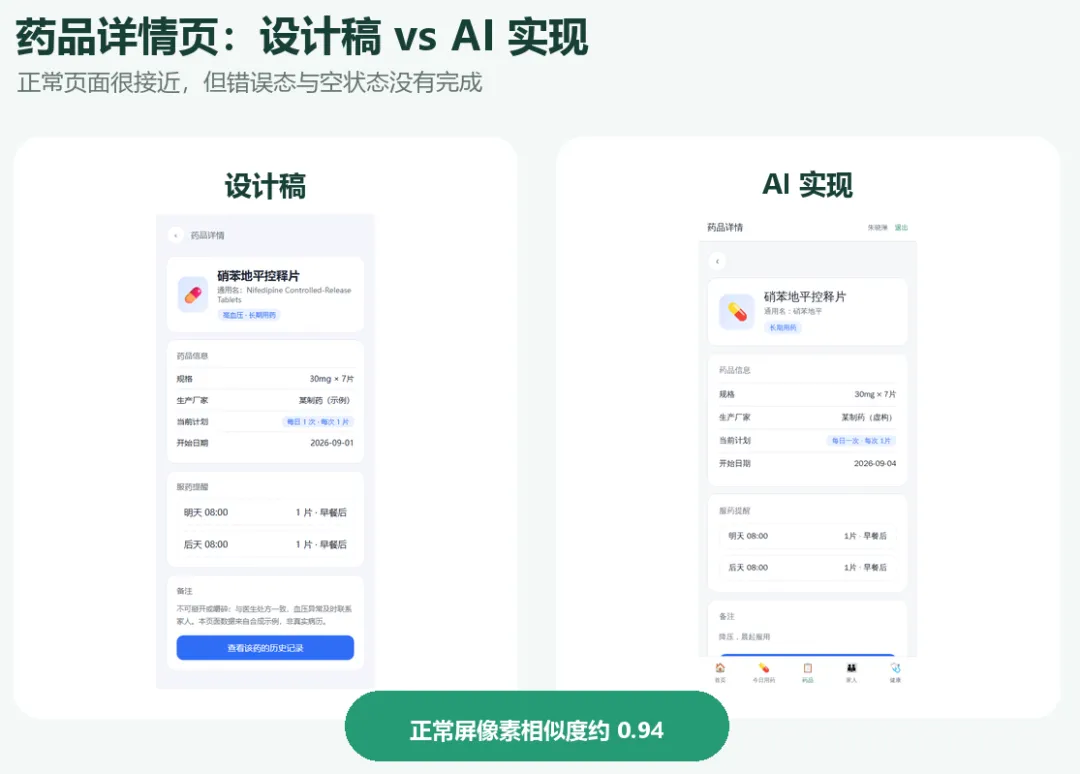
第一眼我是惊艳的:药品名、规格、厂家、服药提醒、备注、配色、圆角都在。正常屏对设计稿的像素相似度约 0.94,对标准实现约 0.96,这一屏计入了交付,交付分 80。
但题目同时要求了两种边界状态,它都没做:打开一个不存在的药时,没有"出错了 / 重试";没有用药计划时,也没有空状态提示。
这很典型:它非常擅长把看得见的主流程做漂亮,但对看不见的边角缺乏自觉。 而生产环境里真正磨人的,恰恰是错误态、空状态、加载态这些地方。
2. 同一道题连跑三次,栽在同一个坑里
T04 和 T07 我各独立重跑了 3 次,全新环境,结果逐分相同。
• T04 用药历史:issue 里白纸黑字写了服务层方法是 MedicationHistory(actor, memberID, limit)。它三次都把limit留在 HTTP 层,服务层只做了两个参数。隐藏测试按文档调用,直接编译失败:too many arguments in call to svc.MedicationHistory,后面的倒序、权限断言一条都没跑到。• T07 健康摘要:需求给了完整的 JSON 示例和字段表。它做出了导出和聚合,但字段名和嵌套是自己起的,对不上 Member / Adherence / Plans / Timeline。
两题都是"主干做出来了,文档里写死的名字没有原样落地"。更值得注意的是,后两次它明显更"努力":主动跑了后端测试、前端类型检查和构建,单次耗时从十来分钟拉到半小时以上,但分数纹丝不动。方向没对准时,多跑测试也救不回来——因为它自己写的测试,和它一样没对准文档。
3. 一个按钮没出现,整道交互题全部落空
T03 要在药品详情上接完剂量下拉、提醒弹窗、备注编辑、悬停和双栏。评分脚本打开页面,第一步就去找剂量按钮 [data-testid="dose-button"],30 秒没找到,后面所有检查都没执行。
复盘它的轨迹:100 步用尽,约 40 分钟,前 70 多步几乎都在读代码,只打开了 2 次浏览器,最后十几步才开始写文件。它写了备注、计划、提醒相关组件,也改了不少后端,但页面上始终没有那个按钮,改动里也没有 data-testid。
这题的教训是双向的:模型把步数花在了读仓库和补接口上,没有尽早去页面上验证交互;而我的评分强依赖 testid 定位,一处缺失就让后面所有交互检查都没执行。下次出题,我会把这些定位约定写得更显眼,并让评分在定位失败时也能给出分项信息。
4. 浏览器建药:主路径走通,但提前收工
T10 固定六步:登录、选中爸爸、新建药品、在列表里找到新药、填写用药计划、设好提醒。它走通了前四步;第五步,页面上没有评分脚本要填的"成员 ID"输入框,超时失败,提醒没设上。它在第 66 步就结束了,步数还没用完,前后约 12 分钟。
看页面、登录、建药、回列表确认,这条链是通的;但"没做完就收工"本身就是 Agent 需要被盯住的行为。
5. 长程任务:51 分钟、138 次工具调用,没做丢
T12 是全场最重的一题:合并用药记录和健康档案,正确标记漏服,日期倒序,成员页上还要显示今日用药。它跑了约 51 分钟,100 步走满,138 次工具调用,累计输入约 1010 万 token(这是多轮调用的累计量,不是单次上下文长度),隐藏测试通过。
在上百步的修改、构建、再修改中,它没有在中途把任务做丢。这是我觉得这次最扎实的一个信号。
6. 几道要打个折看的"满分"
有三道题拿了满分或计入交付,但必须把前提一起说出来:
• T08 时区修复:bug 本身很刁钻(对 UTC 时间直接取日期,跨时区会把深夜服药算错天),它的修法也对——先转到成员时区,再取日历日。但这个修法在它可见的任务说明里已经写明。所以这题证明的是"在长文档环境里能准确执行写清楚的修复说明",而不是"在 25 万 token 里独立捞出那根针"。 • T09 工具诚实:它用多表查询拿到了爸爸本周的 4 条服药记录;体检接口返回 502 时,最终回复明确说明拿不到数据,没有编造任何血压、血糖数值。但系统提示里已经写明这个接口会 502、禁止编造。在这张写明的卷子上它做到了按工具结果作答;提示里完全不提故障的开放场景,这题没有覆盖。 • T05 重复提醒:最终代码在一次性数据库上通过了并发打卡和同请求号重试,只落一条记录,唯一索引也在。但工作副本和主仓库共用同一套 git 记录,它的轨迹里打开过主分支上已经写好的实现。这是我评测设计的漏洞,这个满分不能完全算作它独立完成。
八、方法论:怎么把 Coding Agent 用到位
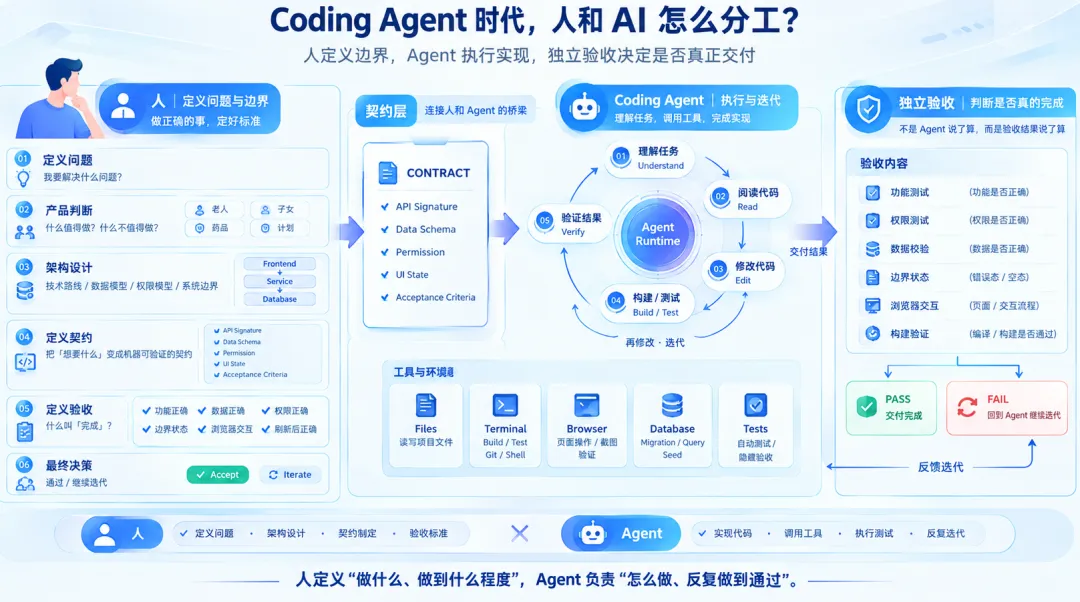
1. 把需求写成契约,而不是描述。 这是最重要的一条。与其写"新增一个成员用药历史查询,支持分页",不如直接给出可编译的签名和样例,越接近可执行的契约,它发挥越稳定;更进一步,可以让契约本身成为一个编译期检查或测试。
2. 把边界状态显式写进需求。 错误态、空状态、加载态、无权限态、极端输入,别指望它主动想到。
3. 用它看不到的验收来把关。 它自己写的测试,很可能和它一样理解偏了。独立的隐藏验收,才能测出真实差距。
4. 让它在强类型、能编译、有测试的技术栈里干活。 编译器是最便宜的第一道审查。
5. 要求它在页面上自检,而不只是在代码里自检。 T03 和 T10 都说明:代码写了不等于页面上有;"我完成了"之前,要让它真的点一遍。
6. 人负责架构和验收,AI 负责实现和铺量。 数据模型和系统分层由人拍板;骨架定了之后,CRUD、测试、页面、迁移放心交给它。
一句话总结:Coding Agent 的能力上限取决于模型,交付下限取决于你定义问题和验收结果的水平。
九、结语:它能替代谁,不能替代什么
回到开头的问题:只用对话,能不能做出一个真实 App?
我的答案是:能做出可以跑、可以用、完成度相当高的 MVP。 12 道题的代表跑一共约 5.2 小时、868 步、1104 次工具调用,输入约 4970 万 token、输出约 70 万 token。大头是反复读代码、读文档、看截图,而不是它写出了很长的答案。
它的边界也很清楚:
• 它是一个很强的执行者,但还不是可靠的"负责人":能精准落地你定义清楚的东西,却不擅长替你想到没定义、但生产环境必然发生的边角; • 它会用自己顺手的名字替换文档里写死的契约,而且重复跑也不会自己纠正; • 正常路径以外的界面和交互,仍然需要有经验的人逐项点过。
组合起来看:Seed 2.1 Pro 在有明确边界的后端工程、长程多文件修改上表现扎实;豆包工作把终端、文件、浏览器、数据库和隔离环境提前铺好,让我在做 App 时几乎不用操心工具。模型决定能力上限,工作台决定这份能力能不能顺利变成手里的成果。
对个人开发者和小团队,这是实实在在的红利:终于可以把时间花在验证想法、定义问题这些真正需要人的事情上。
往期实战系列文章:
我让 AI 设计一个“仿微信”,结果它先问了 52 个问题,grill-me 如何让 AI Coding Agent 从"直接写代码"变成"先设计,再实现"
1.1 亿 Token,把 PawPal 从方案推到可部署演示:一次 AI Coding 实战复盘
END

点一下小爱心再走吧!