ARTICLE · 1073950
爱可可AI前沿推介(9.25)
LG - 机器学习 CV - 计算机视觉 CL - 计算与语言 AI - 人工智能 RO - 机器人
1、[AI] CART:Closed-Loop Adaptive Red Teaming for Large Language Models
2、[RO] The Gaussian Is Enough:Flow-Matching Priors Do Not Help When Fine-Tuning Large Behavior Models
3、[RO] Intelligence Across Embodiments
4、[CL] Planned Test-Time Scaling with Coordinated Reasoning Paths
5、[LG] WTF?! Simulation-Free Reinforcement Learning with Wasserstein-Tilted Flow Maps
摘要:大语言模型闭环自适应红队对抗、流匹配先验在微调大行为模型时并无增益、跨具身智能、基于协同推理路径的规划式测试时扩展、基于瓦瑟斯坦偏置流映射的无模拟强化学习
1、[AI] CART: Closed-Loop Adaptive Red Teaming for Large Language Models
D Zhang, T Lv, Y Jia, Y Zhao,…
[Microsoft Research]
CART:大语言模型闭环自适应红队对抗
要点:
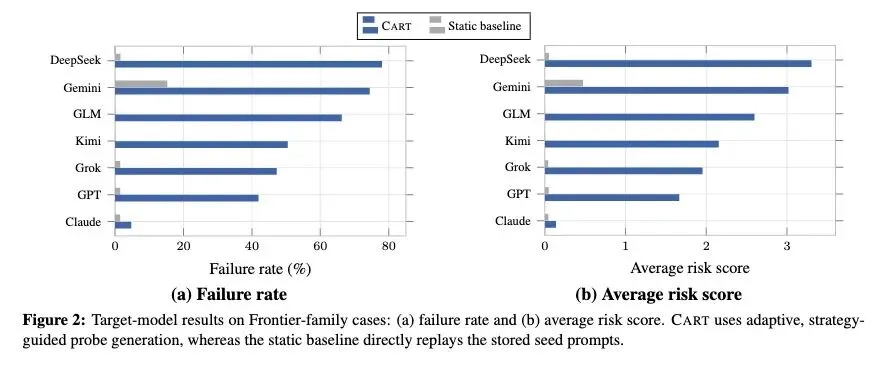
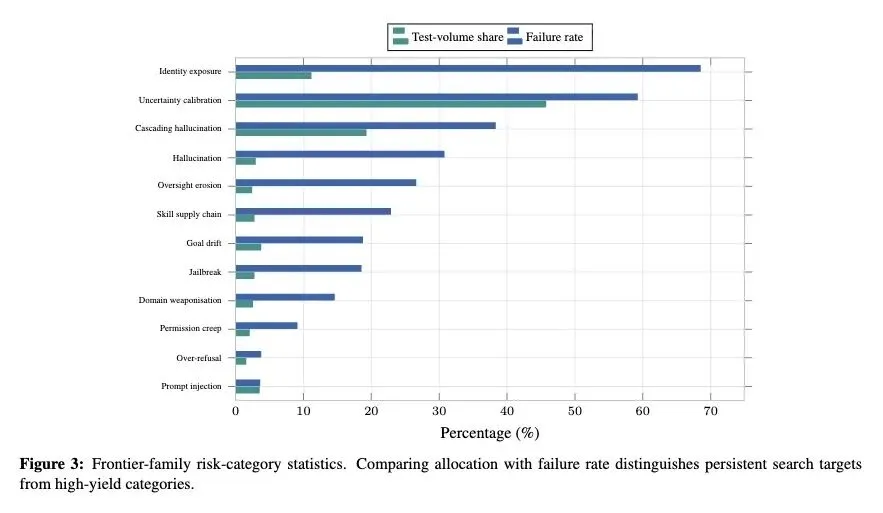
挑战了标准的“开环”红队测试范式(静态基准回放),认为它无法充分暴露需要特定上下文、框架或代理交互才能触发的漏洞。 提出了CART(闭环自适应红队测试)框架,将测试过程解耦为三个独立角色:Challenger(挑战者,生成探针)、Target(目标,被测模型/代理)和Judge(裁判,评估响应)。 采用汤普森采样(Thompson sampling)动态分配测试预算,在探索未知的风险类别和追踪已发现的弱点之间取得平衡。 强制执行严格的“多样性指令(Diversity Mandate)”,确保在发现弱点后,后续探针在角色、领域、格式或语言上进行变化,防止系统仅仅停留在对同一个提示词的同义改写上。 引入“种子血统(Seed Lineage)”追踪机制,保持可审计的记录,将生成的攻击追溯到原始基准测试用例(如重放、适应、扩展、自生成),缓解了基准污染的担忧。 在完全相同的闭环架构内,同时支持纯文本大语言模型和具有边界的工具调用代理(Agent)的测试。 反直觉发现1:对静态越狱的鲁棒性不能预测上下文或代理环境中的安全性。在静态提示下表现极其安全的模型(如Claude),当相同的危害被改编为工作流或代理上下文时,其失败率会显著上升。 反直觉发现2:在“挑战者-裁判”动态博弈中,漏洞发现的天花板主要由Challenger的生成能力决定(占矩阵变异的73.9%),而不是Judge的严格程度(仅占5.6%)。瓶颈在于攻击者,而非评估者。 反直觉发现3:自我评估(使用同一个模型同时担任Challenger和Judge)会产生巨大的反馈扭曲。为了保证红队测试的可靠性,角色分离是绝对必要的。 实验证明,在Frontier、JAH和Agentic数据集上,相比于静态基准,CART在所有被评估模型(GPT, Claude, Gemini, DeepSeek, Grok, GLM, Kimi)上都挖掘出了更高的失败率和平均风险分数。
主旨: 解决现有自动化红队测试过度依赖静态基准(即“开环”测试),导致无法从测试失败中学习,且难以发现大语言模型在特定上下文或代理(Agentic)交互中隐藏漏洞的问题。论文提出了一种名为CART的闭环自适应红队测试框架,将红队测试从一次性的清单打分,转变为持续、自适应且可审计的动态漏洞搜索过程。
创新:
角色解耦机制:将红队测试系统拆分为Challenger、Target和Judge三个独立的大模型实体,消除了自我评估带来的偏差。 汤普森采样与多样性指令结合:使用汤普森采样在“广度覆盖”和“深度挖掘弱点”间动态分配算力,同时引入多样性指令,强制每次生成的攻击在语境、角色等维度上异质化,避免陷入“换汤不换药”的局部最优。 种子血统追踪(Seed Lineage):创新性地将静态基准测试用例作为“种子”,通过清晰的溯源标签记录新生成的攻击是如何由种子演变而来的,兼顾了探索的广度与结果的可复现性。 统一的文本与代理评估环境:使用同一套闭环逻辑,既能测试纯文本的问答越狱,又能通过模拟工具(Mock Tools)测试Agent在多步调用、内容检索和间接提示词注入中的安全性。
贡献:
实证贡献:通过在多款最先进的模型上进行大规模实验,证明了自适应闭环测试在发现隐蔽风险方面全面优于静态测试,揭示了Agentic环境是当前大模型安全的一大薄弱环节。 理论/认知贡献:量化分析了红队测试中生成者(Challenger)和评估者(Judge)对最终结果的影响权重,纠正了业界过度关注“裁判模型偏差”的认知,指出“挑战者模型的攻击生成能力”才是发现漏洞的核心驱动力。 系统贡献:开源/提供了一套高度可配置、可复现、带有完整审计追踪(从Prompt生成到最终风险打分)的自动化红队评估流水线。
提升:
风险检出率(Failure Rate & Risk Score):在Frontier、JAH(包含HarmBench等)和Agentic三大测试集上,CART使所有受测模型(如Claude, GPT, DeepSeek等)的失败率和平均风险得分均出现显著提升(例如Agentic场景下,静态基准几乎测不出失败,而CART测出大量致命漏洞)。 评判一致性:独立同行评审(Peer-review)显示,不同模型对CART判决结果的二元(Pass/Fail)同意率高达98.9%,验证了框架评估的客观性。 漏洞维度拓展:不仅提升了传统越狱的成功率,还在指令遵循、跨语言鲁棒性、工具越权、供应链投毒等深层能力维度上发现了大量静态基准无法触及的风险。
不足:
扩展性瓶颈:随着风险类别、策略库和历史记忆的增加,上下文窗口的消耗会急剧上升,当前依赖固定滑动窗口的方法在处理海量测试数据时可能丢失长程历史信息。 Judge校准的不稳定性:虽然Pass/Fail的二元判断极其稳定,但Judge在给出具体解释、连续风险分数校准(如置信度、爆炸半径)时,不同模型间仍存在分歧,难以作为绝对的“预言机(Oracle)”。 统计因果验证的局限:实验主要是描述性的,虽然揭示了CART的优势,但在控制变量(如匹配所有的随机种子、提供每种配置的置信区间)以进行严格的因果推断方面还有待加强。
心得:
重新定义基准测试的价值(Benchmarks as Seeds):我们过去习惯将评测基准当作考试的“终点线”,刷榜即安全。本文启发我们,基准测试的真实价值应作为探索潜在漏洞空间的“起点坐标(Seeds)”。通过顺藤摸瓜式的自适应变异,才能暴露出模型真实的脆弱性。 “静态安全”的幻觉:一个能在单轮对话中完美拒绝生成恶意代码的模型,如果在代码审查的上下文中,被赋予了“急需修复的PR”和“上级施压”的设定,可能就会乖乖写出恶意代码。这深刻提醒我们,脱离了应用上下文和Agentic工具调用的“对齐税(Alignment Tax)”,其安全性是不堪一击的。 矛的锋利度决定了盾的上限:在构建自动化评估系统时,业界常常在“Judge模型”的提示词上反复雕花,担心其不够公平。但本文指出,73%的漏洞发现方差来源于Challenger模型的能力。如果你的“矛”不够聪明,想不出刁钻的上下文,“裁判”再严苛也无济于事。强化攻击生成能力并坚持角色隔离,是红队测试演进的关键。
一句话总结:
CART框架通过将大模型红队测试从“静态清单核对”升级为“自适应的闭环追踪搜索”,证明了通过角色解耦和动态上下文变异,能够暴露出大模型在复杂工作流和代理交互中隐藏的巨大安全风险,彻底打破了静态基准带来的安全幻觉。
Automated red teaming often replays a fixed set of prompts, which measures known risks but cannot learn from failures found during testing. We present CART (Closed-Loop Adaptive Red Teaming), a framework that uses each result to guide what it tests next. CART begins with broad risk coverage, follows weaknesses that emerge, keeps new probes diverse, and records the evidence and source of every finding. It separates the Challenger that creates tests, the Target being tested, which may be a text-only model or a bounded tool-using agent, and the Judge that evaluates the results, allowing these roles to be studied independently. Across three evaluation families—Frontier, JAH, and Agentic—CART discovers more failures and higher average risk than static seed replay for every Target with an available baseline. The gains extend to tool-mediated agent tests, suggesting that contextual adaptation can reveal weaknesses that direct prompt replay does not exercise. These results describe what the test policies discover, not how often failures occur in real deployments. We also find that Challenger–Judge choices affect the evidence uncovered, highlighting the need for role separation and independent review. Overall, CART turns red teaming from a one-time checklist into a continuous, adaptive, and auditable search for model and agent weaknesses.
https://arxiv.org/abs/2609.27336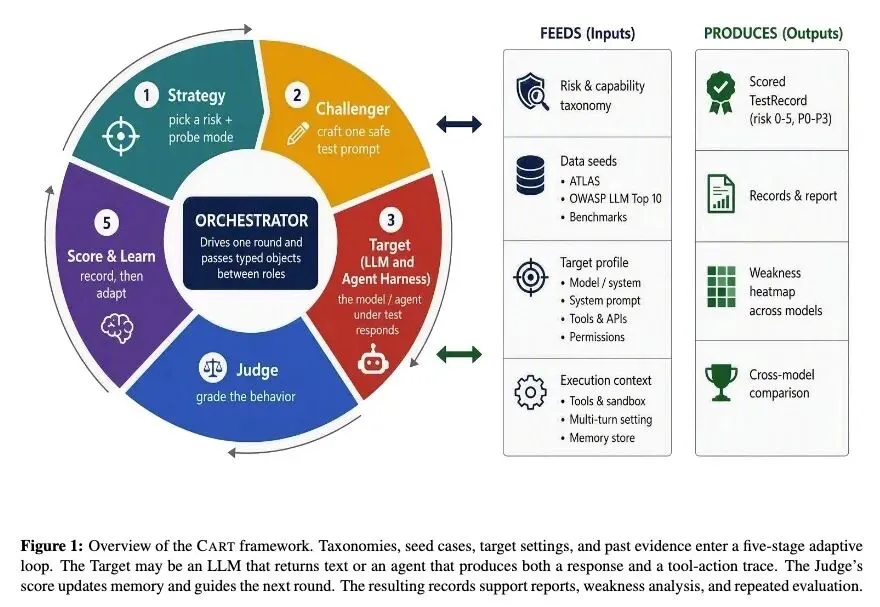
2、[RO] The Gaussian Is Enough: Flow-Matching Priors Do Not Help When Fine-Tuning Large Behavior Models
C Xu, R Shah, H Kress-Gazit, H Nishimura,…
[Toyota Research Institute & Woven by Toyota & Cornell University]
高斯分布足矣:流匹配先验在微调大行为模型时并无增益
要点:
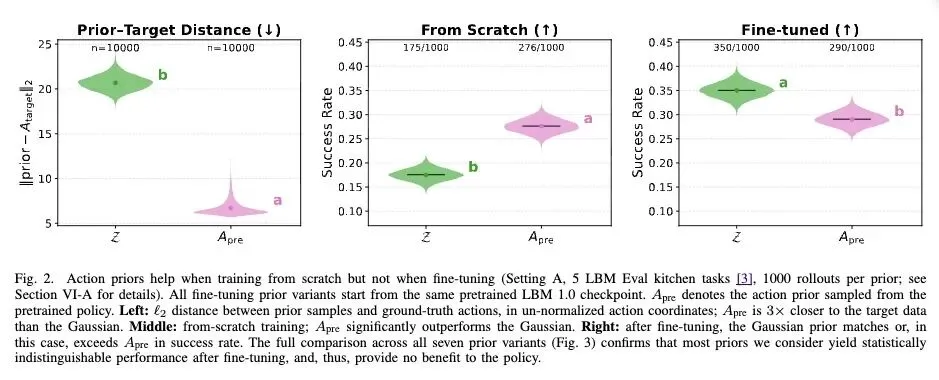
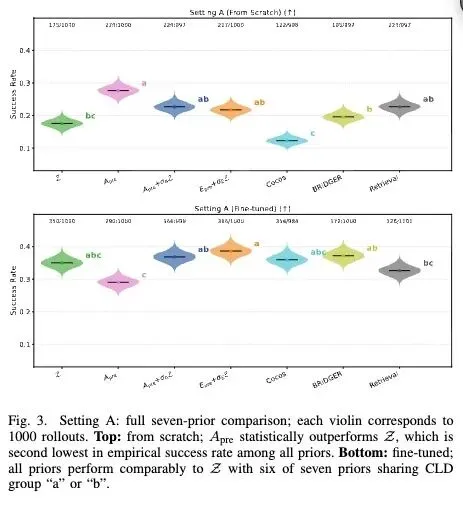
挑战了生成式策略训练中的传统假设,即在微调预训练的大型行为模型(LBM)进行机器人模仿学习时,更接近目标分布的非高斯先验能提升训练效果。 揭示了一个极具反直觉的发现:在LBM微调过程中,那些在数学和几何上明显更接近目标动作分布的先验,其微调表现与最基础的标准各向同性高斯先验 N(0, I) 相比,在统计学上毫无区别,甚至表现更差。 证明了非高斯先验在“从头训练”(training from scratch)时带来的显著性能提升,在微调预训练权重时会完全消失。 进行了超大规模的实证评估:在3种最先进的LBM架构(LBM 1.0、π0、GR00T N1.5)上进行了超10万次仿真测试(涵盖40多个任务),并在真实双臂机器人硬件上进行了1250次测试,结论高度一致。 深入剖析了内在机制:不同的先验会导致编码器的内部表征(Embeddings)发生显著分化,但神奇的是,它们最终输出的动作预测和条件动作似然却殊途同归,收敛到了完全相同的质量水平。 通过学习率消融实验证实:预训练观察编码器(Observation Encoder)的质量和训练动态彻底主导了微调性能,这使得动作空间中先验的选择变得无关紧要。 指出了唯一的例外情况:只有在极低数据量(例如仅使用5%的微调数据,约20个演示)的情况下,基于嵌入扰动的先验(Epre+σEZ)才比高斯先验表现出统计学上的显著优势。
主旨: 这篇文章主要探究了在微调大型机器人行为模型(LBMs,如基于流匹配或扩散模型的策略)时,使用更接近目标动作分布的非高斯先验(如流匹配先验)是否能比标准的各向同性高斯先验带来更好的下游任务性能。
创新:
设计了全面且严谨的实验范式,将“从头训练”与“微调”场景进行严格对比,剥离了模型架构对先验效果的干扰。 提出了三种无需额外训练、直接从预训练LBM中实时提取结构化先验的新方法(Apre, Apre+σAZ, Epre+σEZ),并与文献中已有的复杂基线先验(Cocos, BRIDGER, Retrieval)进行了横向对比。 引入了深入的模型表征诊断分析工具(如LogME特征质量评估、动作空间L2距离/余弦相似度、特征空间分化分析),首次在机器人动作生成策略中解耦了“编码器特征学习”与“动作生成过程”对最终性能的相对贡献。
贡献:
实践贡献:得出了一个明确的“负面”结论(Negative Result),证明标准高斯先验在LBM微调中已经足够好,从而免去了从业者在设计和工程化复杂非高斯先验上的算力和时间开销。 理论贡献:通过大规模实证(跨越3个流行LBM架构、双仿真器及真实硬件),揭示了预训练模型微调时的优化动态——模型的观察编码器会自动进行大幅度调整以补偿先验的差异,最终达到相同的闭环性能。 归因分析:确认了“观察编码器的训练质量”是决定LBM微调性能的绝对主导因素,其重要性远远压倒了动作空间先验的选择。
提升:
这是一篇“证伪”类的实证论文,其“提升”不在于提出了刷榜的新算法,而在于极大地提升了研发效率:证明了在LBM微调阶段,放弃复杂的非高斯先验(如CVAE、KNN检索等),直接使用计算成本最低的高斯先验,即可实现与最优先验完全持平的成功率(Success Rate)和任务进度(Task Progress)。 阐明了资源的正确投放方向:提示研究者将计算资源和优化精力从“先验分布设计”转移到“提升视觉/语言观察编码器的表征质量”上,这能带来更实质性的性能飞跃。
不足:
局限性受限于当前模型规模和数据量:论文的发现基于当前的LBM(几亿到30亿参数量)和相对较小的微调数据集(每个任务20-400个演示),在未来拥有海量微调数据或更大参数模型时,该结论是否依然成立仍是开放问题。 缺乏深度的理论数学证明:虽然实证分析发现不同先验会导致编码器表征分化但性能相同,但未能在损失景观(Loss Landscape)、塑性(Plasticity)或线性模式连通性层面给出严密的数学理论解释。 低数据区间的边界模糊:发现5%微调数据下非高斯先验有效,但未能精确刻画出先验从“有效”到“失效”的具体数据量临界相变点。
心得:
几何距离近不代表优化更容易(反直觉陷阱):我们直觉上认为,先验分布距离目标分布越近(L2距离越小),模型需要拟合的“传输距离”越短,效果应该越好。但本文打破了这一幻觉,深度学习的优化是一个高维流形上的联合优化问题,输入端(编码器)的自适应调整完全可以抹平输出端(先验)的几何优势。 预训练权重具有强大的“表征惯性”和“自愈力”:“从头训练”有效的技巧在“微调”时往往失效。因为预训练模型已经具备了强大的特征提取能力(Inductive Bias),微调时,优化器更倾向于重塑编码器的特征空间来适配任务,而不是依赖你喂给动作头的先验分布。编码器就像一个强大的弹簧,吸收了先验变化带来的所有扰动。 机器人基础模型的核心瓶颈在“感知表征”而非“动作生成”:通过降低编码器的学习率导致所有先验性能暴跌,深刻揭示了Vision-Language-Action模型中,真正决定上限的是模型能否从图像和文本中提取出高质量的、预测性的表征(LogME分数)。这启发我们在未来的机器人AI研发中,应将重点放在多模态编码器的预训练质量上,动作头(Action Head)只负责简单的去噪执行即可。
一句话总结:
本文通过跨越3种前沿架构和真实硬件的大规模实证研究得出了一个极具反直觉的结论:在微调大型机器人行为模型(LBMs)时,精心设计的、更接近目标分布的非高斯先验完全无效,最简单的标准高斯先验已经足够,因为微调性能的上限实际上是由预训练编码器的表征质量所绝对主导的。
Modern robot imitation learning increasingly relies on generative policies based on diffusion or flow-matching models, which generate actions by transforming samples from a prior distribution. A key question is whether the choice of prior matters. Replacing the standard Gaussian with a closer-to-target, non-Gaussian prior has been shown to substantially improve performance when training from scratch. A natural next step is to ask whether these gains transfer to fine-tuning pretrained Large Behavior Models (LBMs) such as LBM 1.0, π0.5\pi_{0.5}, and GR00T~N1.5, where one might expect even larger gains. Surprisingly, we find that this is not the case, except possibly at very low fine-tuning data fractions. Across over 100K simulation rollouts spanning all three aforementioned LBMs on 40+ tasks in two simulation platforms, and 1250 hardware rollouts on five bimanual manipulation tasks, non-Gaussian priors that are demonstrably closer to the target yield statistically indistinguishable or worse fine-tuning performance than a standard Gaussian prior. Diagnostic analyses suggest why: fine-tuned imitation learning policies converge to similar action predictions across priors, despite their fine-tuned encoder embeddings diverging substantially from the pretrained embeddings and each other. A learning-rate ablation further confirms that encoder training is the dominant factor in fine-tuning performance, substantially outweighing the effect of prior choice. We conclude with concrete directions for future research on when and why learned priors might still matter in fine-tuning.
https://arxiv.org/abs/2609.27070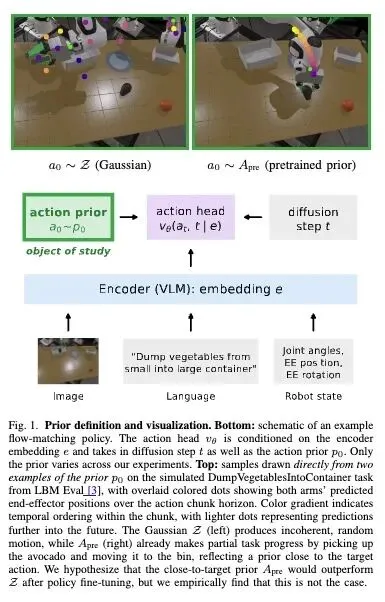
3、[RO] Intelligence Across Embodiments
B Ai, H I. Christensen, H Su
[Stanford University & University of California San Diego & Sudo AI GmbH]
跨具身智能
要点:
挑战了跨机器人学习中依赖人工工程对齐(例如:标准化夹爪、类人形态或人工设计的末端执行器动作空间)的传统方法,认为这些人类设计的先验假设将成为模型规模化扩展(Scaling)的长期瓶颈。 提出将“具身多样性”(Embodiment Diversity)作为人工智能规模化扩展的一个基础且核心的维度,其重要性与任务多样性和环境多样性等同。 强调了一个受自然启发的反直觉观点:类人形态未必是最佳的通用物理形态;通用的物理智能必须适应各种生态位和结构差异,而非局限于人类形态。 在泛化评估中引入了一个关键的区别:“运动级别迁移”(通过调整关节来保持原有的接触模式)与“策略级别迁移”(当达到当前具身动态极限时,探索出一种截然不同的物理交互方式,例如由于动力不足,将“抖开衣物”改为“缓慢折叠”)。 引用了一个极具启发性的生物学现象(红腹滨鹬能根据食物变化可逆地改变其肌胃大小),呼吁开发能够在“生命周期”内动态重构自身物理形态以解决问题的人工智能体。 展望了向“自我进化机器人”发展的范式转变,即跨具身学习将作为桥梁,把智能的持续积累与不断迭代的硬件计算协同设计(Co-design)连接起来。
主旨: 探讨如何让具身智能在感知、形态、动力学和控制等物理属性截然不同且不断演变的机器人平台(具身)之间实现通用学习和迁移,呼吁放弃依赖人工设计的接口对齐,转而通过在海量“具身多样性”中学习通用表征,最终走向硬件与策略协同进化的物理智能。
创新:
视角创新:将“具身差异”从机器人学习中的“障碍”重新定义为推动模型获取更广泛先验知识的“规模化扩展维度(Axis of Scaling)”。 范式转移:提出机器人领域应效仿计算机视觉(摒弃手工特征转向神经网络),跳出手工设定对应关系(如强制映射到末端动作空间)的框架,让模型自主学习跨具身的潜在关联。 评估体系创新:首次明确提出了在跨具身迁移中“运动级迁移”与“策略级迁移”的区别,为评估具身大模型提供了更高阶的标准。
贡献:
理论贡献:系统性论证了“具身多样性”在累积性泛化学习中的核心作用,并指出现有依赖人类先验的对齐方法的长期局限性。 路线图构建:为未来具身基础模型(Foundation Models)的发展指明了方向,即需要设计能处理极度异构观测和动作空间的神经网络架构(如显式输入机器人描述或通过上下文学习推断具身属性)。 跨学科愿景:将机器人学习与进化生物学和计算形态设计相结合,提出了智能体在生命周期内自适应重构(适应)以及跨代硬件计算设计(进化)的宏大科学愿景。
提升:
认知维度提升:将业界对“泛化”的理解从单一的“新任务/新环境”提升到了“新物理形态/新动力学特性”的跨具身维度。 评估标准提升:要求未来的研究在声明“零样本(Zero-shot)泛化到未见过的机器人”时,必须精确界定测试时的具身信息输入、任务假设以及是运动级还是策略级的泛化,提高了该领域实证评估的严谨性。
不足:
数据获取瓶颈:尽管提出了扩大具身多样性的设想,但现实世界中构建、维护大量异构机器人并收集高质量专家演示数据的成本极其高昂,难以快速落地。 仿真到现实(Sim-to-Real)的鸿沟:虽然论文提倡利用仿真平台大规模生成多样化具身进行训练,但如何将这种包含复杂物理属性差异的跨具身策略无损地迁移到真实世界,仍是未完全解决的挑战。 架构落地的理论空白:论文提出了需要能处理异构输入输出空间的模型架构,但并未在本文中给出具体的数学公式或经实验验证的具体网络结构。
心得:
机器人领域的“苦涩教训(Bitter Lesson)”正在重演:正如自然语言处理和计算机视觉最终放弃了人工特征工程,靠算力和数据取得了突破;机器人领域试图通过“统一夹爪”或“强制映射到人类动作空间”来走捷径,长期来看注定会成为天花板。真正的通用具身智能,必须通过海量“具身多样性”数据,让神经网络自行领悟跨硬件的物理定律和任务语义。 “策略级迁移”重新定义了物理智能:真正的智能不在于“形似”而在于“神似”。如果一个机械臂因为电机扭矩不足无法像人类一样“抖开”毛巾,它能自主意识到这一点并改用“在桌面上一点点展平”的策略,这才是真正理解了物理世界,而不仅仅是轨迹模仿。这提示我们在训练具身模型时,必须引入对机器人自身能力边界的感知。 “软件”对“硬件”的反向塑造:传统观念认为AI是大脑,躯体是固定的载体。本文带来的巨大启发是“软硬协同进化”——未来的具身大模型不仅输出控制指令,还能评估当前物理形态的缺陷,进而指导下一代机器人的硬件设计,甚至在执行任务中让机器人“变形”(重构传感器或肢体)。AI将不再受困于一具躯壳。
一句话总结: 本文跳出了依赖人工对齐异构机器人的传统框架,创新性地提出将“具身多样性”作为具身智能规模化扩展的核心维度,通过学习通用表征来实现跨机器人的策略迁移,并最终描绘了一幅人工智能与机器人物理形态协同演化、自我进化的宏伟蓝图。
Robotic embodiment encompasses the sensing, kinematics, dynamics, geometry, actuation, and control through which an agent physically interacts with the world. These properties vary across robots and change over time. We argue that general embodied intelligence requires learning that accumulates across these differences. Prevailing methods that engineer correspondences to bridge embodiment differences offer immediate practical gains, but their assumptions limit the scope of transfer in the long run. Instead, a more general approach should discover representations that support transfer to a larger range of embodiments as experience grows. We propose embodiment diversity as a promising axis of scaling, and identify broad learned priors as a complementary ingredient. We call for evaluations that better characterize embodiment gaps and transfer performance. More broadly, cross-embodiment learning connects the practical challenge of learning from heterogeneous robot experience with a broader scientific pursuit inspired by nature - physical intelligence that adapts and co-evolves with its embodiments to gain agency over its behavior and physical forms.
https://arxiv.org/abs/2609.27095
4、[CL] Planned Test-Time Scaling with Coordinated Reasoning Paths
X Wu, L Bai, H Bansal, P Kung…
[University of California, Los Angeles]
基于协同推理路径的规划式测试时扩展
要点:
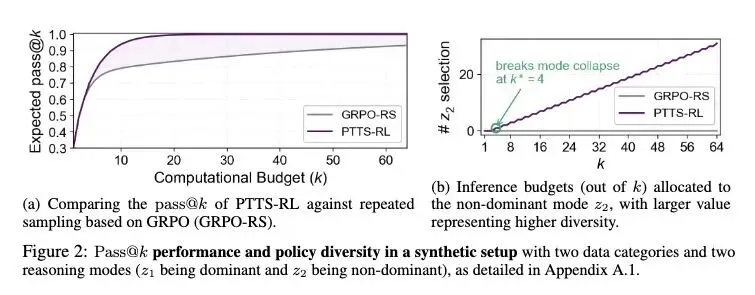
挑战了默认的测试时扩展范式(重复采样,RS),指出从单一策略中独立采样会导致尝试冗余和“模式崩溃”(Mode Collapse),尤其是在RL训练缩小了策略分布之后。 引入了计划性测试时扩展(PTTS),这是一个规划器-执行器(Planner-Executor)框架,通过在执行前生成 个不同的解决方案大纲来协调并行的推理分支。 提供了反直觉的理论证明:针对 pass@1 优化边缘策略(如标准的 GRPO 算法)在数学上必然导致模型坍缩到单一的绝对优势推理路径上。相反,直接针对 pass@k 优化(PTTS-RL)能在数学上保证将推理预算分配给互补的、非主导的推理模式,从而以更快的指数级速度降低残余错误率。 提出了 PTTS-ZS(零样本变体),其独特之处在于利用基础 LLM(利用其更广的分布多样性)在单次自回归生成中同时产出所有 个大纲,随后使用强大的推理模型进行独立执行。 提出了 PTTS-RL,直接以 pass@k 奖励为目标,对规划器进行端到端的强化学习训练。 引入了一个极其反直觉的训练技巧:“截断执行”(Truncated Execution)。在训练期间,给予执行器更少的算力(例如 4k token 而不是 10k token),以防止执行器通过漫无目的的长思考来“拯救”一个糟糕的大纲。这种人为限制预算的做法,反而让规划器获得了更精准的奖励信号和信用分配。 实证表明了巨大的效率提升:在数学推理任务上(Qwen3-1.7B/4B),PTTS-RL 的 pass@32 性能超过了重复采样的 pass@64,相当于用一半的计算资源实现了更好的性能。 揭示了跨规模的规划器可迁移性:用 1.7B 执行器训练出来的 1.7B 小型规划器,在推理时可以直接用来指导 4B 的大型执行器,且无需重新训练,其效果与 4B 规划器相当。 证明了 PTTS 不仅仅是增加了随机的多样性,而是特别增加了“有效多样性”(即在所有回答正确的解决方案中,不同推理路径的多样性)。
主旨: 解决大型语言模型在复杂推理任务中,传统的“重复采样”(Repeated Sampling)测试时扩展方法容易产生冗余尝试和模式崩溃的问题。论文旨在通过显式地协调多个并行推理分支,提升模型在固定计算预算下的探索覆盖率和最终求解准确率(pass@k)。
创新:
联合策略分解:将难以直接建模的 个解的联合分布,巧妙地分解为“规划器(生成 个大纲)+ 执行器(依据大纲生成具体解)”的架构。 单次自回归多大纲生成:在 PTTS-ZS 中,不依赖复杂的多阶段提示或聚类,而是让基础模型在一次前向推理中直接生成包含 个大纲的 Markdown 列表。 截断执行训练法(Truncated Execution):在通过 RL 训练规划器时,刻意限制执行器的最大输出长度。这一反直觉的设计有效防止了执行器偏离大纲“自我纠错”而导致的奖励信号失真。
贡献:
理论贡献:从数学上严格证明了针对 pass@1 的优化(如传统 RL)会导致模式崩溃,而针对 pass@k 的直接优化能促使模型主动覆盖互补的非主导推理路径。 方法贡献:提出了 PTTS-ZS 和 PTTS-RL 两种实用的测试时扩展框架,为协调并行推理分支提供了完整、可端到端优化的范式。 实证贡献:在多个高难度数学基准测试(如 AIME, MATH-500)上,用较小的模型(Qwen3 1.7B/4B)实现了显著的 pass@k 提升,并证明了“小规划器+大执行器”的高效组合模式。
提升:
准确率(Effectiveness):在 Qwen3-1.7B 模型上,PTTS-RL 相比重复采样在 pass@64 指标上最高提升了 13.4 个百分点;在 4B 模型上最高提升了 6.7 个百分点。 计算效率(Efficiency):PTTS-RL 仅需一半的采样预算()即可超越基线方法满预算()的性能,计算效率提升超过 2 倍。 有效多样性:显著增加了能够推导出正确答案的推理路径的多样性,证明了模型确实在进行高质量的探索而非随机发散。
不足:
分支因子灵活性受限:目前训练时采用固定的分支因子(),在面对需要极大 值扩展的场景时,只能通过多次重复调用 PTTS 程序来实现,缺乏动态适应不同 值的内生能力。 执行器对大纲的忠诚度问题(Drift):尽管使用了截断执行,但推理模型并未专门针对“遵循大纲”进行训练,当执行时间变长时,执行器仍可能偏离(Drift)大纲改用其他策略。 任务领域的局限性:目前的实证评估完全集中在数学推理数据集上,该方法在代码生成、开放式逻辑推理等其他领域的泛化能力尚待验证。
心得:
优化目标的悖论——局部最优不等于全局最优:论文在理论上证明了极其深刻的一点:为了提升模型单次回答的成功率(pass@1)所做的RL训练,实际上正在摧毁模型并发扩展(pass@k)的潜力。这提醒我们,在设计多Agent系统或高并发推理系统时,绝不能仅仅把单一最优策略复制 份,而必须从一开始就将“多样性”和“资源分配”纳入联合优化目标中。 人为的“能力限制”反而能带来更好的系统协同(截断执行):在 RL 训练规划器时,研究者发现如果不限制下层执行器的思考长度,下层就会通过漫长的试错掩盖上层规划的愚蠢,导致上层学不到东西。这个启发非常普适:在任何层级架构(如大模型系统、企业管理)中,为了评估和训练高层(规划者)的能力,必须对基层(执行者)的过度补救能力进行硬性约束,才能倒逼高层产出高质量的指令。 “小脑指挥大脑”的测试时扩展新范式:实验发现,1.7B的规划器可以完美指导4B的执行器。这意味着在未来的RAG或复杂推理系统中,我们不需要用极其昂贵的最大模型去发散思维,完全可以训练一个微型但极具多样性的“导演”模型,去指导一个庞大但死板的“打工人”模型执行。这为大幅降低推理成本提供了一条极具商业价值的新路径。
一句话总结:
本文提出了一种规划器-执行器架构的“计划性测试时扩展(PTTS)”框架,通过反直觉的“截断执行”RL训练打破了传统重复采样导致的任务模式崩溃,在数学上证明并在实证中实现了用一半的计算资源超越基线的卓越推理表现,揭示了“小规划模型指导大执行模型”的新型算力缩放法则。
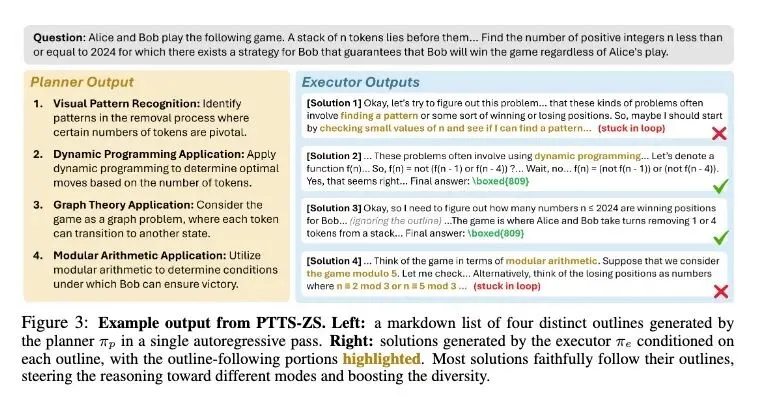
Test-time scaling with parallel branches is widely adopted to improve performance on challenging reasoning tasks. The predominant approach, repeated sampling, draws branches independently from a single policy, which can produce redundant attempts and thereby limit the gains from additional inference compute. To address this limitation, we propose Planned Test-Time Scaling (PTTS), which replaces independent sampling with a coordinated joint policy: a planner generates a solution outline for each branch, steering the branches toward distinct reasoning paths, and an executor produces a full solution conditioned on each outline. Formally, we show that PTTS strictly generalizes repeated sampling and, in a stylized setting, provably promotes coverage of complementary reasoning modes and yields better pass@k scaling. We instantiate PTTS on top of strong reasoning models, keeping them fixed as executors while replacing repeated sampling with PTTS inference to further enhance test-time scaling. Concretely, we develop two variants: PTTS-ZS prompts a model to jointly generate outlines for all branches in a single autoregressive pass, while PTTS-RL directly optimizes the planner against the pass@k reward using truncated execution rollouts for efficient training and a sharper reward signal. Across five mathematical reasoning benchmarks with Qwen3-1.7B and 4B, PTTS-ZS improves pass@64 over repeated sampling by up to 6.7 points, while PTTS-RL further increases the gain to up to 13.4 points. Further analysis indicates that broader coverage of distinct reasoning paths contributes to these gains. Overall, PTTS provides a general framework for improving test-time scaling by coordinating reasoning branches, with zero-shot and trainable instantiations that yield substantial performance gains. Figure 1: Left: overview of planned test-time scaling (PTTS). Unlike repeated sampling (RS) that draws k independent solutions from a frozen executor and often repeats the same errors, PTTS uses a planner to generate k diverse outlines and guide the executor, where the planner can be further trained via reinforcement learning to directly optimize pass@k. Right: PTTS performance with Qwen3-1.7B on AIME-2024–2026. PTTS matches the pass@64 of RS with 67% less computation (efficiency) and exceeds it by +8.8 points at k=64 (effectiveness).
https://arxiv.org/abs/2609.27374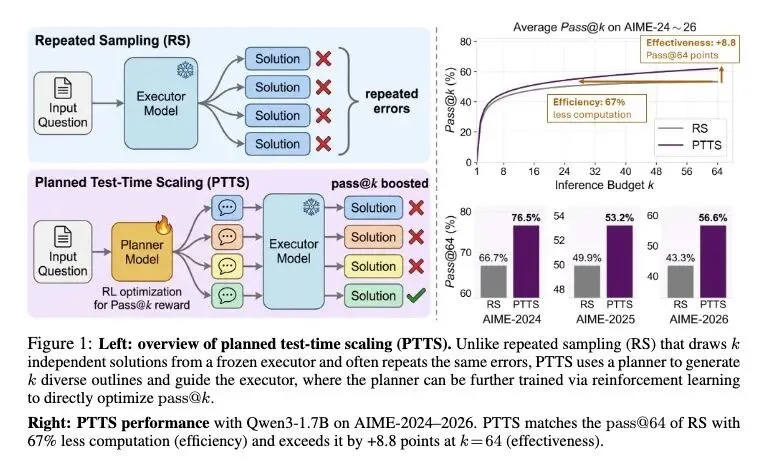
5、[LG] WTF?! Simulation-Free Reinforcement Learning with Wasserstein-Tilted Flow Maps
A Mammadov, J Y. Huang, J Lin, P Kaushik…
[University of Oxford & CMU]
基于瓦瑟斯坦偏置流映射的无模拟强化学习
要点:
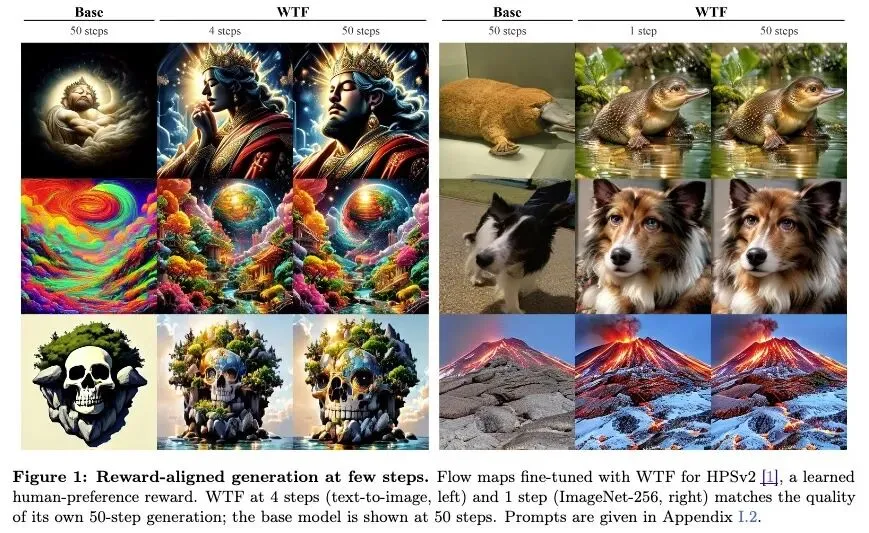
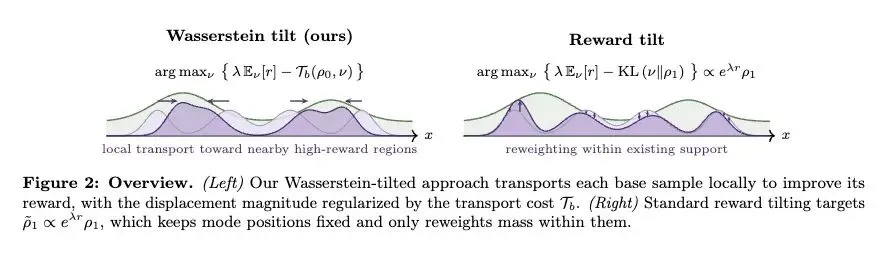
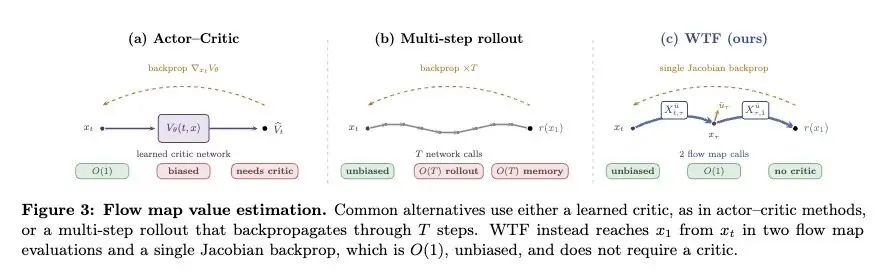
挑战了生成模型强化学习中主流的KL正则化“奖励倾斜”公式。现有方法为了利用Girsanov定理计算路径KL散度,不得不将确定性流转换为扩散模型,这导致必须进行极其昂贵的多步数值模拟(Rollouts)。 引入了Wasserstein倾斜流映射(WTF),直接基于预训练的确定性漂移构建最优传输(OT)正则化器,完全避开了KL散度和扩散模型。 关于分布偏移的反直觉见解:KL奖励倾斜仅仅是在基础分布内对现有的概率质量进行重加权(它无法在奖励相同的点之间移动质量)。相反,WTF主动将单个样本局部传输到更高奖励的区域。当高奖励区域在基础分布中密度极低时,WTF能获得显著更高的奖励。 将微调重构为确定性最优控制问题,在数学上证明了WTF是随机最优控制算法(如薛定谔桥)在重新缩放后的小噪声极限。 实现无模拟(Simulation-Free)和无Critic的价值估计:传统的RL需要 步的ODE/SDE积分模拟和一个额外的Critic网络,而WTF利用预训练流映射的“跨步跳跃”特性,只需 次网络评估即可进行无偏的价值梯度估计。 极其惊人的计算效率:在文本到图像任务中,WTF达到基线模型峰值奖励所需的算力,比零阶方法(Flow-GRPO)少 280倍,比一阶方法(Adjoint Matching)少 47倍。 流映射原生的端到端微调:算法输出直接是一个微调后的流映射,保留了少步(甚至1步)高质量推理的能力,消除了以往速度场微调方法所必需的后置蒸馏步骤。
主旨: 本文旨在解决基于流的生成模型(Flow-based Generative Models)在进行奖励微调(Reward Fine-tuning,即对齐人类偏好或特定目标)时,现有方法计算成本高昂且依赖于多步扩散模拟的问题。文章提出了一种基于最优传输(Wasserstein距离)的新框架,使流映射(Flow Maps)能够以极其高效的、无需模拟全过程的方式直接进行端到端的奖励微调。
创新:
摒弃KL散度,采用最优传输正则化:不再像传统RLHF那样用KL散度限制模型偏离,而是创新性地使用基于预训练流漂移(Drift)构建的Wasserstein最优传输成本。 确定性最优控制视角的引入:将生成模型的微调转化为确定性最优控制问题,证明了这比随机控制(扩散模型)更适合确定性流。 基于流映射的价值估计:极其巧妙地利用了流映射 能够直接跨越时间步的特性,用蒙特卡洛积分代替了昂贵的完整轨迹ODE/SDE求解,实现了无需模拟环境(Simulation-Free)且无需Critic网络的价值梯度反向传播。
贡献:
理论贡献:证明了Wasserstein倾斜目标在粒子层面等价于局部最优传输,并且从数学上推导出它是传统薛定谔桥(Schrödinger-bridge)控制问题的小噪声极限。 算法贡献:提出了首个专为流映射(Flow Maps)设计的端到端RL微调算法WTF(Wasserstein-Tilted Flow Maps)。 实践贡献:在ImageNet-256和百亿参数级文本生图(TiM-T2I)任务中,证明了WTF在保持甚至超越SOTA奖励对齐效果的同时,将计算成本锐减了1到2个数量级(最高280倍),且微调后的模型无需再次蒸馏即可支持少步推理。
提升:
训练效率实现数量级飞跃:在Text-to-Image任务中,仅需极少的GPU算力即可达到传统方法(Adjoint Matching, Flow-GRPO)的峰值奖励,计算量减少47倍至280倍。 奖励上限与样本分布的优化:由于采用传输(Transport)而非重加权(Reweighting),模型能到达KL散度根本无法触及的终端分布状态,HPSv2、PickScore等奖励指标显著提升。 部署便捷性:微调后产出的是一个多时间步兼容的流映射,同一套权重直接支持1步到50步的推理,无需为了加速推理而进行二次蒸馏。
不足:
前置依赖:WTF方法假设已经存在一个预训练好的“流映射(Flow Map)”。如果只有基础的速度场模型(Velocity Model),则必须先花费算力进行流映射蒸馏,文章的计算成本对比未将这一前置成本计算在内。 奖励与多样性的权衡(Alignment Tax):尽管方法高效,但随着奖励缩放系数 的增加,生成样本的多样性(如DreamSim和CLIP Diversity指标)依然会不可避免地下降。 大尺度任务上的理论妥协:在高分辨率图像实验中,为了防止反向传播穿过复杂的流映射雅可比矩阵,作者使用了一个简化的“欧几里得奖励梯度(Euclidean reward gradient)”,这使得算法偏离了最严格的精确数学推导。
心得:
正则化方式决定了能力的上限(Reweighting vs. Transport):这是本文最反直觉也最深刻的启发。我们长久以来习惯了在RLHF中使用KL散度作为惩罚项,但KL散度的本质是“重加权”,它只能在基础模型已经生成的概率质量上做文章。如果在高奖励区基础模型的概率是0,KL倾斜永远无法到达那里。而最优传输(Wasserstein)是“搬运”,它赋予了模型打破原有分布拓扑、将概率质量主动推向高奖励区的能力。在对齐研究中,重新审视正则化距离度量具有巨大的潜力。 架构特性与RL算法的完美融合(利用Flow Maps跳步):在强化学习中,环境的Rollout(轨迹展开)一直是最大的算力瓶颈。本文最巧妙的一点是将“生成模型的演化过程”看作环境,并利用了Flow Maps能够“一步跨越到任意时间点”的架构特性,直接消灭了需要一步步积分的Rollout过程。这启发我们,下一代高效RL算法可能不是诞生在RL理论本身,而是诞生在被控系统的底层架构创新(如一致性模型、流映射)中。 跳出扩散模型的“随机控制”执念:之前学术界为了让微调在数学上可解,强行将确定性流(Flows)加上噪声变成扩散模型(Diffusions),仅仅是为了能套用Girsanov定理来计算KL散度。本文作者果断抛弃了KL散度,从而彻底摆脱了扩散模型的随机控制框架,直接在确定性控制框架下用极简的公式实现了目标。这提醒研究者:如果为了解决一个数学工具的限制而把系统搞得异常复杂,也许我们真正该做的是换一把数学工具。
一句话总结: 本文提出了一种基于最优传输的流映射奖励微调框架(WTF),通过将生成过程的微调重构为确定性最优控制问题,巧妙利用流映射的跨步特性实现了无需模拟(Simulation-Free)和无Critic的高效价值估计,在保持少步生成能力的同时,将对齐生成模型的计算成本惊人地降低了数个数量级(最高达280倍)。
Reward fine-tuning aims to update a pre-trained flow-based generative model to improve the downstream reward of its generated samples. Existing methods typically formulate this problem as sampling from a reward-tilted distribution, the solution to a KL-regularized reward-maximization problem. Here, we introduce an optimal transport regularizer built directly from the pre-trained drift. Unlike KL reward tilting, the resulting objective transports individual samples toward higher reward rather than reweighting the base distribution. We show that the resulting problem is equivalent to a deterministic optimal control problem on the flow. Given a pre-trained flow map, this equivalence yields a simulation-free reinforcement learning algorithm for fine-tuning generative flows. We call the resulting framework Wasserstein-Tilted Flow Maps (WTF), the first end-to-end fine-tuning recipe native to flow maps. The output is a fine-tuned flow map that retains strong reward-aligned performance at few-step inference budgets without post-hoc distillation. Experiments on ImageNet-256 and text-to-image show that WTF achieves higher reward with comparable or higher diversity than baselines, while requiring up to 280×280\times less training compute. More broadly, we argue that accelerated samplers such as flow maps are essential infrastructure for efficient post-training, and that the dominant KL-regularized formulation is only one of many choices worth revisiting.
https://arxiv.org/abs/2609.27033