ARTICLE · 1088014
世界模型:让 AI 在“脑海中”预演未来——从概念到 Nano World Model
从感知、预测到规划:理解世界模型如何成为物理 AI 的关键底座
导语:大语言模型擅长理解和生成文字,图像与视频模型擅长“画出”世界;而世界模型更进一步——它试图学习世界如何随时间变化,以及一个动作会带来什么后果。它不是一台只会回放画面的机器,而是一个可用于预测、反事实推演和规划的内部模拟器。本文先解释世界模型的核心概念,再以开源项目 Nano World Model(NanoWM)为例,看看一个尽量精简、可复现的视频世界模型怎样训练、评估并用于决策。
一、世界模型是什么?
按照 NVIDIA 的定义,世界模型是一类理解现实世界动态的 AI 工具:它接收文本、图像、视频、声音、运动或传感器数据,学习其中的空间关系、时间演化与物理规律,并预测“接下来可能发生什么”。更通俗地说,人看到杯子靠近桌边,会在真正伸手之前预判它可能掉落;世界模型希望赋予机器类似的内部预演能力。
这里的“世界”不一定指整个真实宇宙,也可以是一个游戏关卡、一条自动驾驶道路、一个机器人工作台,甚至是一段树脂在纤维预制体中流动的制造过程。模型只要能压缩当前状态、学习状态转移,并在给定动作后预测未来,就具备了世界模型的基本形态。
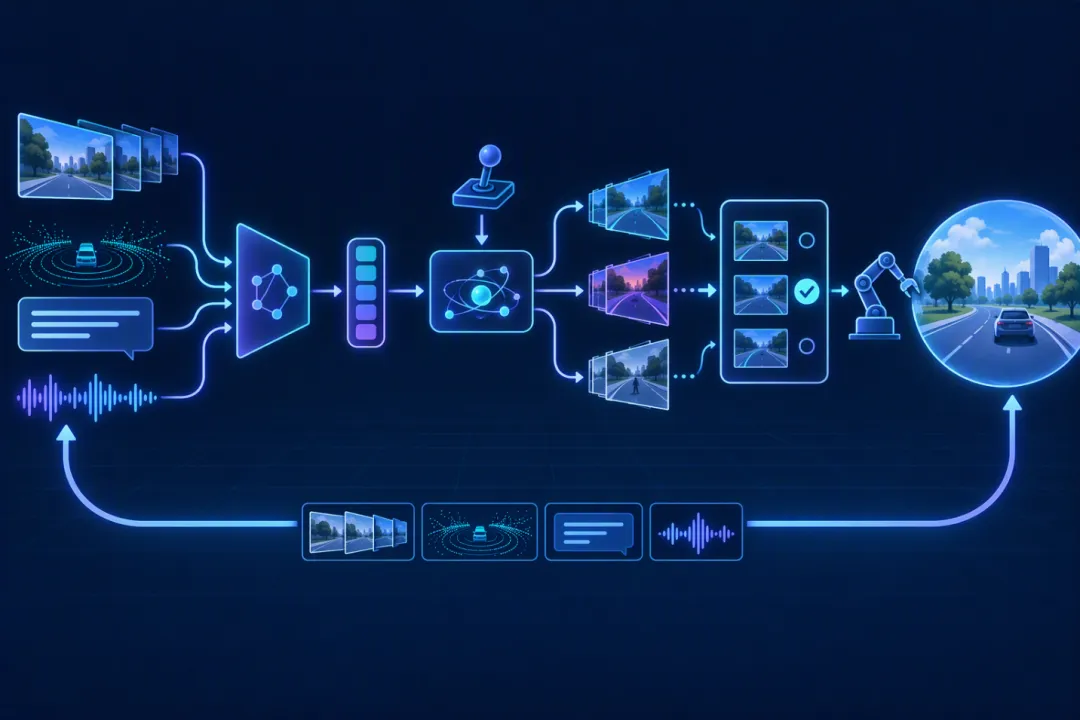
图 1 世界模型的基本闭环:观察环境、形成内部状态、想象多种未来、选择动作,再用真实反馈修正模型。
1. 从“生成内容”到“预测后果”
普通视频生成更关心画面是否逼真,世界模型则更关心变化是否可信、动作是否真正影响结果,以及预测能否支持决策。大语言模型主要在符号空间预测下一个 token;传统数值仿真依据显式方程计算状态;世界模型则从数据中学习一个近似的动态系统。三者可以互补:语言模型负责理解任务,物理仿真提供高可信规律,世界模型负责快速预演大量候选未来。
2. 一个世界模型通常包含什么?
·表征模型:把高维图像、视频和传感器信号压缩成紧凑的潜在状态,保留与任务有关的信息。
·动态模型:学习“当前状态 + 动作 → 下一状态”的变化规律,并处理时间依赖与不确定性。
·生成或解码模块:把预测的潜在状态还原成画面、深度、点云或其他可观察结果。
·奖励或目标模型:衡量某一未来是否更接近任务目标。
·规划器或策略:比较多条候选动作序列,在内部模拟后选择更优方案。
3. 它为什么重要?
如果模型能够在内部快速预演,机器人就可以在执行前比较不同抓取路径,自动驾驶系统可以评估不同操控的后果,游戏智能体可以通过“想象”学习策略,工程系统也可以用低成本代理模型探索大量工况。与每次都调用高成本真实试验或高保真仿真相比,世界模型有机会显著提高数据效率和决策速度。
但“看起来真实”不等于“物理上正确”。世界模型可能在长时序滚动时累积误差,也可能忽视罕见碰撞、接触、材料失效等关键事件。因此,它更适合与不确定性评估、真实反馈、规则约束和高保真仿真结合,而不是简单取代物理模型。
二、Nano World Model:把视频世界模型做成可研究的“最小系统”
Nano World Model(NanoWM)由 Max Simchowitz 实验室开源,目标不是用最大模型刷新单一榜单,而是提供一个代码精简、配置统一、容易复现和修改的研究平台。它采用 MIT 许可证,并公开训练配置与检查点。其定位很像世界模型领域的 nanoGPT:研究者可以用同一套框架逐项比较预测目标、动作注入方式和模型规模,而不必先理解一个庞大的工业代码库。
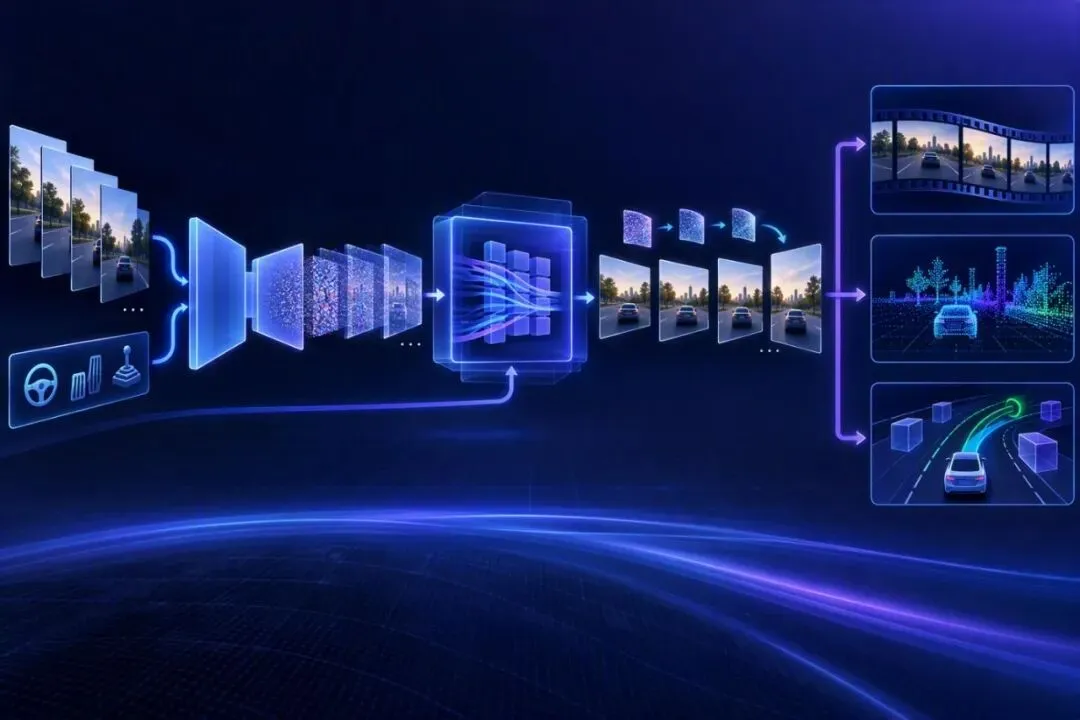
图 2 NanoWM 的概念流程:视频与动作进入潜空间,不同帧接受不同噪声强度,再由时空模型逐步去噪并生成未来。
1. 输入、压缩与预测
训练时,视频片段先由 VAE 编码到潜空间,降低空间分辨率与计算量;每个时间步的潜变量再加入噪声,并与动作嵌入一起送入 Transformer 主干。模型学习预测速度参数 v、原始样本 x、噪声 ε 或 flow。优化器采用 AdamW,基准学习率为 1e-4,并配合 warmup 与 cosine 衰减。
2. 核心方法:Diffusion Forcing
传统视频扩散常给整段视频设置同一种噪声强度;Diffusion Forcing 则允许每一帧独立采样噪声水平。训练时,过去帧可以接近干净,未来帧可以接近纯噪声,模型因而学会在“部分已知、部分未知”的时序条件下恢复未来。这让同一个模型兼具两种能力:像自回归模型一样沿时间向前滚动,又像扩散模型一样通过多步去噪生成更清晰、更具多样性的画面。
推理阶段采用顺序调度:模型固定已知历史帧,逐步去噪下一帧,再把新生成的帧加入上下文继续向前。README 中的默认设置为 250 步 DDIM。模型命名沿用 DiT 风格,例如 S/2、B/2、L/2 分别对应不同容量,数字 2 表示 patch 大小。
三、NanoWM 的三组关键实验
实验维度 | 对比设置 | 主要结论 |
预测目标 | ε / v / x / flow | v、x、flow 整体优于 ε;flow 的 FID、PSNR 更好,x 的 SSIM、LPIPS 更好。默认选择 v,并结合 cosine 调度与 ZTSNR。 |
动作注入 | additive / adaLN / adaLN-fuse / FiLM / cross-attention | 最简单的 additive 几乎不增加参数,与复杂方法表现接近;FiLM 在 RT-1 的 FID 略好,cross-attention 在该模型规模下表现最弱。 |
模型规模 | S/2 约 40M;B/2 约 159M;L/2 约 460M | 四项指标随规模增大而持续改善,到 460M 仍未明显饱和;默认配置采用 B/2。 |
这些结果传递出一个非常实用的信息:在 NanoWM 所研究的规模上,预测目标和模型容量比复杂的动作注入结构更值得优先投入。对于希望复现实验或搭建自己的工程原型的人,这意味着可以先采用简单、稳定的动作融合方式,将计算预算留给更合适的训练目标与模型规模。
四、从简单环境到真实机器人:它能做到什么?
NanoWM 覆盖三类任务:来自 DINO-WM 的 Point Maze、Wall、PushT、Rope、Granular 等控制环境;CSGO 游戏视频;以及 RT-1 真实机器人数据。简单环境的 PSNR 大约在 26 到 37 之间,RT-1 约为 24.4。总体规律很直观:结构越简单、动力学越稳定,未来越容易预测;绳索、颗粒等可变形对象以及真实机器人场景中的光照、遮挡和多样运动,会显著增加难度。
·长时序视频生成:把刚生成的帧继续作为历史条件,滚动预测更长序列。
·视频转三维:将预测视频交给深度估计模型,重建场景点云,形成从二维未来到三维空间的桥梁。
·MPC 规划:用 CEM 等方法采样多组候选动作,让世界模型分别“想象”其结果,再选出得分最高的动作序列执行。
五、与传统 VAE + GRU 世界模型相比
维度 | VAE + GRU 路线 | NanoWM |
未来预测 | 直接预测下一步潜变量,通常较确定 | 通过扩散逐步生成下一帧,可表达多种可能未来 |
时序主干 | RNN / GRU | 时空 Transformer |
视觉质量 | 速度快,但长时序容易模糊 | 画面更清晰,但多步去噪成本更高 |
典型用途 | 在潜在“梦境”中训练策略 | 视频预测、MPC 规划和三维重建 |
六、如何上手 NanoWM?
1.先复现推理:官方环境面向 Linux x86_64 与 CUDA。Windows 用户可优先使用 WSL2、Linux 服务器或官方 Colab notebook,下载 Point Maze 检查点观察历史帧、动作与预测帧。
2.再读训练配置:从数据张量形状、VAE 编码、逐帧噪声采样、动作嵌入、损失目标和采样调度六条主线理解代码。
3.最后做小规模消融:先选择 Point Maze 或 PushT,使用 S/2 或 B/2,固定其他条件,只比较一种预测目标或动作注入方式。
结语:世界模型的关键,不是生成视频,而是支撑行动
世界模型真正令人期待的地方,是它把感知、预测和决策连接起来:机器不再只回答“眼前是什么”,还能够估计“如果这样做,会发生什么”。NanoWM 的价值正是在于把这个复杂方向拆成一个足够小、足够透明的实验平台。它的实验也提醒我们,现阶段更重要的往往不是堆叠最复杂的条件注入结构,而是选择合适的预测目标、模型容量和训练调度,并用可靠评估验证长时序一致性。
参考资料
·NVIDIA Glossary:World Models
·simchowitzlabpublic / nano-world-model:README 与 docs/training.md
·Nano World Models,arXiv:2605.23993