ARTICLE · 1089254
AI 圈变天了:以后 80% 的“判断题”,根本不需要大模型
💡 核心导读:并不是所有 AI 需求都需要大模型生成长篇文本。 对于分类、判断、路由和评分,像
Laya这样的决策模型,可能更快、更便宜,也更适合被程序直接调用——但它不是开箱即用的银弹,本文也会如实告诉你它的边界。
一、从"生成文本"到"直接决策":后端工程师的新选择
设想一个后端工程师的日常:
业务方提了个需求:
"帮我把工单自动分到对应部门。"
听起来并不复杂,但传统实现路径往往是:
调用云端 大模型 API; 编写一段精心构造的 Prompt;等模型逐字生成一段自由文本; 再用正则或 JSON解析器提取结果。
一旦输出格式漂移、网络抖动或接口超时,整条业务链路就可能断掉。
这引出了三个值得认真思考的问题:
你的程序真的需要 AI 生成一大段话吗? 还是只需要一个 是不是、选哪个、打几分 的确定答案? 为了这个答案,你愿意承受秒级延迟、按 Token计费,还要防范幻觉吗?
那么今天介绍的 Laya,可能正是你缺少的那块拼图。
二、不写文章的 AI:Laya 到底是什么
Laya 是 Convai Innovations 开源的一个 System 1 决策模型,于 2026 年 9 月发布。
不经过深度推理,凭借模式识别,直接给出判断。
它的核心特征可以概括为:
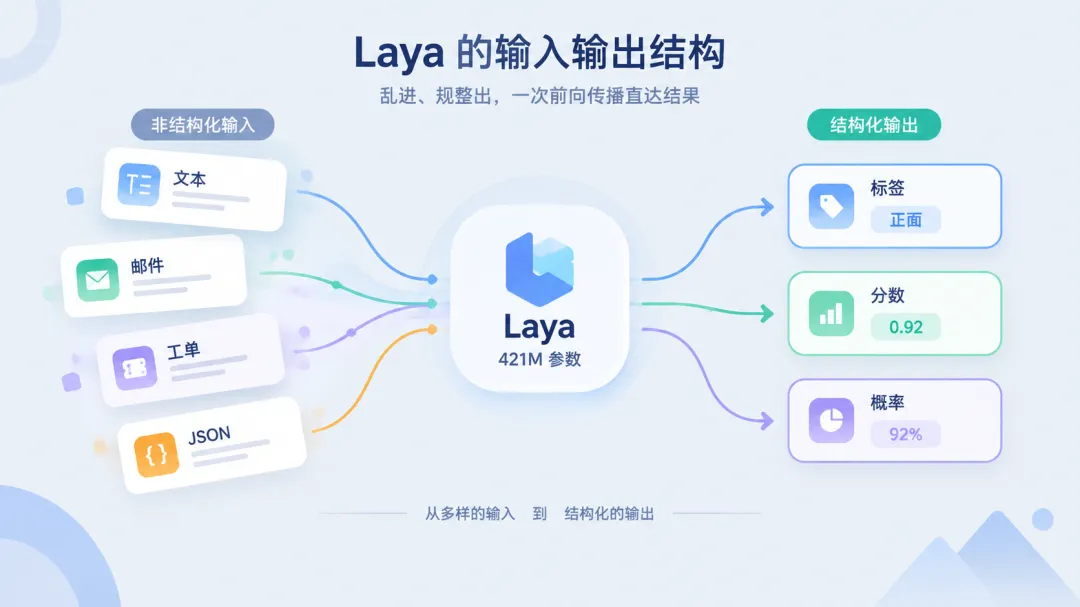
输入非结构化数据,经过 一次前向传播 直接输出结构化判断和概率。
输入可以是:
文本 邮件 工单 JSON
输出则不再是自由文本,而是 标签、分数 和 概率。
这意味着它不需要逐字生成,也不依赖复杂的 Prompt 工程。
Laya 的技术规格
参数量:421M 推理延迟:约 33ms 开源协议: Apache 2.0
更本质的问题在于:
大模型时代,行业关注的是"AI 能不能回答问题";
而当
Agent真正落地后,瓶颈变成了"AI 能不能足够快、足够便宜,并且让程序敢于直接调用"。
打个比方:
过去,我们让一个博士既当门卫、又当秘书、又当专家。
现在,可以把工作拆开:
简单判断交给便宜、快速的小模型; 真正需要深度思考的任务,再交给大模型。
还有一个工程层面的天然优势:
由于输出空间被严格限定为概率和数字,不存在自由文本,也就不存在 JSON 解析失败的可能。
💡 知识延伸
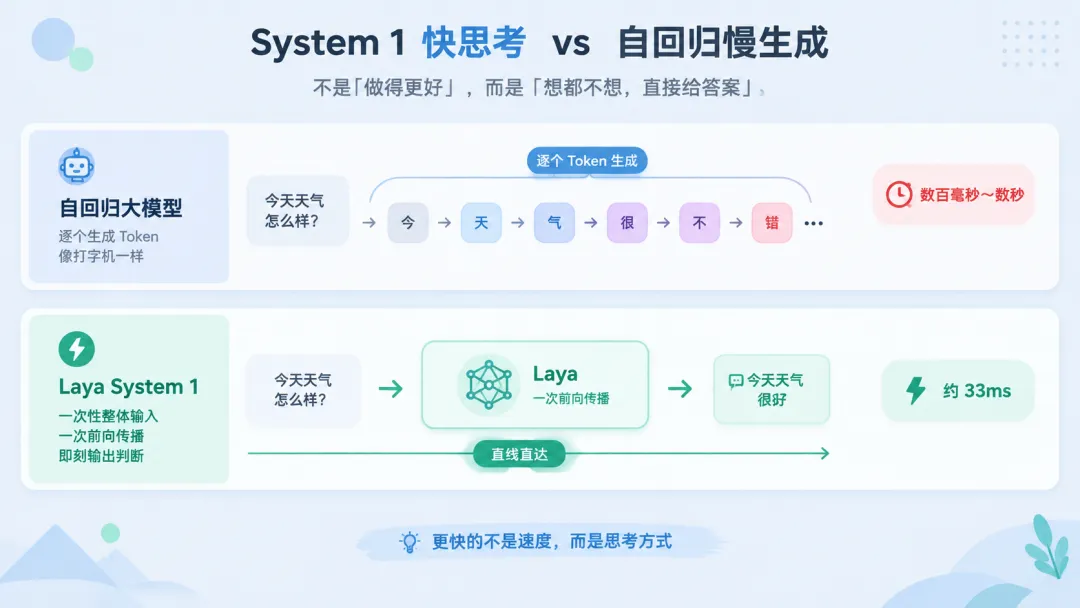
传统大模型通常采用自回归方式逐个生成 Token。
而 Laya 通过一次前向传播,直接完成决策输出。
这也是它能够降低延迟、限制输出空间,并提升工程确定性的关键原因。
三、选择、评分、判断:三种原语覆盖大多数"判断题"
要理解 Laya 与传统大模型的区别,可以先看下面这张对照表:
GPT / Claude) | Laya | |
|---|---|---|
Token | ||
Laya 提供三种决策原语,覆盖绝大多数结构化判断场景:
1️⃣ choice:选择 / 分类
从候选标签中选出最匹配的一项,并返回各选项概率及置信度。
典型场景:
这封邮件应该转给财务、技术还是销售?
输出示例:
billing (confidence: 0.94)📖 解读:模型判断这封邮件应转给财务部门,把握为 94%。
2️⃣ score:评分
在有序量表上给出连续分数。
典型场景:
这个客户请求有多紧急?
输出示例:
1.84 / 2.0📖 解读:紧急度量表满分 2 分,这条客户请求得分 1.84,属于高度紧急。
3️⃣ noul:判断 / 布尔概率
返回 P(true),取值范围为 0.0~1.0。
典型场景:
用户是否在威胁取消订阅?
输出示例:
0.892📖 解读:"用户在威胁取消订阅"成立的概率为 89.2%。
这三种原语有一个关键的工程优势:
一次前向传播,可以同时回答多个问题。
例如,一条售后工单通过一次 predict 调用,就可以同时输出:
应该转给哪个部门: choice紧急度评分: score是否需要退款: noul是否为钓鱼邮件: noul
无需四次 API 调用,也无需编写四段 Prompt。官方实测显示,批量 10 个问题摊薄后每题仅约 7.2ms。
✅ 可以直接根据置信度设置自动化门槛:
置信度 ≥ 0.85:自动执行置信度 < 0.85:转人工复核
这样,模型输出就不只是一个结果,还可以成为业务流程中的自动化决策依据。
四、Laya 的 7 个落地场景:从分类到风险判断
场景一:客服工单路由
类型: choice输入:工单文本 输出:目标部门标签 + 置信度 处理方式:低于阈值时自动转人工
场景二:垃圾邮件与钓鱼识别
类型: noul输入:邮件正文 输出:0~1 的概率值 处理方式:概率 > 0.9时直接隔离,无需人工介入
场景三:内容审核
类型: noul+score输入:用户生成内容 输出: 是否违规:布尔概率 严重等级:连续分数
场景四:模型路由——AI 分级处理
类型: choice逻辑: 简单问题路由至小模型 复杂问题路由至大模型 价值:这是控制推理成本的关键架构手段
场景五:Agent 下一步动作选择
类型: choice定位: Laya不是Agent本身,而是Agent决策层中负责"下一步干什么"的组件
流程示例:
判断数据是否完整; 判断是否存在异常; 决定调用工具,还是调用大模型生成报告。
场景六:工单优先级判断
类型: score输出:紧急度 0~3 级 处理方式:达到指定阈值时,自动通知值班经理
场景七:情绪与风险判断
类型: score+noul输出: 客户不满度评分 流失风险概率 评论情感倾向
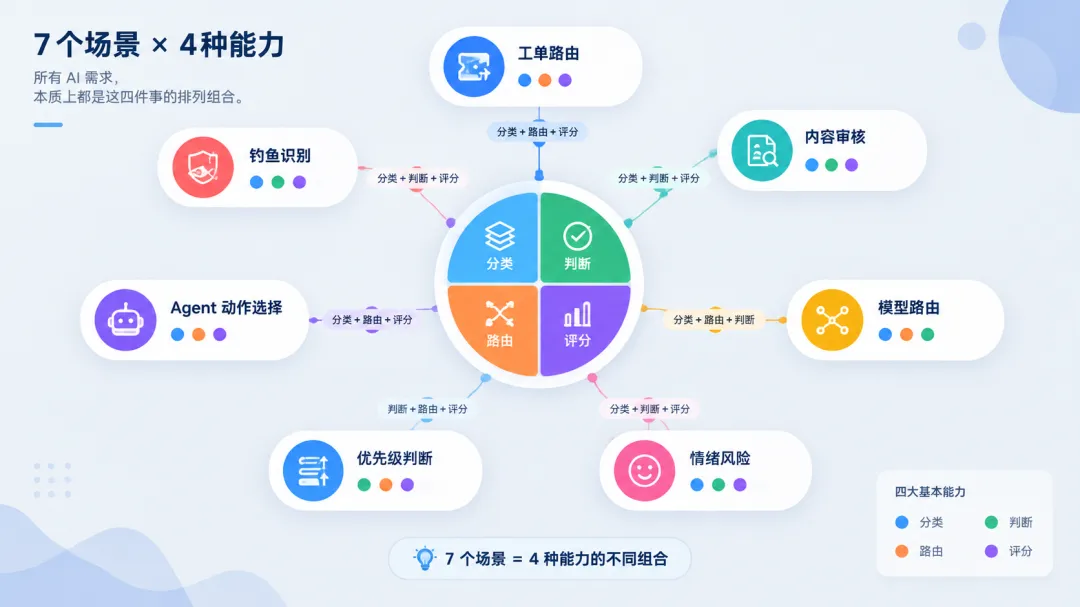
将所有场景抽象归纳,其实只有四件事:
🏷️ 分类:这是什么? ✅ 判断:是不是? 🔀 路由:交给谁? 📊 评分:有多严重?
在实际 AI 应用中,大部分
AI 需求拆开来看,都是这四件事的排列组合。
五、开源 Laya 与闭源 Jev:同一赛道的两种路线
Jev 是 TypeSafe AI 于 2026 年 9 月 15 日推出的产品,也是"System One Model"概念的早期实践者。
它验证了这条技术路线的可行性,但采用的是闭源云端 API 模式,因此可能面临:
网络延迟; 按 Token持续计费(官方定价 $0.042 / 百万输入Token,输出免费);敏感数据需要上传云端; 数据合规与主权受到部署方式限制。
Laya 则选择了完全不同的路线。
核心对比
Jev | Laya | |
|---|---|---|
Apache 2.0 | ||
p50 | ||
Token 计费 | ||
typed-decisions) | ||
ECE | ||
HIPAA / GDPR 等合规要求提供了部署前提 |
六、真正重要的不是 Laya:而是它代表的架构思路
Laya 只是一个 400 多兆参数的模型,单看技术指标,可能并不惊艳。
但它触及了 AI 落地工程中一个长期被忽视的痛点:
我们是否过度依赖大模型了?
✅ 最佳实践
可以按照任务类型进行分层:
Laya | |
让合适的模型处理合适的问题,才是构建稳定、低成本 AI 系统的关键。