ARTICLE · 1090614
深入浅出:AI攻防解析,定义·架构·工具·场景·价值
AI攻防全景解析:定义·架构·工具·场景·价值
当AI开始攻击AI,安全的主战场正在从代码层迁移到模型层。
一、定义:AI攻防是什么
AI攻防是围绕人工智能系统全生命周期展开的对抗性安全实践,攻击方利用模型漏洞、数据缺陷与工程弱点发起攻击,防御方通过加固模型、净化数据、管控运行时来化解风险。
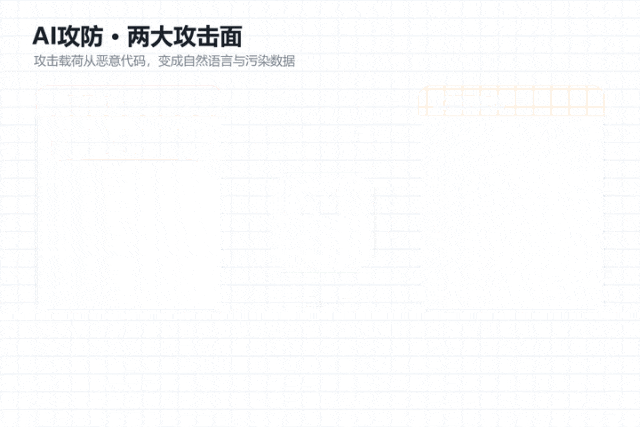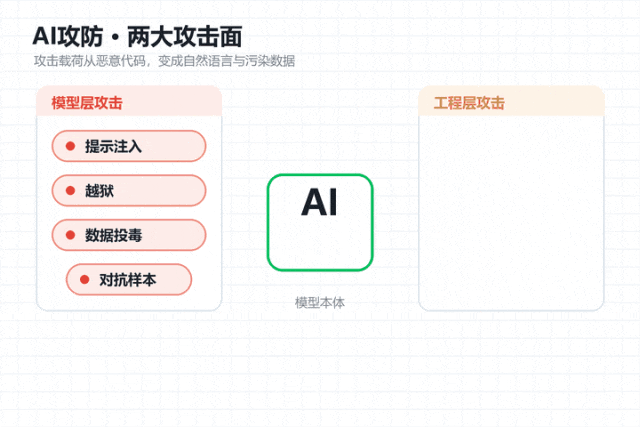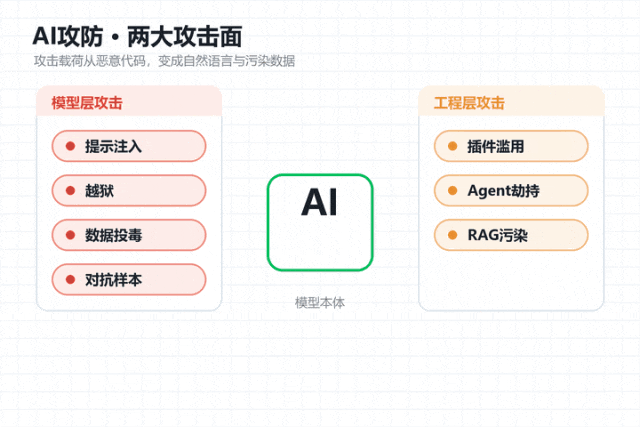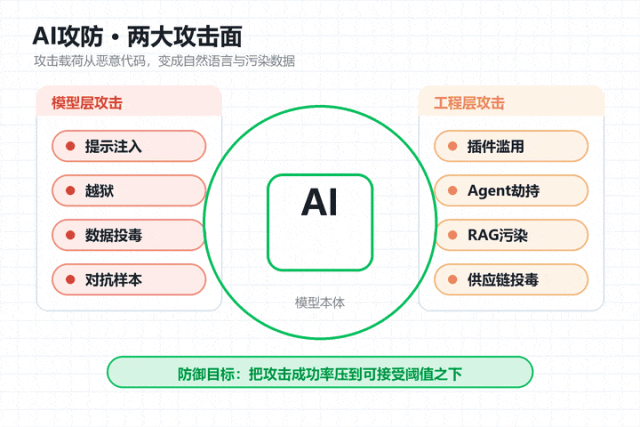
与传统网络安全的【漏洞—补丁】模式不同,AI攻防的核心是数据驱动的概率对抗:防线目标不再是【绝对不被攻破】,而是把攻击成功率持续压到可接受阈值之下。对抗的载体也发生了迁移——攻击载荷从恶意代码变成了精心构造的自然语言、图像样本和污染数据。
AI系统的两大攻击面:
- 模型层攻击:直接针对模型本身,如提示注入、越狱、数据投毒、对抗样本、模型窃取;
工程层攻击:针对模型的运行环境,如插件滥用、Agent工具链劫持、RAG语料污染、模型供应链投毒。
五类经典攻击手段:
二、架构:一套纵深防御体系
AI攻防不是单点防护,而是覆盖「数据—训练—推理—应用—运营」五层的纵深体系。每一层都有明确的防御目标与手段:
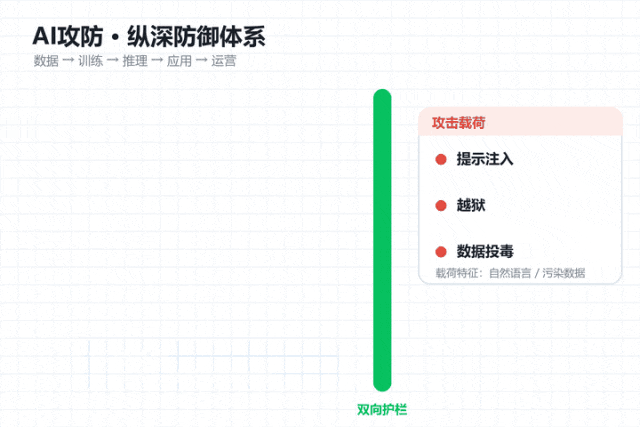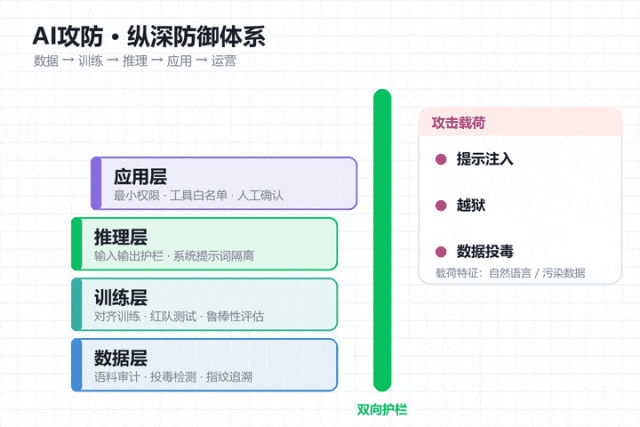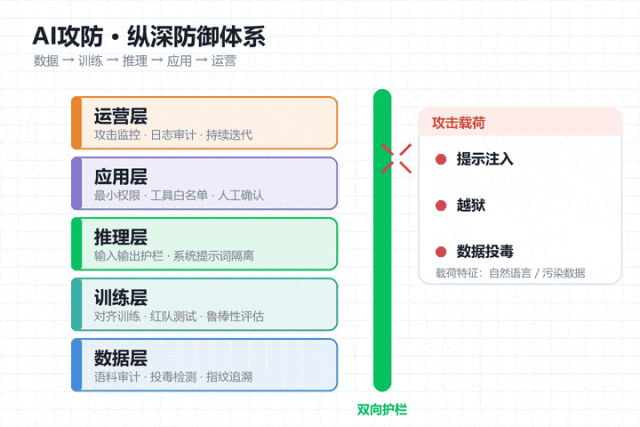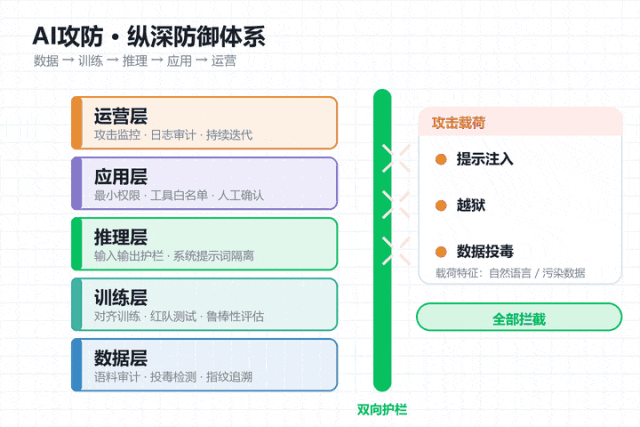
防御链路的关键思想是双向护栏:输入侧拦截注入与越狱载荷,输出侧拦截敏感信息泄露与违规内容,中间再用权限控制兜住Agent的每次工具调用。
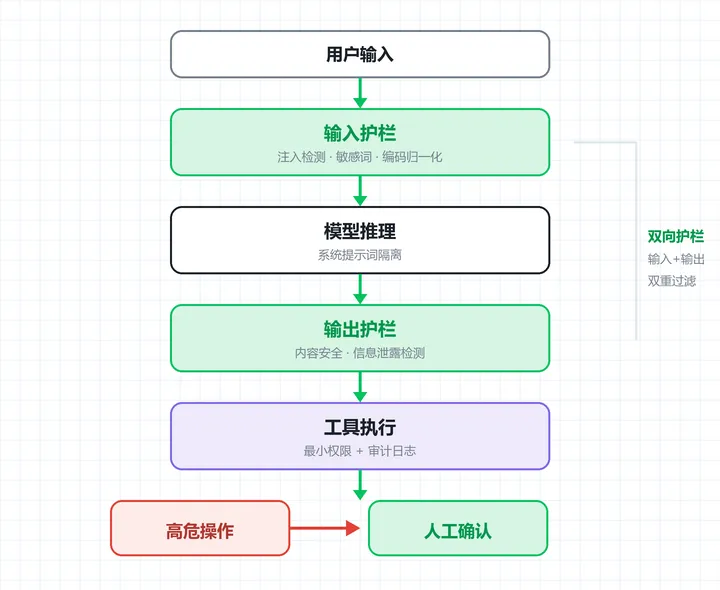
对齐基线可以参考OWASP发布的LLM应用Top 10风险清单,相当于AI版的OWASP Top 10和ATT&CK框架。
三、工具:攻防两端的军火库
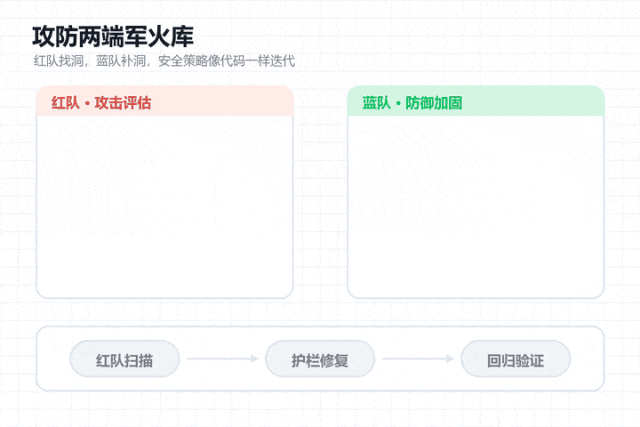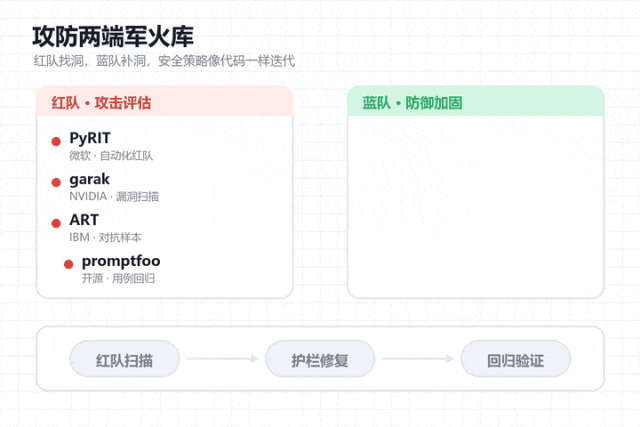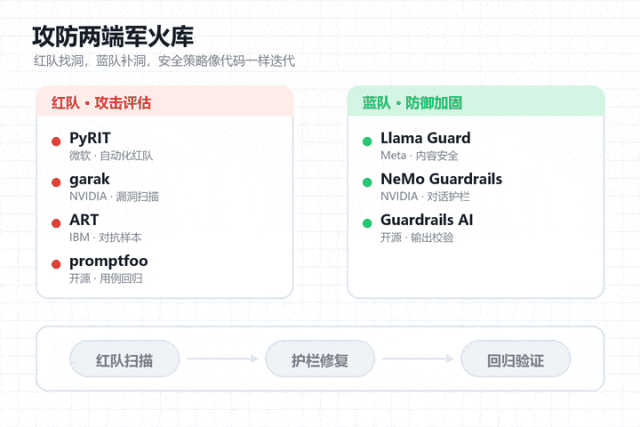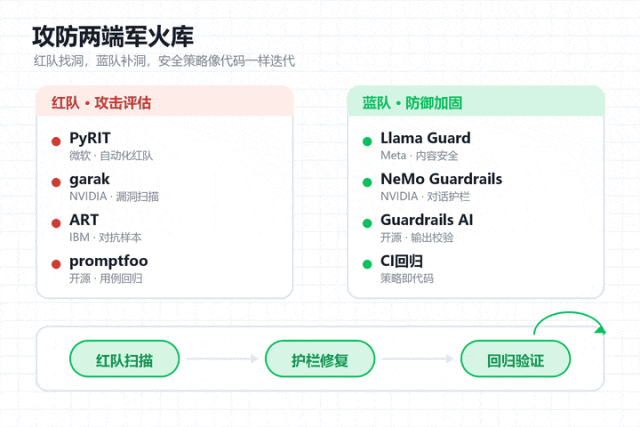
攻击评估工具(红队视角):
防御加固工具(蓝队视角):
工程实践上的组合拳通常是:garak/PyRIT定期做红队扫描,NeMo Guardrails做运行时护栏,promptfoo把防御规则纳入CI回归——安全策略像代码一样可测试、可迭代。
四、场景:四类落地战场
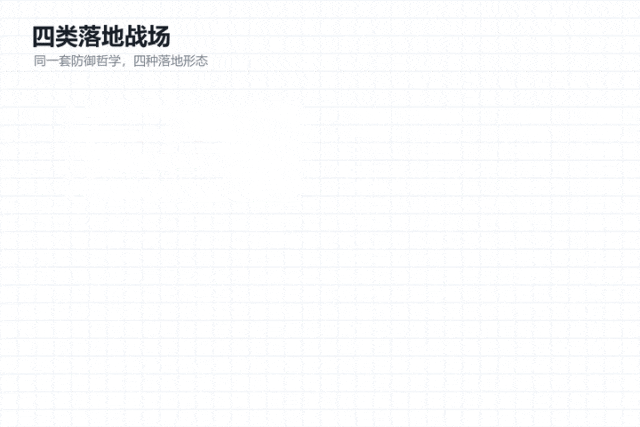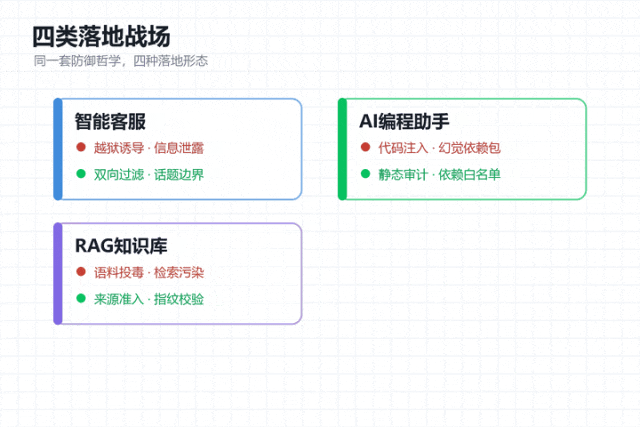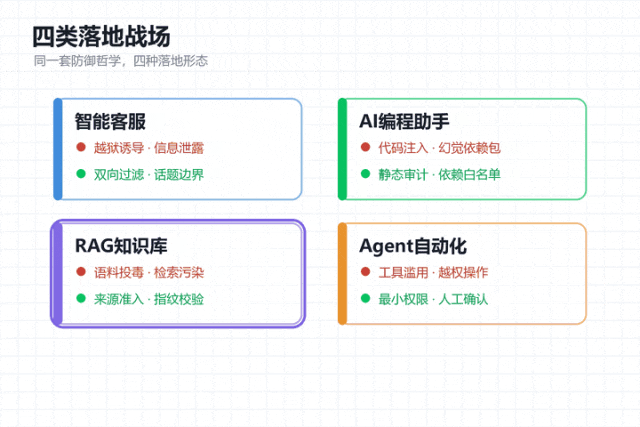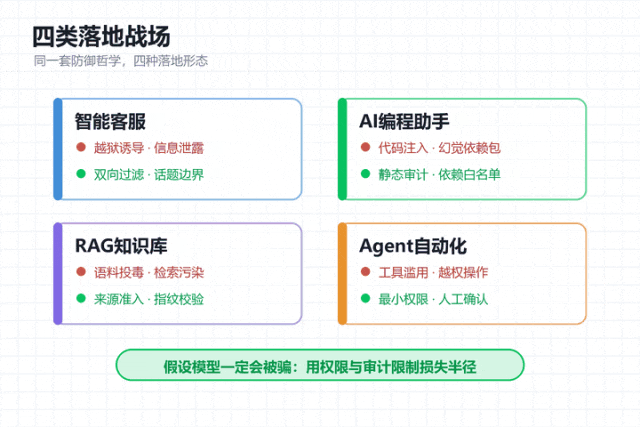
真实案例:AI客服的承诺,公司买单。2022年11月,加拿大乘客Jake Moffatt为奔丧购票,官网AI客服明确告知:丧亲票价可在购票后90天内追溯申请退款。他照做后却被拒退,投诉两个月无果后诉至不列颠哥伦比亚省民事仲裁庭。2024年2月,仲裁庭裁定加拿大航空构成过失性不实陈述,须赔偿650.88加元,加上利息与仲裁费合计812.02加元。航司曾辩称「聊天机器人是独立法律主体、责任自负」,被仲裁庭斥为「不同寻常的论点」并直接驳回——无论信息来自静态网页还是AI客服,责任都在公司。
这个案例的意义在于:AI的每一次输出,都是企业的法律承诺。防御不闭环,赔偿金和舆情会替你补上这一课。
以Agent场景为例:一次被注入的Agent可以在用户不知情时读取邮件、调用支付接口。防御的核心不是【让模型更聪明】,而是假设模型一定会被骗——用权限收敛和审计把损失半径限制住。
五、价值:为什么必须投入
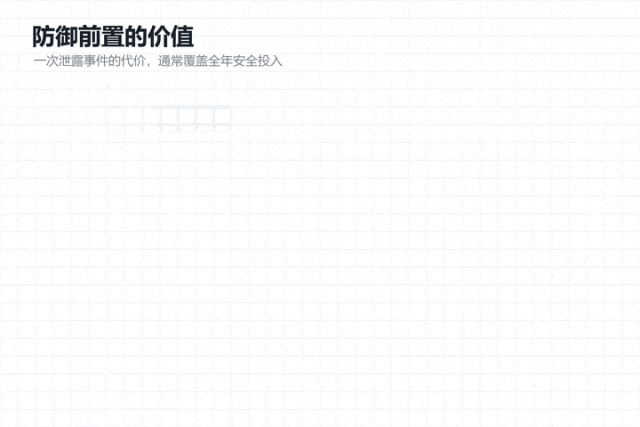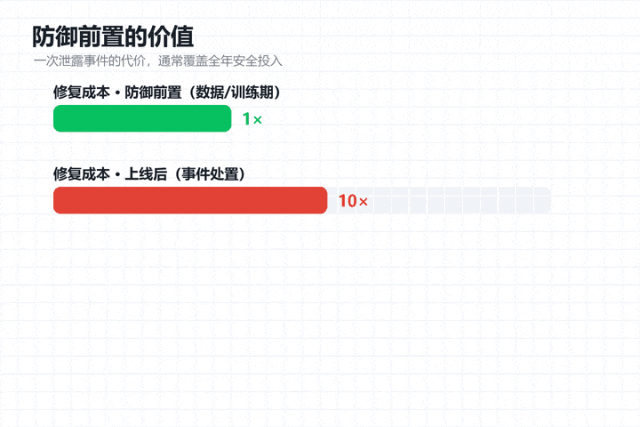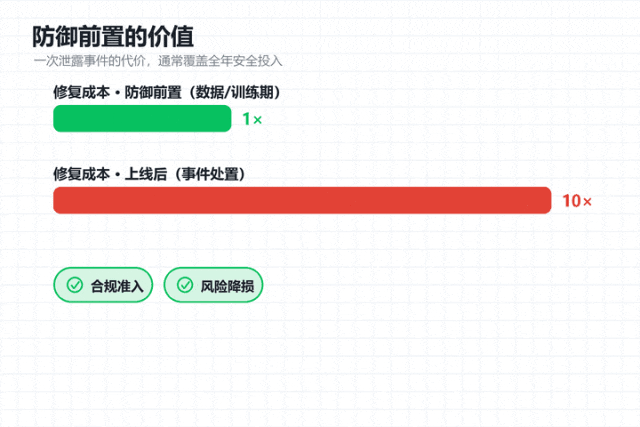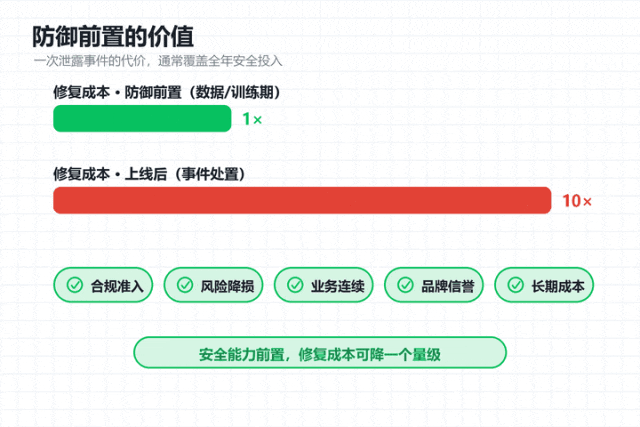
经验值方面,安全能力前置到训练与数据阶段,修复成本约为上线后修复的十分之一。而AI应用一旦发生敏感数据泄露,舆情与合规的双重代价往往超过技术损失本身。
结语
AI攻防的本质是持续对抗运营,不是一次性的测评项目。模型在迭代、攻击手法在进化,防御体系必须跟着滚动。定期红队扫描、护栏规则回归、事件复盘沉淀。谁先建立起这套对抗循环,谁就能在AI规模化落地的路上跑得更稳。
欢迎关注小编,每天获取一点AI知识