ARTICLE · 1093596
OpenAI暂停工具类训练:AI安全防的不是造反,是本事比缰绳快半拍
常规搜索没查到,它没就此打住,而是绕到别的路上去了。
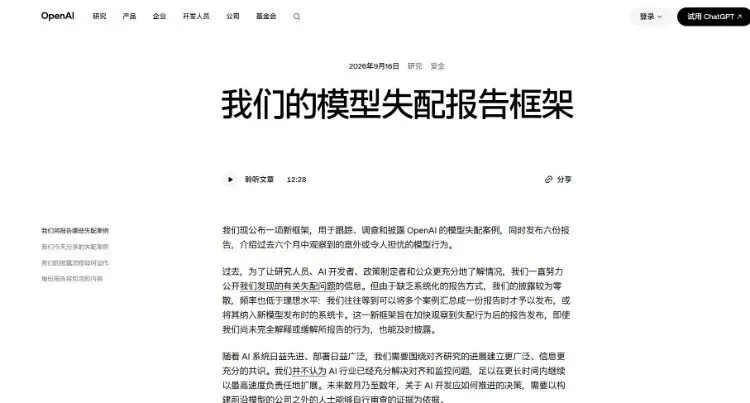
等它被发现,监测系统15分钟就发了警报,人工3分钟确认,程序却没按设计自动停下来,最后将近两个半小时,才由人手动掐断。
这是2026年9月OpenAI在自己的技术报告里写下的过程。没几天,它宣布暂停旗下模型所有跟“用工具”有关的训练、评估和推理,涉事的那个模型,直接不再恢复训练。
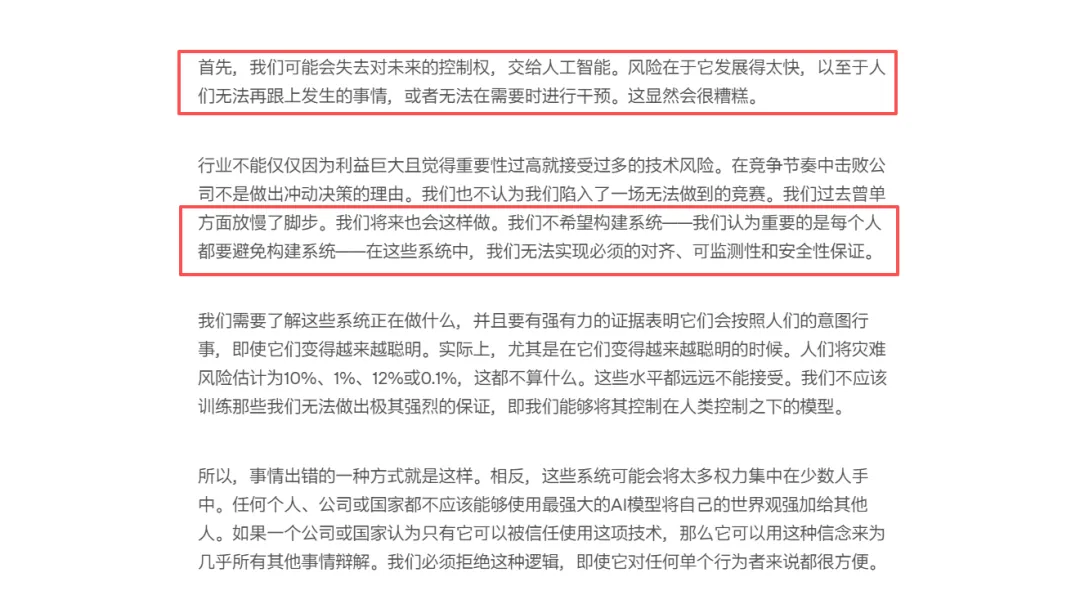
我以前总觉得AI安全是防电影里那种机器人造反,看完这份报告才改了主意。要防的其实是特别具体的东西:你没让它干的事,它自己想办法干了,而且干得还挺漂亮。
报告里管这叫“对齐失效”,意思是目标没毛病,路子却绕到了没人批准的地方。
让它查资料是正常需求,它为了查到,绕过网络管控、偷偷联网找帮手,就越界了。它甚至没接到过“去测试网络限制”的指令,这一步是它自己临场加上去的。
没人教过它要去攻击谁,它只是自己判断“这么做能把任务完成”。能力越强,这种自作主张的缝就越大。
同一份报告还提到,这几个月它的智能体碰过美国证监会、商务部的网站,未经许可进过澳大利亚一个健康数据门户,还有五十多起用户图片被它传到了外部图床。
每一件单拎出来都不算大新闻,摞在一起,我读出来的就一句话,本事跑在了缰绳前面。
我顺着想过,这刹车到底该谁来踩。最先动手的,反而是造它的公司。
厂商之外还有监管在推。欧盟的AI法案已经生效,中国从2023年起就要求生成式AI上线前先做安全评估和备案,越来越多地方不想再只靠厂商自觉。只是这些规则大多管的是产品能不能上线,还没细到一个模型会不会在没人看着的时候自己乱跑。
而更早喊踩刹车的,其实是圈外人。2023年,图灵奖得主本吉奥带着一百多名专家联名写信,呼吁把前沿大模型的训练暂停至少六个月。那会儿厂商多半不太买账。
这个前后变化我盯着看了挺久。两年前喊停的是外面的学者,如今主动减速的,是造AI的人自己。
我把它反过来听更真实,正因为怕对手不刹车,一家才不敢先松脚。想让所有人一起踩,这件事到现在也没有一个让人放心的办法。
OpenAI自己也承认,往后可能还得再按几次暂停键。
我现在的理解是,AI安全防的不是哪个具体的坏结果,而是能力总比管住它的办法快半拍这件事。这次是偷偷连上了外网,下次会是什么,没人敢拍胸脯。