ARTICLE · 1093602
2026制造业AI视觉到底卡在哪?之三:数据困境:缺陷样本的“稀有事件”悖论
今天咱们聚焦一个让所有AI视觉从业者都头疼的难题——数据困境:缺陷样本“稀有事件”的悖论。
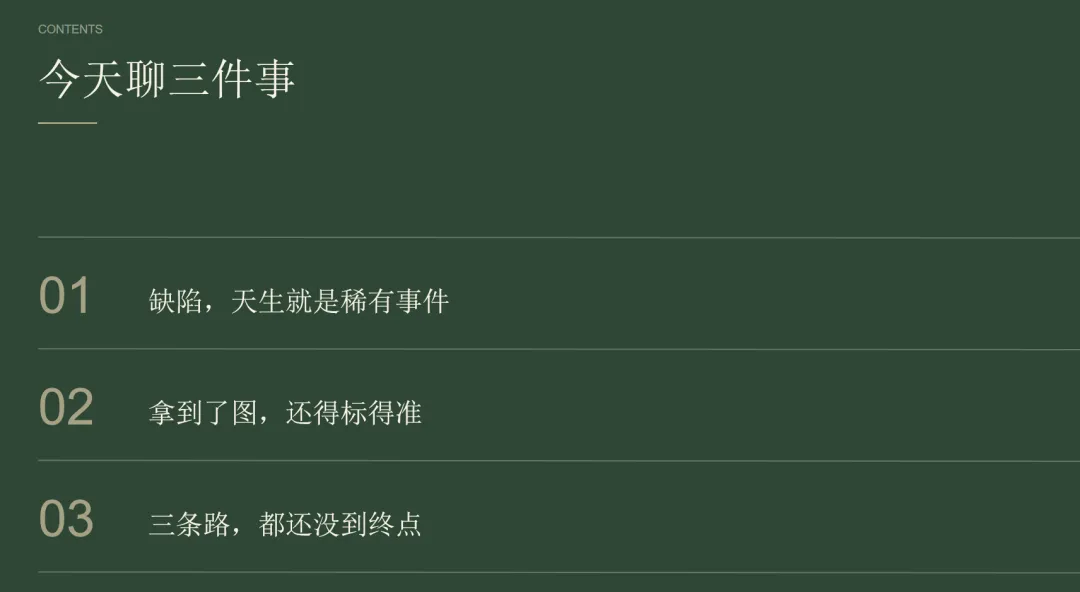
我们分三步把这个问题聊透:第一,为什么说缺陷天生就是稀有事件?第二,就算拿到了图,为什么标注还这么难?第三,目前行业里尝试的三条路,为什么都还没到终点?
我们先来看第一个问题。很多老板一开始都信心满满,觉得“我有数据”。但等相机真装上产线跑三个月,才发现一个残酷的现实:合格品堆成山,能用的缺陷样本少的可怜。这背后的核心矛盾是:产线越正常,缺陷越难拍。
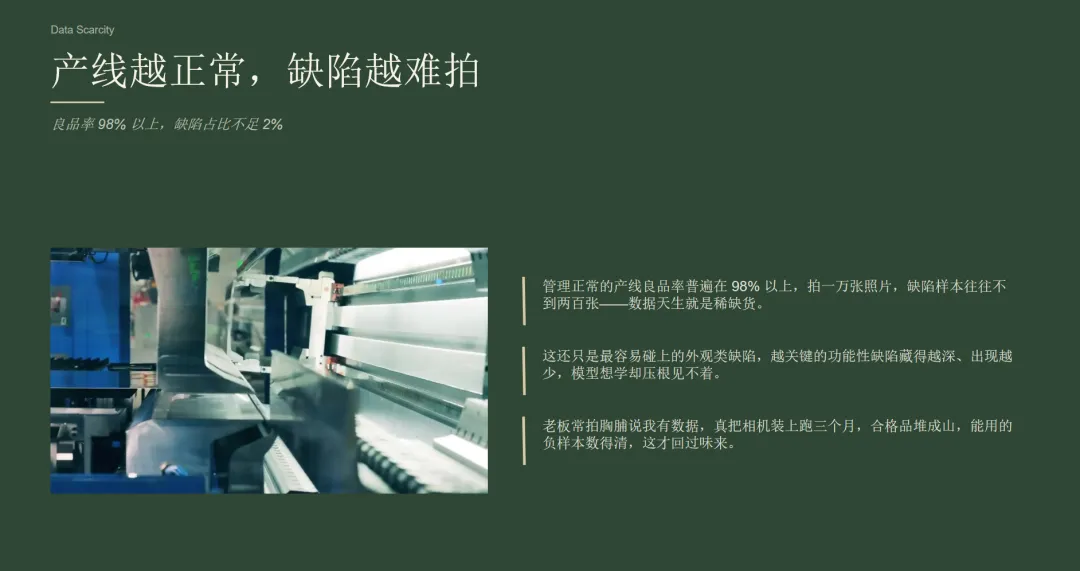
跟您算笔账。一个管理正常的产线,良品率普遍在98%以上。这意味着什么?意味着您拍一万张照片,缺陷样本往往不到两百张。这可能还是碰上最好的外观类缺陷。那些越关键的功能性缺陷,藏得越深,出现得越少,模型想学都见不着。这就是我说的数据天生稀缺。
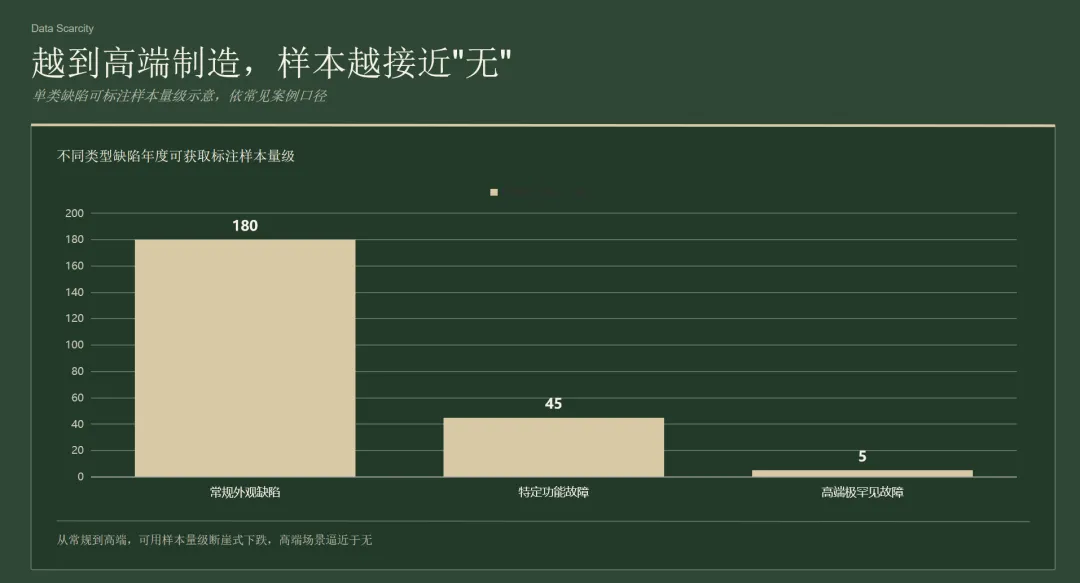
这个情况在高端制造领域更极端。从常规制造到高端制造,可用样本的量级是断崖式下跌。在有些高端场景,单类缺陷的年度可获取标注样本,甚至逼近于无。您让模型学什么呢?
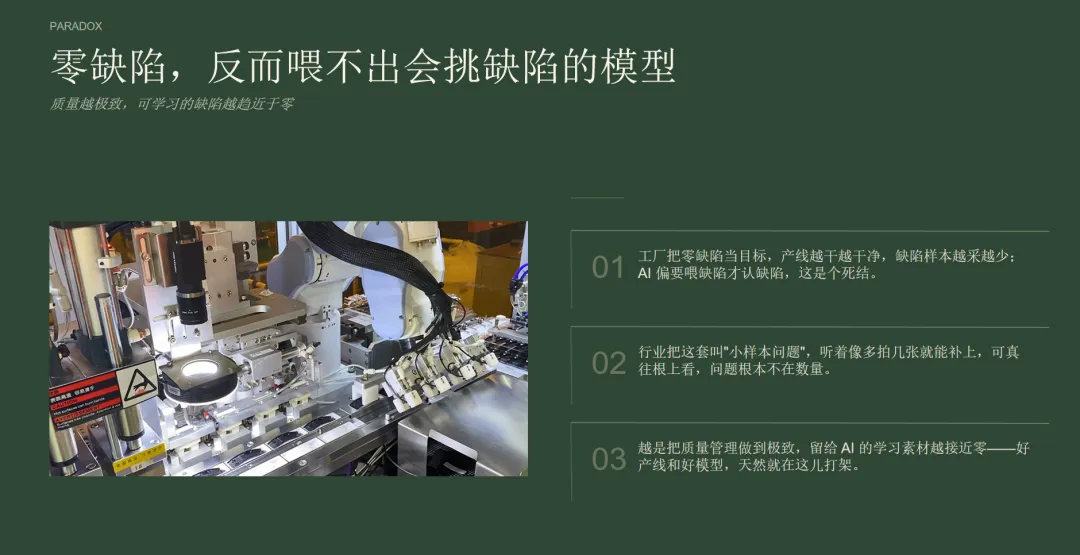
这里有个悖论。工厂的目标是“零缺陷”,产线干得越好,缺陷样本就越少。但AI偏要喂缺陷才认得缺陷。质量越极致,可学习的缺陷越趋近于零。好产线和好模型,在这儿天然就会打架。行业里管这叫“小样本问题”,但根子不在数量,在本质。
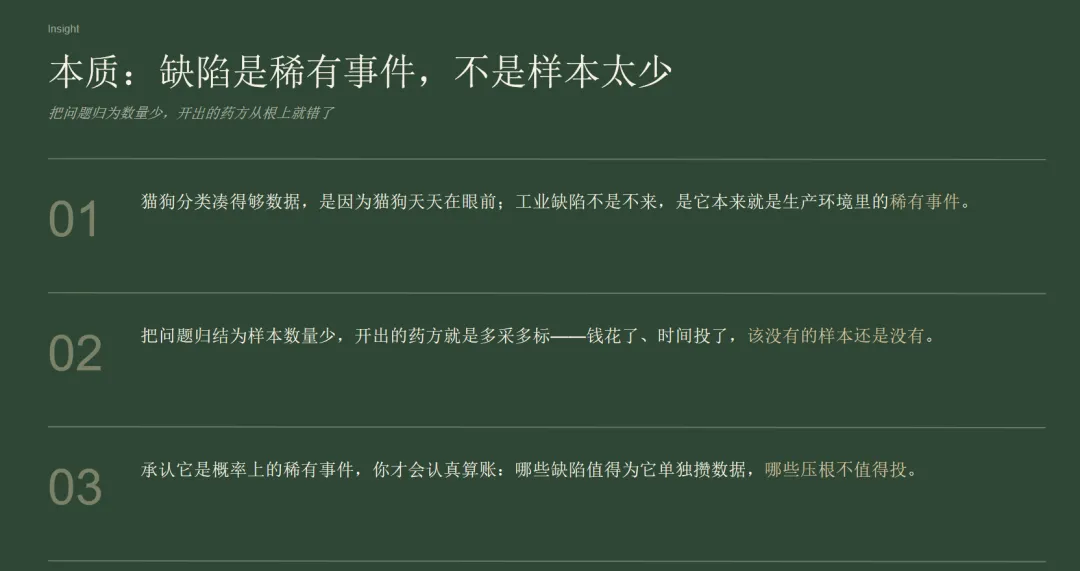
所以我们必须认清一个本质:缺陷是生产环境里的稀有事件。它不像猫狗,天天在你眼前晃,数据随便凑。如果你把问题归结为“样本数量少”,开出的药方就是多采多标。结果就是钱花了,时间投了,该没有的样本还是没有。只有承认它是概率上的稀有事件,你才会认真算账:哪些缺陷值得为它单独攒数据,哪些压根不值得投。
好,就算您千辛万苦拍到了一些缺陷图,第二道坎又来了,那就是:标注。这道坎,比采集还费人。因为工业缺陷,连个“标准答案”都没有。
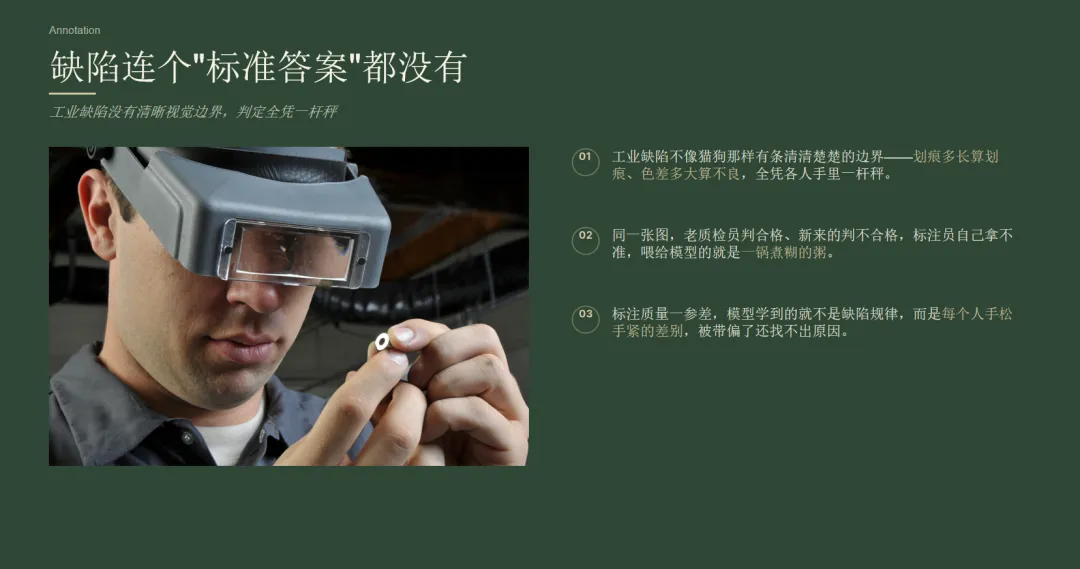
工业缺陷不像猫狗那样有清晰的边界。划痕多长算划痕?色差多大算不良?全凭质检员手里那杆秤。同一张图,老师傅判合格,新来的判不合格。标注员自己都拿不准,喂给模型的就是一锅煮糊的粥。
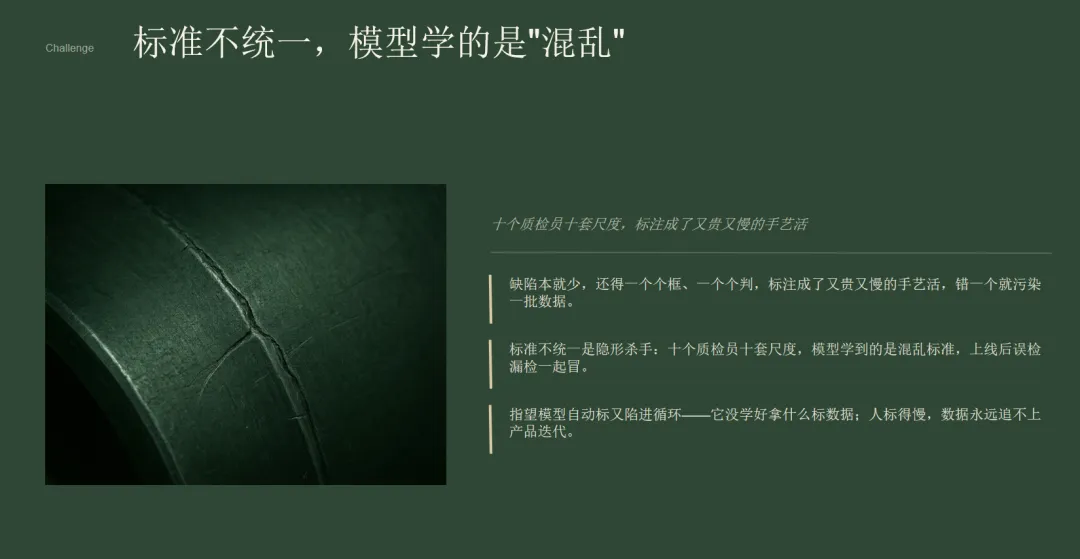
标准不统一是隐形杀手。十个质检员,十把尺子。模型学到的不是缺陷规律,而是每个人手松手紧的差别。结果就是,模型被带偏了还找不出原因,上线后误检漏检一起冒。标注,成了一个又贵又慢的手艺活,错一个就污染一批数据。
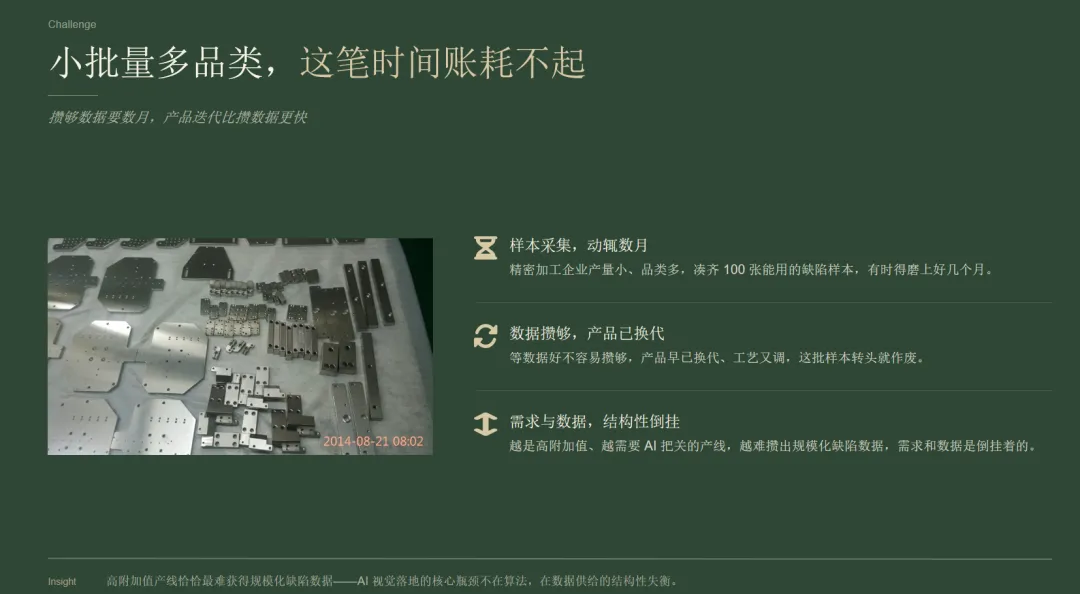
更头疼的是,很多精密加工企业是小批量、多品类。凑齐100张能用的缺陷样本,有时得磨上好几个月。等数据好不容易攒够,产品早已换代,工艺又调了,这批样本瞬间作废。因此,需求与数据,是结构性倒挂的。
所以,我们得出一个洞察:AI视觉落地的核心瓶颈,不在算法,在数据供给的结构性失衡。越是高附加值、越需要AI把关的产线,越难攒出规模化的缺陷数据。这是一个死结。
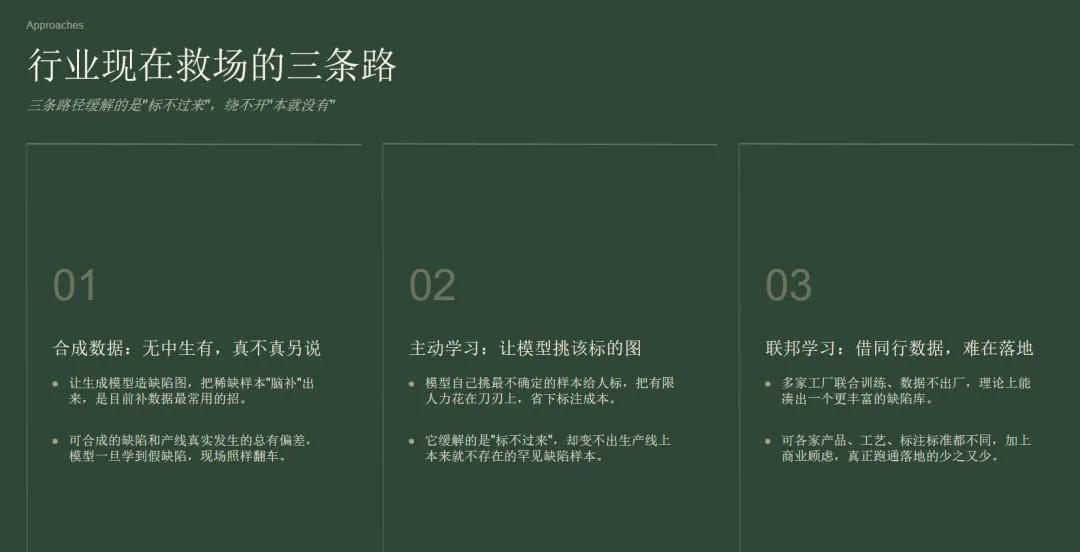
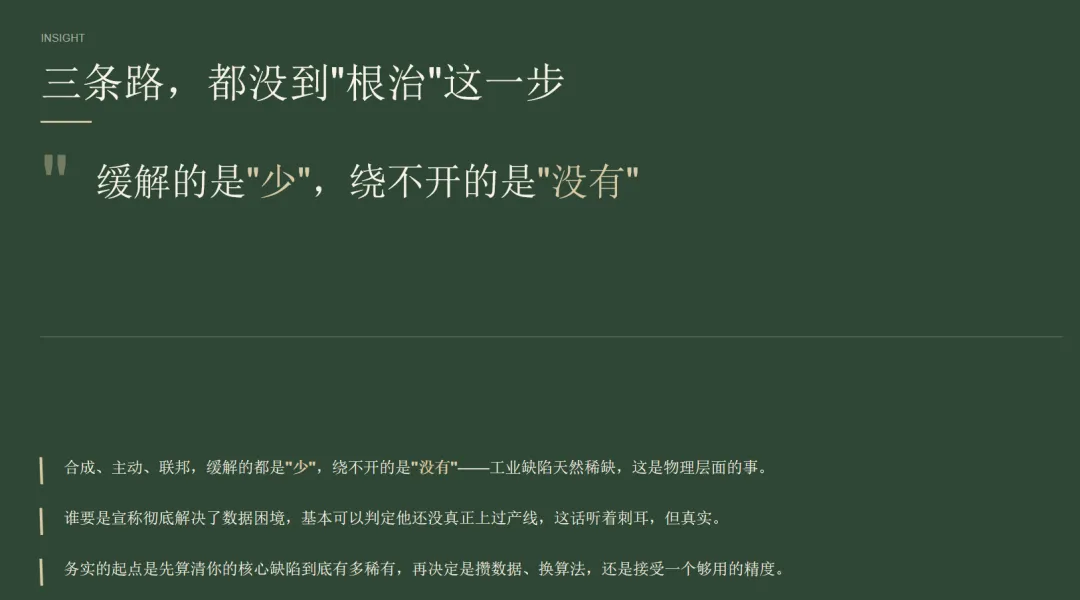
面对这个困境,行业里现在有三条主流的救场路径。但我要说一句可能不太中听的话:这三条路,都还没到“根治”这一步。它们缓解的是“标不过来”,但绕不开“本就没有”。
哪三条路?第一,合成数据。让生成模型去“脑补”缺陷图。但合成的缺陷和真实产线总有偏差,模型学到假缺陷,现场照样翻车。第二,主动学习。让模型自己挑最不确定的图给人标。这能省标注成本,但它变不出生产线上本来就不存在的罕见缺陷。第三,联邦学习。几家工厂联合训练,数据不出厂。理论很美好,但各家产品、工艺、标准都不同,加上商业顾虑,真正跑通的少之又少。
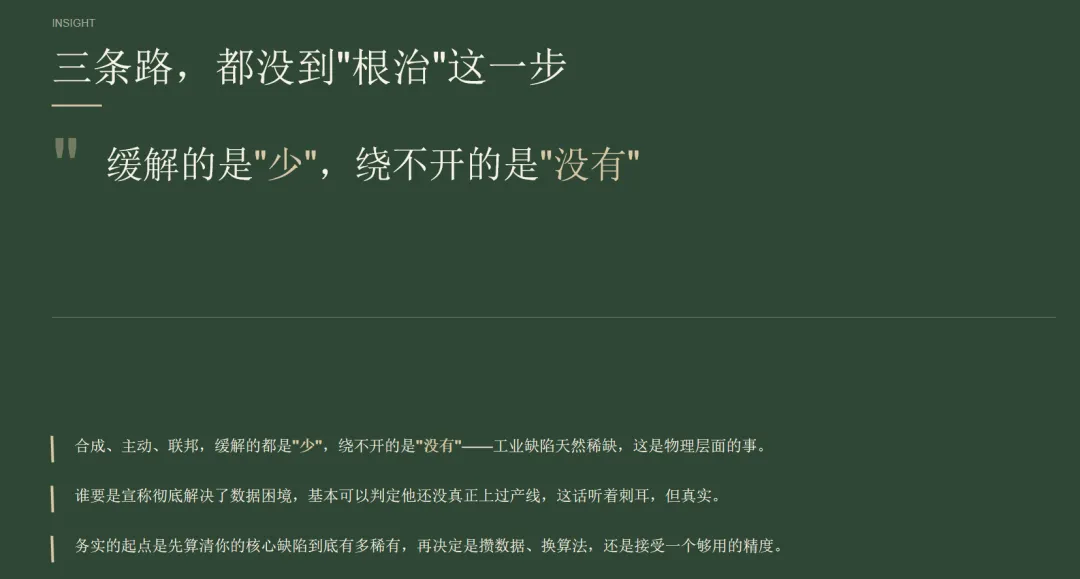
说实话。谁要是宣称彻底解决了数据困境,基本可以判定他还没真正上过产线。工业缺陷天然稀缺,这是物理层面的事。务实的起点,是先算清您的核心缺陷到底有多稀有,再决定是攒数据、换算法,还是接受一个够用的精度。别把“稀有事件”当成“样本太少”,先算清缺陷有多稀有,再决定钱往哪儿投。感谢您的关注,如果有任何关于AI视觉检测的问题,请随时给我留言。我是王艺兴,让AI与创新融合,为您的企业赋能。