ARTICLE · 1094593
AI 会写代码之后,研发的胜负手在哪里?
《AI Native 研发范式实践手册》(阿里技术出品,2026 版)读后感。
过去一年,行业叙事变了好几轮:从 Copilot 辅助编码,到 Devin 式"AI 软件工程师",再到 Agent 满天飞。但大多数讨论还停留在"哪个模型更强"。读完这本手册,我的结论是:AI 写代码这件事正在被快速"解决",而真正的胜负手,已经移到了代码之外。
一、1个扎心的数字:编码 1 小时,上线 3 周
手册里给了一组数据:
主流模型在 SWE-bench Verified 的通过率,两年间从约 30% 攀升到 80%;Terminal-Bench 2.1 上头部模型普遍突破 85%; 但按阿里内部的粗略统计,生成代码只占整个研发链路的 20%~30%,甚至更低; 一个真实案例更极端:一个交互实验需求,编码+本地验证不到 1 小时,而走完方案评审、联调环境准备、多平台联调、发布审批、灰度验证、封网期合规检查,总耗时约 3 周。编码占比不到 1%。
这就是阿姆达尔定律的现实版:你优化的如果不是瓶颈,就不可能带来数量级的效率提升。把 1 小时的编码压缩到 1 分钟,那条 3 周的链路纹丝不动。
为什么 Coding 偏偏最先被 AI 攻克?手册的解释我很认同:AI 总是优先解决那些反馈公开、验证可以规模化的问题。编译是否通过、测试是否通过,跑一下就知道——Coding 和数学是少有的"对错机器自己就能判"的领域。而企业级生产环境里,答案藏在内部系统里,没有公开反馈,验证一次成本还很高。
由此推出整本手册最核心的行动纲领:
Coding 正在被解决,恰恰意味着"让 AI 更会写代码"不再是主战场。主战场在验证与环境。
二、电气化类比:别做"电力轴传动"的工厂
手册用电气化历史做类比,是全文最有思想密度的一段。与吴泳铭的思路保持一致。
电气化早期,工厂只是用电动机替换蒸汽机——动力源换了,但所有机器仍围绕中央传动轴布局。真正的生产率跃升,发生在"单元驱动"普及之后:每台机器拥有独立电动机,工厂才能按生产流程重新组织,空间、流水线、管理方式被彻底重构。
电气化最大的价值不是电动机比蒸汽机效率高,而是电力最终成为重构整个生产系统的基础设施。
对应到今天:把 AI 嵌进 PRD、方案、生码、测试的既有流程,每个节点局部提效——这还只是"电力轴传动"。SDD、各种 Prompt 工程技巧,本质都在这条路线上。它的结构性问题是:优化的是"人如何使用 AI",而不是"AI 如何使用研发环境"。
而 Agentic 的真正定义,手册给得很精准:
Agentic 的核心不是 AI 拥有更多决策权,而是它能够自主获得验证信号,并据此持续推进任务。
三、3个真实案例,3条经验
案例一:AIDC 数字投手(6 人小队)。经历了"超级个体 → 数字员工 → 云上 Scrum"三个阶段。金句频出:
"Token 放大的是一个人能干的事,产能还锁在个人电脑和单个会话里,难以被团队协作和继承。"
"员工有了,但卡在协作上,人更多是传令兵。"
到第三阶段,人的工作收缩为两件事:维护 Loop(保证每个执行环节有对应的验证手段)和寻找真需求。策略交付周期从 10 天缩到 2 天,约 80% 核心能力 Skill 化。他们的边界划分很清楚:系统负责状态、权限、规则等高确定性事务;AI 负责约束内的分析与执行;人负责目标设定、关键决策、风险取舍和最终责任。
案例二:千问用增 Agent(15 名工程师,3 个多月)。成果:交付周期缩短一半、千行代码缺陷率下降 70%、变更失败率下降 90%+。方法论核心是四个环节:项目理解(Code Docs + Code Graph + Rules)、需求理解(AI 主动追问,沉淀为 Spec 和 Tasks)、TDD 编码、TraceId 证据链排障。最有洞察的一条:
"AI Coding 的上限很大程度取决于基础设施是否够 AI 友好。能否清晰提出问题、拆解问题、定义边界并建立验证机制,正在变得比单纯编码熟练度更重要。"
案例三:万有无界平台。约 80% 交互体验类需求用可交互原型承接,视觉类问题一次修复成功率 89%,设计师直接参与代码协作(单月近 20 个活跃日),累计新增代码 80+ 万行。他们的框架是"一个需求、一组事实":上下文资产说明解决什么问题,工程执行环境决定修改发生在哪里,验证证据证明结果是否成立——三者首尾相接成闭环。
四、组织才是最难啃的部分
这部分是手册里最锋利、也最少有人敢写的内容。
协作的本质是消除理解不一致性的成本,而这个成本,过去一直是人在扛。一份不完整的需求、一段没注释的代码、一个口口相传的"潜规则",系统能运转是因为人在用自己的灵活性悄悄补缺口。这些动作发生得太自然,自然到我们不再把它看作"工作"。但它们是工作。
关于"蒸馏焦虑":员工每写一份 SOP、每教 AI 一个流程,都是在把知识"导出"到组织资产里。"它感觉是合作行为,但结构上接近一种替代关系。"手册毫不留情地指出三个后果:
培养断裂:day 1 就有 AI 写代码,那 day 1 的人该做什么?"每家公司不招 day 1 是局部最优,但整个行业不招 day 1,三五年后 senior 池开始枯竭。" 转型被焦虑杀死:"当员工意识到'我说得越多,被替代得越快',关键知识开始藏匿,而 Harness 建设恰恰需要员工说出隐性约定。员工不说,转型就不可能完成。" 行业级负反馈环:"大家在 death of expertise 的方向上互相加速。几年后,整个行业的判断力会被同步抽空。"
关于组织形态:专业岗合并("再清晰区分前端后端、Java 还是 Go,只会导致低效的沟通")、3~5 人小团队冲具体问题、管理者从"信息中转站"转向"意图教练"、组织从 org chart 走向 execution graph。其中最容易被低估的红利:
如果组织的最小执行单元从"人 + 关系网络"变成"任务 + 上下文 + 权限 + 工具",那么组织重组不再依赖重建人际关系网络——你获得的是组织适应速度本身的提升。
五、度量:别只看"AI 写了多少代码"
很多团队上 AI 的第一反应是看两个数:多少人用了 AI、AI 写了多少代码。手册的判断很直接:如果度量体系只围着它们转,后面基本都会跑偏。
"AI 写了代码,不等于代码进了提交;代码进了提交,不等于变更成功发布;变更发布了,也不等于需求价值真正交付。"
他们建的是三层指标:
L1 AI 效能层(覆盖率、Session、Token、Skill/MCP 使用)证明 AI 进入过程;
L2 工程质量层(缺陷率、回滚返工、恢复时间)证明质量守得住;
L3 价值交付层(交付周期、发布频率、AI vs 非 AI 对比)证明业务结果有改善。三层合在一起,才构成完整证据链。
还有一个被严重低估的指标:上下文资产(Skill、MCP、Spec、runbook)。"如果不度量这些资产,团队就会一直停留在'每个人临时问 AI'的阶段。"以及一句值得贴在墙上的话:
度量不是一个事后统计系统。它会反过来塑造研发流程。
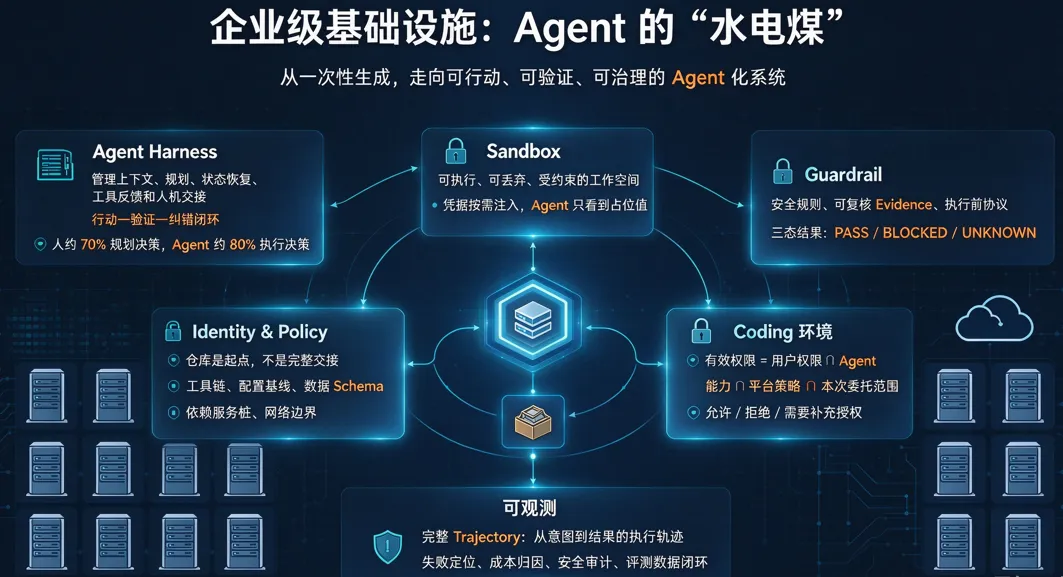
六、企业级基础设施:Agent 的"水电煤"
基础设施的核心组件将产生变化,形成如下图所示Agent的水电煤。
结语
手册主编在结尾写了一段很清醒的话:这本手册"不是一份成熟的方法论,更谈不上标准答案——很多做法还在验证中"。但方向已经足够清楚:软件工程的下一场竞赛,比的不是谁的模型更强,而是谁先把验证环境建起来、把组织知识沉淀下去、把人的角色重新安放好。
AI 会写代码之后,研发的稀缺资源变成了三样东西:
可验证的环境
可复用的上下文
敢担责的人
谁先补齐这三样,谁就拿到下一个阶段的入场券。