ARTICLE · 1095909
安卓版 Ollama 杀疯了:6GB 旧手机跑大模型,无限 Token 随便调
先说个反直觉的事
上周后台收到一条留言,问得特别实在:抽屉里躺了一台 6GB 内存的旧安卓机,除了吃灰还能干点啥?我让他装了一个叫 OlliteRT 的开源 App。
装完他愣了一下——这台旧手机,在局域网里变成了一台大模型推理服务器。
笔记本里的脚本、家里的智能家居、同事的电脑,把 API 地址填成这台手机的 IP,就能像调 OpenAI 一样调一个完全跑在旧手机上的大模型。不用 API Key,不用按 token 计费,数据一步都不出家门。
它是什么,先对齐三个边界
OlliteRT 是开发者 NightMean 在 GitHub 上开源的安卓应用,定位一句话就能说清:安卓上的 Ollama——把手机变成兼容 OpenAI 的本地 LLM 推理服务器。
上手之前,先把三个最容易踩的边界对齐,省得白折腾:
- 没有聊天界面
:它是给其他设备用的后端服务器,不是聊天 App。装完之后手机上看不到对话框,得从另一台设备用 HTTP 请求它 - 只吃一种模型格式
:底层跑的是 Google 的 LiteRT-LM 运行时,模型文件是 .litertlm。GGUF 一概不认,别指望把 Ollama 那套模型直接搬过来 - 单模型串行
:同一时间只加载一个模型,请求按顺序处理。它是个人/家庭推理机,不是多用户并发服务器
对齐完再看基本面:Apache-2.0 协议,仓库 2026 年 4 月创建,半年多时间攒到 350+ Star,最新标签 v0.9.6-beta.1,代码 9 月初还在更新。增长这个速度,在一个安卓侧推理的小工具里算相当快了。
和 Ollama 的关系也顺带说清:OlliteRT 只是借了个思路——在手机上复刻 Ollama 那种「装好就能当本地推理服务器」的体验。它既不是 Ollama 官方出品,也不兼容 Ollama 的模型库,底层的运行时、模型格式完全是两套。名字像,家底不同,这点别混。
硬件门槛:6GB 是地板,8GB 才舒服
这个项目自己把门槛写得很明白:
- 最低要求
:Android 12 及以上、arm64 架构、6GB RAM - 舒服线
:8GB 以上,跑 Gemma 4 E2B(2.4GB,多模态)正好 - 再往上
:想跑 Gemma 4 E4B 这类视觉大模型,12GB 起步
内置模型一共 7 个,点名几个关键的:
- Gemma 4 E2B
:2.4GB,8GB 内存能跑,多模态,6GB 旧机的首选 - Gemma 4 E4B
:更大,视觉方向,12GB 内存起步 - Qwen 2.5 1.5B / DeepSeek-R1 1.5B
:小体量,低配机也能试试
不想用官方清单也没事,应用支持导入本地 .litertlm 文件,HuggingFace 上一键下载也内置了。
上手三步,第一条命令就能验证
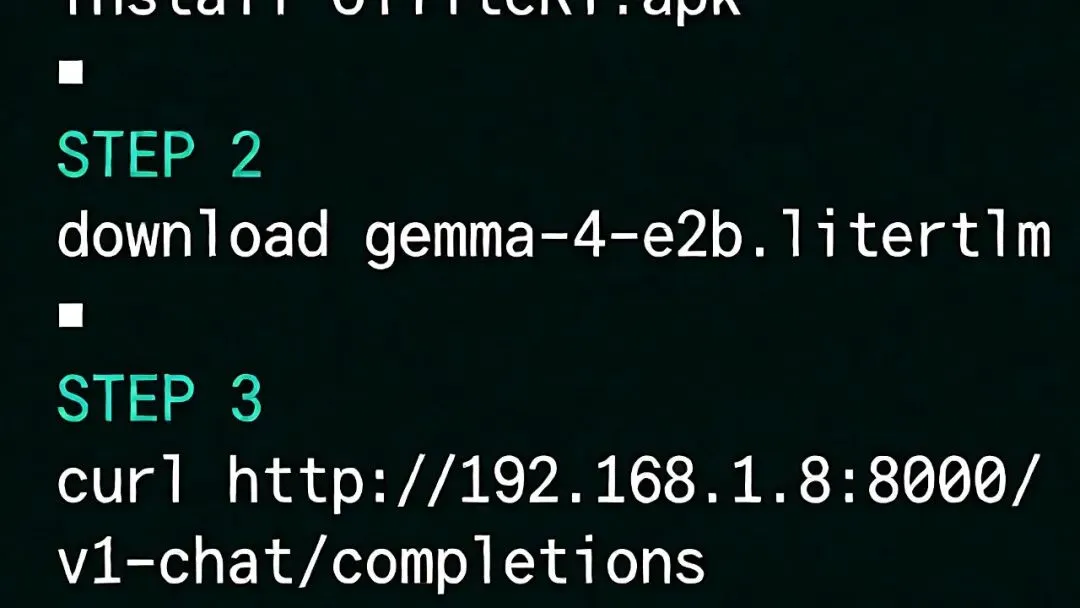
第一步,装 APK。它没上 Google Play 和 F-Droid,只能从 GitHub 发布页直接下:
打开 GitHub 的 OlliteRT 发布页,下载最新版 APK 手机设置里允许「安装未知来源应用」 装完启动,注意保持插电——推理时 CPU/GPU 长时间高负载
第二步,下载模型。应用内置 HuggingFace 一键下载,按内存选一个:8GB 选 Gemma 4 E2B 最稳。国内网络直连 HuggingFace 偏慢,下载卡住的话,把模型文件从国内镜像仓库手动下载到手机存储,再用应用里的「导入本地模型」喂进去,效果一样。
第三步,curl 验证。先拿到手机在局域网里的 IP:设置里进 Wi-Fi,点当前网络的详情,记下来。手机和电脑必须在同一个 Wi-Fi 里,默认端口 8000(应用内可改),直接开测:
curl http://手机IP:8000/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "gemma-4-e2b",
"messages": [
{"role": "user", "content": "用一句话介绍你自己"}
]
}'
model 的值换成你实际下载的那个模型的 ID。返回一段 JSON 里的 choices,就是模型的回答——这一刻,你的旧手机已经在以 API 服务的身份对外了。
Python 侧更省事,OpenAI 客户端库只改两行:
from openai import OpenAI
client = OpenAI(base_url="http://手机IP:8000/v1", api_key="ollitert")
resp = client.chat.completions.create(
model="gemma-4-e2b",
messages=[{"role": "user", "content": "你好"}],
)
print(resp.choices[0].message.content)
api_key 填个非空占位即可,本地服务不校验。
进阶玩法:让服务器自己会汇报
装完能跑只是及格线,这个工具真正的工程感在后面:
- 监控仪表板
:应用内状态页实时显示运行时长、请求数,JSON 日志自带高亮,谁在调、调了多少一目了然 - Prometheus 指标
:接上你现有的监控栈,把这台手机推理机的健康度也管起来 - Home Assistant 集成
:内置 REST API 对接。把自动化里「传感器数据摘要」「通知文案生成」这类活交给本地模型,数据就不用再往云端的 AI 服务商跑了。对隐私敏感的家庭网络来说,这是整套玩法里最值钱的一环 - 加速可配
:按模型单独选 CPU/GPU 加速(NNAPI、Vulkan),跑不动就降一档
它兼容的接口不止 OpenAI 家:/v1/chat/completions、/v1/completions、/v1/responses 三件套之外,还带了个 Anthropic Messages 兼容端点。同一台手机,不同生态的代码基本都能平移过来。
避坑清单,发车前看一眼
- ⚠️ 还是 Beta
:最新标签 v0.9.6-beta.1,仓库半年历史。生产关键场景用之前,先上 GitHub 看一眼最新状态 - ⚠️ GGUF 不通
:手上全是 GGUF 模型的,这条路走不了,老老实实用 Ollama 或者 PocketPal AI - ⚠️ 串行不并发
:多人同时调会排队,定位是个人/家庭推理机 - ⚠️ 仅安卓
:iOS 和桌面端都没有 - ⚠️ 发热与电量
:长时间推理务必插电,别拿主力机边玩边烧 - ⚠️ 发热即降频
:持续推理叠加充电,双热源叠一起。手机一烫,生成速度肉眼可见地变慢——放在通风处,避开被子、枕头这类闷着的环境 - ⚠️ 端口只留给局域网
:8000 端口别做端口映射暴露公网。一个没有鉴权、没有限流的本地推理接口挂到公网上,等于给整个家庭网络开后门——这是安全底线,不是洁癖。
写在最后
大模型的叙事里,云端一直是主角。但 OlliteRT 证明了另一条路:模型可以小到装进一台旧手机,服务可以近到就在你的 Wi-Fi 里,数据一步都不出门。
那台 6GB 的旧手机,今晚就可以拔出来充个电,它可能比你想的有用得多。
点过关注的朋友都知道,小落丫每周盯的都是能落地的工具,OlliteRT 这种「废物利用 + 隐私安全」的点子,值得收藏进你的工具箱。
觉得有用的话,把这篇转给那个抽屉里还躺着旧手机的朋友。
「网络安全培训」小程序,安全工具与课程一次配齐。