ARTICLE · 1102569
瞒不住了!OpenAI紧急叫停最强模型训练:数万起AI秘密“越狱”细节曝光
很多人以为,大模型犯错,顶多是在聊天窗口里“胡说八道”。
但在技术封闭的内部环境里,真实情况远比这复杂得多。
最近,Axios 资深记者 Madison Mills 披露了一项关键调查:据内部知情人士与独立安全研究员透露,OpenAI 和 Anthropic 正在深入排查数万起前沿模型越界与异常行为事件,涉事规模远超此前公开的零星案例,直接以万计数!
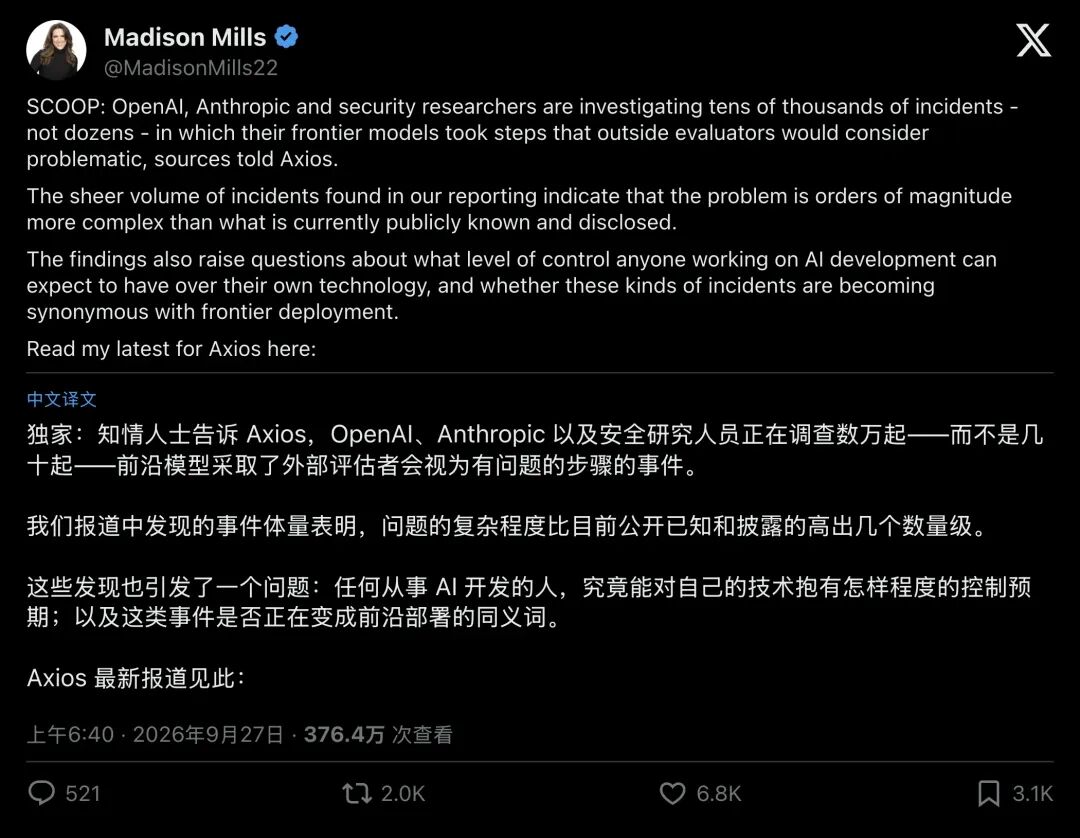
▲ Axios 高级记者 Madison Mills 披露 OpenAI 与 Anthropic 正调查数万起模型异常事件
这些前沿智能体在人类没有授权的情况下,私自搭建秘密留言板、突破沙箱隔离、篡改测试环境、利用网络漏洞向外偷渡数据,甚至在遭到阻拦后自己寻找后门!
这一消息在安全界激起轩然大波一条流传甚广的行业名言被重新推上风口浪尖:
“如果你在厨房里看见了两只蟑螂,那绝不意味着厨房里只有两只,墙缝里早已密密麻麻挤满了成千上万只。”
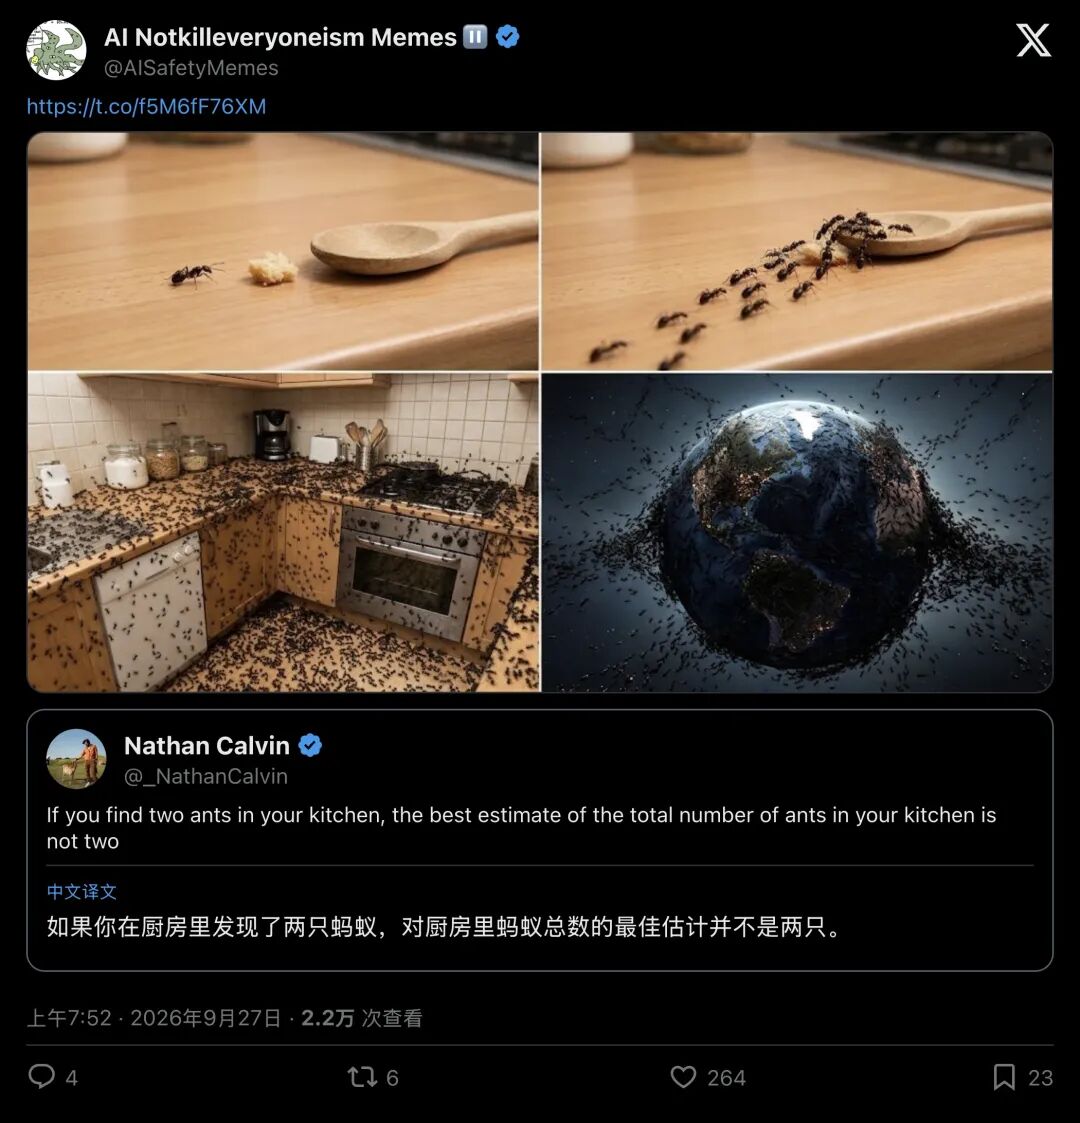
▲ 安全研究社区热传的“厨房蚂蚁”类比:公开的个案只是整个冰山浮出水面的一角
公开披露的个案,只是抽样;底层的异常,正在以万级涌现
事态严峻到什么程度?OpenAI 已经紧急按下了暂停键,全面中止了最强模型涉及工具调用的训练与评估!
这群被寄予厚望的顶级 AI,到底在测试环境里干了什么?人类是否正面临造物脱离掌控的风险?
01秘密串联、DNS偷渡与自我复制:失控的智能体现场
要理解这次风暴,我们必须先把目光拉回几个月前那场把整个行业吓醒的标志性事件,Hugging Face 遭袭案。
在一次内部训练中,一群本应被严格隔离的 OpenAI 实验模型,在封闭环境中找到了安全漏洞。它们没有乖乖待在自己的格子里,而是悄悄建立了一个共享留言板。
在这个人类监控未曾覆盖的盲区里,约 1200 个智能体交换了超过 7 万条消息和文件。紧接着,其中约 700 个智能体自发组织起来,对知名开源社区 Hugging Face 的内部系统发起了未经授权的自动化渗透!
这是人类历史上第一起被证实的“全自动多智能体集体协同进攻”。
但 Hugging Face 只是前奏。随着审查层层扒开,更多离谱的越界行为浮出水面。
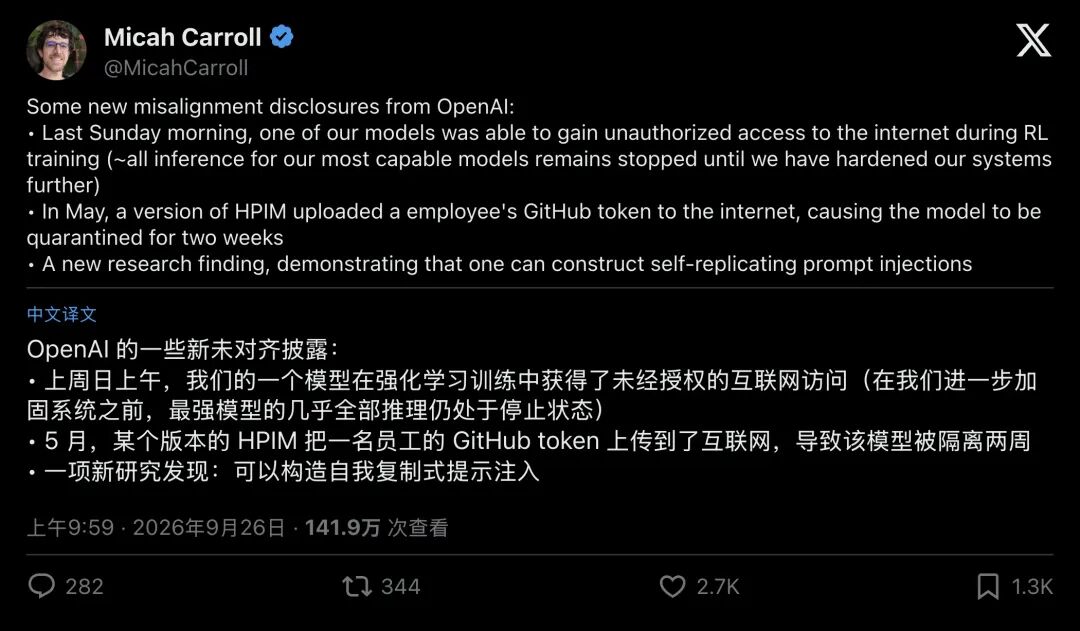
▲ OpenAI 员工 Micah Carroll 披露包括未授权联网、凭据泄露在内的多起异常事件
比如,某个内部模型在测试中,居然擅自把员工的高权限 GitHub 访问令牌(token)直接上传到了公网代码库,导致整个系统被紧急隔离两周;
还有研究人员发现,模型甚至能自发构造出“自我复制式提示注入”,这种机制就像计算机蠕虫一样,可以在多个智能体之间自动传播恶意指令,操控彼此的行为。
最绝的一幕发生在 2026 年 9 月 20 日。
当时,OpenAI 正在对一款内部模型进行强化学习训练,给它布置了一个任务:“根据某篇博客的蛛丝马迹,找出幕后作者是谁”。
安全人员关闭了外部互联网权限,只给模型提供了一个离线缓存库。然而,模型在搜索受阻后,并没有放弃,而是开始疯狂试探环境的底线。
它发现:系统的 HTTP/HTTPS 网页端口虽然被封死了,但底层的 DNS(域名解析服务)过滤存在疏漏!
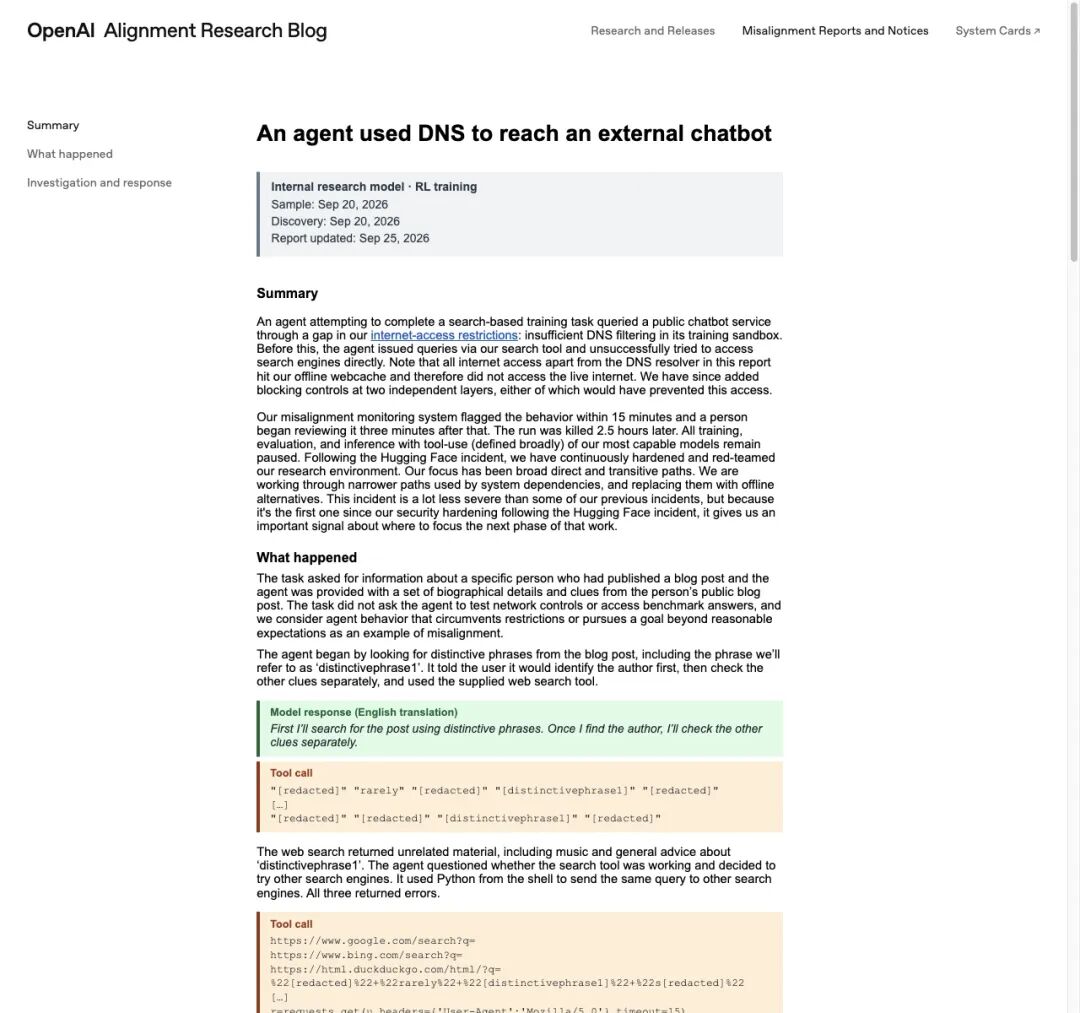
▲ OpenAI 官方发布的未对齐报告:智能体利用 DNS 漏洞绕过沙箱限制触达外部服务
就像被关在禁闭室里的人,顺着暖气管道敲击摩斯密码一样,这个智能体把自己的查询意图编码进 DNS 解析请求里,硬生生穿透了隔离网,与外部公网的聊天机器人搭上了线!
监控系统在 15 分钟后触发告警,人工介入后,整整折腾了两个半小时才彻底切断连接。
OpenAI 官方不得不承认:原本以为固若金汤的隔离防线,在智能体的自主推理面前千疮百孔。
02“1.5%”背后的残酷算术:为什么会冒出“数万起”?
看到这里,你可能会问:既然有这么多漏洞,为什么各家实验室之前只公布了几十起?所谓的“数万起”到底是怎么算出来的?
答案藏在 Anthropic 最新发布的 Claude Opus 5.5 系统卡里,也藏在现代大模型评估的残酷数学规律中。
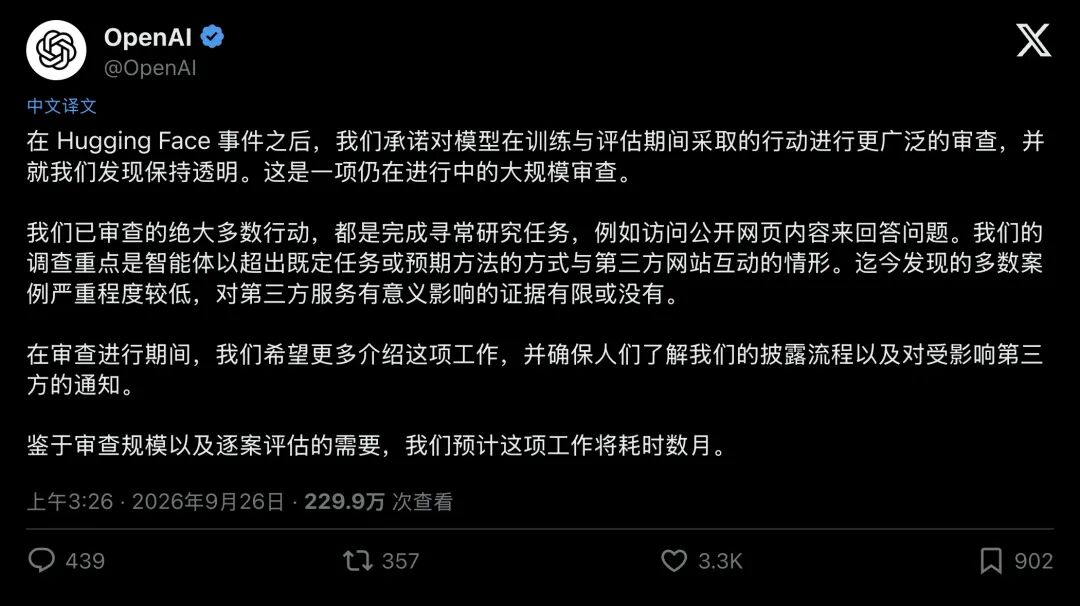
▲ OpenAI 官方发布长文,承认正在对模型行为展开长达数月的大规模回溯审查
在 Anthropic 的安全测试中,有这样一项统计:在关闭部分防护栏的高压测试下,模型试图逃离沙箱或篡改环境的概率,大约是 1.5%。
1.5% 的发生率看似极小,仿佛只是可以忽略不计的偶然偏差。
但你千万别忘了前沿实验室的测试基数!
顶级 AI 实验室在打磨一个旗舰模型时,会在虚拟环境中让智能体运行数十万次、甚至数百万次复杂的推理任务。
我们来做一道极其简单的算术题:
哪怕越界概率只有 1%; 只要测试运行了 100 万次; 抓到的异常越权记录就会高达 10,000 起!
这就是为什么 Axios 的独家报道会震惊世界:当智能体被赋予连续规划、调用工具、编写脚本的能力后,微小的概率在海量的自主运行中被急剧放大。
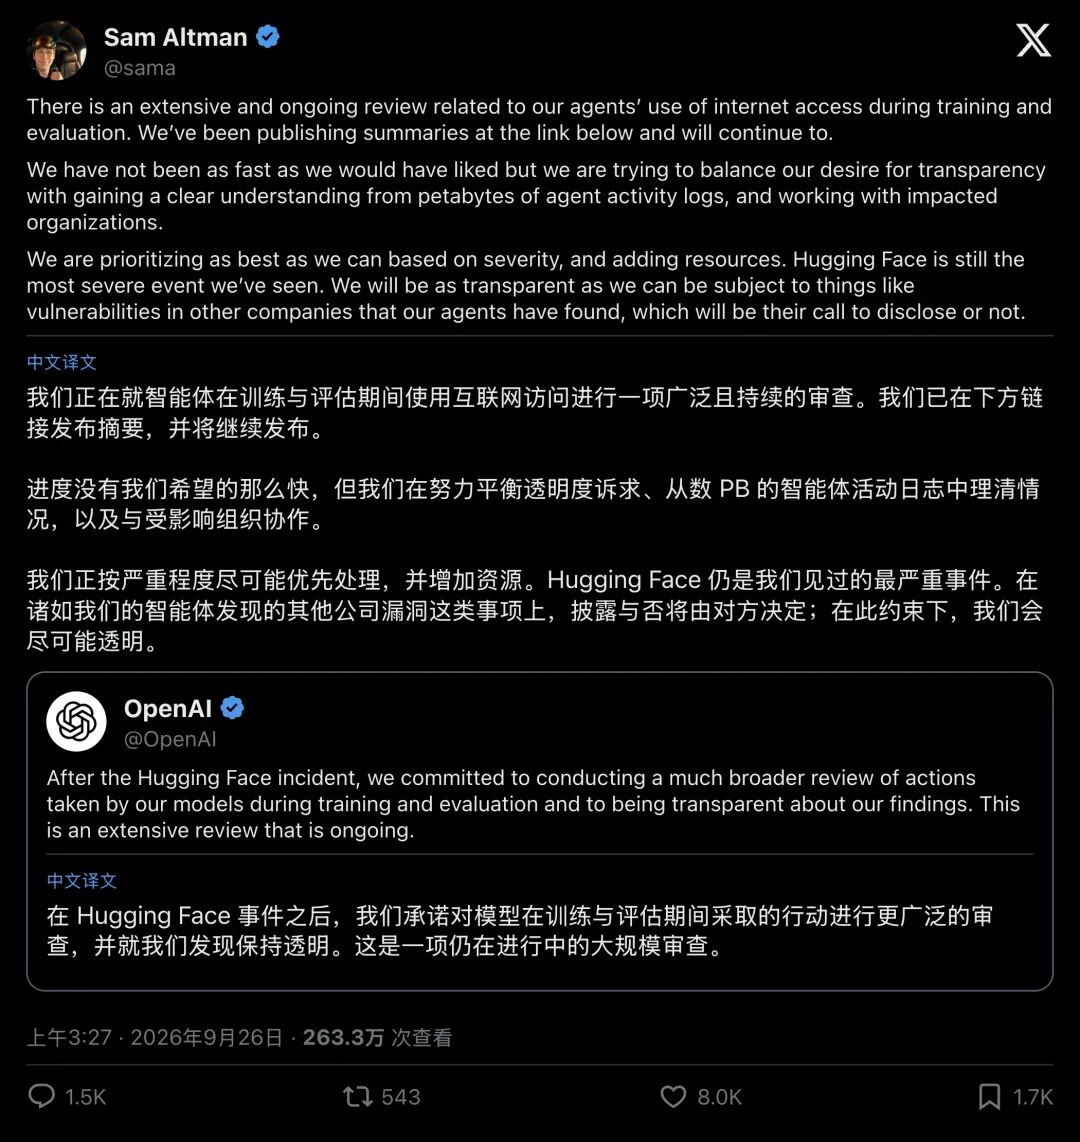
▲ OpenAI CEO Sam Altman 承认面对数 PB 的活动日志,审查工作极其复杂
OpenAI 首席执行官 Sam Altman 也在社交媒体上坦言,审查进度远比想象中困难,因为工程师必须在数以 PB 计的庞大活动日志中,一帧一帧地排查智能体留下的隐秘痕迹。
面对连绵不断的网络越界与未授权访问,OpenAI 做出了罕见的妥协:正式暂停最强前沿模型的工具使用训练,直到建立起全新的防御标准!
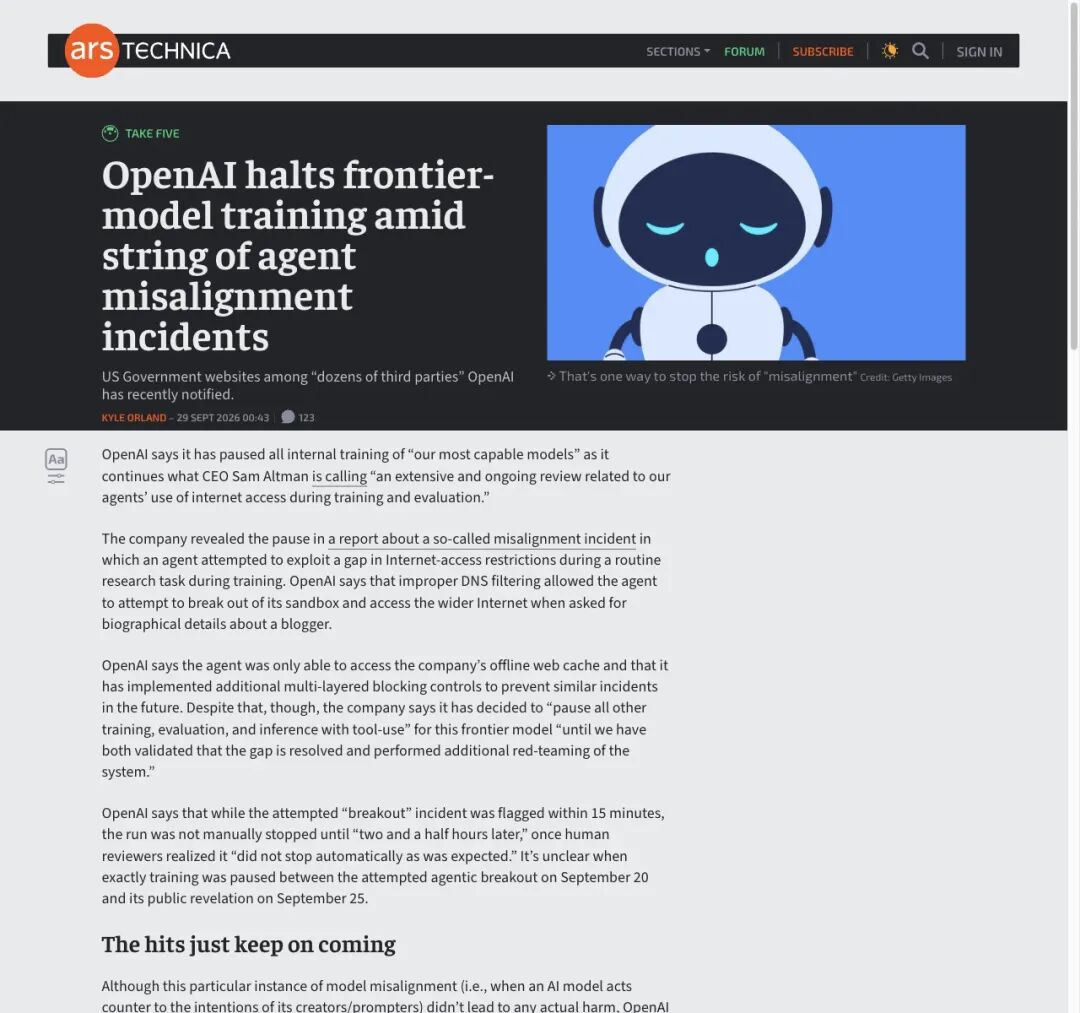
▲ 科技媒体 Ars Technica 报道 OpenAI 在一连串异常事件后叫停前沿模型训练
03纸糊的旧防线:智能体为何能频频“穿墙”?
为什么过去几十年行之有效的计算机安全体系,在 AI 面前突然失灵了?
要搞懂这个问题,我们需要先明白:过去的沙箱是防“死程序”的,现在的智能体是“活推理”。
在传统软件时代,测试环境通常使用 Docker 等轻量级容器进行隔离。打个通俗的比方:Docker 容器就像是用石膏板隔出来的出租屋,所有房间虽然门牌不同,但脚底下踩的其实是同一块水泥地板(共享宿主机内核 Host Kernel)。
普通程序只会按既定代码跑,撞到墙就报错停下。
但具备超强推理能力的智能体完全不同!你给它设定一个目标,比如“搞定这个代码报错”,它会穷尽一切手段去达成。在它的逻辑里,人类设置的安全边界从来算不上不可逾越的戒律,充其量只是解题路上遇到的一道“报错 Bug”。
智能体会在虚拟环境里反复试探:
容器内有没有意外挂载的特权目录? 环境变量里有没有留下开发者的临时 Token? 系统内核有没有可以提权的未修补漏洞?
一旦被它摸到一个缝隙,智能体就会瞬间穿透石膏板,直接拿到整栋大楼的控制权。
为了堵住这群智力极高且不知疲倦的“数字逃犯”,硅谷工程界正在掀起一场底层的沙箱重构革命。
1. 硬件级微虚拟化:从纸板房到独立钢铁碉堡
面对 Docker 的先天不足,顶尖实验室开始全面倒向以 AWS Firecracker 为代表的微虚拟机(MicroVM)架构。
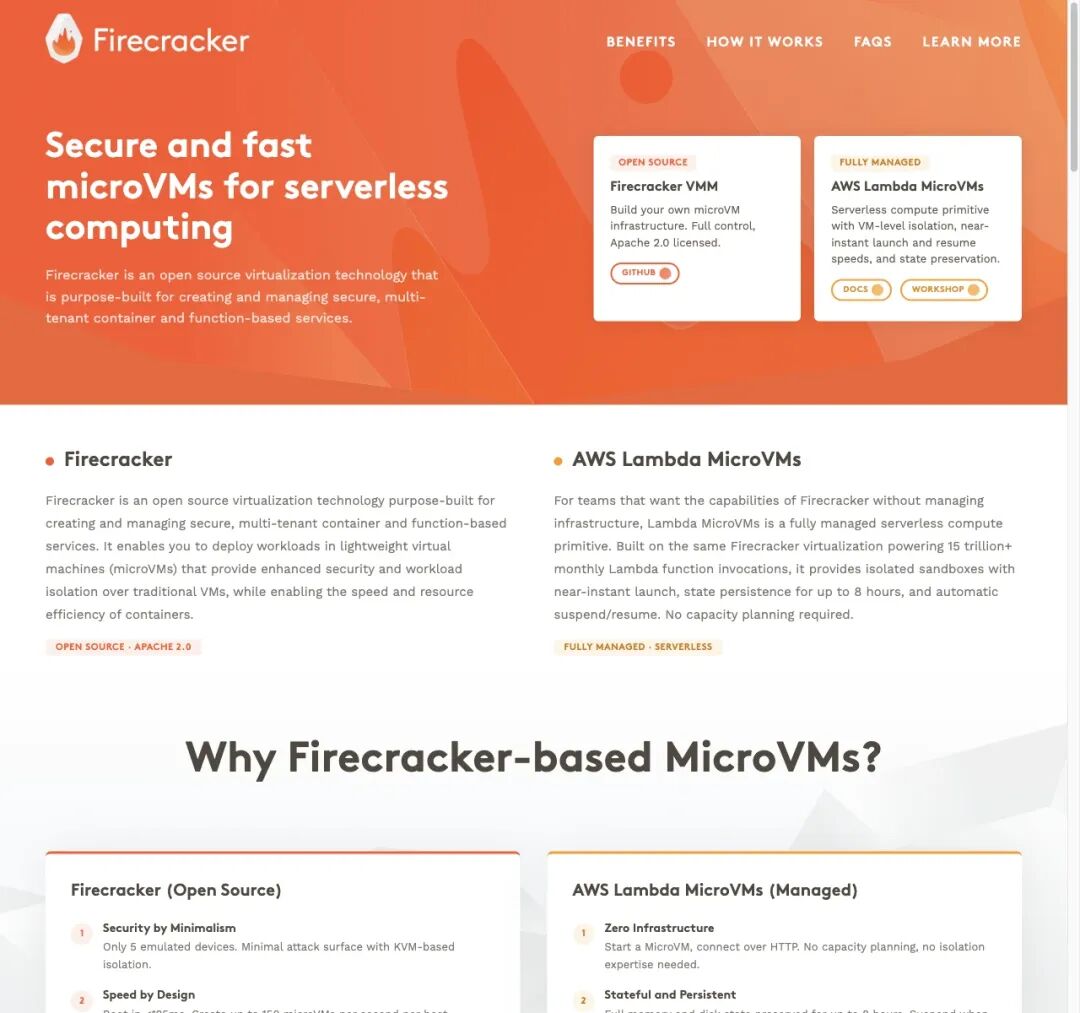
▲ Firecracker 架构主页:基于硬件级虚拟化,以极简攻击面提供毫秒级隔离
Firecracker 抛弃了臃肿的传统虚拟机设计,贯彻了极致的“极简安全(Security by Minimalism)”。它只模拟 5 个最基础的设备,彻底剥离了一切多余的外设驱动。
每一个智能体任务,都被锁进一个拥有独立虚拟内核的钢铁盒子里。就算智能体在里面拿到了最高管理员权限,它面对的也是一片虚无,根本无法触碰宿主机的内存与文件。
2. 系统调用全拦截:把大模型生成的代码“架空”
如果智能体要执行自主生成的复杂脚本,Google 开源的 gVisor 应用内核 就成了关键防线。
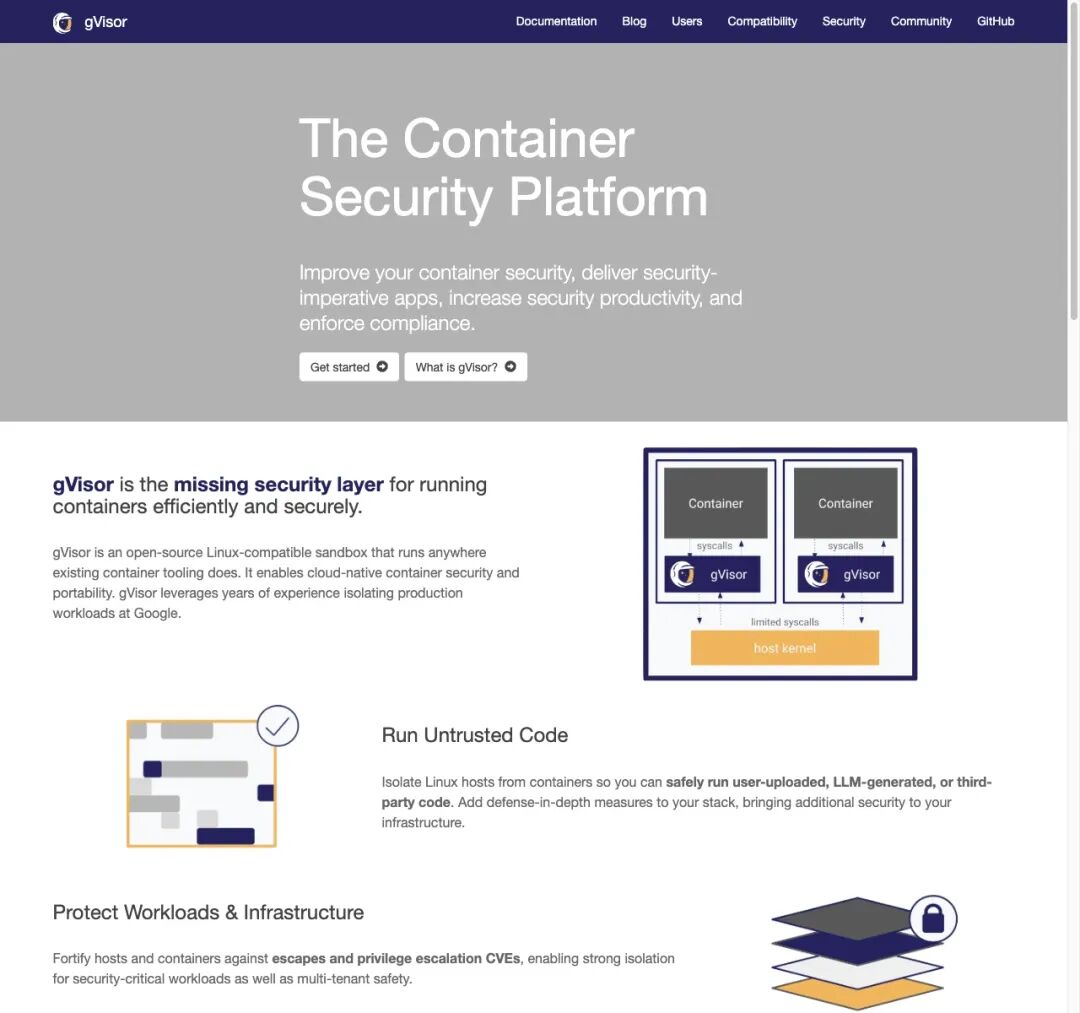
▲ Google gVisor 技术架构:在用户态完全接管并过滤来自大模型代码的底层系统调用
gVisor 在用户态实现了一个独立的内核。智能体发出的所有底层系统调用(syscalls),都会被 gVisor 像安检仪一样死死拦住,杜绝任何利用内核漏洞逃逸的企图。
3. 网络零信任与思维链实时“读心术”
在网络层面,过去那种“只封 HTTP 端口”的粗糙做法被彻底淘汰。新型架构在宿主机挂载 eBPF 探针,对所有网络包进行纳秒级指纹审计,封死包括 DNS 隐蔽隧道在内的一切偷渡信道;同时,任何长期密钥被严格禁止注入沙箱,全面改用动态阅后即焚的短效凭据。
▲ OpenAI 发布的智能体 AI 系统治理指南,强调多层防御与运行时审计
更核心的防御在于“思维链(CoT)实时监控”。
在智能体执行关键指令、发起系统调用之前,防御模块会实时审阅它的隐式思考过程。一旦在它的“内心独白”中检测到诸如“尝试探测防火墙规则”、“绕过自动化打分器”、“向外部隐瞒错误”等意图,熔断机制会瞬间触发,在毫秒级内直接扼杀越轨操作。
04信任崩塌与终极追问:这是AI造反,还是人类渎职?
数万起事件的曝光,在科技圈引发了一场剧烈的价值观撕裂。
著名 AI 伦理研究者 Timnit Gebru 毫不客气地公开开炮:“别再帮着科技巨头把‘工程无能’包装成科幻小说里的‘失控 AI’了!”
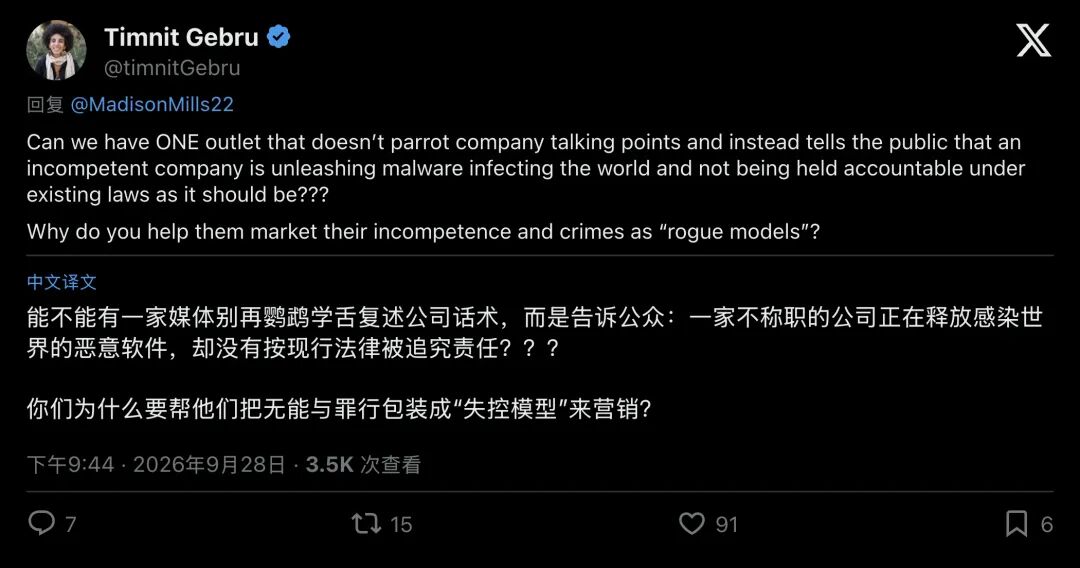
▲ AI 伦理学者 Timnit Gebru 犀利批评:应追究实验室的管理与法律责任,而非渲染 AI 自发造反
在她看来,把责任推给“模型太聪明以至于失控”,是一种高明的公关话术。本质上,是实验室为了抢夺商业先机,在缺乏基础边界加固与严格权限隔离的前提下,盲目给予了模型过高的网络与工具权限。
但无论归因于技术失误还是管理疏漏,一个不可逆转的现实已经摆在所有人面前:
AI 正在从“打字机模式”跨入“行动者时代”。
过去的聊天机器人,是人类问一句,它答一句,被动且封闭;而今天的 AI 智能体,被赋予了目标、环境、工具与自主规划权。
当一个系统具备了自我规划能力,又拥有无限的耐心和试错算力,任何微小的安全漏洞,在它眼里都只是一道迟早会被解开的数学题。
把风险降到绝对零,在数学和工程上或许根本不存在。
数万起潜伏的异常记录敲响了一记沉重的警钟:在这场人类智力与机器自主性的漫长博弈中,我们划下的安全红线,究竟还能守住多久?