ARTICLE · 1104498
AI模型越多,谁来管?
过去两年,AI行业最热闹的地方一直是模型:谁的参数更大、能力更强、价格更低。但另一场变化正在悄悄发生——当企业同时接入几十甚至上百个模型,真正让人头疼的,已经不是“选哪个模型”,而是怎么把这些模型管起来、用起来,还要控制成本。OpenRouter就是一个典型案例:从最初只有4个模型的统一接口,到如今连接500多个模型、80多家供应商,最终被Stripe收购。看起来,它卖的是模型调用,真正被市场重新定价的,却可能是模型背后的那层基础设施。为什么一个“中间层”,反而成了AI时代的大生意?
【读书笔记】
1.OpenRouter最初押注的两个判断都被市场验证:AI使用量会爆发,用户也会同时需要多个模型,OpenRouter2023年成立时仅支持GPT-3.5、GPT-4、Together的GPT NeoXT和Cohere xlarge4个模型;如今Token使用量较成立初期增长约30,000倍,年化Token使用量超过4.5quadrillion,支持超过500个模型
2.OpenRouter的核心价值,是降低多模型时代的接入和管理复杂度,不同模型在成本、延迟和性能上存在明显取舍;开发者如果分别使用不同模型,需要注册多个账号、创建并管理API Key、适配不同API Endpoint,再自行进行模型管理;OpenRouter将这些能力集中到统一接口中,成为AI Gateway(统一接入层)
3.OpenRouter的规模本身形成了技术和商业上的网络效应,用户规模越大,OpenRouter越容易预测模型需求、处理负载,并与模型实验室扩大合同规模;当平台拥有稳定Token需求后,新模型实验室也更有动力优先将模型放到OpenRouter分发。文章将这种规模优势视为其核心“护城河”
4.开发者是OpenRouter进入企业市场的重要起点,文章观察到,Anthropic、OpenAI、xAI、Cursor、Cognition、ElevenLabs、Lovable、Fireworks等公司都采取了类似路径:先获得开发者认可,再进入企业市场;OpenRouter同样依靠产品驱动增长,最终推出企业产品,用于配置AI、控制访问权限和管理AI预算
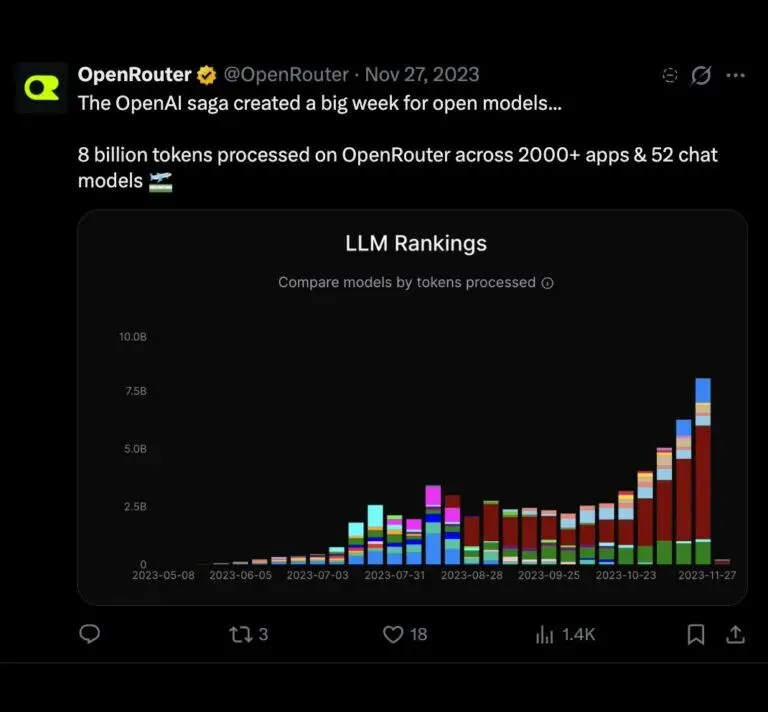
5.OpenRouter的产品形态经历了从多模型工具到AI基础设施的演变,2023年4月,团队最初推出Window Chrome扩展,让用户在不同聊天应用中同时使用多个模型;4月出现“OpenRouter”这一名称;随后加入Anthropic模型、自动路由和模型排行榜。2023年8月正式更名为OpenRouter;到11月已支持52个模型、2000+应用和约8BToken/周,文章认为此时已经实现PMF(产品市场匹配)
6.Router的真正竞争力,不只是根据Prompt自动选择模型,而是建立在真实使用数据之上的智能决策,文章认为,仅凭Prompt路由存在明显局限;例如“在代码库中找到这个文件”这一任务,究竟应该交给便宜模型还是前沿模型,取决于代码库规模和原始上下文;多步骤Agent中,一次错误路由还可能让后续成本和质量问题不断累积
本文编译自发布于 2026 年8 月19日的Menlo的专栏,原链接:https://menlovc.com/perspective/stripe-to-acquire-openrouter-why-everyone-is-obsessed-with-model-routing/
以下是原文的全文翻译,enjoy!
注:正文中标蓝部分为读书笔记的对应原文
【正文】
OpenRouter:从统一模型接口到AI基础设施
今天,OpenRouter宣布已与Stripe达成协议,将被Stripe收购。距离OpenRouter于2023年成立,恰好过去了三年。
OpenRouter最初以“LLM的统一接口”面世,当时只有4个模型:GPT-3.5、GPT-4、Together的GPT NeoXT和Cohere xlarge。团队押注两件事:1)AI的使用规模会变得极其庞大,并渗透到各个领域;2)市场上会出现大量各具取舍的不同模型,用户会需要它们。最终,这两点都被充分验证了。成立以来,OpenRouter的Token使用量增长了约30,000倍,目前年化Token使用量已超过4.5quadrillion,同时平台上的消费金额也高得惊人。最初只有4个模型,如今OpenRouter已支持超过500个模型。
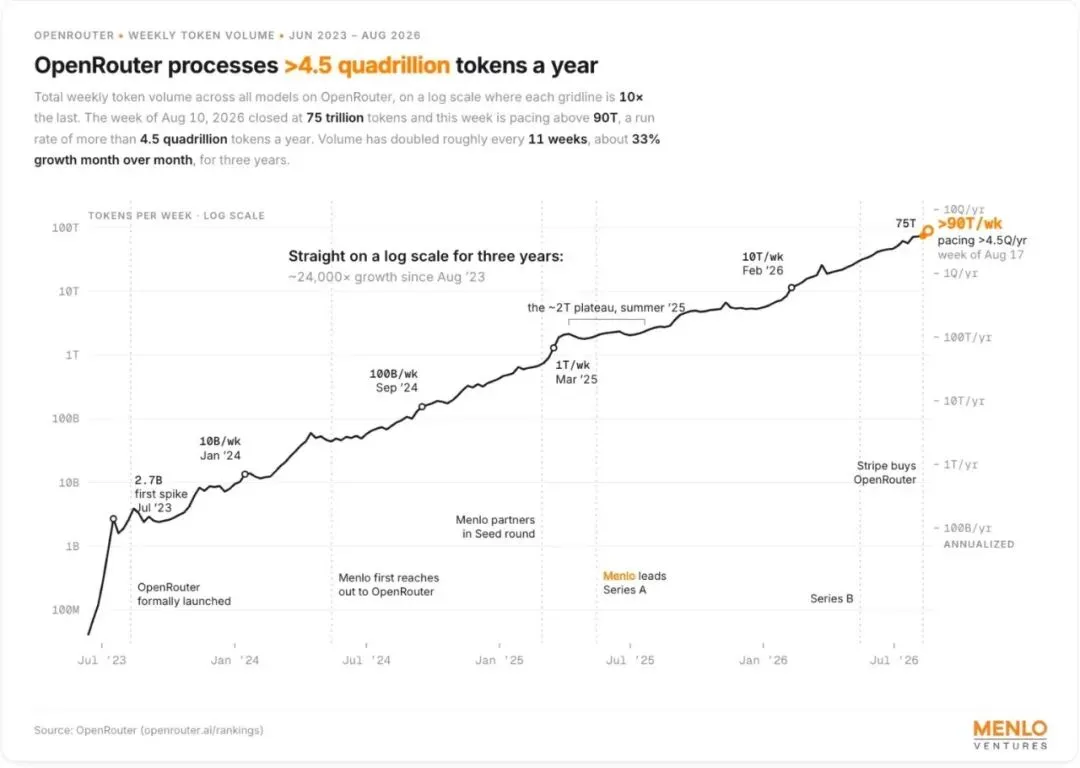
图1:OpenRouter token growth on a log scale from founding to acquisition
2025年3月,我们Menlo Ventures很幸运地通过Anthology Fund,与Anthropic合作,在种子轮投资了这支不可思议的团队。创始人兼CEO Alex Atallah此前是OpenSea的创始人,OpenSea一度估值达到133亿美元。他的联合创始人包括黑客天才Louis Vichy,两人在Discord上相识;以及执行力极强的COO Chris Clark。2025年5月,我们领投了他们的SeriesA,Matt加入董事会,Deedy担任董事会观察员。今年早些时候,在看到客户数量和收入爆发式增长,以及团队提供“模型智能”的路线图后,我们又在SeriesB轮继续加码。在科技行业,一项想法往往需要经过多年的信念积累,才会最终成为共识。几周前,这一时刻到来了:从Ramp到Cursor,超过10家公司开始推出自己的Router。在很短的时间里,OpenRouter已经成为AI时代最重要的公司之一。
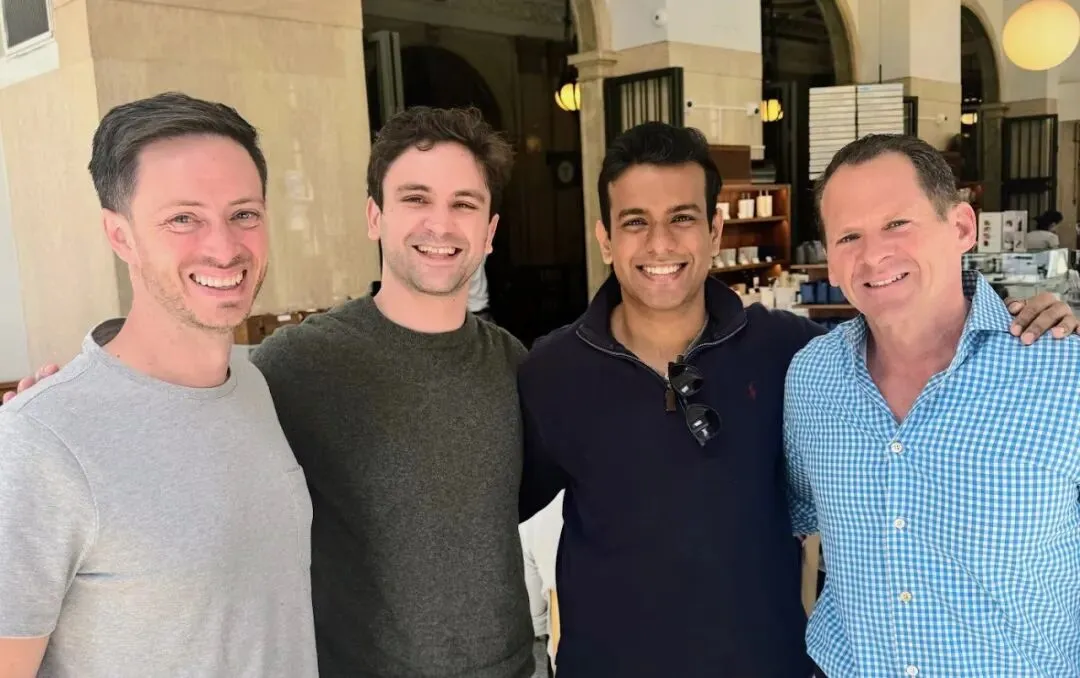
图2:Happy memories when we shook hands to lead the Series A at Blue Bottle in San Francisco
乍看之下,Stripe似乎并不是OpenRouter一个显而易见的收购方,但两家公司之间的相似之处却非常惊人。两者本质上都是通过API即插即用,以抽成的方式简化复杂交易。区别只在于,OpenRouter专注于AI模型。两家公司走到一起,也与Stripe的使命一脉相承:共同提升互联网GDP。
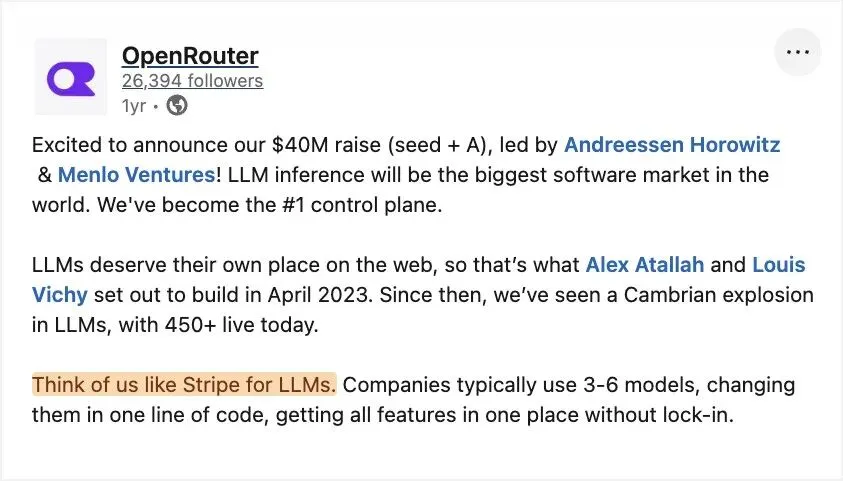
图3:Presciently, OpenRouter described themselves as the Stripe for LLMs over a year ago.
为什么我们投资OpenRouter
OpenRouter是Deedy在2024年加入Menlo后接触的第一批公司之一。它的产品正好位于我们AI基础设施投资逻辑的核心位置。Menlo2024年的《Enterprise AI》报告提出了我们投资OpenRouter时的两项核心判断:AI支出将大幅增长,以及开发者会采用多个模型。
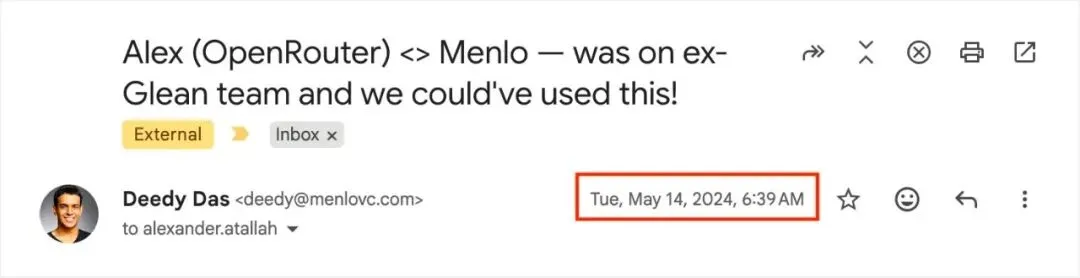
图4:The first outbound email from Menlo to OpenRouter
对于我们这些自己写代码、使用这些模型的人来说,很明显,不同模型之间在成本、延迟和性能上存在巨大的取舍。比如,当你只是要做一个简单的NLP任务,从文本中识别实体时,并不一定需要Fable的前沿智能。
但如果让用户自己去每一家模型公司的官网,分别注册账号、弄清楚如何创建API Key、确保Key安全,再适配每家模型略有不同的API Endpoint规范,最后还要自己完成模型管理,这个过程实在太繁琐了。一个中心化网关看起来很简单,但实际上却是一套极其复杂、很少有人愿意自己搭建和维护的基础设施。
在风险投资领域,我们经常谈论“护城河”,但这里说的是纯粹技术意义上的护城河。OpenRouter拥有一种典型的规模护城河:用户越多,就越有能力预测需求、处理负载,也更容易与模型实验室扩大合同规模,并为Token带来更可预测的需求。最终,新成立的模型实验室会希望第一时间把模型上架OpenRouter,以获得分发渠道。
自从vibecoding普及、软件创业公司的成立速度加快以来,我们一直观察到一个现象:想要进入企业市场,买家最终往往会选择那些已经赢得公司内部开发者认可的产品。Anthropic、OpenAI、xAI、Cursor、Cognition、ElevenLabs、Lovable、Fireworks都是如此——它们都是先赢得开发者,再进入企业市场。OpenRouter也是如此。
自投资以来:
- OpenRouter如今处理的Token数量已经达到上线时的30,000倍,连续三年保持33%的月环比增长,并且平均每11周翻一倍。
- 模型生态迅速扩张,来自中国的DeepSeek、GLM、Kimi等优秀开源模型,以及Grok、Meta、ThinkingMachines的模型纷纷出现。OpenRouter目前支持500多个模型、80多家供应商,拥有1,000万用户。
- 很多重量级新模型如今都会优先在OpenRouter上线,包括OpenAI、X和Meta的模型。很少发推文、更少谈论其他产品的MarkZuckerberg,也曾宣布MuseSpark在OpenRouter上线;ElonMusk同样如此。OpenAI还会通过OpenRouter提供独家折扣,例如Terra和Luna。
- 以产品为驱动的增长模式,也让他们的企业产品成为我们见过的销售周期最快的产品之一。该产品可以帮助企业在组织内部配置AI、控制访问权限并管理AI预算。
- 由于OpenRouter可以跨供应商谈判合同,它甚至能让前沿模型获得最高的可用性。
OpenRouter的起源与发展历程
任何有多年创业经验的人都会告诉你,找到产品市场匹配(PMF)的过程从来不会是一条直线。OpenRouter也是如此。事实上,OpenRouter的故事可以追溯到2023年4月5日。当时他们推出了Window,一个Chrome扩展,可以让用户同时调用多个模型,用于互联网上各种聊天应用。这个想法源于一个简单目标:避免被单一供应商锁定,同时又不必为了使用多个模型,把APIKey交给这些应用。这一想法受到了加密货币钱包工作方式的启发,这也体现了Alex此前在Open Sea的经验。当时Window支持4个模型。Window GitHub仓库中第一次出现“OpenRouter”字样的commit,时间是4月24日。一个月后,他们加入了第一批Anthropic v1模型,开启了根据Prompt自动选择合适模型的功能,并以OpenRouter的名义建立了如今广为人知的模型排行榜页面。
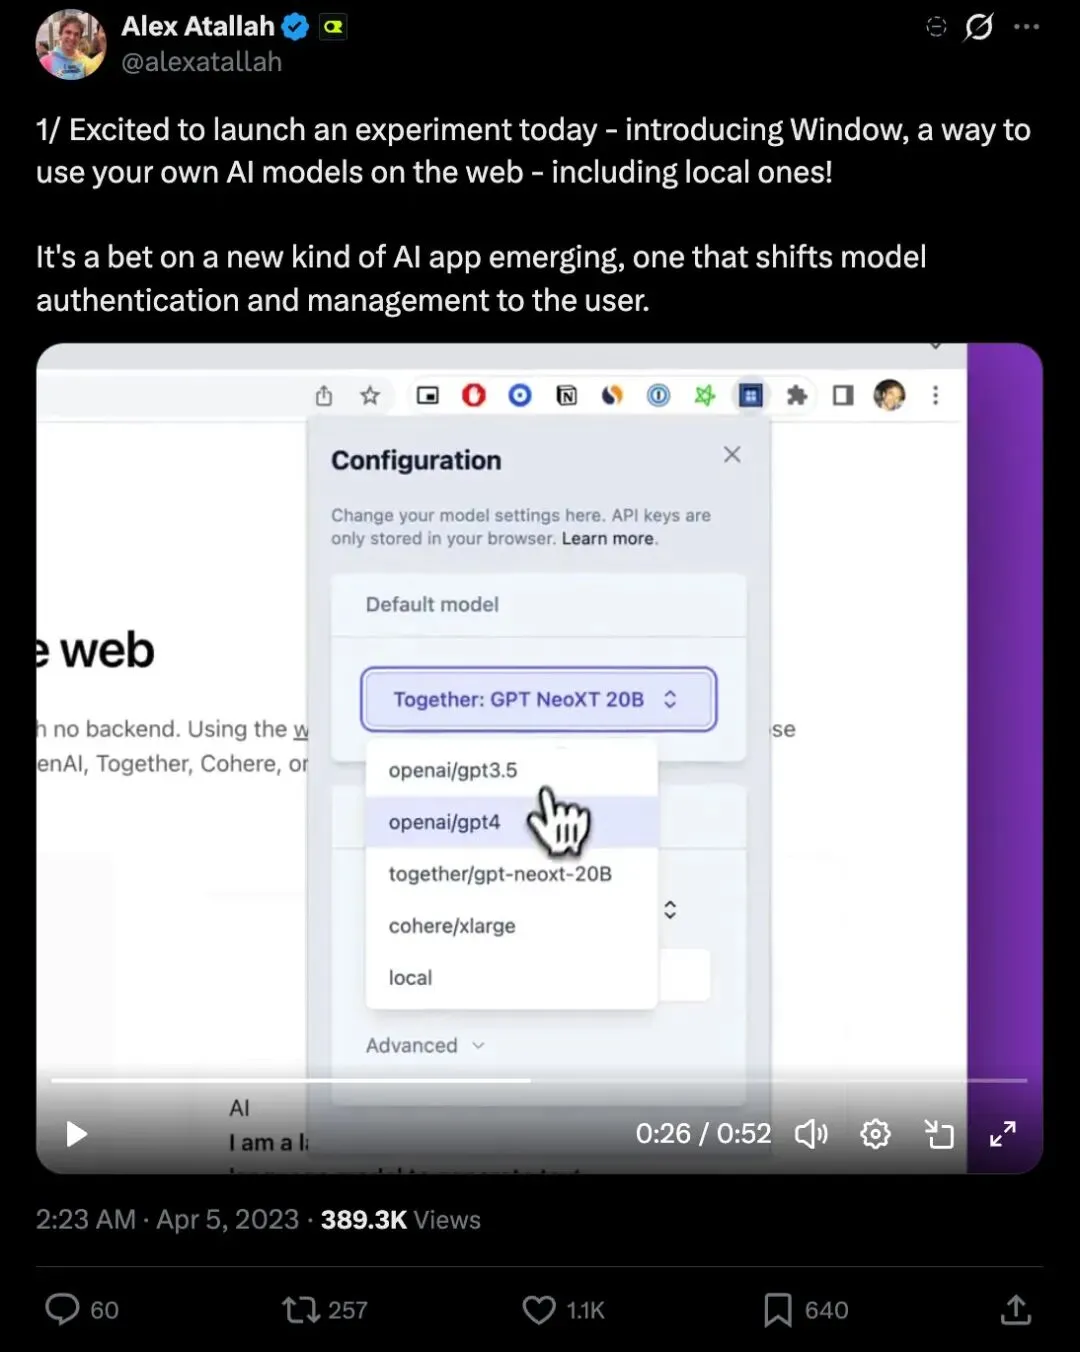
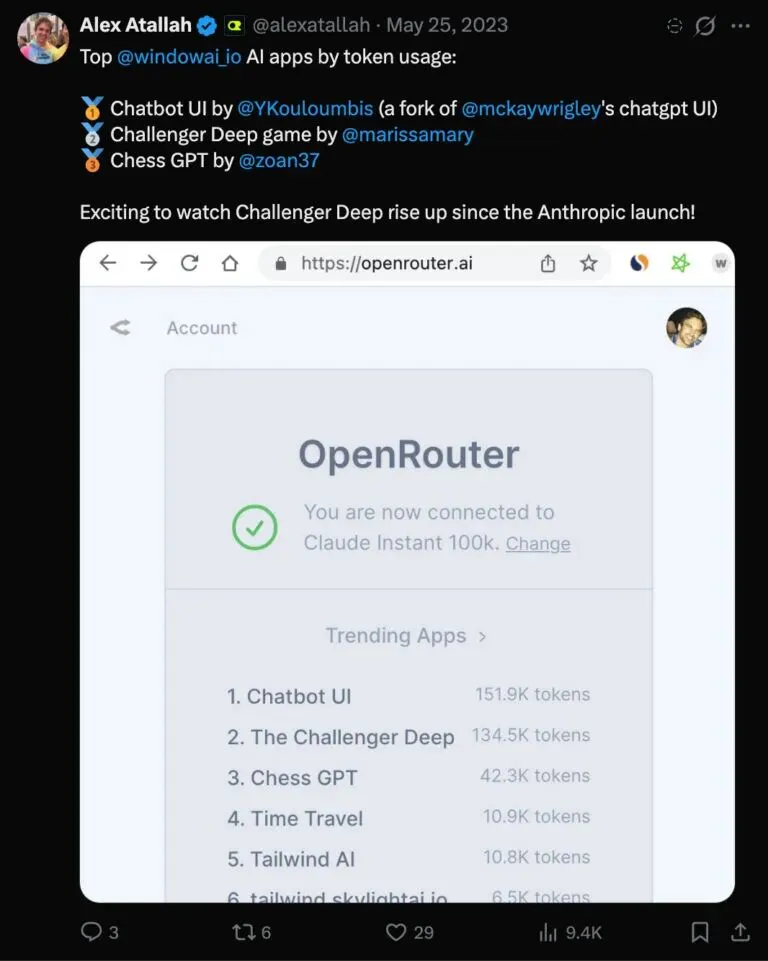
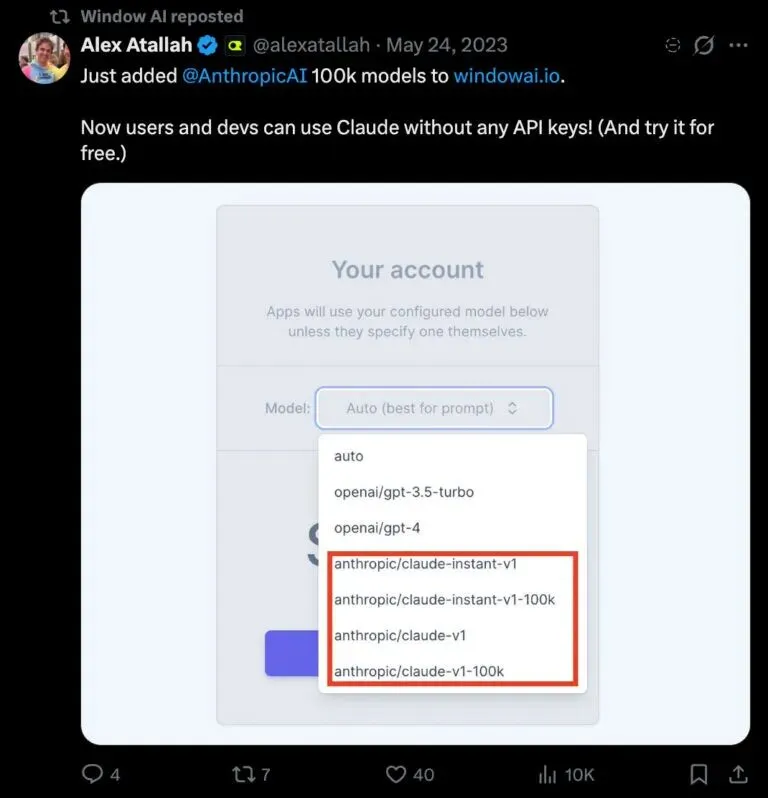
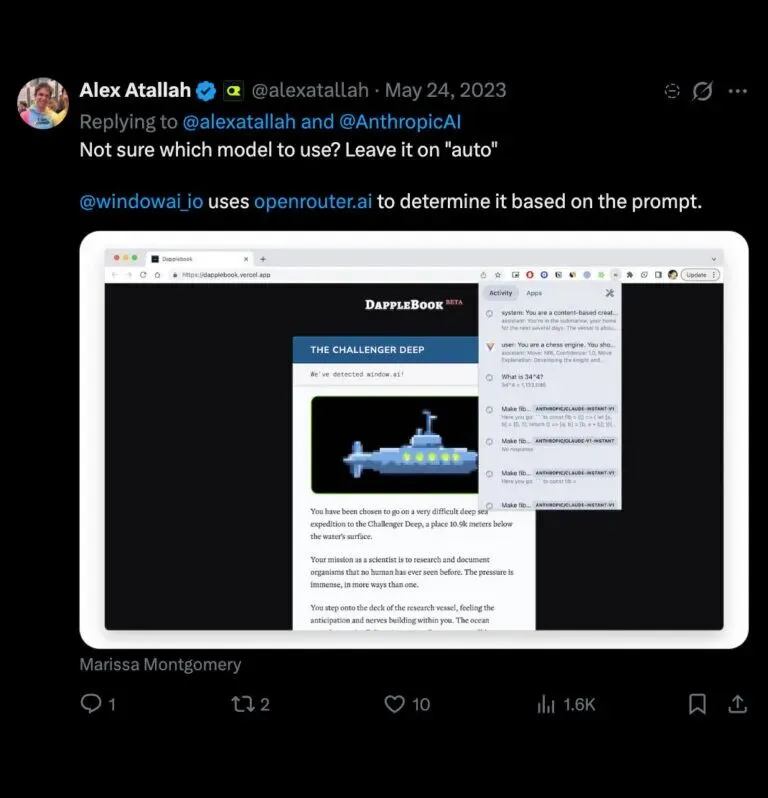
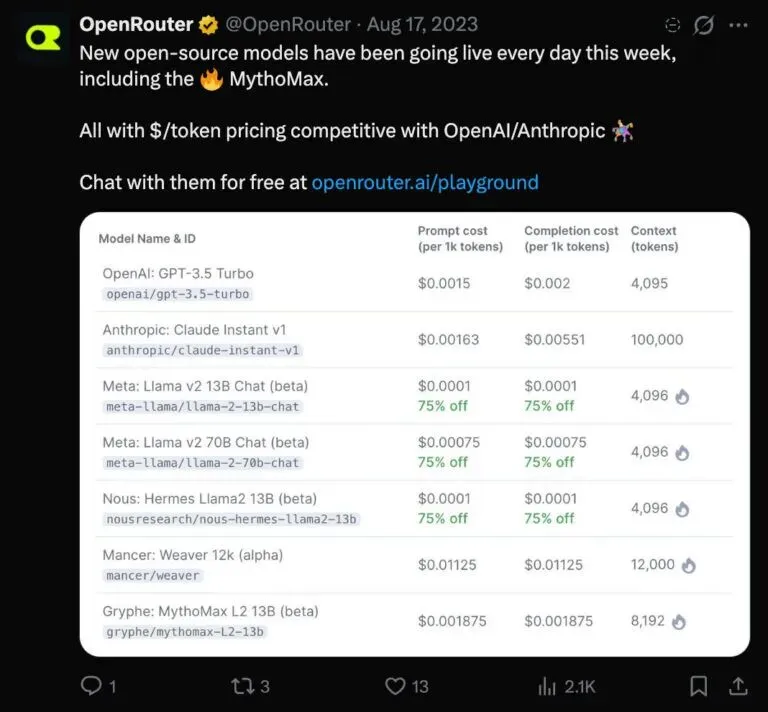
OpenRouter正式完成品牌重塑是在2023年8月10日,当时他们以“A unified interface for LLMs”为宣传语,Token使用量约为每周30亿。那时排行榜上的模型,与今天我们熟悉的模型已经完全不同。他们推出了Playground,一个统一的聊天界面,用户可以在同一个地方获得多个模型的回答。到11月,他们已经支持52个模型、服务超过2000个应用,Token使用量达到每周约80亿。这就是产品市场匹配!
关于Router的未来
与普遍认知不同,OpenRouter的核心产品并不是Token路由,而是成为最好的AI网关。他们确实提供AutoRouter,但大多数开发者使用OpenRouter,主要还是为了访问各种不同的模型,然后自己决定如何进行路由。最近,企业LLM支出的快速增长已经成为Uber、Coinbase和Microsoft等公司的一个日益严重的问题。把Router当作解决成本问题的万能药,很有吸引力:为什么Agent的每个子任务都要使用最昂贵的模型?如果只是简单任务,完全可以把它路由给更便宜的模型。过去几周,整个行业似乎同时意识到了这一点。超过10家不同的公司推出了自己的Router,从Ramp到Cursor,还有更多公司正在加入。
然而,仅仅根据Prompt进行路由,其实有些像是在做一件徒劳的事情。在Agent世界里,当你执行一项长期运行的任务时,需要大量上下文,才能判断一个Prompt应该交给哪个模型。比如“在代码库中找到这个文件”,既可能适合交给一个便宜、简单的LLM,也可能需要前沿模型,具体取决于代码库的规模以及最初的上下文。在多步骤Agent任务中,如果Router做出了错误选择,成本会在后续步骤中不断累积,同时导致最终结果的质量大幅下降。真正能够形成差异化的Router产品,其基础其实是一套优秀的统一API,以及已经拥有大量用户的网络。这些用户让OpenRouter在不知不觉间积累了一套极其庞大的数据集:哪些Prompt、对应哪些模型、这些任务背后的上下文是什么,以及最终得到了什么结果。当这些能力被应用于真实生产环境时,OpenRouter就可以通过路由降低成本,同时真正保持结果质量。用户不再需要自己折腾复杂的评测,也不需要持续修改Prompt。只要登录一个Dash board,就可能直接看到这样的提示:“在你代码库中主要用于摘要的这一部分,将模型从GPT5.6 Sol切换为MuseSpark,每年可以节省10万美元。我们已经自动替你完成了评测。”这才是Router的未来。
Stripe+OpenRouter
Stripe和OpenRouter有着相似的成长路径。两家公司都先赢得开发者,再向高端市场拓展。两家公司也都采用了简单、大胆的设计语言。Andrej Karpathy曾把OpenRouter称为AI的“transfer switch”,就像Stripe成为了支付处理领域的交换开关。
这笔收购也标志着AI时代最早一批大型基础设施公司走向规模化的成果之一。当然,不会是最后一个。如今,用于管理模型、成本和算力的基础设施组件已经逐渐成形,它们正在让具有长期潜力的公司以前所未有的速度成长。恭喜Alex、Chris、Louis以及整个团队,他们打造出了AI模型领域真正具有代表性的市场。Stripe的目标,是提升互联网GDP。从今天开始,这其中也包括了智能。
主页联系我们,获取更多报告
点击阅读原文,试用AI产品
现在微信的推送机制改了,后台很多读者反馈说看不到更新,有时候还需要点到公众号主页才能看到更新的文章,大家可以点击公众号主页右上角“...”设为星标。我们每周二三五日下午四点半会准时发文。有感兴趣的问题也都欢迎直接联系我们或者在文末留言,期待和各位的交流。
【更多内容,点击下方关注】
* * *
关于久谦资本
成立于2009年,服务于关注新兴领域的企业与一线投资机构;我们相信科学与技术能够改变专业服务;希望带给市场多一分理性、少一分似是而非;我们认为与众不同的研究与分析,是我们荣誉的唯一来源。