ARTICLE · 1108971
深入 vLLM 源码:一个基座模型如何同时服务上百个 LoRA?——LoRAModelManager 全解析
深入 vLLM 源码:一个基座模型如何同时服务上百个 LoRA?——LoRAModelManager 全解析
本文基于 vLLM main 分支(2026 年 10 月)的
vllm/lora/model_manager.py源码分析。
一、背景:为什么需要 Multi-LoRA Serving
LoRA(Low-Rank Adaptation)已经成为大模型微调的事实标准:冻结基座权重 W,只训练两个低秩矩阵 A(r × d_in)和 B(d_out × r),推理时输出变为:
y = W·x + B·(A·x)在企业场景中,常常是一个基座模型 + 大量业务 LoRA:客服一个、法务一个、代码一个……如果每个 LoRA 都单独部署一份完整模型,显存成本是不可接受的。
vLLM 的解法是:基座权重只存一份,多个 LoRA 的 A/B 矩阵常驻 GPU 的固定"槽位"(slot),同一个 batch 内的不同请求可以使用不同 LoRA,一次前向全部算完。
而负责调度这一切的核心组件,就是 LoRAModelManager。
二、整体架构一览
model_manager.py 中主要有三个角色:
LoRAModelManager | |
LRUCacheLoRAModelManager | |
create_lora_manager() |
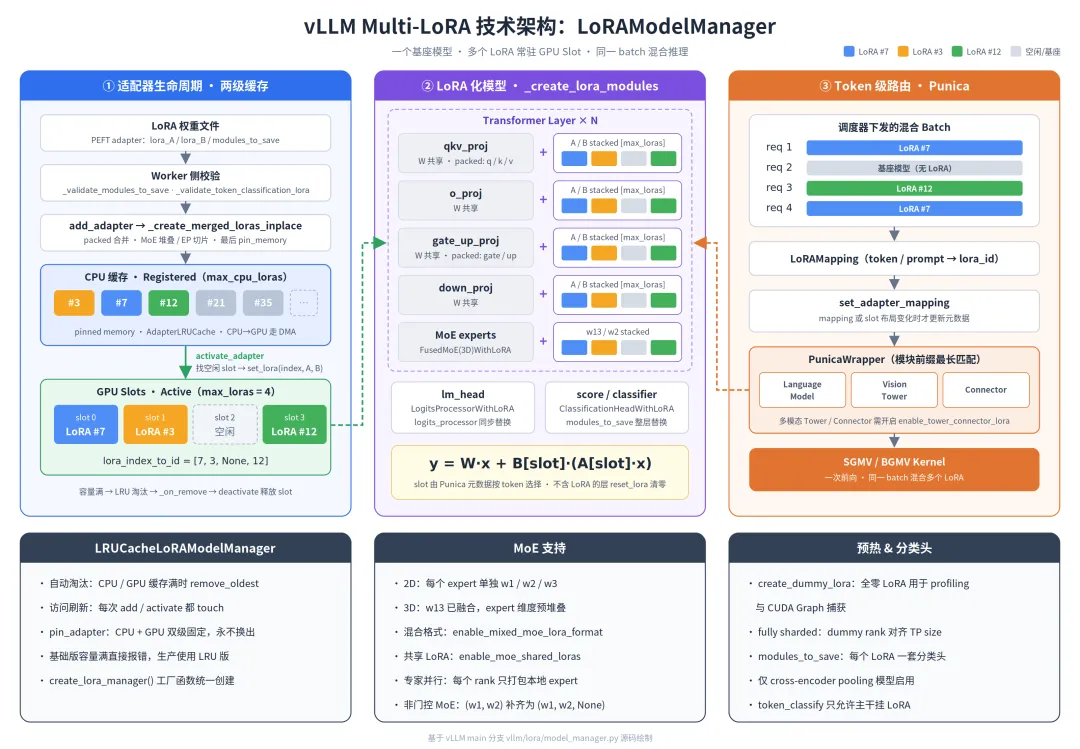
一个 LoRA 从磁盘到参与计算的完整链路如下:
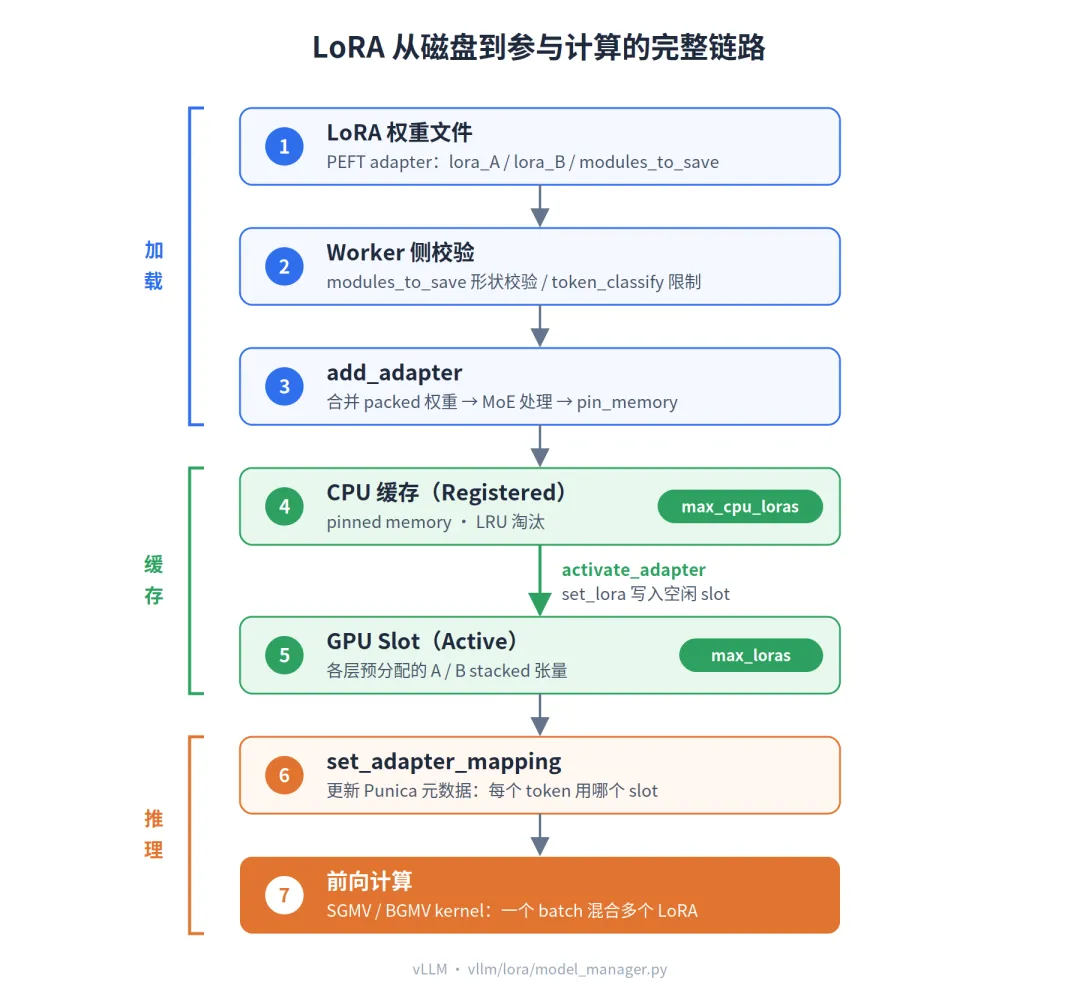
下面逐一拆解。
三、第一步:把模型"改造"成 LoRA-Ready
LoRAModelManager 在构造时会调用 _create_lora_modules(),遍历模型所有子模块,把符合条件的层原地替换为带 LoRA 能力的包装层(BaseLayerWithLoRA 的子类)。
for module_name, module in self.model.named_modules(remove_duplicate=False):if isinstance(module, PPMissingLayer):continue ... new_module = from_layer( module, self.lora_slots, self.lora_config, packed_moduled_lst, self.model.config, ) new_module = replace_submodule(self.model, module_name, new_module)这里有几个值得关注的细节:
1. 目标模块筛选
未指定 target_modules时,使用模型声明的supported_lora_modules;指定了 --lora-target-modules时,只包装命中的模块,可以减少显存占用。
2. Packed 模块处理
vLLM 为了性能会把多个线性层合并,例如 q_proj/k_proj/v_proj 合并为 qkv_proj,gate_proj/up_proj 合并为 gate_up_proj。而 PEFT 训练出的 LoRA 权重是按原始子模块分开保存的。_register_packed_modules() 会记录这种"一对多"的映射关系,供后续权重合并使用。
3. 别名模块去重
某些模型中同一个模块会挂在两条路径上(例如 MoE 的 gate 同时被 block 和 MoE runner 引用)。代码用 wrapped_by_id 按对象 id 去重,让别名路径指向同一个包装层,而不是重复注册——否则激活时别名会调用 reset_lora 把刚写入的权重清空。
4. lm_head 的特殊处理
如果 lm_head 被包装,对应的 logits_processor 也会被替换为 LogitsProcessorWithLoRA。
四、第二步:两级缓存——CPU 注册与 GPU 激活
这是整个设计最核心的部分。管理器维护了两个 LRU 结构:
self._registered_adapters: AdapterLRUCache[LoRAModel] = AdapterLRUCache( self.capacity, self.deactivate_adapter # max_cpu_loras)self._active_adapters: AdapterLRUCache[None] = AdapterLRUCache( self.lora_slots, self._deactivate_adapter # max_loras)self.lora_index_to_id: list[int | None] = [None] * self.lora_slotsmax_cpu_loras | |||
max_loras |
lora_index_to_id 是一张 slot 表,记录"第 i 个 GPU slot 当前放的是哪个 LoRA"。
AdapterLRUCache 重写了 _on_remove 钩子:一个 LoRA 被移出缓存时,会自动触发对应的 deactivate 逻辑,保证 slot 表与缓存状态一致。
注册:add_adapter
defadd_adapter(self, adapter: LoRAModel) -> bool:if adapter.id in self._registered_adapters:returnFalseif len(self._registered_adapters) >= self.capacity:raise RuntimeError("No free adapter slots.") self._add_adapter(adapter)returnTrue真正的工作在 _create_merged_loras_inplace() 中完成:
把 q/k/v等子模块的 LoRA 权重打包成PackedLoRALayerWeights,与 vLLM 合并后的层对齐;对 MoE 模型做专家维度的堆叠、格式转换或 EP 切片; 最后才执行 pin_memory()。
源码注释解释了为什么 pin 要放在最后:MoE 模型的 LoRA 权重数量很多,加载后立即 pin 开销很大;而且打包操作(如 pack_moe)会产生新张量,之前的 pin 会失效。
Pinned memory 的作用是让后续 CPU→GPU 拷贝走 DMA,加快激活速度。
激活:activate_adapter
defactivate_adapter(self, lora_id: int) -> bool:if lora_id in self._active_adapters:return False first_free_slot = next( ((i, lora_id) for i, lora_id in enumerate(self.lora_index_to_id)if lora_id is None),None, )if first_free_slot is None:raise ValueError("No free lora slots") index, _ = first_free_slot ...for module_name, module in self.modules.items(): module_lora = self._get_lora_layer_weights(lora_model, module_name)if not module_lora: module.reset_lora(index)continue module.set_lora(index, module_lora.lora_a, module_lora.lora_b)逻辑很直接:找到第一个空闲 slot,遍历所有 LoRA 层,把该 LoRA 的 A/B 矩阵拷贝进每一层预分配好的 lora_a_stacked / lora_b_stacked 张量的第 index 个位置。
如果某层在这个 LoRA 中没有权重,就调用 reset_lora(index) 清零,避免残留上一个占用者的数据。
一个容易踩坑的点:如果一个 LoRA 激活后没有任何层被写入权重,代码只会打一条 debug 日志,请求会静默退化为基座模型输出。通常是
--lora-target-modules配置与 adapter 不匹配导致的。在 PP / EP 并行场景下,某些 worker 上出现这种情况则是正常的。
五、第三步:Token 级路由——Punica Wrapper
GPU 上已经放好了多个 LoRA,怎么让 batch 中的每个 token 用上正确的那个?答案是 Punica——一组专门为多 LoRA 批量计算设计的 kernel(SGMV / BGMV)。
set_adapter_mapping() 负责把调度器给出的"请求→LoRA"映射,转换为 Punica kernel 需要的元数据:
defset_adapter_mapping(self, mapping: LoRAMapping) -> None: slot_layout = tuple(self.lora_index_to_id)if self._last_mapping != mapping or self._last_slot_layout != slot_layout: self._set_adapter_mapping(mapping) self._last_mapping = mapping self._last_slot_layout = slot_layout注意这里的缓存判断同时比较了 mapping 和 slot 布局。源码注释特意说明:一次带外的 add_lora() 可能触发 LRU 淘汰并重新分配 slot,而此时正在运行的 batch 的 mapping 并没有变化。如果只比较 mapping,就会用过期的 slot 索引去计算,结果是请求被路由到错误的 LoRA。这是一个非常隐蔽的正确性问题。
所有 LoRA 层共享同一个 Punica wrapper 实例(通过引用),所以元数据只需更新一次,所有层就都能看到。
六、多模态模型:按子模型分配 Wrapper
对于多模态模型(如 Qwen-VL 系列),视觉编码器(tower)、连接层(connector)、语言模型的 token 数量和 batch 结构完全不同,不能共用一套元数据。
_maybe_init_mm() 为它们分别创建 Punica wrapper:
语言模型 wrapper:按 max_num_batched_tokens分配;Tower wrapper:按多模态 encoder 的 token 预算分配, max_batches = max_num_seqs × 每个 prompt 最多的多模态条目数;Connector wrapper:需要模型实现 get_num_mm_connector_tokens(),否则自动禁用。
模块与 wrapper 的匹配采用最长前缀优先:
for prefix in sorted(self.punica_wrapper_mapping.keys(), key=len, reverse=True):if module_name.startswith(prefix):return self.punica_wrapper_mapping[prefix]这样 visual.merger 会优先匹配到 connector,而不是被更短的 visual. 前缀吞掉。
Tower / Connector LoRA 需要通过 enable_tower_connector_lora=True 显式开启,目前官方仍标注为实验性功能。
七、MoE 模型:最复杂的部分
MoE 是这个文件中代码量最大的部分,主要应对以下几种情况:
1. 2D 与 3D 权重格式
2D 格式:每个 expert 的 w1/w2/w3单独保存一份 LoRA;3D 格式:所有 expert 的权重已在磁盘上堆叠成一个 3D 张量,且 w1/w3已融合为w13。
模型的格式标记决定使用 FusedMoEWithLoRA(2D)还是 FusedMoE3DWithLoRA(3D)。
2. 混合格式(enable_mixed_moe_lora_format)
开启后强制使用通用的 2D 包装层,遇到 3D 格式的 adapter 时通过 _convert_3d_to_2d_moe_lora() 拆分,使两种格式的 LoRA 可以共存于同一个服务。
3. 共享 expert LoRA(enable_moe_shared_loras)
w13 的 lora_A 和 w2 的 lora_B 在所有 expert 之间共享,以预堆叠形式存储,大幅减少参数量。
4. 专家并行(EP)
开启 EP 后,每个 rank 只持有部分 expert。_restrict_to_local_experts() 和 _slice_moe_lora_ep() 确保每个 rank 只打包本地 expert 的 LoRA 权重,并在打包后立即释放非本地 expert 的数据,避免 CPU 内存浪费。
5. 非门控 MoE
部分模型(如 Nemotron-H)的 expert 只有 w1/w2 没有 w3。_pad_lora_pairs_to_triplets() 把二元组补齐为 (w1, w2, None),以复用统一的 pack_moe 逻辑。
八、新特性:分类头整层替换(modules_to_save)
最新代码中新增了一项实用能力,面向 cross-encoder 类型的 pooling 模型(如 Reranker、文本分类模型)。
用 PEFT 训练分类任务时,分类头(score / classifier)通常不做低秩分解,而是通过 modules_to_save整层保存——因为不同任务的标签数量本来就不同,低秩增量无法表达。
vLLM 现在支持每个 LoRA 携带自己的一整套分类头:
self.supported_modules_to_save = ( {"score", "classifier"}if self.is_pooling_modeland vllm_config.model_config.score_type == "cross-encoder"else set())实现要点:
包装:分类头使用 from_layer_classification()包装为ClassificationHeadWithLoRA,并通过pooler.replace_classifier()替换原分类器;分类头不受target_modules过滤约束;激活:在 activate_adapter中调用set_module_to_save(index, weight, bias)把整层权重写入 slot;路由:在 _set_adapter_mapping中按 prompt 粒度调用set_output_mapping(),让每个请求的输出走对应 LoRA 的分类头,未使用 LoRA 的请求映射为-1(走基座分类头);校验:加载时由 worker 调用两个校验函数: _validate_modules_to_save():检查权重形状必须为(1..max_lora_cls_labels, input_size),bias 与输出维度匹配;_validate_token_classification_lora():token_classify任务只允许在主干网络上挂 LoRA,若 adapter 带了分类头权重则直接报错。
这意味着可以用一个基座 Reranker 同时服务多个领域定制的打分头,且每个打分头的标签数可以不同。
九、LRUCacheLoRAModelManager:生产环境的选择
基础版管理器在容量满时会直接报错。生产中实际使用的是它的子类 LRUCacheLoRAModelManager:
defactivate_adapter(self, lora_id: int) -> bool:if (lora_id notin self._active_adaptersand len(self._active_adapters) >= self.lora_slots): self._active_adapters.remove_oldest() result = super().activate_adapter(lora_id) self._active_adapters.touch(lora_id)return result核心改进:
自动淘汰:GPU slot 满时淘汰最久未用的 LoRA;CPU 缓存同理; 访问刷新:每次 add / activate 都会 touch,更新 LRU 顺序;Pin 固定: pin_adapter()会同时在 CPU 和 GPU 两级缓存中固定某个 LoRA(必要时先激活),保证高频 LoRA 永不被换出。
十、预热:Dummy LoRA
vLLM 启动时需要做 profiling 和 CUDA Graph 捕获,此时还没有真实的 LoRA。create_dummy_lora() 会根据每个已包装层的实际形状,生成全零的 LoRA 权重,覆盖普通线性层、packed 层、embedding、lm_head 以及 2D/3D MoE 等所有情况。
get_dummy_lora_warmup_rank() 则处理一个边界情况:fully sharded 的 MoE 层会沿 rank 维度切分 W13,因此 dummy rank 必须是 TP size 的倍数,否则需要向上取整(且不能超过 max_lora_rank)。
十一、关键参数与调优建议
--max-loras | ||
--max-cpu-loras | ||
--max-lora-rank | ||
--lora-target-modules | ||
--fully-sharded-loras |
十二、总结
LoRAModelManager 的设计可以归纳为三句话:
空间换时间:启动时为每个 LoRA 层预分配 max_loras个 slot,运行时只做权重拷贝,不做内存分配;两级缓存:CPU pinned memory 作为热备池,GPU slot 作为工作集,配合 LRU 和 pin 策略平衡命中率与显存; Token 级路由:借助 Punica kernel,一个 batch 内不同请求使用不同 LoRA,一次前向完成计算。
在此之上,它还处理了多模态子模型隔离、MoE 的多种权重格式与专家并行、分类头整层替换等大量工程细节。对于想要在单卡/单集群上承载大量业务定制模型的团队,理解这套机制是做好容量规划和性能调优的基础。
如果你在使用 vLLM Multi-LoRA 时遇到问题,欢迎留言交流。