ARTICLE · 1110189
怎样把一句工作要求变成AI真正能执行的任务?
QUOTE
不要先问 Prompt 怎么写,先问这项工作到底怎样才算完成。
本栏目:把agent搭起来
上一篇,我们把三个经常混在一起的概念拆开了:
Prompt、Workflow、Agent。
简单来说:
Prompt解决一个任务。 Workflow解决一套流程。 Agent解决一个需要动态决策的目标。
但不管最后用哪一种,有件事都绕不过去:
你到底要让AI干什么?
这句话看起来很简单。
实际上,我觉得很多AI任务从第一步就已经出了问题。
比如我们经常会对AI说:
帮我分析一下客户。
帮我研究一下竞争对手。
帮我看看这个产品有什么问题。
帮我写一个营销方案。
人听起来似乎都能明白,可是如果真的准备把这些任务交给一个Agent长期执行,这些要求其实都太模糊了。
所以今天先不搭Agent,我们先练一个可能比搭Agent更重要的能力:
把一句“人话”,变成AI真正可以执行的任务。
本文看点
01
模糊要求为什么不够
02
AI 任务卡的五个要素
03
怎样判断任务真的完成
01
先看一句非常常见的工作要求
假设老板告诉你:帮我研究一下竞争对手。
如果这是交给一个有经验的员工,他可能会继续问:
研究谁?
研究什么?
为了什么决策?
看产品还是价格?
看国内还是国外?
最后要给我什么?
什么时候要?
但如果我们直接把这句话扔给AI:帮我研究一下竞争对手。
AI通常也会给我们一个答案。
而且很可能写得挺像那么回事。
问题恰恰就在这里。
AI有答案,不代表任务完成了
因为我们甚至还没有定义:
什么叫“研究完成”?
02
先让AI执行这个模糊任务看看
比如我们经营一家女性服装品牌。
直接问AI:帮我研究一下我们的竞争对手。
AI可能回答:
市场竞争激烈;
消费者越来越重视品质;
社交媒体营销很重要;
建议加强品牌差异化;
可以关注价格、产品和渠道。
这些话可能都没错。
但老板看完以后很可能还是不知道:所以我下一步该干什么?
问题不是AI不会写。
问题在于:
我们没有给它一个真正的任务
03
什么才算一个“可以执行的任务”?
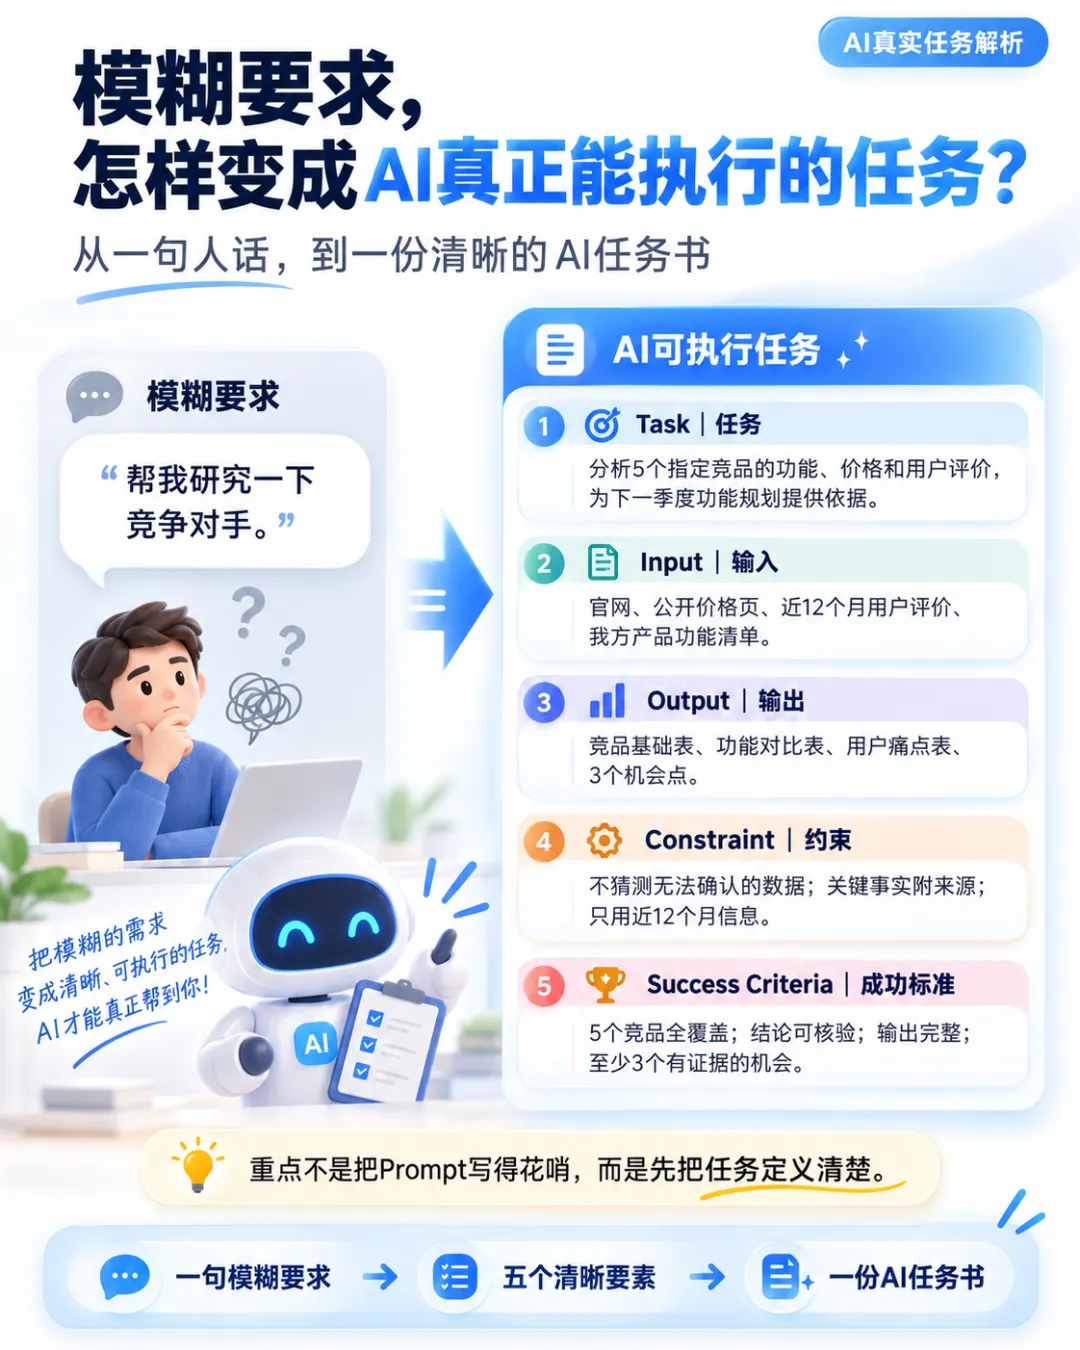
我现在习惯把一个AI任务至少拆成5部分:
Task:任务是什么?
Input:它可以使用什么输入?
Output:最后必须交付什么?
Constraint:哪些事情不能做?
Success Criteria:什么情况才算完成得好?
可以记成:
Task
+
Input
+
Output
+
Constraint
+
Success Criteria
这5个东西一旦清楚:
一句模糊要求才开始变成真正的:
AI任务
04
第一个:Task——到底要完成什么?
还是:研究竞争对手。
这不是一个足够好的Task。
因为“研究”太宽了。
我们继续往下问:研究完以后,我准备拿这个结果干什么?
假设答案是:我要决定自己产品下一季度应该重点优化哪些功能。
那任务就可以改成:
分析5个主要竞争产品的核心功能、价格和用户评价,找出它们共同做得好的地方以及用户最不满意的问题,为下一季度产品功能规划提供依据。
是不是一下清楚很多?
Task最重要的不是写得长。
而是回答:
这个任务最终要帮助谁做什么决定?
例如:
差的任务:分析客户反馈。
更好的任务:从最近100条客户反馈中找出出现频率最高、影响核心体验的5个问题,帮助产品经理确定下一版本优先级。
差的任务:做市场研究。
更好的任务:分析当前国内5个主要竞品的定价方式,帮助我们确定新产品的首发价格区间。
目标不同:
Agent的工作方式也会完全不同。
05
第二个:Input——AI到底允许使用什么?
这个问题经常被忽略。
比如我们说:分析用户投诉。
那么:
用户投诉在哪里?
100条还是10000条?
Excel?
邮件?
聊天记录?
是不是可以搜索互联网?
能不能读取公司历史资料?
这些都属于:
Input
还是竞品研究的例子。
我们可以规定:
输入包括: 1. 5个指定竞争对手名称; 2. 官方网站; 3. 产品价格页; 4. 最近一年公开用户评价; 5. 我们自己的产品功能清单。
这时候AI已经知道:我的“原料”是什么。
06
为什么Input特别重要?
因为如果不规定Input:
AI很容易自己补东西。
比如你问:这个品牌消费者最不满意什么?
AI可能根据:
训练数据。
网络印象。
常见行业问题。
甚至自己的推断。
给你一份看起来很合理的答案。
但是在真实工作中,我们真正想知道的是:你的判断来自哪里?
所以Input其实还隐含了一个非常重要的概念:
证据边界
例如可以规定:
「用户满意度判断只能来自提供的用户评价,不允许根据品牌知名度自行推断。」
这句话就已经开始提高任务可靠性了。
07
第三个:Output——最后到底要给我什么?
这一点对Agent尤其重要。
很多人给AI布置任务的时候只说:帮我分析一下。
但没有说:最后交什么。
于是AI可能给:一篇长文章。
也可能给:几个Bullet Point。
还可能:写一份3000字报告。
人就只能再说:帮我整理一下。
如果这是Agent系统,这种不确定性会非常麻烦。
08
把Output提前定义好
例如竞品研究要求最后必须输出:
表1|竞品基本情况
表2|功能比较
表3|用户主要不满
最后再给:3个最值得关注的竞争机会。
这时候:AI不只是知道“要分析”。
还知道:
最终要交什么作业
09
Output最好尽量结构化
这也是以后做Workflow和Agent很重要的一点。
例如:
competitor_name
positioning
price
strengths
weaknesses
evidence
为什么结构化重要?
因为下一步可能还有别的系统要使用这个结果。
比如:
Research Agent
↓
结构化竞品数据
↓
Analysis Agent
↓
机会判断
↓
Report Agent
↓
生成报告
如果第一步输出完全自由:
第二步就很难稳定处理。
所以从这一篇开始,可以逐渐建立一个认知:
给人看的答案可以很漂亮,给系统使用的答案最好很结构化。
10
第四个:Constraint——哪些事情不能做?
这是很多Prompt里容易遗漏的。
任务不仅需要告诉AI:做什么。
还要告诉它:
不要做什么
比如竞品研究:
不允许猜测无法确认的价格。
没有来源的数据标记“无法确认”。
不得用两年前的信息冒充当前信息。
用户评价只统计给定时间范围。
不要因为单条评价就得出整体结论。
这些都属于:
Constraint
11
为什么Agent比普通聊天更需要Constraint?
因为普通聊天中:
AI回答不好,我们可以重新问一次。
但是Agent开始拥有:
工具。
权限。
自动执行。
甚至可以修改外部系统。
这时候:不要做什么
和:做什么
一样重要。
比如一个客服Agent:
可以:查询退款政策。
但不一定可以:自动退款。
可以:起草回复。
但不能:擅自承诺赔偿。
所以Constraint其实是在定义:
Agent的工作边界
12
第五个:Success Criteria——怎样才算做对了?
这是我认为最重要、也最容易被忽略的一项。
还是竞品研究。
Agent最后给你一份:
20页PPT。
图很好看。
分析也很多。
是不是代表任务完成得好?
不知道。
因为我们没有标准。
所以开始之前必须问:我准备怎么判断它做得好不好?
13
给竞品研究建立成功标准
例如:
1. 覆盖度
5个指定竞品必须全部研究。
2. 数据准确度
价格必须来自官方页面或者可靠来源。
3. 证据完整度
关键判断必须附来源。
4. 时间有效性
使用最近12个月内的信息。
5. 输出完整度
规定的3张表不能缺失。
6. 决策价值
最终必须给出3个可以供产品团队进一步讨论的机会点。
这时候:
我们第一次拥有了:
“怎样知道AI做对了”的标准
而不是:看上去挺不错。
14
现在把原来的那句话重新写一次
最开始我们只有:帮我研究一下竞争对手。
现在经过5步以后,它变成:
Task 分析5个指定竞品的核心功能、价格和用户评价,找出共同优势、主要用户痛点以及可能的产品机会,为下一季度功能规划提供参考。
Input 使用指定5个竞品的官方网站、公开价格页以及最近12个月公开用户评价;同时使用我方产品功能清单作为对照。
Output 输出竞品基础表、功能对比表、用户痛点表,并总结3个值得产品团队进一步验证的机会。
Constraint 不得猜测无法确认的数据;关键事实必须附来源;超过12个月的数据不能作为当前状态依据;单条评价不能直接代表整体用户。
Success Criteria 5个竞品全部覆盖;关键价格可核验;所有主要结论有证据;规定表格完整;至少提出3个有证据支持的机会。
你会发现:
这已经不再像:一句Prompt。
更像:
一份给AI员工的任务书
15
这其实就是Agent搭建真正开始的地方
很多人会觉得:搭Agent是从选平台开始。
比如:
Dify。
n8n。
Coze。
OpenAI Agents。
或者其他Agent框架。
但我现在越来越觉得:
真正的第一步不是选工具
而是:先把任务设计清楚。
因为如果连:
Task是什么?
Input是什么?
Output是什么?
Success Criteria是什么?
都说不清楚。
换再强的Agent平台:
也只是把一个模糊任务自动化而已。
甚至可能:
自动化地犯错
16
再看几个“人话 → AI任务”的例子
例1
原话:
帮我分析客户投诉。
改成:
Task:把最近一个月的200条投诉分成主要问题类别,并找出最应该优先处理的5个问题。
Input:200条投诉记录。
Output:分类结果、数量、代表案例、Top 5。
Constraint:一条投诉可有次级标签,但只能有一个主标签;无法判断必须标记。
Success Criteria:人工随机抽查30条,分类结果达到事先约定的可接受标准。
例2
原话:帮我处理会议。
改成:
Task:把60分钟会议记录转成真正可执行的行动清单。
Input:会议转录文本。
Output:
任务
负责人
截止日期
依赖项
待确认事项
Constraint:
会议中没有明确负责人或日期时不能自己编。
Success Criteria:所有明确行动项都被提取,同时不得制造会议中不存在的任务。
例3
原话:帮我回复客户。
改成:
Task:根据客户问题、订单状态和售后政策生成客服回复草稿。
Input:客户消息 + 订单信息 + 售后政策。
Output:问题判断 + 建议处理方式 + 回复草稿。
Constraint:不能自行承诺政策之外的退款或赔偿。
Success Criteria:事实正确、政策正确、没有越权承诺,需要人工审批的问题必须明确标记。
是不是越来越像真正的工作任务了?
17
其实很多Agent失败,在开始运行前就已经注定了
我们以后做实验时,很可能会看到各种问题:
Agent理解错任务。
Agent给出了不需要的东西。
Agent漏了关键步骤。
Agent调用错误工具。
Agent自信地完成了一个根本不是我们想要的任务。
有时我们会怪:模型不够聪明。
但真正的原因可能只是:
人没有把工作定义清楚
所以以后碰到Agent失败,我建议先不要马上:
换模型。
加Prompt。
增加Agent。
先回头检查五个问题:
Task清楚吗?
Input清楚吗?
Output清楚吗?
Constraint清楚吗?
Success Criteria清楚吗?
很多问题可能就在这里。
18
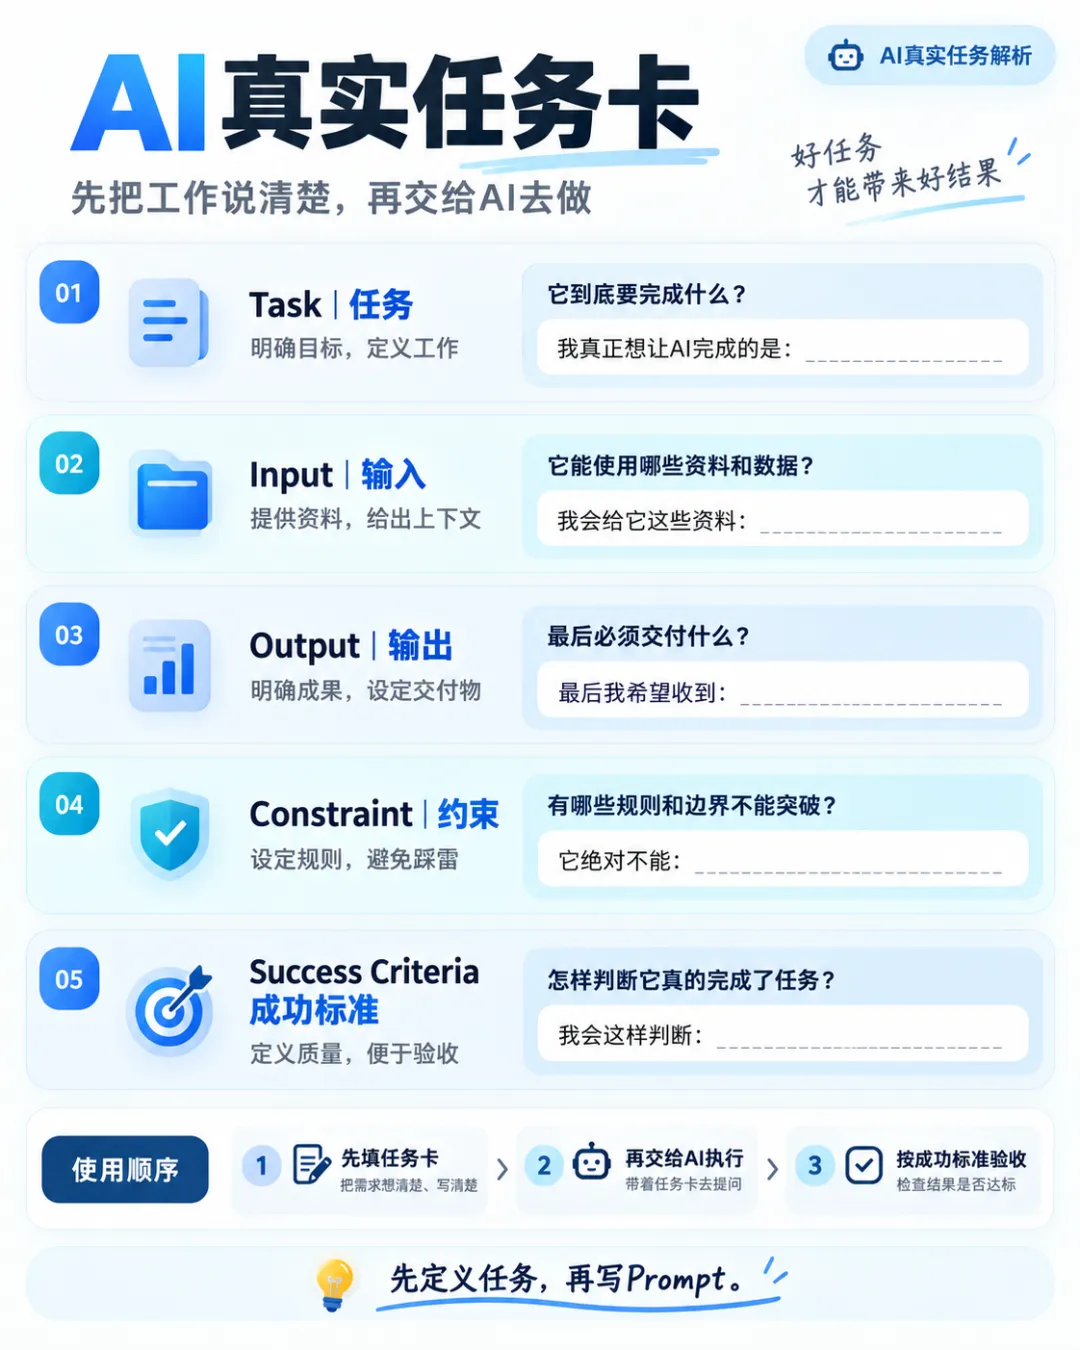
我们把它做成一张“AI任务卡”
以后《AI真实任务解析》的每个实验,都可以先填写这张卡。
AI真实任务卡
Task|任务
它到底要完成什么?
Input|输入
它能使用哪些资料和数据?
Output|输出
最后必须交付什么?
Constraint|约束
有哪些规则和边界不能突破?
Success Criteria|成功标准
怎样判断它真的完成了任务?
以后你甚至可以把这张:
AI真实任务卡
做成这个账号的固定视觉资产。
和:
AI真实任务成绩单
配套。
实验之前:填任务卡。
实验以后:出成绩单。
一前一后。
19
今天给自己做一个小练习
找一项你最近真的想让AI完成的工作。
不要马上问AI。
先把下面5句话写完整:
1.我真正想让AI完成的是:
_____________
2.我会给它这些资料:
_____________
3.最后我希望收到:
_____________
4.它绝对不能:
_____________
5.我会用下面的方法判断它做得好不好:
_____________
如果这5句话都能写清楚:
你其实已经迈过了搭Agent过程中一个非常重要的门槛:
从“我想让AI帮忙”
变成:
“我知道怎样给AI布置工作”
20
今天真正应该带走的不是Prompt模板
很多人在学习AI的时候特别喜欢收藏Prompt。
我以前也很容易把重点放在:
「这句话应该怎么写?」
但现在我觉得更重要的是:
先学会定义任务
一个非常漂亮的Prompt:
如果任务本身模糊,
结果仍然可能不好。
而一个定义非常清楚的任务:
哪怕Prompt写得朴素,
AI往往也能做得不错。
所以今天最重要的一句话是:
不要先问“Prompt怎么写”,先问“这项工作到底怎样才算完成”。
21
下一篇:AI做完了,为什么还不能算任务完成?
现在我们已经把:
Task,Input,Output,Constraint,Success Criteria。
都定义出来了。
理论上AI已经知道:自己该干什么。
但新的问题马上来了。
假如AI告诉我们:任务已经完成。
我们到底凭什么相信?
特别是:它给了一个数字。
引用了一段资料。
或者做出了一个判断。
这些东西:
真的对吗?
所以下一篇我们会进入一个非常重要的能力:
Verification
也就是:AI做完不等于任务完成,必须想办法验证它。
而这恰恰是一个真正能工作的Agent,和一个“看起来很聪明的AI”之间的重要区别。
我是丙海,拿一个现实世界里的真实任务,让AI做一遍,然后解析结果。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。