ARTICLE · 1112208
OpenAI深夜送满血算力,全球程序员却集体崩溃:求求你,把额度收回去!
在这个世界上,最令人窒息的黑色幽默,往往披着“天降福利”的外衣。
想像一下:你在公司辛辛苦苦攒了两个星期的调休假,算准了下周一连休三天去度假。结果周五下班前,老板突然在全员大群里狂发红包,深情款款地宣布:“为了犒劳大家,今天所有人的年假额度全部重置回满格!不过,下一次刷新假期的时间,统一推迟到下个月底!”
你揉了揉眼睛,发现自己原本后天就能享受的假期不仅彻底泡汤,未来整整一个月还得咬着牙当牛马。
2026年9月26日深夜,OpenAI 就给全球数百万开发者上演了这样一出啼笑皆非的魔幻大戏。
因为一次短暂的服务中断,OpenAI Codex 工程负责人 Tibo 怀揣着满满的善意,在社交平台上向所有付费用户宣布:故障已修复,为了补偿大家,所有人的 Codex 和 ChatGPT Work 配额全部立即重置到 100%!
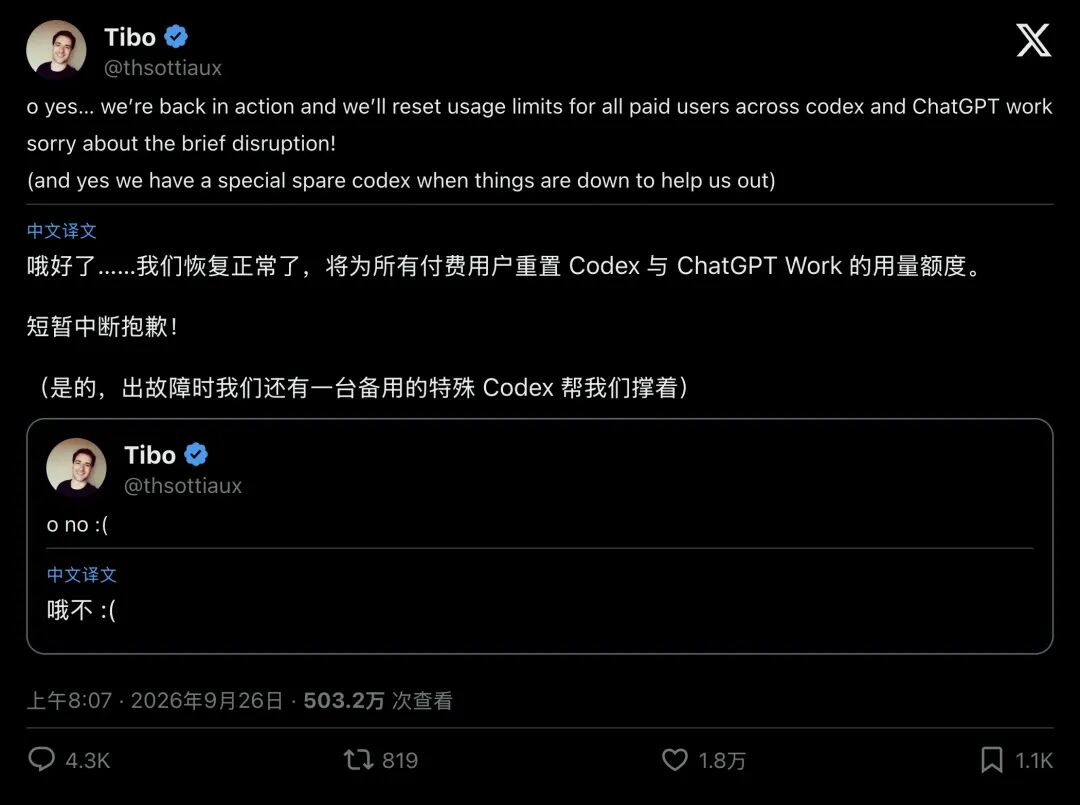
▲ Tibo 发文致歉并宣布为所有付费用户重置配额
紧接着,Tibo 再次发推确认:“重置已全网生效,大家周末愉快!”
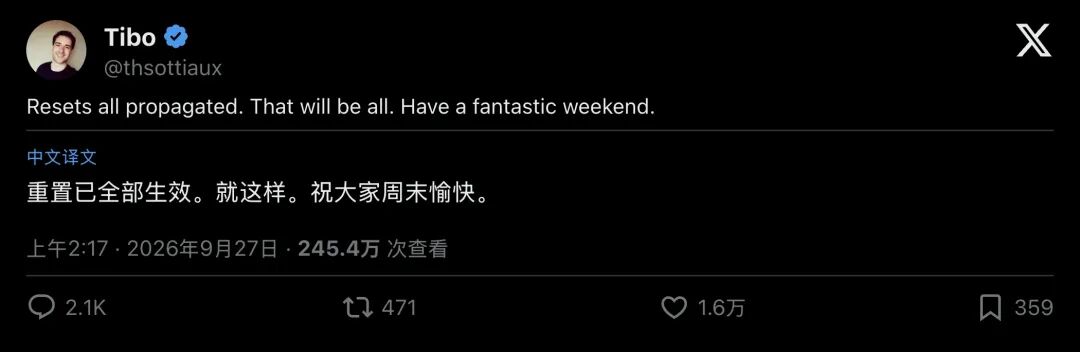
▲ Tibo 宣布“重置已全网生效,祝大家周末愉快”
官方本以为评论区会是一片感恩戴德的欢呼。
然而,短短几分钟内,全球程序员社区一片哗然。成千上万的开发者涌入评论区吐苦水、发牢骚。有人写段子调侃,有人列出小学数学公式直指官方“明赏暗抢”,中文开发者更是直呼“整个排期全被搞砸了”。
一场本应皆大欢喜的官方补偿,为什么会演变成开发者生态里的集体灾难?
01.算术陷阱:一场教科书级的“正向洗劫”
这场风波的源头,来自开发者 calle 发出的一条经典“绿字梗帖”。他把程序员的真实周末写成了一出跌宕起伏的悲剧:
作为一个程序员;今天是周六,你的 Codex 周额度还剩整整 85%;你把这些额度全攒着,准备在周日来一场酣畅淋漓的通宵编程;顶级模型 Astra 战斗力拉满,8个小时就能把这 85% 烧得精光;但没关系,因为你的账户再过 2天(周一)就会自然刷新,重回 100%;算下来,这个周末加上下周初,你原本拥有将近 185% 的充沛算力;结果,Tibo 大手一挥,按下了全员重置按钮;睁开眼还是周六,你的额度变成了 100%;但下一次刷新时间,变成了整整 7 天之后。
文末,calle 留下了一句充满讽刺的呐喊:“醒醒吧,被蒙在鼓里的羊群们(wake up sheeple)。”
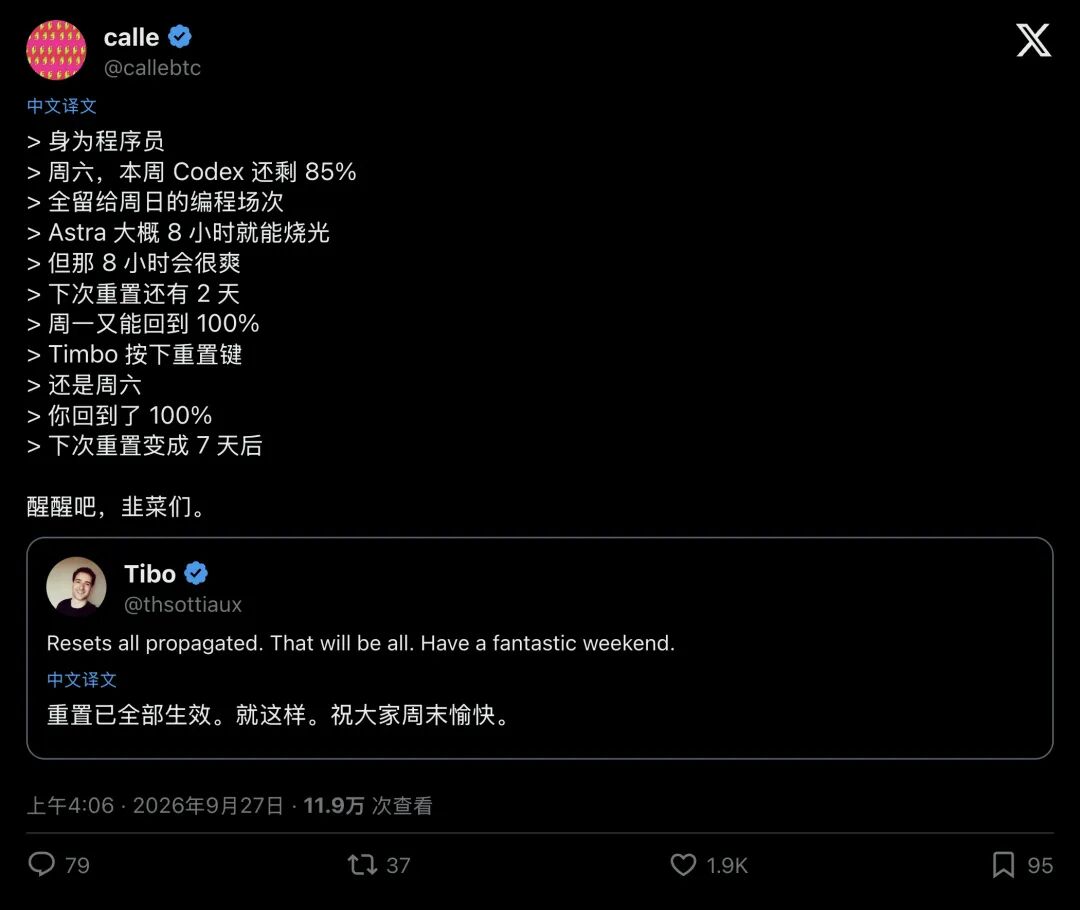
▲ 开发者 calle 的“be coder”情境吐槽迅速刷屏
表面上看,你的可用额度从 85% 涨到了 100%,似乎平白多赚了 15%。
但只要小学数学及格的人都能算明白这笔账:你为了这区区 15% 的纸面增量,被官方生生剥夺了原本两天后就能到账的整整 100% 全新额度!
在官方帖下方,用户 TQx 摆出了更残酷的数据:他原本账户里还剩 45% 的额度,三天后自然刷新,这几天内手头总共能调用 145% 的算力。被官方“强制回血”之后,可用额度立刻变成 100%,下一次刷新却被无情推到了 7 天后,整体算力在瞬间蒸发了将近三分之一。
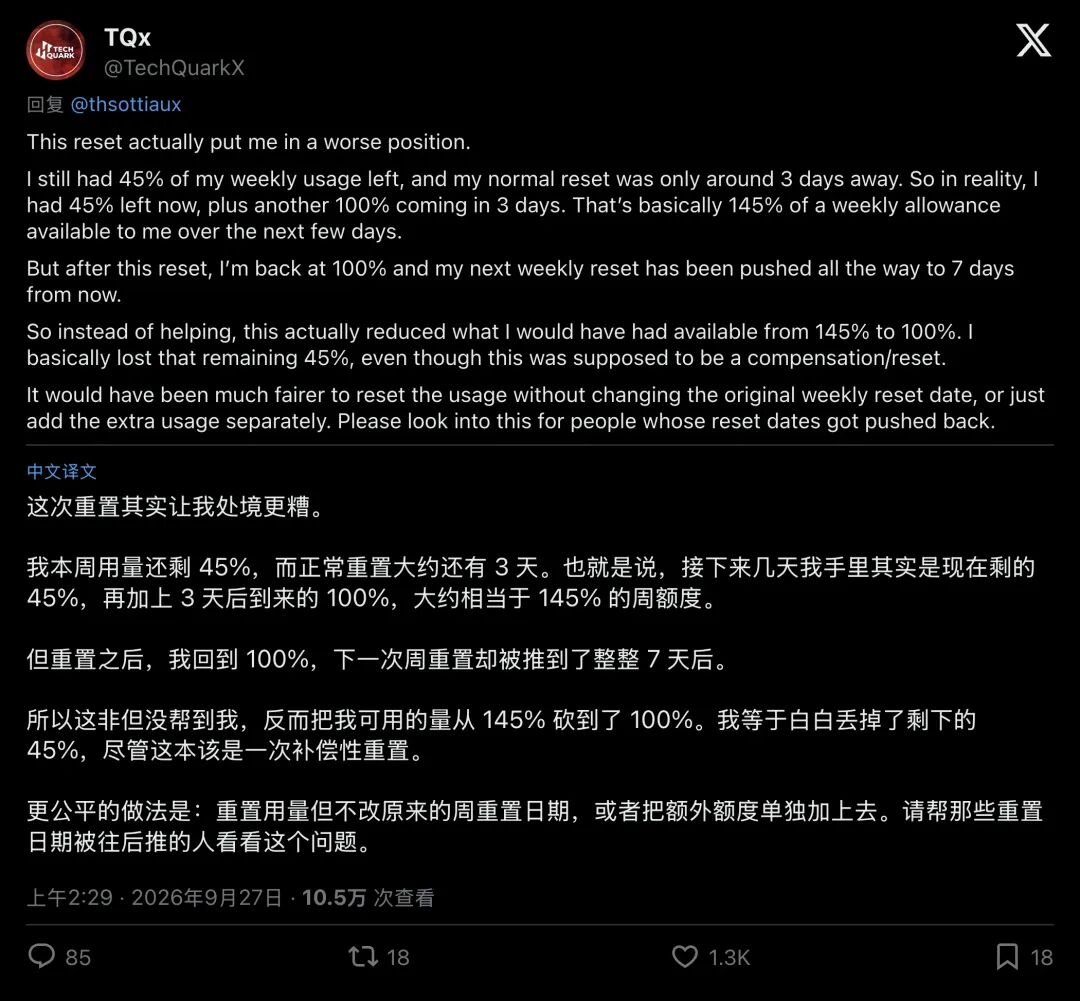
▲ 开发者 TQx 用精确的算术向官方指出:这次补偿其实是一次严重的减配
那些原本就处于满配状态的用户同样满腹怨气。开发者 Proton 忍不住讽刺道:“太感谢了,我本来就是 100%,重置完还是 100%,等于我纯亏了一个自然刷新周期!”
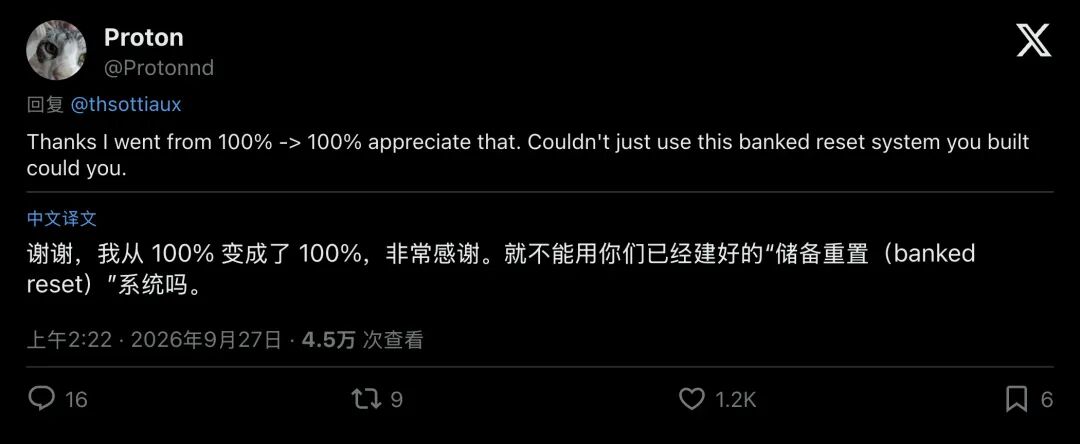
▲ Proton 质问官方为什么不用已有的储备重置系统
中文开发者 Relieve56 也在讨论中绝望地表示:自己还有两天就要重置,因为下周有极其庞大的交付任务,工作日刻意节制,特意留了 60% 的余量。结果官方一记“神仙操作”,把整个生产排期砸得稀烂。
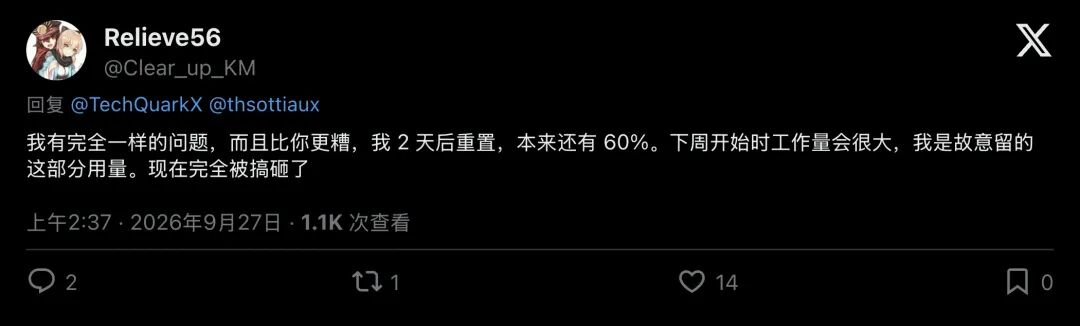
▲ 中文用户吐槽原本留了 60% 准备应付下周高峰,计划瞬间被打乱
02.撕开黑盒:AI时代的“产能排期”与双时钟限流
要看懂开发者的愤怒,就必须先搞清楚 AI 编程工具底层那套如同精密齿轮般的双时钟限流机制。
在现代高强度开发中,像 OpenAI Codex 这样的代理式(Agentic)工具早已成为程序员接入大脑的“外骨骼机甲”,远超普通聊天工具的范畴。为了平衡庞大的算力开销,OpenAI 给付费账户设计了极其特殊的规则:
- 短期滚动窗口(约 5 小时)
:限制你瞬间爆发式的疯狂调用,防止机房被瞬间打崩; - 长期配额窗口(约 7 天)
:这是你的每周总产能池。
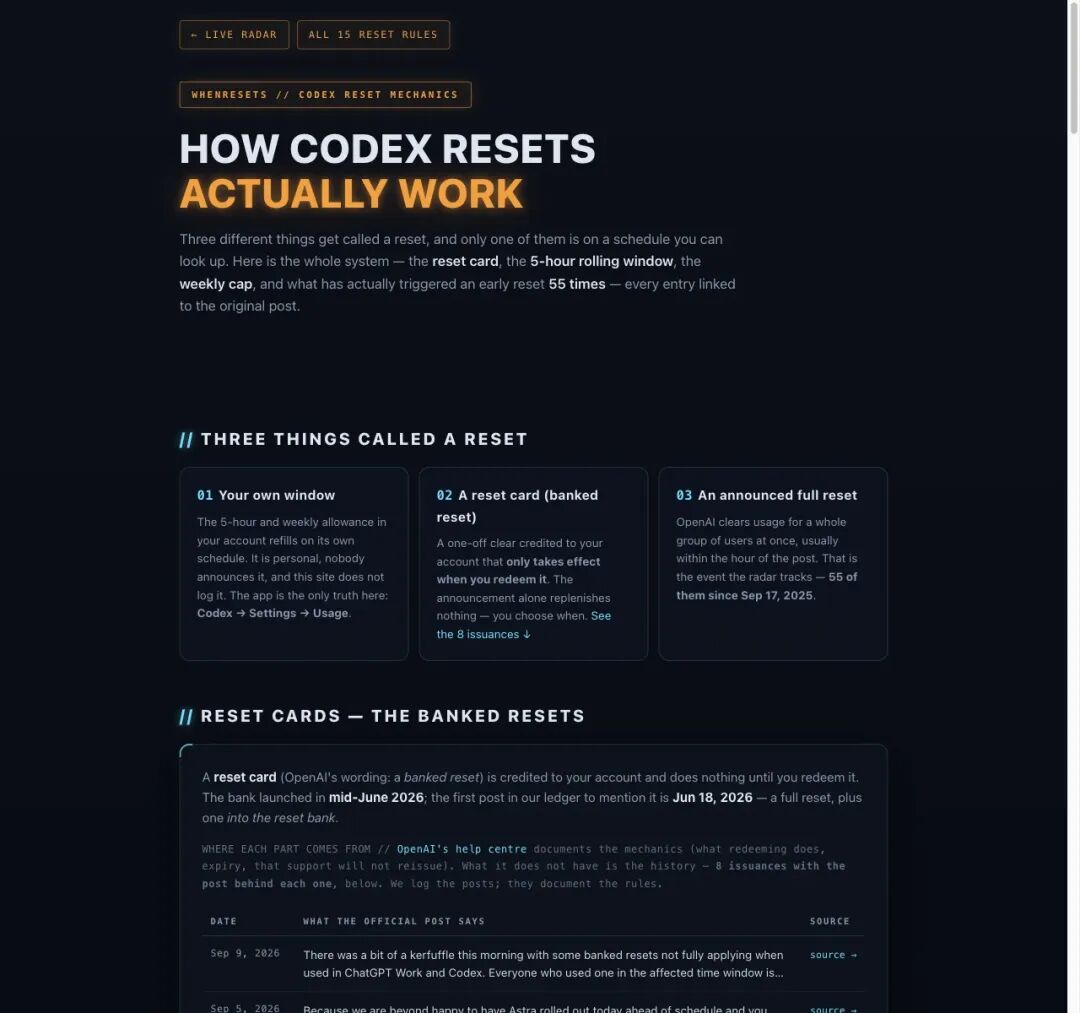
▲ 第三方站点 WhenResets 对个人窗口、储备重置卡与全局重置机制的图文分解
关键在于:这个 7 天长周期的倒计时起点,以你每次重置后的“第一笔请求”为准,全网并未设置统一的“每周一早晨清零”。
如此一来,全网数百万程序员的刷新时间点其实是完全错开、高度个性化的。有的在周二刷新,有的在周六刷新
资深开发者会像管理工业流水线一样管理自己的额度:重构底层代码、跑高消耗的复杂脚本时,挑在重置日前夕把额度拉满;日常修小 Bug 时则节约使用
事实上,社区和官方一直存在三种截然不同的重置方式:
- 个人自然重置
:账户自带的时钟走到终点,悄无声息地回满; - 储备重置(Banked Reset)
:官方把一次重置特权做成一张“兑换券”存进你的账户,你想什么时候用自己说了算; - 宣布式全局重置
:官方在云端强制按下一键清空,立刻全员回满,同时强行改写所有人的时间锚点。
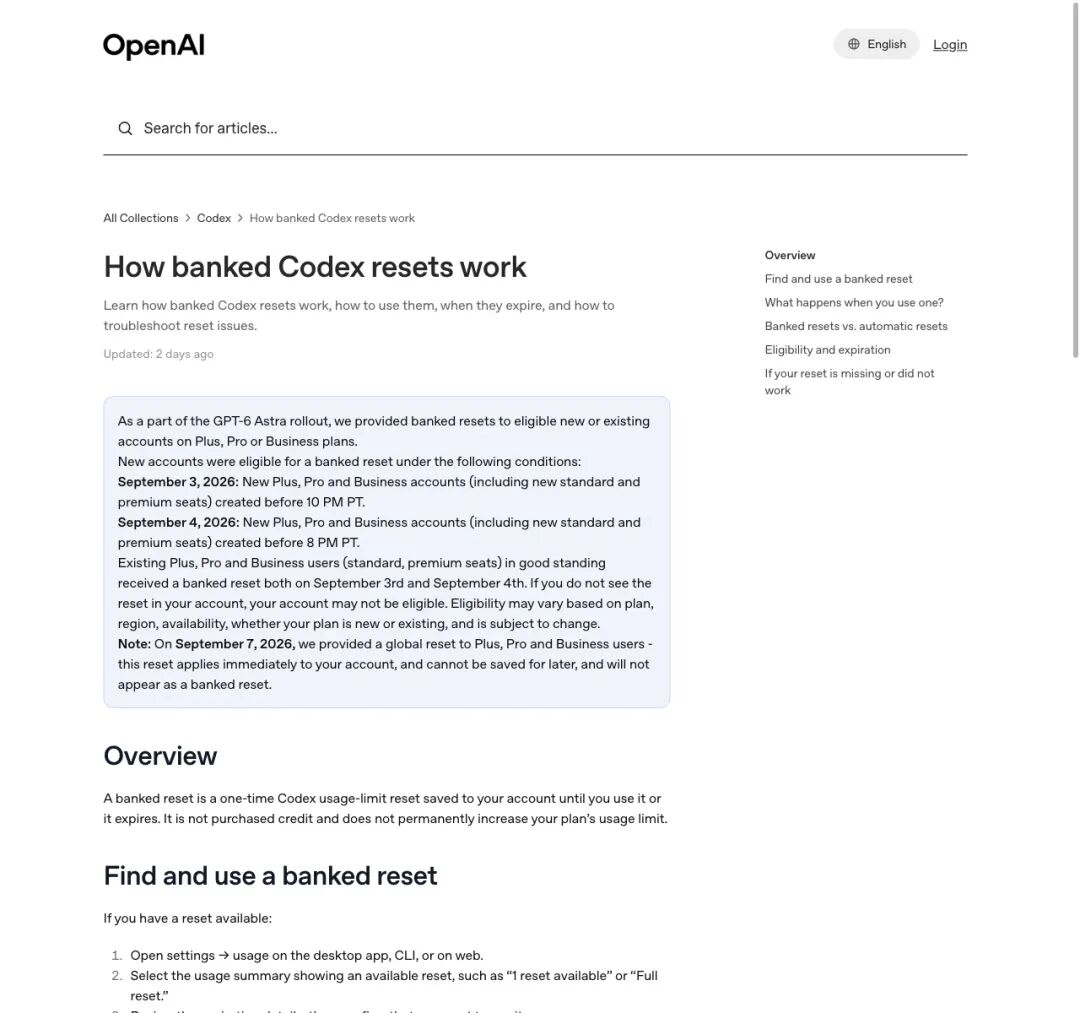
▲ OpenAI 官方帮助文档中,明确区分了全局重置与可自行选择兑换时机的“储备重置”
就在几天前的 9 月 22 日,OpenAI 发布 GPT-6 Sol 和 Luna 时,官方还老老实实地采用了“发放储备重置券”的优雅方案,把选择权完全交还给用户。
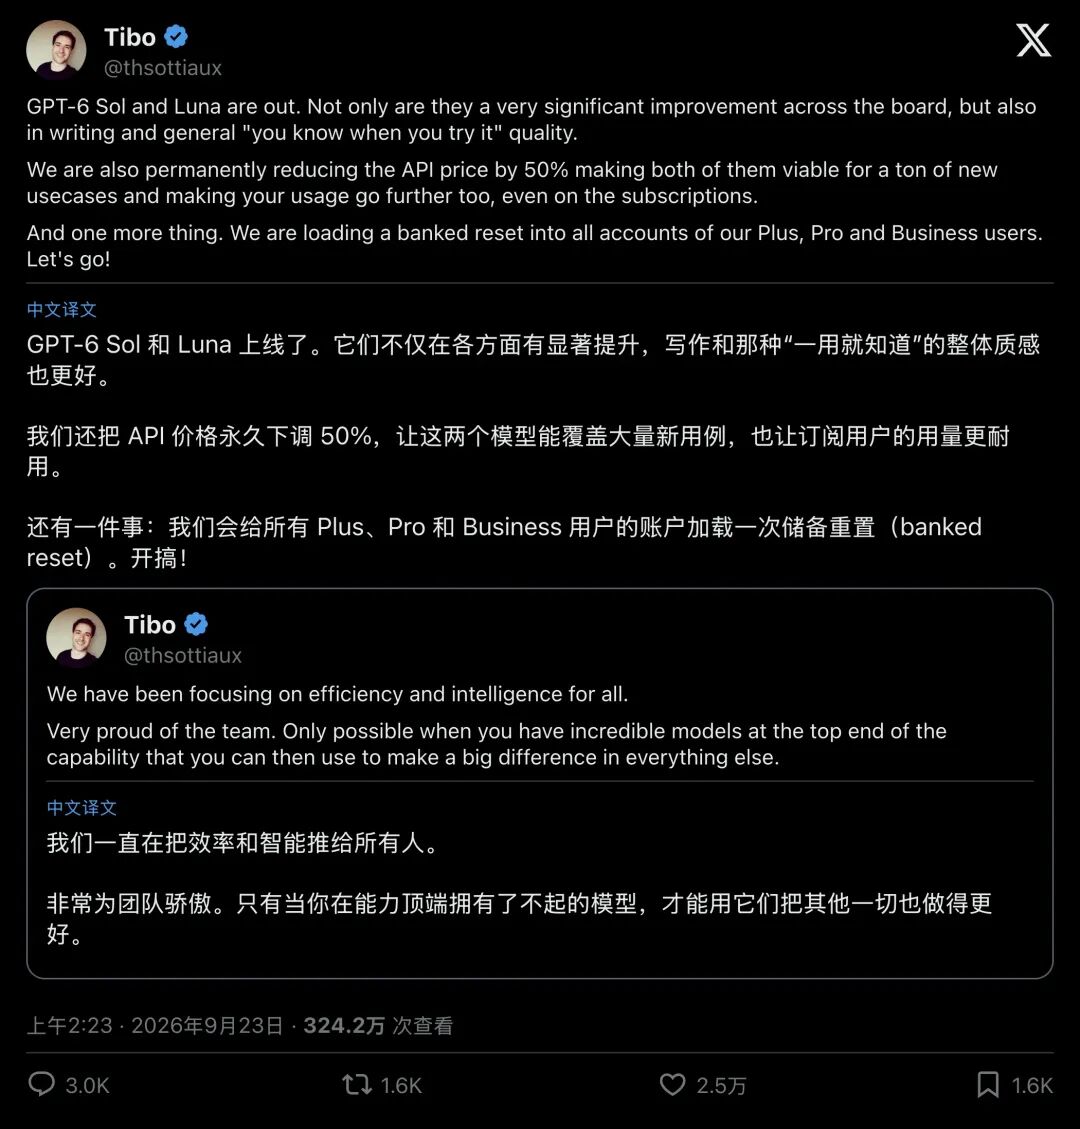
▲ 9 月 22 日官方上线新模型时,曾通过加载“储备重置券”的方式向用户发放福利
既然已经有了成熟的“发放兑换券”机制,为什么这次官方偏偏要选择最粗暴的“全员一刀切强制重置”?
03.工程内幕:一个 $O(1)$ 的技术诱惑,诱发了“时钟坍缩”
决策背后的真实逻辑,深植于大型分布式系统的架构困境中。
回顾当时的场景:9 月 25 日深夜,OpenAI 的系统刚刚经历了一次宕机。服务恢复后,整个工程团队面临着巨大的运维压力与公关危机。此时,摆在负责人 Tibo 和后端架构师面前的,其实只有两条技术路径:
路径 A:优雅但危险的“精细化增量补偿”
如果想让所有人都满意,系统必须为全网数百万独立用户逐一计算:你还剩多少额度?离刷新还剩几天?如果额度很多且临近刷新,系统就只给你发放一张缓冲券,保留原有的倒计时时钟;如果额度见底,再为你执行重置
但在高并发的分布式缓存(如 Redis)集群中,后台必须在极短时间内对数百万个 Key 执行复杂的分布式事务或高消耗脚本。在系统刚刚从宕机中爬起来的脆弱时刻,这种庞大的写入洪峰极易导致数据库 CPU 瞬间冲上 100%,直接诱发系统的二次雪崩。
路径 B:粗暴但极简的“全网版本号刷新”
在分布式限流网关中,有一个极具诱惑力的技术方案:全局纪元(Epoch)翻转。
工程师根本不需要扫描数百万个用户的数据表,只需要在配置中心将全局时间戳统一修改为当前时刻(anchor_time = now()),并将请求计数器归零。这种操作的时间复杂度是纯粹的 $O(1)$,耗时仅需几秒钟,全网瞬间生效,执行风险无限趋近于零。
在宕机恢复的焦头烂额之中,工程团队本能地倒向了路径 B。
然而,这种工程实现上的“极致优雅”,在业务逻辑上却是一场灾难性的“契约撕毁”。
这记重锤不仅强行抹杀了每个开发者基于自身工作流建立的时间节奏,还在技术底层引发了可怕的“时钟坍缩(Clock Synchronization)”。
原本,数百万开发者的刷新时间是均匀分布在全天候的各个时段的,整个 OpenAI 集群承受的流量也是天然错峰的。但经过这一次全员强行对齐,全网极其庞大的高强度开发者,他们的下一次刷新时刻全被死死钉在了未来的同一个时间点,每周六傍晚。
这无异于给系统亲手埋下了巨大的隐患:每到周六傍晚,全网被憋了一周的开发者将同时满血复活,并在同一时刻发起海啸般的并发请求。一次为了安抚用户的运维操作,反手给人造流量洪峰铺平了道路。
04.算力成为新型“电力”时,平台最该遵守什么?
在社区的激烈交锋中,开发者 Ghost In The Stack 回忆道:之前官方就曾试探性地询问过用户“推迟重置日期好不好”,当时就有大量用户明确表示反对这种打乱生物钟的操作。
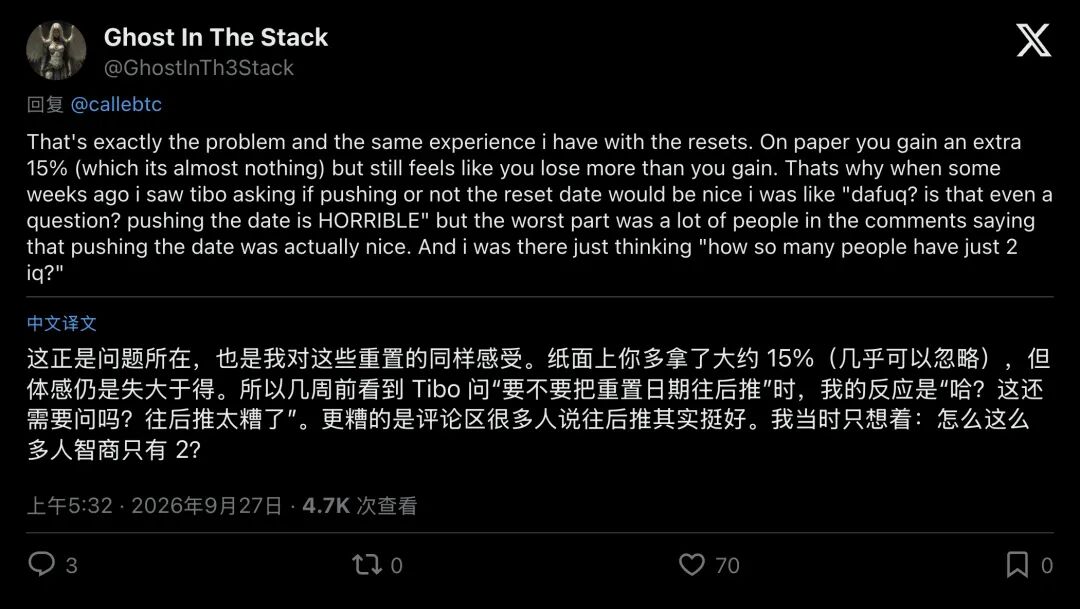
▲ 社区用户讨论官方此前推迟重置日期的争议
面对这种尴尬,开发者 Justin Fortier 甚至直接在推特上写出了一套兼顾公平与系统负载的“伪代码”规则:只有当系统计算出“重置能切实提升用户未来的日均可用算力”时才自动执行,否则就必须无条件保留用户的原有时钟。
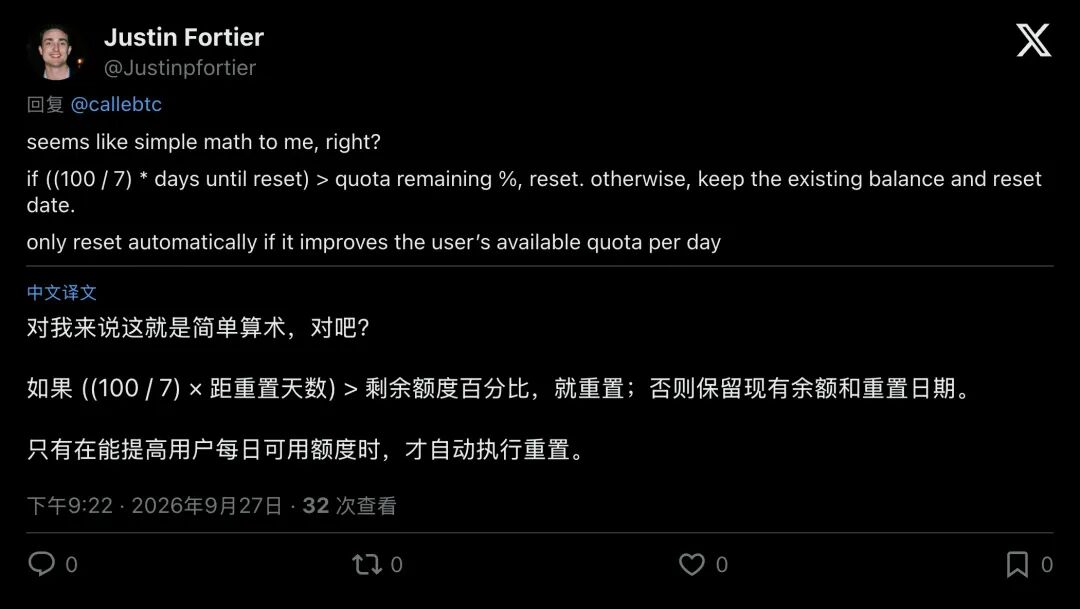
▲ Justin Fortier 提出的条件重置规则,建议只在能改善日均额度时执行重置
第三方追踪网站 Codex Resets 的数据清晰地显示:在过去几个月里,这种由模型发布、故障补偿引发的“额外重置”已经频繁发生了数十次。
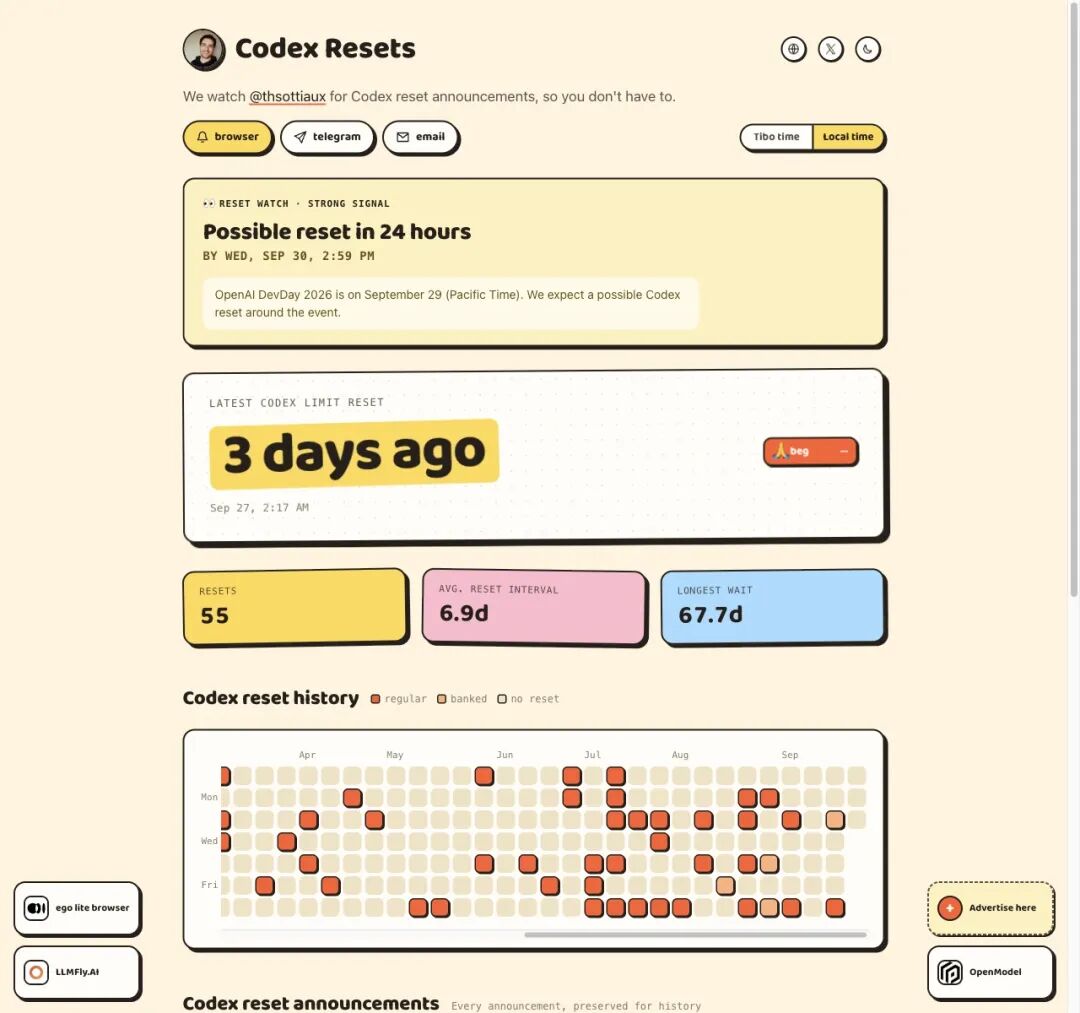
▲ 第三方追踪站详细记录了密集的重置事件与平均间隔
当额外重置从偶发福利沦为无法预期的外部扰动时,用户不得不重新审视人与 AI 工具之间的协作关系。
在生成式 AI 狂飙突进的今天,顶尖编程工具的周配额,早已脱离了单纯的“软件功能试用”范畴,它正在演变成工业时代的煤炭、石油与电力。
每一位将 AI 深度融入生产流程的现代工匠,都是在以“天”甚至“小时”为单位,精密规划着自己的智力输出与交付排期。
在传统的消费互联网思维里,“给所有人白送满格流量”永远是不可指摘的施舍;但在以 AI 为生产外脑的时代,对时间契约的尊重,远比廉价的数字回满更重要。
下一次,当系统再次向你抛出看似慷慨的“免费午餐”时,别急着点赞,先看一眼你的时钟,或许那正是你的生产力日历被悄悄偷走的瞬间。