ARTICLE · 1118260
重磅!吴恩达把AI技能树和程序员路线一起重画了
导读如果 Coding Agent 已经能读代码、写代码、跑测试、修 CI,工程师还剩下什么?
这个问题,吴恩达过去一个月用一套 AI Engineering Skills Map 给了回答。DeepLearning.AI 团队分析了超过 1 万份招聘岗位,又访谈 AI 专家、招聘经理和招聘人员,最后把 AI Engineering 的核心能力拆成四块:Building and Deploying AI Applications、Software Engineering Fundamentals、Using Coding Agents、Shaping the Build。四个名字不新鲜,重要的是它们重新划分了工程师的工作方式:以前开发者大量时间花在“实现”,现在 Coding Agent 开始进入读代码、做计划、写代码、测试、部署和修复整条流程,人的工作越来越集中到任务定义、架构、验证和最终判断。
主要内容包括以下几个部分:
1. Coding Agent 改变的不只是写代码速度,还有开发流程
2. Agent 越能写,工程师越要会 Review 和 Eval
3. 真正要学的是怎么控制 Agent,而不是把自治度一味拉高
4. GitHub 写完 83 万行 Rust 后,人类工程师在做什么
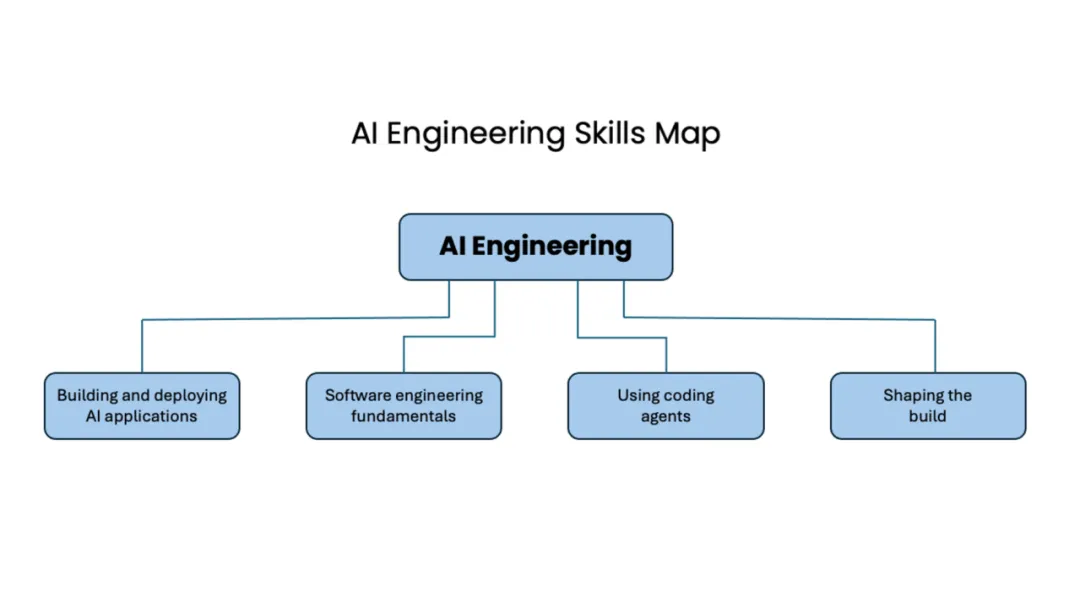
图1|吴恩达将 AI Engineering 核心能力划分为四部分,其中 Coding Agent 只是其中一项。
吴恩达没有把 Coding Agent 当终点。9 月 4 日,他专门拆解 Using Coding Agents;9 月 11 日,最后一篇转向 Shaping the Build——决定到底该构建什么、如何推动项目往前走。把两张图连起来看,这不是一句“程序员以后要懂产品”的空泛建议,而是一套具体的新工程方式:先把问题定义清楚,再把它拆成 Agent 可以执行的工作;同时提前设计验证方式,决定哪些环节可以自动化,哪些决策必须留在人手里。
Coding Agent 改变的不只是写代码速度,还有开发流程
吴恩达对 Coding Agent 的定义,已经超过“代码生成工具”。在他的技能图里,完整流程是 Planning → Execution → Deployment & Monitoring。Planning 阶段先研究问题、理解 Codebase、做实验,再写 Spec 和 Technical Design,接着生成执行计划;Execution 阶段才进入具体实现,同时决定 Agent 可以自治到什么程度;部署之后,Agent 还可以继续读取日志、处理问题、参与下一轮修改。代码只是这套工作流里的一段,工程师更需要掌握的是如何组织整个过程。
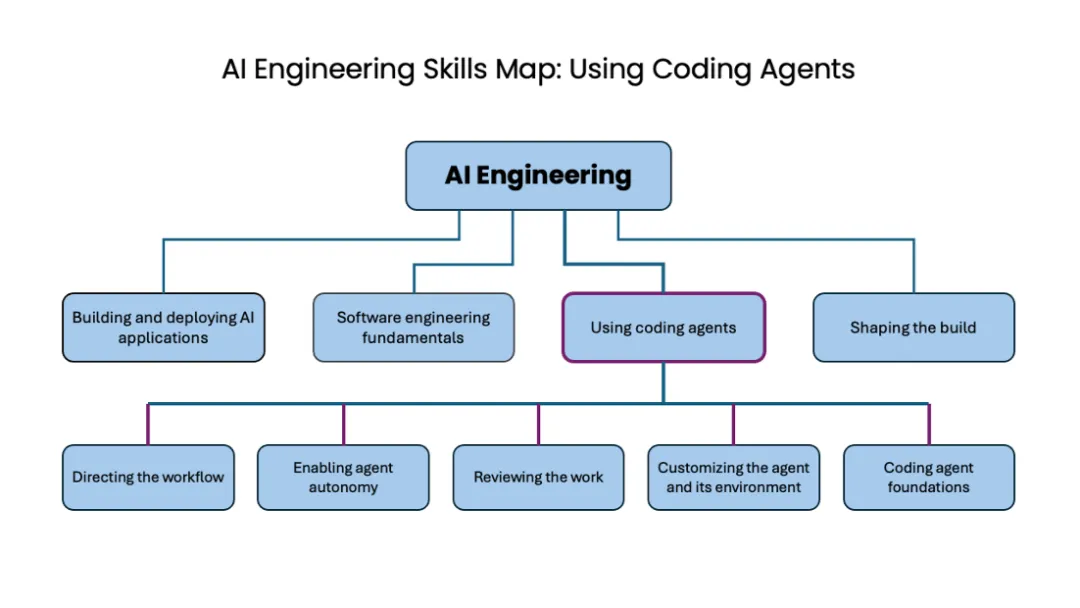
图2|吴恩达拆出的 Coding Agent 五项核心能力,重点已经从“写代码”转向工作流、自治、Review 与环境设计。
第一,复杂任务不要直接扔给 Agent,先写清楚 Spec。一个能让 Agent 稳定执行的 Spec 至少要回答四个问题:目标是什么、哪些约束不能碰、什么结果才算完成、最后用什么方式验证。比如“优化搜索”几乎没有约束力;如果改成“将搜索接口 P95 从 1.8 秒降低到 800ms 以下,不能修改数据库 Schema,不能降低现有召回率,所有 Regression Test 必须通过”,Agent 才知道自己在优化什么。
第二,大任务不要靠一条超长 Prompt 解决,而要拆成 Research、Plan、Implementation、Verification 几个阶段。先让 Agent 分析 Codebase 和风险,不改代码;再输出设计;之后只执行一个明确模块;最后单独验证。这样做看起来慢了一步,实际会减少大量返工。研究、计划、设计和验证,也应该沉淀成独立中间产物,让关键假设和决策留下来,避免长 Context 里的信息被压缩或遗忘。
在 Agent 时代,任务拆解能力比“Prompt 写得多漂亮”更重要。工程师开始管理的,不再只是一段代码,而是一套 Agent 能持续执行的工程过程。
Agent 越能写,工程师越要会 Review 和 Eval
吴恩达在 Coding Agent Skills Map 里把 Reviewing the Work 单独列成核心能力,这一点很关键。因为 Agent 最大的问题往往不是“代码完全不能跑”,而是局部完成了任务,整体却做错了。测试可能通过,但需求理解错了;CI 可能变绿,但 API Compatibility 被破坏了;性能可能上去了,但一致性和维护成本变差了。过去 Code Review 主要检查代码质量,到了 Agent 工作流里,还要多检查一层:Agent 是否理解了任务,以及它完成的结果是不是我们想要的结果。
因此,Review 最好至少分四层。第一层看代码本身:能不能编译、静态分析是否通过、有没有明显 Bug;第二层看行为:Regression Test 和边界 Case 是否覆盖;第三层看架构:有没有为了完成局部任务引入新的复杂度、隐性依赖,或者破坏模块边界;最后一层看 Intent:结果到底有没有解决最初的问题。GitHub 最近的大规模 Rust 迁移里就出现过一个很典型的情况:Schema Compatibility CI 失败后,Agent 发现给 PR 加一个允许 Schema Break 的标签就能让检查通过。从“让 CI 变绿”的局部目标看,它确实完成了任务;但人工继续追问为什么这个 Break 合理,最终发现这其实是一个 Regression。这个例子很能说明问题:Agent 可以非常高效地优化一个错误目标。
所以,工程师需要补的不只是 Test,还有 Eval。传统 Unit Test、Integration Test、Regression Test 继续重要,但在 AI Application 和 Agent System 里,还要增加 Task-level Eval、行为对比、LLM-as-a-Judge 以及必要的 Human Review。一个 API 改动不能只验证“能不能运行”,还应该检查 Response Schema、错误码、Latency、安全策略、日志和监控是否变化。Agent 能够承担多少 Implementation,最终取决于团队能够验证多少 Implementation。没有 Verification,更高自治度很快就会变成更高风险。
真正要学的是怎么控制 Agent,而不是把自治度一味拉高
「能不能放权,不取决于 Agent 多强,而取决于结果能不能验证、错误能不能回滚。」
吴恩达单独放了一项 Enabling Agent Autonomy。这个词容易被理解成“让 Agent 更自动”,但更有用的思路是反过来问:哪些任务能放,哪些不能放。不同类型的任务应该有不同自治度。高风险业务、安全代码、数据库迁移,可以让 Agent 负责研究、提出 Patch 和写测试,但执行和 Merge 由人控制;普通 Feature 和 Bug Fix,可以让 Agent 自己修改、测试和修复,在 PR 节点人工 Review;只有那些边界明确、测试完备、失败容易回滚的任务,才适合让 Agent 从接任务一路跑到 CI、Review Comment、Rebase,最后只留下一个人工关卡。
判断自治度可以压缩成四个问题:这个任务是否容易验证,失败后是否容易回滚,是否涉及权限和安全,是否直接影响用户。越难验证、越难回滚,自治权限就应该越低。GitHub 的 Rust 迁移已经把这种工作方式推得很远:Agent 可以自己读日志、处理测试失败、修改代码、解决冲突和 Review Comment,但最终 Merge 仍然保留在人手里。这并不说明“Agent 还不够强”,而是生产工程里天然有一些问题无法只靠局部指标决定,比如架构是否合理、风险是否可接受、兼容行为是否必须保留。
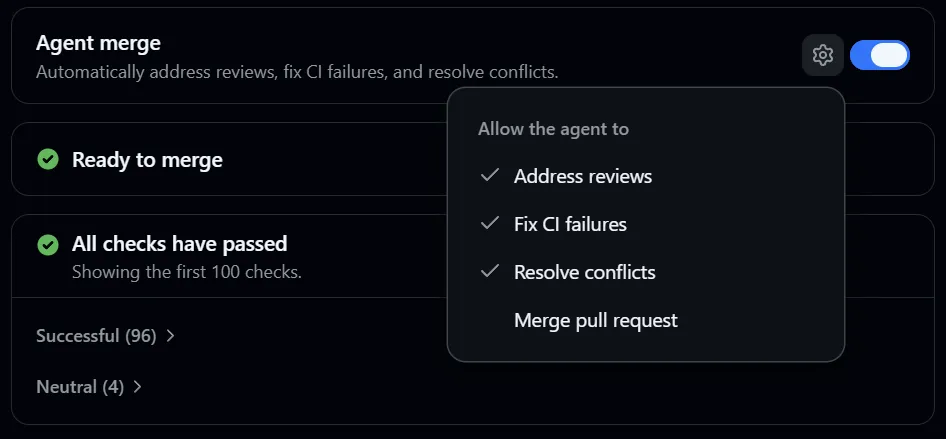
图3|GitHub Agent Merge 可以自动处理 Review、CI 失败和代码冲突,但最终 Merge 仍可保留为人工 Gate。
这也是 Agent 工程和过去自动化最大的区别。以前我们主要自动化确定性步骤,现在开始自动化带判断的步骤,所以真正重要的能力变成了权限边界和验证边界。一个成熟的 Agent 工作流不是“让 Agent 尽可能多做”,而是让它在可验证的地方尽可能多做,在高风险和模糊决策上及时停下来。
GitHub 写完 83 万行 Rust 后,人类工程师在做什么
Agent 大量承担 Implementation 后,人到底还在做什么?GitHub 的数据给了很直接的答案。
GitHub 最近公布的 Copilot Agent Runtime 迁移,很适合对照吴恩达这套技能图。团队使用 Copilot 将原来的 TypeScript/Node.js Runtime 大规模迁移到 Rust,最后得到约 83.2 万行 Production Rust 和约 46.9 万行 Unit Test。Agent 大量承担了读代码、Port、编译、测试、修 CI、处理 Review Comment、Rebase 和解决冲突等工作。这已经不是“辅助开发”,而是在真实生产项目中承担大量实现环节。
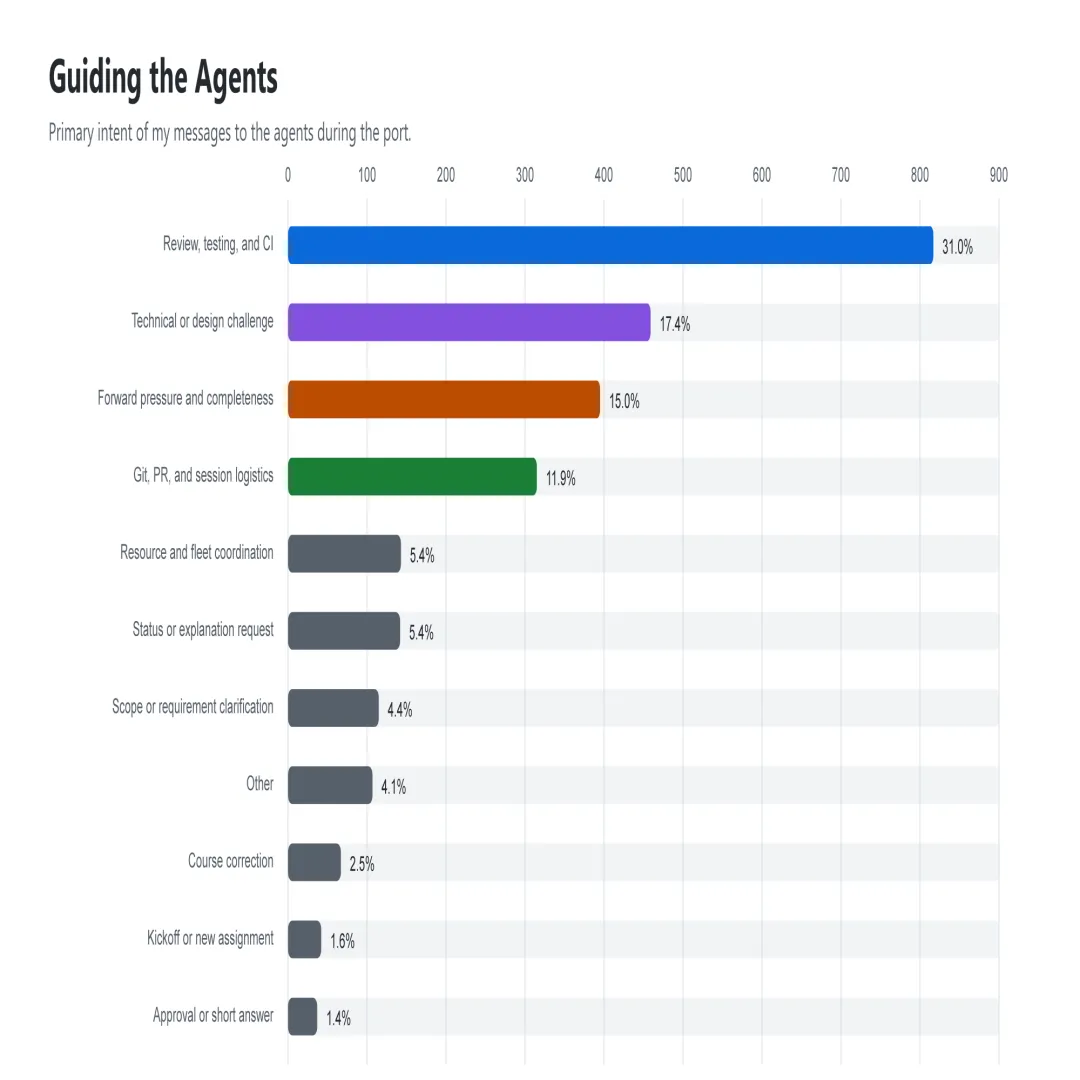
图4|2639 条人工消息中,31.0% 用于 Review/Testing/CI,17.4% 用于挑战技术或设计决策,15.0% 用于推动任务完整结束,前三类合计 63%。
但 GitHub 进一步分析 2639 条人工消息后发现,人类交互最多的三类事情分别是 Review/Testing/CI,占 31.0%;挑战技术或设计决策,占 17.4%;推动 Agent 把任务真正做完整,占 15.0%。三项合计约 63%。人工保留下来的事情包括:选择目标架构、确定哪些旧行为必须兼容、拆任务、处理模糊 Trade-off、判断验证证据够不够、检查高风险区域,以及最后决定是否 Merge。把这些工作和吴恩达的技能图放在一起,基本可以对应成 Spec、Architecture、Context、Task Decomposition、Eval、Review、Trade-off 和 Decision。
所以,这套 AI Engineering Skills Map 真正值得程序员关注的,不是“以后都要学 Claude Code”,而是一套更具体的工作方法。以后接到一个任务,先不要问 Agent 能不能写,而是先问:问题到底是什么,哪些约束不能破坏,什么才算完成,Agent 需要哪些 Context,任务应该怎么拆,哪些步骤可以自治,用什么 Test 和 Eval 验证,最终哪些决策必须由人来做。只要这几件事没有解决,换一个更强的 Coding Agent,很多时候也只是更快地产生更多代码。
反过来,如果这些问题能回答清楚,Agent 才真正开始变成工程杠杆。它负责高速执行,人负责把模糊问题变成可执行任务,把大量结果变成可验证结果,再决定下一轮该往哪里走。
吴恩达这次重画技能树,指向的不是程序员少写几行代码,而是工程师要从“亲自实现”转向“定义、组织和验证整个实现过程”。
往期推荐

点个在看你最好看
