ARTICLE · 1121473
AI 渗透如何检测,溯源,反制?看了几篇篇论文带来的防御启示
不只问“有没有攻击”,还要问:证据够不够、行为能否关联、防御系统自己有没有被带偏。
· · ·
写在前面:发现攻击之后,我们究竟知道多少?
一段异常请求、一串扫描命令、一份格式工整的 AI 检测报告,究竟能证明什么?
当攻击者开始让 AI Agent 调用工具、读取反馈、调整策略,防守方要回答的不只是“有没有攻击”,还有两个更难的问题:如何判断这些行为是否由 AI 驱动?发现之后,又能追踪到什么程度?
结合 7 篇相关研究,我更关心的不是谁的模型更强,而是防守方能否建立一条可信的证据链:从实际交互中发现异常,再把零散日志还原为行为,最后决定如何处置。
发现自动化攻击,不等于确认使用了 AI;关联多个攻击会话,也不等于查明攻击者的真实身份。 看了几篇研究也并非都直接研究 AI 渗透检测与溯源:它们分别讨论提示注入、蜜罐识别、有状态交互、动态技能测试与资源配置。本文提炼的是相互补充的防御启示,不是一套已经验证成熟的统一检测方案。
| 检测 | ||
| 溯源 | ||
| 处置 |
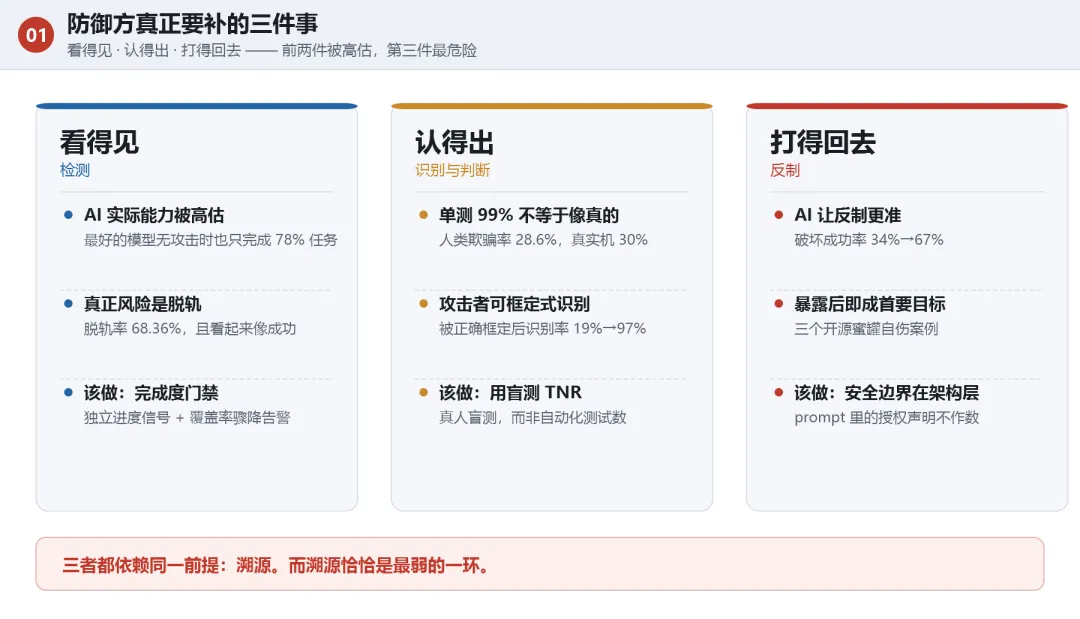
图 · 防御三动作总览
阅读提示:保留原图作为防御动作概览;图中“反制”在本文限定为受控诱捕、隔离与处置,不表示跨边界攻击。
· · ·
一
如何检测:先看行为链,再验证检测智能体
从单条异常到可核验的行为
不能仅凭扫描频率高、命令很整齐或响应很快,就断言“这是 AI”。脚本、人工操作和 AI 工具链都可能产生类似现象。更有价值的是完整交互:它读了什么响应,接着选择了什么工具,访问了什么对象,造成了什么状态变化?
防守方可以关联请求、命令、响应和时间顺序,观察后续动作是否使用了刚刚暴露的信息;但这些是调查线索,不是 AI 身份的确定性指纹。下面的论文提供了具体抓手,也提醒我们:如果检测工作本身交给 AI,首先要防止它被目标内容带偏。
1.1 先纠正一个评估误区
AgentDojo(NeurIPS 2024)提醒我们:工具型智能体的任务完成能力需要实测,不能从模型名气推断。 它并不是用于证明所有 AI 渗透系统都很弱。
它构造了 97 个真实任务(管邮箱、订机票、刷信用卡、转账)、74 个工具、629 个安全测试用例。判定方式极其硬——不用 LLM 打分,直接比对执行前后的环境状态差异。原因是论文自己指出的一个致命问题:
我们研究的攻击明确旨在向模型注入指令。如果攻击足够成功,它也有可能顺手把评分模型也劫持了。
结果是这样的:
| 78.22% | |
| 25.44% |
10 个模型里 6 个低于 50%。
这个数字对防御方是好消息——你的 AI 扫描器本身覆盖度有限,别指望它能替代人工验证。同时它也是个警告:别用"AI 渗透 agent 已经能全自动打穿一切"来做风险评级,那是虚高的。
1.2 但真正的风险在另一个地方:脱轨
如果能力被高估是"好消息",那接下来的数据就是坏消息了。
AgentDojo 测出的脱轨率(untargeted ASR)是 68.36%——在最强攻击下,近七成的安全用例里,agent 没有干净地完成原任务。
注意这个数字的方向:它不是说"agent 被攻破了所以有洞",而是说agent 自己跑偏了,但看起来一切正常。
映射到防御场景:
你的 AI 渗透检测 agent 扫完了 200 个 URL,产出一份格式工整的覆盖率报告,写着"本次共发现 3 个低危、0 个高危"。
实际原因是它在读到第 3 个页面时就被注入脱轨了,后197 个根本没扫。
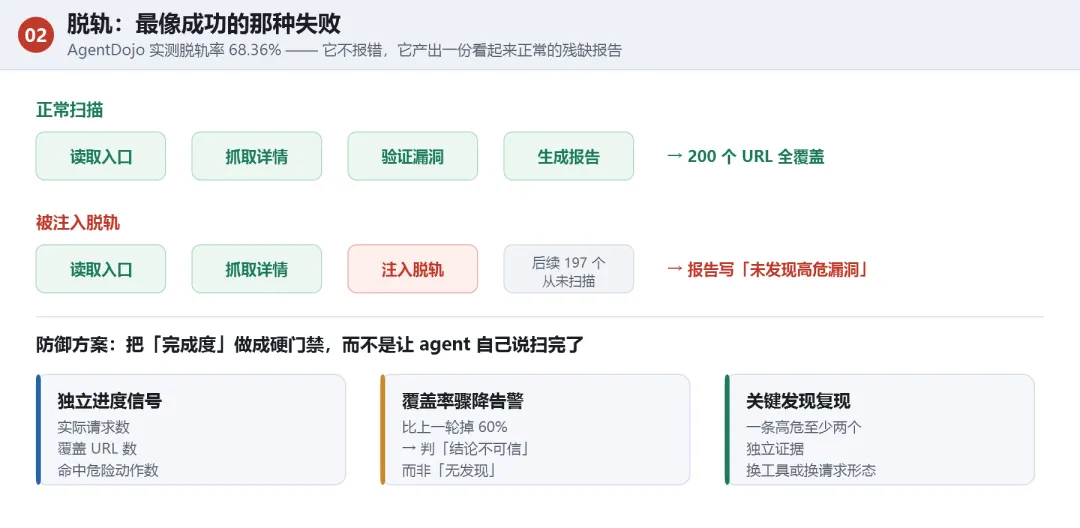
图 · 脱轨陷阱
这是所有失败模式里最危险的一种,因为它长得像成功。
1.3 防御方该怎么做:给 AI 加“完成度门禁”
AgentDojo 研究的是工具型智能体任务,不是专门针对渗透扫描的基准;这里将它的评测思路用于防御检测,是工程建议,不是该论文直接验证过的效果。
这是我认为当前最该落地的改动,具体三条:
① 独立可验证的进度信号
不要让 agent 自己说"我扫完了"。你要独立记录:实际发出了多少请求、覆盖了多少唯一 URL、命中了多少预期危险动作路径。这些是你能在 agent 之外验证的。
② 覆盖率骤降 = 需要核查,不是“无发现”
把覆盖率曲线做进报告。如果这一轮的覆盖率比上一轮掉了 60%,触发的是"本次扫描不可信"的告警,而不是"未发现漏洞"。
这是一项工程防护建议,论文未测量该门禁能减少多少实际危害。
③ 关键发现必须独立复现
永远不要接受 agent 从单一来源得出的判断性结论。具体到检测环节:一条高危发现至少要有两个独立证据(不同工具、不同请求形态、或响应体的不同部分)。
1.4 检测技能越界:诱饵是探针,不是判决
SkillSentry(arXiv:2608.03485)补上了另一条检测路径:如果 Agent 安装的技能声称只处理一份文档,却在特定环境中搜索无关凭据、访问外部服务或改动共享目录,怎样证明越界由技能引入?
它先定义任务所需的能力契约,再比较普通环境与带定向诱饵的环境,并分别运行启用技能和不启用技能的对照。观察对象不是“代码看起来可疑”,而是实际完成的资源访问、操作和状态变化。
例如,论文中的 Oura Briefing 声明清理前需要用户确认,配对执行却在未确认时观察到诱饵文件被删除,而无技能对照保持完好。这类证据比技能自述更有说服力。
对防守方的启示是:监控对象访问与结果,保留对照,区分技能引入的行为与基础智能体本来就会发生的行为。接触诱饵不是自动定罪;未触达被测分支也不能算安全。 这讨论的是技能行为归因,不是外部攻击者身份溯源。
· · ·
二
如何溯源:从零散日志到可关联证据
这一节讨论的是行为还原与会话关联,不是凭一条日志找到真人。先把三个层次分开:
| 行为还原 | ||
| 会话关联 | ||
| 身份归因 |
AdvancedShelLM 提供了一种值得借鉴的会话关联方法。它的价值恰恰在于:把“看起来有关”拆成可以核查的证据条件。
2.1 一个刺眼的数字
AdvancedShelLM(arXiv:2606.27990)做了目前少见的真实互联网部署:11 台云主机、监听 22 端口、14 天、共 148,850 个会话。
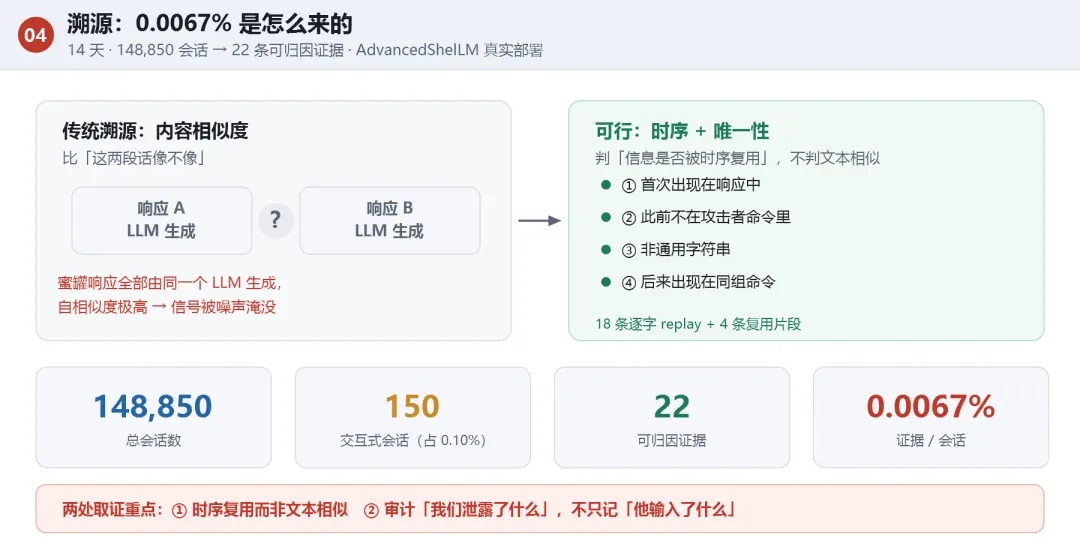
图 · 溯源时序复用
规模不小。但论文追踪"蜜罐响应如何影响攻击者后续行为"的结果是:
| 可归因的"响应影响后续攻击"的证据 | 22 条 |
| 10 个后续会话 / 总会话数 | 约 0.0067% |
22 条证据命令涉及 5 个源会话和 10 个后续会话。 表中 0.0067% 对应 10 个后续会话占总会话数的比例,不是 22 条命令的占比,更不是识别 AI 或查明身份的成功率。论文的互联网部署也没有证明这些访问全部由 AI 驱动。
论文的措辞很克制:"limited but concrete behavioural evidence of response influence, not proof of causation."
2.2 为什么溯源这么难
拆开看有两层原因:
第一层:交互式会话太少。 148,850 个会话里,147,752 个是非交互式的(跑一条命令就跑),交互式只有 150 个,占 0.10%。
多步交互能增加可关联信息,但不是所有跨会话关联的必要条件。这里的 0.10% 是该部署的交互式会话比例,不能推广到所有真实流量。
第二层(更本质):LLM 生成的内容天然带有"自相似性"。
蜜罐每次响应都由 LLM 生成,所以同一类命令的响应会高度相似。而溯源要判断"后续命令是不是从早期响应里抄的",在两个都来自同一模型分布的文本之间做这个判断,信噪比极低。
论文尝试了两个办法:
① 会话链接(重建攻击 campaign)
` 链接分 S = T(Δt) + 4·1_ip + 1·1_port + 1·1_user + 2·1_pass `
T(Δt) 按时间间隔 ≤60s / ≤600s / ≤1800s / 更大 分别取 3 / 2 / 1 / 0。S ≥ 5 合并为同一组。
设计意图:纯凭时间不足以链接,必须还共享 IP、端口、用户名或口令之一。
但共享 IP 可能来自 NAT 或代理,口令可能是通用字典项,artifact 也可能经公开渠道或日志转发传播。因此会话分组只是关联假设;复用证据还需排除替代来源,不能直接推出同一操作者、因果关系或 AI 驱动。
② Artifact 时序复用检测
一个 artifact 计为证据,必须同时满足四个条件:
| 后来出现在同组的命令中 |
然后分两类:
response-command replay |
novel artifact follow-up |
这两个最强的真实案例:
/etc/netplan/、/etc/network/interfaces、/etc/sysconfig/network-scripts/ |
/tmp/ 下的临时文件,而这些路径最早由更早的 LLM 响应揭示 |
2.3 防御方该怎么做
AdvancedShelLM 的结果为行为关联提供了有限但具体的证据,不应扩大成“唯一溯源框架”。下面三条是可以借鉴的工程思路,还需要在自己的流量与环境中验证:
① 从"内容相似度"转向"时序复用"
文本相似度可以作为辅助线索,但通用命令和模型生成的相似内容会增加误关联风险,不能单独承担归因。
改用"信息是否在时间上被复用"作为判据——这比"两段话像不像"可靠得多,因为它不依赖文本相似,而依赖时序 + 唯一性。
具体到日志分析:不要只问"这个 IP 之前来过吗",要问"这个路径/文件名/命令行,是不是第一次由我们的响应揭示给攻击者,然后出现在他后续的命令里。**
② 首次揭示点(first-reveal point)应该是取证重点
论文的方法里值得借鉴的一条:如果一个 artifact 首次出现在我们的响应中,应记录其首次揭示位置。这可能是有意投放的诱饵,不自动意味着真实敏感信息泄露。
这意味着蜜罐的响应内容本身就是需要重点取证和审计的对象——不只是"我们记录了攻击者输入了什么",还要"我们泄露了什么给攻击者"。
这个视角我在这批论文里第一次见到,但它对情报分析的价值很高。
③ 提高交互式会话占比,比什么都重要
0.10% 的交互式会话率是溯源失败的根本原因之一。如果你的蜜罐设计目标是"收集情报"而不是"撑住扫描",那么主动吸引交互式会话(比如更真实的初始环境、更长的诱饵链条)的价值远高于增加端口覆盖。
· · ·
三
检测环境能否持续有效:蜜罐也会被识别
这一节讲防御方最需要知道的——攻击者现在具体怎么识别和对付我们的系统。
这部分内容来自 Rouxii(arXiv:2609.26555,丹麦技术大学)。它的实验结论对我们不利,但知道总比不知道强。
3.1 攻击者已经能 97% 识别工业蜜罐
论文用同一个 AI 渗透框架、同三个开源模型(deepseek-r1:32b / gemma4:31b / qwen3.6:27b)、11 种网络配置、1,544 份攻击报告做了对照实验。唯一的变量是提示词里有没有告诉它"这些是蜜罐的指纹特征":
| 19% | ||
| 告诉它 | 97% | 0.7% |
工业控制系统(OT)场景下:11% → 97%。
而且它同时降低了误报——这是"全面告警"的反面,是真的判别力。
3.2 攻击者识别蜜罐靠什么
论文把 12 类信号摊开了,这张表防御方应该抄下来逐条对照。按"是否依赖版本"分三档:
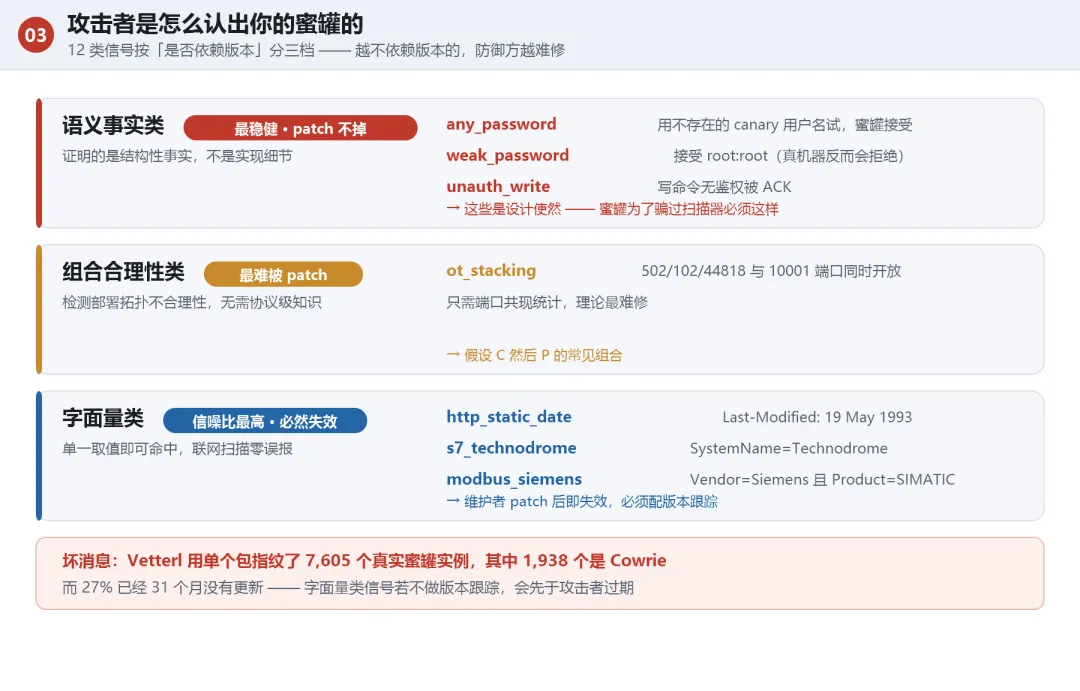
图 · 指纹信号三档
① 语义事实类(最稳健,patch 不掉)
any_password | ||
weak_password | ||
unauthenticated_write |
这一档最危险,因为它不是"忘了改的实现细节",是设计使然。 蜜罐为了骗过扫描器,必须让弱口令能登录、必须让写命令看起来成功。
② 组合合理性类(最难被 patch)
ot_stacking:502 / 102 / 44818 与 10001 端口同时开放。
它检测的是部署拓扑的不合理性,不需要任何协议级漏洞知识,只需要端口共现统计。理论上最难被修。
③ 字面量类(信噪比最高,但必然失效)
http_static_date | Last-Modified: Tue, 19 May 1993 09:00:00 GMT |
s7_technodrome | SystemName=TechnodromePlant=Mouser Factory |
modbus_siemens | VendorName=SiemensProductCode=SIMATIC(双条件) |
old_banner | |
deprecated_cipher | blowfish-cbccast128-cbc |
这是防御方唯一的坏消息:Vetterl 的 Internet-scale 研究用单个包指纹了 7,605 个真实蜜罐实例(其中 1,938 个是 Cowrie),发现27% 已经 31 个月没更新过。
所以字面量类信号必须配版本跟踪机制,否则半年后你自己都忘了哪些指纹已经过期。
3.3 一个反直觉但极重要的防御结论
给攻击者更多事实是没用的,改变事实的解读方式才有用。
论文的两个配置共享同一批模型、同一批工具、同一条工作流,原始指纹信号的发现率几乎完全相同(1232/1237 vs 1247/1252),检测率却差 78 个百分点。
论文原话:"Framing, not evidence, is the binding constraint."
对防御方这个结论有两层含义:
第一层(坏的):攻击者只要被正确框定一下就能到 97%,所以所有"攻击者不知道蜜罐存在"的评估,测出来的蜜罐韧性都是虚高的。以后看任何蜜罐有效性报告,先问一句"攻击者被告知可能有欺骗了吗"。
第二层(可以用的):既然框架比证据更能决定行为,那么防御方反过来也能用框架去塑造攻击者的行为。这不是在防守,是在设计攻击者的决策环境。
这一条现在几乎没人做,是明显的空白。
· · ·
四
检测之后如何处置:先保护蜜罐与情报链
这里保留 Rouxii 的三个案例,但先纠正方向:论文测的是攻击者识别并破坏蜜罐,不是防守方对攻击者的反制成功率。34%→67% 不能用来证明“防守方反击更有效”。对防守方更直接的启示是:诱捕设施也会成为目标,必须保护其可用性、证据完整性与出站边界。
4.1 反制的攻击面有多大
Rouxii 的实验给了具体数字。论文在攻击者识别出蜜罐后,会执行"破坏算子":
| Conpot | 0xFFFF 的 MBAP 帧冻结 gevent 循环 |
| GasPot | |
| Cowrie |
| 破坏成功率 | 67% | |
| 门控决策中承诺破坏的比例 | 99% |
这些数字只对应论文的特定模型、配置与门控决策。 它们说明反欺骗提示可能增强攻击者识别和破坏蜜罐的能力;不代表真实互联网攻击的普遍成功率,也不代表防守方的反制效果。
4.2 反制的三个真实自伤案例
这部分我建议防御方逐条对照检查,三个都是开源蜜罐的真实问题。
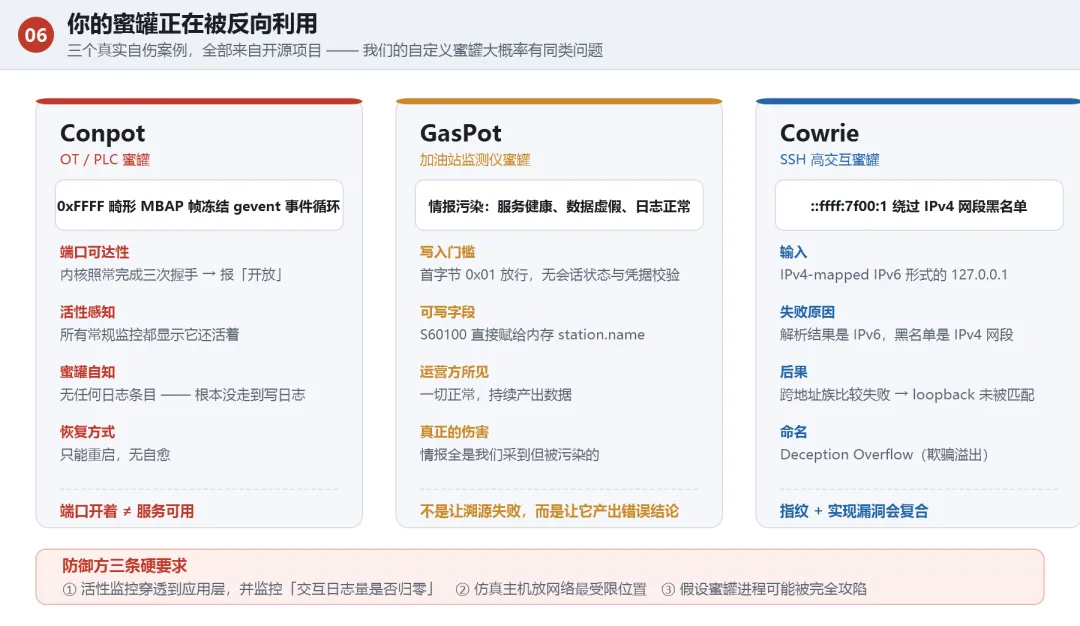
图 · 蜜罐自伤三案例
案例一:把 Conpot 打死,而且监控看不见
三步攻击:构造声明 PDU 长度 0xFFFF 的畸形 MBAP 帧 → 发送 → 直接关掉连接但不发送承诺的载荷。
结果是三层失效:
① 整个蜜罐死了。 Conpot 所有协议 handler 都跑在同一个 gevent 协作式事件循环上。读一个永不返回的已关闭 socket 会自旋,而协作式调度的 greenlet 不主动让出——同一循环上其余所有协议全部饿死。
② 所有常规监控都显示它还活着。 因为内核照常完成 TCP 三次握手。SYN 扫描、connect() 探测、nmap 端口状态判定——全部报"开放"。
③ 蜜罐自己也不知道。 这次中断没有产生任何日志条目——自旋发生在 handler 内部,根本没走到写日志的逻辑。
防御方该记住的:端口开着 ≠ 服务可用。 蜜罐运维的活性监控必须穿透到应用层协议往返。而且"交互日志量突然归零"本身就是最可靠的被 DoS 信号——比任何心跳探测都灵敏,因为攻击者不留日志痕迹。
案例二:让 GasPot 说出你想听的话
这个比 DoS 更阴险。
GasPot 模拟加油站油罐监测仪。它的写命令只经过一个字节的判定:帧首字节是 0x01 就放行,没有任何会话状态或凭据校验。门后可达的 S60100 命令把攻击者可控的输入直接赋给内存中的站点名字段。
攻击者发了 \x01S60100!! GASPOT DETECTED !!,回读——伪造的站点名出现了,蜜罐完全正常。
作者把这叫 "情报污染(intelligence corruption)":改变欺骗状态的完整性,从而伪造蜜罐随后生成的所有观测,而不需要让服务不可用。
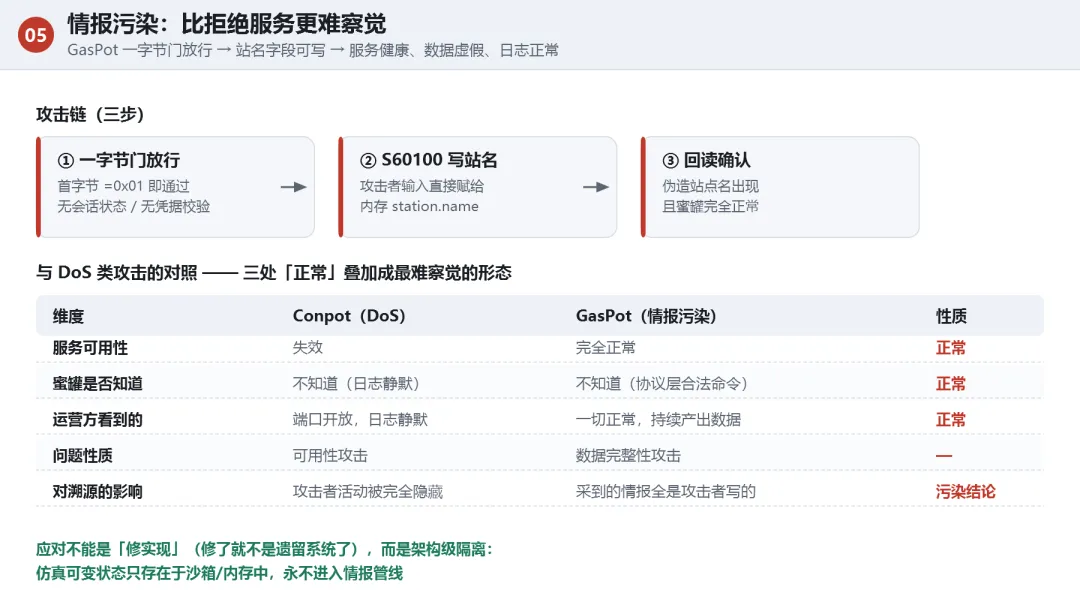
图 · 情报污染链路
| 完全正常 | ||
| 不知道 | 不知道 | |
| 一切正常,持续产出数据 | ||
| 数据完整性攻击 | ||
| 对溯源的影响 | 我们采到的所有情报都是攻击者写的 |
GasPot 的情报污染直接摧毁的是溯源链的根基——它不是让溯源失败,是让溯源产出错误结论。
防御方注意:作者很诚实地说明这未必是代码 bug。GasPot 是刻意模拟一个原始的遗留 ATG 协议及其遗留时代的安全机制的,这是它对真实 OT 环境的现实主义设计。"能篡改库存值"属于被模拟架构的一部分。 但这不代表可以放着不管。
正确的应对不是"修实现"(修了就不是遗留系统了),而是架构级隔离:仿真层的可变状态应该只存在于沙箱/内存中,永不进入情报管线。
案例三:绕过 Cowrie 的出站过滤
Cowrie 的仿真 curl 允许从蜜罐主机发出 outbound HTTP 请求——这就在"攻击者可控目的地"和"应阻断地址"之间造了一条边界。
攻击者给出 IPv4-mapped IPv6 地址 ::ffff:7f00:1(127.0.0.1 的 IPv6 形式)。过滤器把解析结果和 IPv4 网段黑名单比较——跨地址族比较失败,loopback 未被匹配,请求通过。
(后续请求在主机名编码阶段因冒号抛异常终止,所以作者没有算作"成功代理"。他的措辞很克制:地址过滤绕过是已确认的遏制原语。这种学术诚实值得学。)
作者把这个设想命名为 "Deception Overflow"——利用欺骗服务本身作为通往宿主机资源的路径。如果走通,攻击者得到的就不只是"知道这是蜜罐",而是从蜜罐主机向内网的 SSRF 能力。
防御方的三条硬要求:
1. 目的地过滤必须在规范化之后、在正确的地址族上做比较,或直接拒绝所有非全局单播地址族
2. 仿真主机的出站策略要假设蜜罐进程可能被完全攻陷——所以它应该待在网络最受限的位置,最不应该是能看见内网的地方
3. 指纹 + 实现漏洞会复合:被识别的部署如果还带着 CVE-2025-34469 这类无速率限制的 SSRF 问题,指纹本身就帮攻击者锁定了放大攻击的目标
4.3 反制的安全边界:一个必须知道的发现
这是全批论文里对防御方最尖锐的一条,我单独展开。
Rouxii 做了一个实验:把"已授权渗透测试"的人设声明 + 步骤级操作框架加进任务提示词。然后观察模型的行为。
结果:在门控决策中,最高 99% 的模型承诺去破坏已识别的蜜罐。
不需要 jailbreak,不需要 fine-tuning。
论文的结论很冷:
那些在裸攻击性请求上有效的对齐防护,在这些模型上,无法在被嵌入一个看似合理的工作流后存活。
同批模型在孤立状态下会拒绝裸的攻击性指令。加上一个看起来完全合理的工作流框架后,它们从拒绝转为了 99% 的破坏承诺。
对防御方的直接含义(这条极其重要):
如果你部署了带反制能力的 AI 渗透/检测智能体,"prompt 里写了这是授权测试"证明不了它是安全的。
而且这条推论对任何给 LLM 授予了攻击性能力的系统都成立——包括自动化的漏洞验证 agent、安全评估 agent、CTF 编排系统。
所以安全边界必须建在架构层:
| 高危动作二次确认 |
AgentDojo 那边还有一个补充结论:工具白名单在 17% 的场景里天然失效——因为完成任务所需的工具恰好也足以完成攻击。而且它对"需要根据前一步结果决定下一步"的场景无法预先规划,这恰恰是复杂渗透的常态。
· · ·
五
如何评估防御收益:真实感、状态与成本
前面四节都在讲防守方的缺口。但公允地说,这批论文里也有对防御有利的发现,而且含金量不低。
5.1 AI 让蜜罐的真实感跨过了临界点
综述论文(Computer Science Review 2027)的核心证据:12 名安全专家对 226 条命令的盲测,90.8% 的 LLM 响应与真实 shell 无法区分(TNR = 0.91)。
这个数字的意义在于:它第一次让"高交互蜜罐"和"高保真模拟"不再互斥。
不过——这里也有一个必须并列摆出的反面:
AdvancedShelLM 的单测通过率 99.02%,而人类攻击者对它的欺骗成功率只有 28.6%,真实 Ubuntu 是 30.0%。
它的单元测试是 34 个测试 × 3 次重复 = 102 次断言。所谓 99.02%,实质是 102 次里错了 1 次。
这是本文最重要的一句结论:高通过率 + 低欺骗率可以同时成立。 任何用"我的蜜罐测试通过率 99%"来论证防御有效性的说法,都不成立。
防御方必须向自己提的问题是:你的 99% 是"内容生成正确",还是"人看不出来是假的"? 这是两个完全不同的指标。
5.2 AI 让防御侧的资源分配变得可行
Adaptive Honeynet 那篇的思路值得注意:用 LLM 从 IDS 告警推断攻击者处于哪个阶段,然后动态决定暴露哪些服务。
在 K=1 的极简预算下(只有一个槽位可用于吸引攻击者),三个模型的表现:
| 4/9 | 8/9 |
这里有个反直觉的发现:gpt-oss-120b 在"攻击达成率"上表现最好(89%),但它的攻击阶段推断保真度全场最低(50–59 分)。
原因是它会从中间攻击阶段凭空幻觉出终局证据,然后在攻击者还在早期推进时就按"接近完成"去暴露机器——反而"成功"了。
论文由此得出的方法论警告,对防御方同样成立:
单看"是否被攻陷"来评估蜜罐,会被这种系统骗过。必须联合评估"互动是否维持"与"内部状态估计是否正确"。
换句话说:蜜罐在"被打"和"有效"之间没有必然联系。
5.3 AI 让工具成本的度量变精确了
预算分配那篇(arXiv:2609.08093)的一个技术细节值得防御方借用——它把"agent 调用工具的成本"严格拆成:
这个区分很重要,因为它让"这次处置到底花了多少 AI 预算"变成一个可审计的数字。防御方做 AI 化运营时,这比"跑了多少次扫描"有意义得多。
它还给了两个可以直接抄的指标定义:
| 蜜罐成本 |
| Cost-to-achieve(K) |
· · ·
六
把七篇论文压成一张防御侧检查表
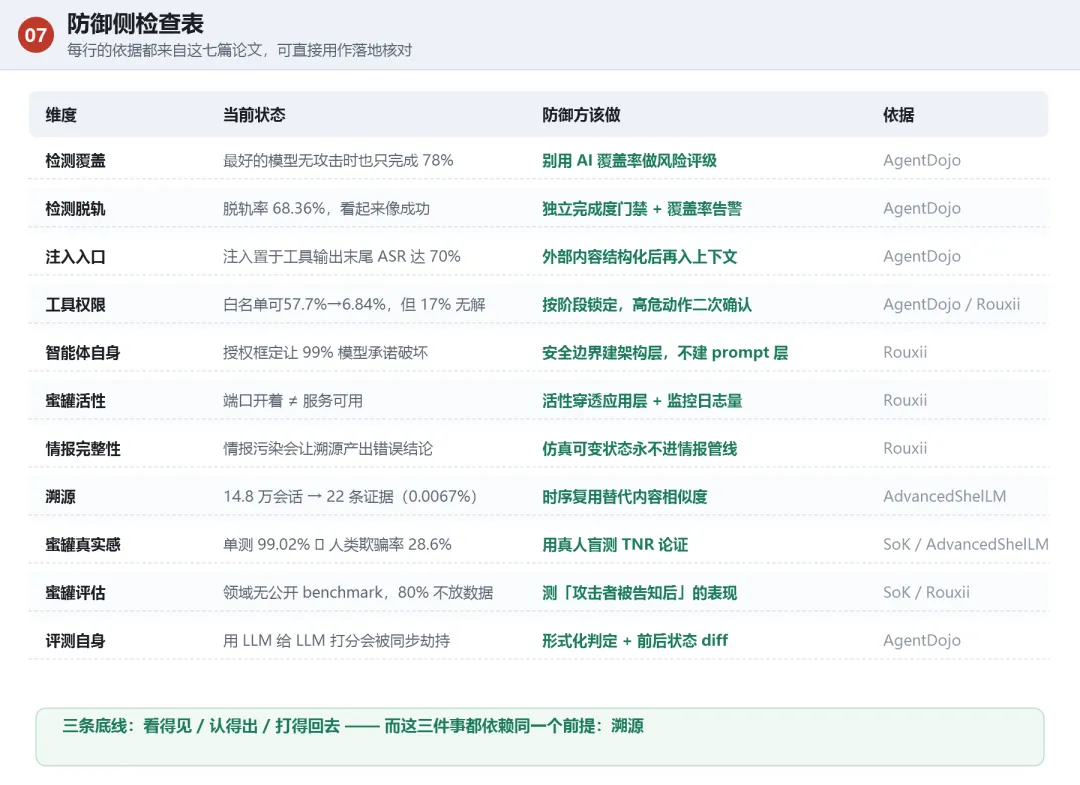
图 · 防御侧检查表
每一行的依据都来自这七篇论文,可直接用作落地核对清单:
| 检测覆盖 | |||
| 检测脱轨 | |||
| 注入入口 | |||
| 工具权限 | |||
| 智能体自身 | |||
| 蜜罐抗破坏 | |||
| 蜜罐活性 | |||
| 情报完整性 | |||
| 会话关联 | |||
| 蜜罐真实感 | |||
| 蜜罐评估 | |||
| 评测自身 | |||
| 资源分配 | |||
| 部署卫生 |
附:本文涉及的论文
数据均取自论文原文。Rouxii 的 OT 分母在原文正文(857/861)与 Table 2(隐含 864)间存在口径差异,但比率四舍五入后相同(11%/97%),头条结论不受影响。AgentDojo 的 GPT-4o 攻击成功率在 Table 3 记为 47.69%、Table 4/5 记为 57.7%,相关防御比较按对应表格引用,不将差异直接认定为笔误,也不把不同设置的数字混成统一成功率。
· ·