ARTICLE · 1121479
爱学习I RAG 答不准,先改文档切分
爱学习
RAG 答不准,先改文档切分
别急着换模型——你花在换模型上的时间,可能不如花在切分上值。
# 文档切分# 检索质量# RAG 优化# AI 应用
爱学习,搞懂一个算一个。
写在前面
先给你一个数字:同一份知识库、同一个模型、同一批问题,只把文档的切分方式换掉,检索 F1 从 0.24 涨到 0.64。
这是 2025 年一项临床决策支持研究的实测。知识库、embedding 模型、top-k 全部锁死,只动切分。
这一期拆流水线的前两步:解析和切分。
换句话说:你花在换模型上的时间,可能不如花在切分上值。最差的固定长度字符窗口,捞回来的片段里不到五分之一是相关的;换成最好的自适应切分,差 2.7 倍。
01文档进屋,先被「读」一遍
RAG 的第一步不是切,是把文档变成干净的文字。这一步最容易被当成「格式转换」,找个库跑一下就算完,可它恰恰是整条链里最脏的一段。最常见的三种翻车:
表格被压成一行糊字。解析器不认识表格结构,会把「审批人|金额|时限」三列顺着读成一串连续文字。而合同、报价单、参数表,正是 RAG 最常被查的东西。
扫描件根本没被识别。图片型 PDF 解析出来是空白或乱码,得先上 OCR,OCR 又带进新的识别错误。
页眉页脚、页码、水印混进正文。每页重复的公司名和页码,切完之后每一块都带着。
建议只有一句:新文档进来,先随机抽十段人眼看一遍,再谈切分。
02切多碎才算对
检索的最小单位不是文档,是块(chunk)。模型看不见你的数据库,提问时它只能看到被捞出来的那几块。块切得对不对,决定它看到的是完整一句话,还是半截话。
这里有个默认值陷阱。主流切分器的默认参数是 1000 字符、重叠 200 字符,这套默认值是为英文调的。1000 个字符放进中文,往往是三四个不相干的主题挤在一起:每块都沾一点,检索时又什么都不像。
切太碎
一句话被拆成三段,命中了也答不全。
切太长
一块里塞五个主题,命中之后大半是噪声。
划重点
中文场景拿 256 到 512 个 token 起步,重叠 10% 到 20%。这不是标准答案,但比 1000 字符合理得多。
03四种切法,怎么选
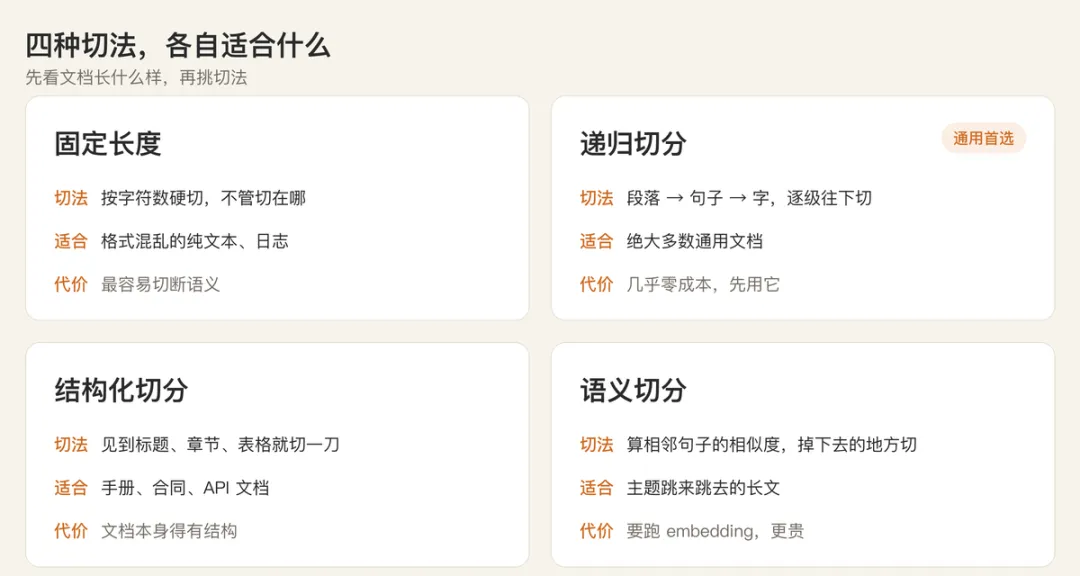
— 四种切法对比:固定长度、递归切分、结构化切分、语义切分
四种切法各有各的适用面,代价图里都标了。其中两种值得单独说:通用文档和结构化文档,各有各的最优解。
递归切分
按段落、句子、字逐级往下切,通用文档首选。
结构化切分
按标题、章节、表格切,适合手册、合同、API 文档。剩下两种——固定长度和语义切分——各有各的适用面。
小贴士
得说句公道话:有研究对比过,语义切分并不总是赢过固定切分,embedding 模型选得对不对,影响比切分策略更大。先看你的文档长什么样,再挑切法。
真正零成本、收益最大的一招是:有结构就用结构。标题本身就是天然的分界,按标题切几乎不会出错,却最少人做。
04比调参数更管用的:把上下文补回去
切得再准,有个问题躲不掉:一块被单独拎出来的时候,常常看不懂。
比如某一块里写着「限额已上调至 1 万元」,可它没说清是哪个产品、哪类限额。人看得出缺了什么,向量看不出来——它的坐标从一开始就偏了。
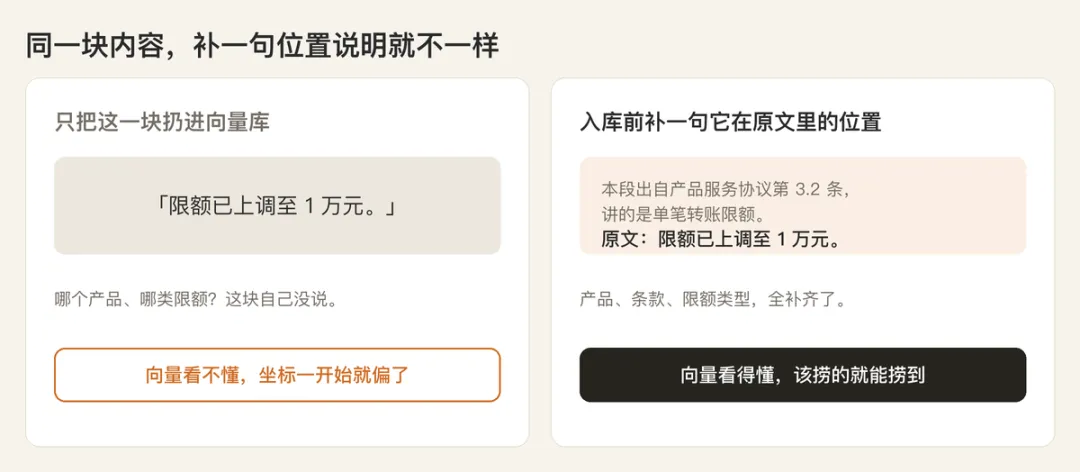
— 补上下文前后对照:同一块内容,补一句位置说明,向量才看得懂
解法就是把切掉的东西补回去。Anthropic 2024 年的一组实验结论很干脆:给每块补一句它在原文里的位置说明,再去做向量,检索失败率降 35%;再加上关键词检索 BM25,降 49%;再叠一层重排 rerank,降 67%,把失败率从 5.7% 压到 1.9%。
−35%补上下文−49%+ BM25−67%+ rerank
这个动作还很便宜:每块加 50 到 100 字的上下文说明,一次性预处理,成本大约每百万 token 一美元出头。
父子切分
小块负责检索,命中后把大块交给模型。
适度重叠
相邻块留 10% 到 20% 的重叠区。都是用一点冗余,换一次不丢信息。
05今天就能做的一件事
别急着换模型。拿最常被问的那份文档,做一件事:
1写 20 个真实问题 · 量「正确答案有没有出现在前 5 块里」
2只改切分方式 · 同一个问题集再量一次
同一个问题集,只动切分,测两轮。这一下午的收益,通常比换一个更贵的模型大。
答案的质量,在检索开始之前就定了大半。
解析定型了文字,切分定型了检索的最小单位。这两步糊弄过去,后面换多少模型,都只是往一个被压死的上限上靠。
下期预告
下一期往上走:文字怎么变成坐标,中文该选哪个 embedding 模型,向量库该建什么索引。
如果你身边有人在搭知识库、做 AI 应用,把这篇转给他。
转发给需要的朋友
素材来源:MDPI《Bioengineering》12(11):1194,Comparative Evaluation of Advanced Chunking for Retrieval-Augmented Generation in LLMs for Clinical Decision Support(2025);Anthropic《Introducing Contextual Retrieval》(2024);LangChain 官方文档 RecursiveCharacterTextSplitter 参数说明。具体数据与结论以原始文献为准。
未来我会持续关注和汇报我在 OPC 创业过程遇到的一些问题和使用 AI 工具的感受。本人有十几年开发、架构和团队管理经验,主导千万级支付系统的实施和落地,也希望大家和我多交流,我相信:一个人走得快,一群人走得远。· · ·
扫码查看小程序